Topik ini menjelaskan cara menggunakan Delta Join.
Delta Join: Penggabungan dua aliran untuk Fluss
Dalam skenario gudang data real-time, Anda sering perlu membangun tabel lebar terpadu dari beberapa tabel data real-time. Gudang data real-time yang dibangun di atas Flink dan Kafka open-source biasanya menggunakan streaming join Flink untuk menggabungkan beberapa topik Kafka menjadi satu tabel lebar. Desain ini memperbarui seluruh tabel lebar setiap kali terjadi pembaruan pada salah satu topik.
Namun, karena Kafka tidak dirancang untuk beban kerja analitis, skenario ini bergantung sepenuhnya pada kemampuan streaming join bawaan Flink. Pendekatan ini mengharuskan kedua sisi penggabungan untuk mendorong pembaruan dan menyimpan cache semua data hulu, sehingga menghasilkan state besar di Flink. Akibatnya, biaya sumber daya tinggi, operasi dan maintenance (O&M) menjadi kompleks, serta efisiensi sistem menurun.
Dibandingkan dengan Kafka, Fluss memperkenalkan kemampuan Delta Join. Solusi penggabungan baru ini mendorong pembaruan data ke tabel Fluss sekaligus mempertahankan semantik penggabungan dua aliran. Pendekatan ini secara signifikan mengurangi konsumsi sumber daya Flink serta meningkatkan stabilitas dan efisiensi eksekusi pekerjaan.
Keunggulan Delta Join
-
Tidak ada join state: Menghilangkan penyimpanan data redundan.
-
Biaya rendah: Hanya bergantung pada tabel kunci primer Fluss dan indeks sekunder.
-
Lebih stabil dan efisien: Menghindari bottleneck performa akibat state besar.
Batasan Delta Join
-
Kedua tabel kiri dan kanan harus merupakan tabel kunci primer Fluss (tabel partisi didukung).
-
Kunci bucket dari tabel kunci primer Fluss harus merupakan awalan dari kunci primernya.
-
Kunci gabungan untuk Delta Join harus mencakup kunci bucket yang didefinisikan dalam tabel kunci primer Fluss. Jika tabel dipartisi, kunci gabungan juga harus mencakup kunci partisi.
CatatanSebagai contoh, sebuah tabel didefinisikan dengan
PRIMARY KEY (user_id, order_id, order_data)dan'bucket.key' = 'user_id'.-
Karena kunci bucket merupakan awalan dari kunci primer, Anda dapat menggunakan
user_idsebagai indeks sekunder untuk pencarian data yang efisien. -
Pertimbangkan kueri berikut:
JOIN users u ON o.user_id = u.user_id.Dalam kasus ini, kunci gabungan adalah
user_id, yang mencakup kunci bucket yang telah ditentukan. Oleh karena itu, pengoptimal menjalankan kueri sebagai Delta Join.
-
Contoh penggunaan
Platform e-commerce harus menggabungkan aliran pesanan dan aliran item menjadi tabel lebar untuk kueri downstream.
Langkah 1: Buat tabel sumber dan tabel hasil
Kunci gabungan harus sesuai dengan indeks pada kedua tabel sumber. Dalam contoh ini, kunci gabungan adalah (merchant_id, item_id). Pada tabel orders, kunci gabungan merupakan awalan dari kunci primer dan harus dideklarasikan sebagai kunci bucket agar berfungsi sebagai indeks awalan yang tersedia. Pada tabel items, kunci gabungan adalah kunci primer, sehingga tidak diperlukan konfigurasi tambahan.
CREATE TABLE `my-catalog`.`my_db`.`orders` (
  merchant_id BIGINT,                    -- ID merchant
  item_id BIGINT,                        -- ID item
  order_id BIGINT,                       -- ID pesanan
  amount DECIMAL(18, 2),                 -- Jumlah pesanan saat ini
  PRIMARY KEY (merchant_id, item_id, order_id) NOT ENFORCED
) WITH (
  'bucket.key' = 'merchant_id,item_id'
);

CREATE TABLE `my-catalog`.`my_db`.`items` (
  merchant_id BIGINT,                    -- ID merchant
  item_id BIGINT,                        -- ID item
  item_name STRING,                      -- Nama item
  PRIMARY KEY (merchant_id, item_id) NOT ENFORCED   -- Kunci gabungan sama dengan kunci primer.
);

CREATE TABLE `my-catalog`.`my_db`.`order_item_wide` (
  merchant_id BIGINT,
  order_id BIGINT,
  item_id BIGINT,
  item_name STRING,
  amount DECIMAL(18, 2),
  PRIMARY KEY (merchant_id, order_id, item_id) NOT ENFORCED
);
Langkah 2: Tulis penerapan penggabungan
USE CATALOG `my-catalog`;
USE `my_db`;

-- Aktifkan penulisan ulang Delta Join.
SET 'table.optimizer.delta-join.strategy' = 'EVENTUAL';

-- Pernyataan Delta Join tidak memerlukan sintaks khusus.
INSERT INTO order_item_wide
SELECT
  o.merchant_id,
  o.order_id,
  o.item_id,
  i.item_name,
  o.amount
FROM orders AS o
JOIN items AS i
  ON o.merchant_id = i.merchant_id AND o.item_id = i.item_id;
Langkah 3: Verifikasi bahwa optimasi berjalan
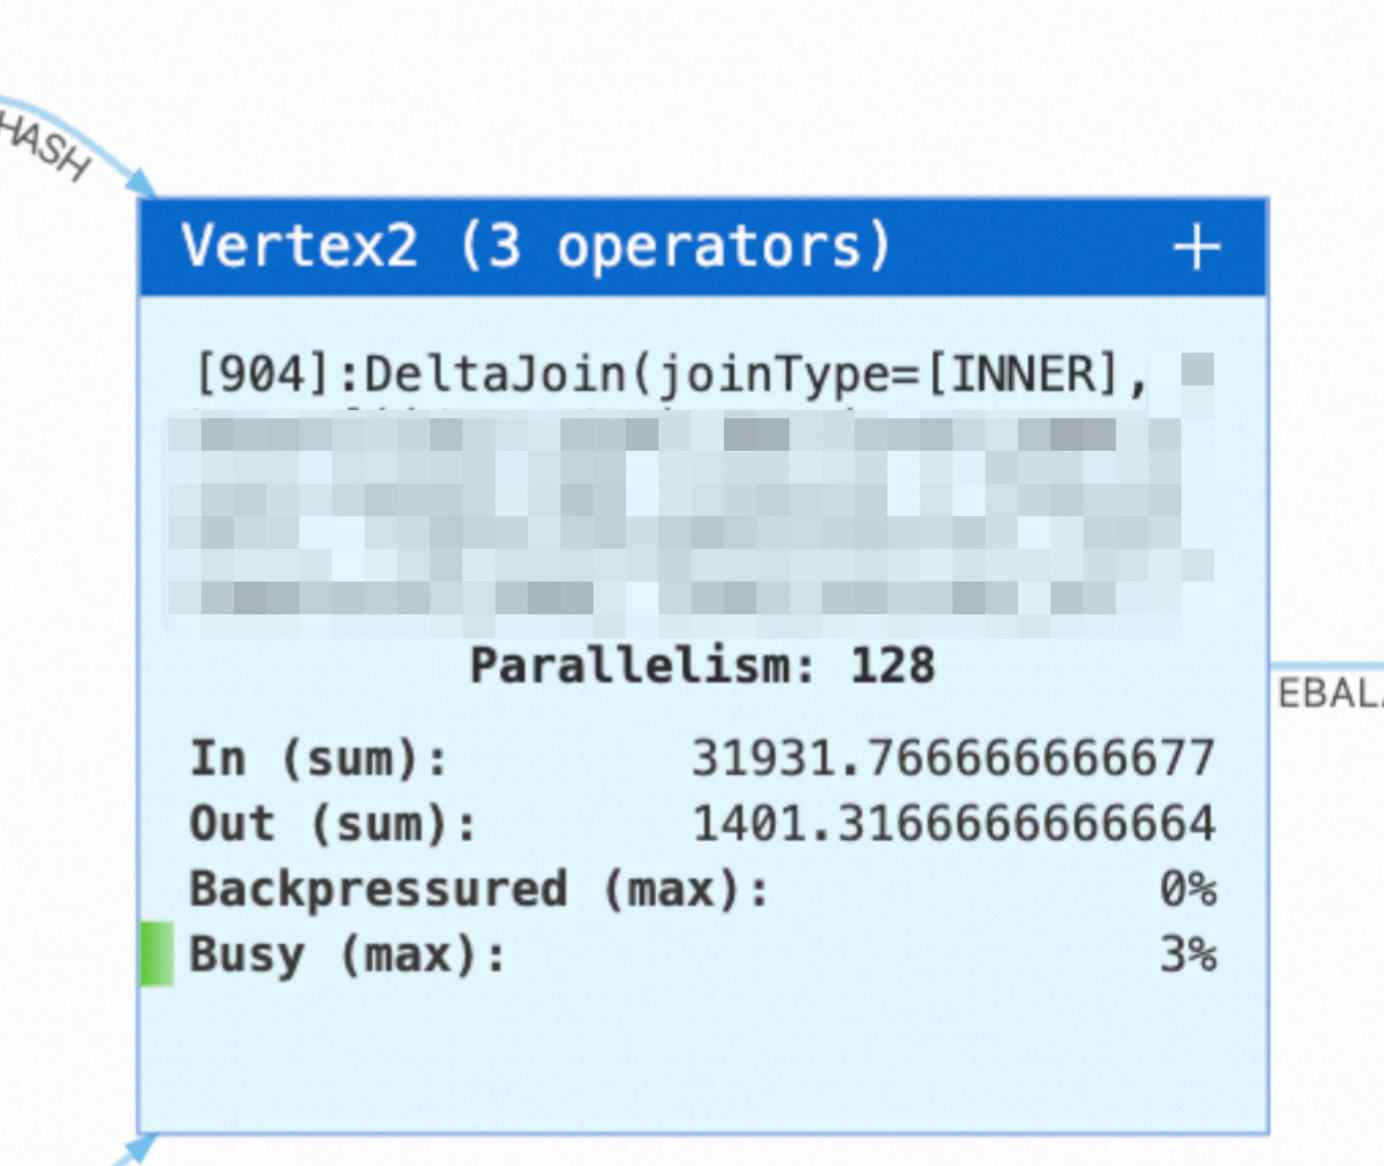
Setelah penerapan dipublikasikan dan dijalankan, periksa topologi penerapan di halaman Status. Jika Anda melihat node Delta Join berikut, penggabungan streaming telah ditulis ulang menjadi Delta Join.
Parameter
Parameter penerapan Flink
|
Parameter |
Nilai default |
Deskripsi |
Saran penyetelan |
|
|
|
Menentukan apakah kueri akan ditulis ulang menjadi Delta Join. Catatan
Pada versi sebelum VVR 11.5, gunakan |
Kami merekomendasikan |
|
|
|
Menentukan apakah akan melewati pemeriksaan kondisi filter yang diterapkan pada kunci non-unik dari hasil penggabungan. |
Atur parameter ini ke |
|
|
|
Menentukan apakah cache memori lokal diaktifkan. Fluss tidak diminta ketika lookup mengenai cache. |
Kami merekomendasikan mengatur parameter ini ke |
|
|
|
Jumlah kunci yang hasil lookup-nya pada tabel kiri disimpan dalam cache. Parameter ini hanya berlaku jika cache diaktifkan. |
Setiap catatan yang tiba di sisi kanan memicu lookup pada tabel kiri berdasarkan kunci gabungannya, dan hasil yang dikembalikan masuk ke cache ini. Oleh karena itu, kapasitas yang dibutuhkan bergantung pada jumlah kunci gabungan populer yang memicu lookup dari sisi kanan. Parameter ini mengonsumsi memori. Saat mengonfigurasinya, pertimbangkan juga ukuran setiap catatan dan ukuran memori TaskManager. Saat tekanan memori rendah, mulailah dengan nilai default. Kurangi nilainya jika garbage collection sering terjadi. Tingkatkan nilainya jika tekanan lookup pada kluster Fluss tinggi. |
|
|
|
Jumlah kunci yang hasil lookup-nya pada tabel kanan disimpan dalam cache. Parameter ini hanya berlaku jika cache diaktifkan. |
Setiap catatan yang tiba di sisi kiri memicu lookup pada tabel kanan. Konfigurasikan parameter ini dengan cara yang sama seperti cache tabel kiri. |
|
|
|
Jumlah permintaan lookup asinkron yang dapat diproses secara bersamaan oleh setiap instans paralel operator Delta. |
Tingkatkan nilainya saat tekanan pada kluster Fluss serta tekanan CPU dan memori pada TaskManager rendah. Nilai sekitar seribu direkomendasikan. Parameter ini berlaku untuk setiap instans paralel setiap operator Delta. Jumlah total permintaan yang sedang berjalan dalam suatu penerapan kira-kira sama dengan parallelism dikalikan jumlah operator Delta dikalikan nilai ini. Evaluasi kapasitas kluster Fluss berdasarkan jumlah total tersebut sebelum menaikkan nilainya. Turunkan nilainya jika memori menjadi sempit atau kluster Fluss kelebihan beban. |
|
|
|
Periode timeout untuk satu permintaan lookup asinkron. |
Tingkatkan nilainya jika timeout lookup sesekali menyebabkan penerapan gagal. Nilai yang lebih besar mencakup latency ekor normal. Jika kluster Fluss sudah kelebihan beban, jangan tingkatkan nilai ini. Permintaan yang timeout menempati slot konkurensi lebih lama dan memperburuk tekanan balik. Dalam kasus ini, kurangi dulu tekanan lookup atau lakukan scale out kluster Fluss. |
Parameter tabel Fluss
Parameter berikut dikonfigurasi dalam klausa WITH saat Anda membuat tabel Fluss. Anda juga dapat menggunakan petunjuk SQL untuk menyesuaikannya pada satu penerapan.
|
Parameter |
Nilai default |
Deskripsi |
Saran penyetelan |
|
|
|
Jumlah maksimum permintaan lookup tertunda di sisi client. |
Tingkatkan nilainya jika penerapan memproses volume data besar dan permintaan lookup terlihat mengantre. Kurangi nilainya jika memori TaskManager terbatas. |
|
|
|
Jumlah maksimum lookup yang digabungkan menjadi satu permintaan. |
Tingkatkan nilainya jika volume permintaan besar dan Anda ingin mengurangi overhead jaringan. Kurangi nilainya jika Anda sensitif terhadap latency. |
|
|
|
Jumlah maksimum permintaan lookup yang diproses secara bersamaan. |
Tingkatkan nilainya untuk meningkatkan konkurensi lookup. Pantau juga beban kluster Fluss secara bersamaan. |
|
|
|
Waktu maksimum menunggu batch terisi penuh. Batch dikirim segera setelah periode timeout berakhir. |
Kurangi nilainya jika Anda sensitif terhadap latency end-to-end. Tingkatkan nilainya jika Anda menginginkan tingkat pengisian batch yang lebih tinggi. |
Saat Anda menggunakan petunjuk untuk menyesuaikan parameter ini, letakkan petunjuk tersebut setelah tabel yang dilookup:
INSERT INTO order_item_wide
SELECT o.merchant_id, o.order_id, o.item_id, i.item_name, o.amount
FROM orders /*+ OPTIONS('client.lookup.queue-size' = '51200') */ AS o
JOIN items /*+ OPTIONS('client.lookup.queue-size' = '51200') */ AS i
  ON o.merchant_id = i.merchant_id AND o.item_id = i.item_id;