Tim Alibaba Cloud Elasticsearch mengembangkan plugin aliyun-knn, yaitu plugin mesin pencarian vektor berbasis pustaka vektor Proxima dari Akademi DAMO Alibaba. Plugin ini memungkinkan Anda menerapkan pencarian vektor secara cepat untuk berbagai kasus penggunaan seperti Pencarian Gambar, sidik jari video, pengenalan wajah, pengenalan suara, dan rekomendasi produk. Topik ini menjelaskan cara menggunakan plugin aliyun-knn.
Panduan ini ditujukan bagi pelanggan yang menggunakan plugin knn pada instans Elasticsearch lama.
Untuk kasus penggunaan pencarian vektor baru, kami merekomendasikan pembelian instans Elasticsearch (versi 8.15 atau lebih baru) dan menggunakan kemampuan pencarian vektor native mesin tersebut.
Latar Belakang
Kasus Penggunaan
Mesin pencarian vektor Alibaba Cloud Elasticsearch telah terbukti dalam aplikasi produksi berskala besar, termasuk Pailitao, Image Search, pengambilan sampel sidik jari video untuk Qutoutiao, rekomendasi "Tebak Yang Anda Sukai", pencarian personalisasi, dan pencarian lintas media.
Cara Kerja
Fitur pencarian vektor di Alibaba Cloud Elasticsearch merupakan plugin yang dibangun di atas mekanisme ekstensi Elasticsearch. Plugin ini sepenuhnya kompatibel dengan versi Elasticsearch native, sehingga memastikan kurva pembelajaran yang ringan. Indeks vektor mendukung penulisan inkremental real-time dan kueri near real-time (NRT). Plugin ini juga menyediakan semua kemampuan terdistribusi native Elasticsearch, termasuk dukungan untuk beberapa replika dan pemulihan kesalahan.
CatatanPlugin pencarian vektor Alibaba Cloud Elasticsearch tidak mendukung migrasi data menggunakan snapshot OSS atau DataWorks. Kami merekomendasikan penggunaan Logstash.
Algoritma
Mesin pencarian vektor mendukung algoritma Hierarchical Navigable Small World (HNSW) dan linear. Algoritma ini cocok untuk kasus penggunaan dengan dataset kecil yang disimpan dalam memori pada satu mesin. Tabel berikut membandingkan kinerja kedua algoritma tersebut.
Tabel 1. Perbandingan kinerja algoritma HNSW dan linear
Data dalam tabel ini diukur dalam lingkungan Alibaba Cloud Elasticsearch V6.7.0. Lingkungan pengujian dikonfigurasi sebagai berikut:
Konfigurasi instans: Dua node data, masing-masing memiliki 16 core, memori 64 GB, dan disk cloud SSD 100 GB.
Set data: Vektor float SIFT berdimensi 128.
Total data: 20 juta catatan.
Konfigurasi indeks: Parameter default.
Metrik kinerja
HNSW
Linear
Recall top-10
98,6%
100%
Recall top-50
97,9%
100%
Recall top-100
97,4%
100%
Latensi (p99)
0,093 detik
0,934 detik
Latensi (p90)
0,018 detik
0,305 detik
CatatanDalam tabel ini, p berarti persentil. Misalnya, Latensi (p99) adalah waktu di mana 99% kueri dikembalikan.
Prasyarat
Metode instalasi plugin aliyun-knn bervariasi tergantung pada versi kluster Alibaba Cloud Elasticsearch dan versi kernelnya. Untuk detailnya, lihat tabel berikut.
Versi Elasticsearch
Versi kernel
Deskripsi
6.7.0
Lebih awal dari 1.2.0
Anda harus menginstal plugin aliyun-knn secara manual di halaman Plug-ins. Untuk informasi lebih lanjut, lihat Instal atau uninstal plugin default.
Fitur seperti pencarian berbasis skrip dan pemanasan indeks tidak didukung. Jika Anda memerlukan fitur-fitur ini, gunakan kluster dengan versi kernel Alibaba Cloud Elasticsearch. Untuk informasi lebih lanjut, lihat Catatan rilis versi kernel.
Saat membuat indeks vektor, hanya metrik jarak
SquaredEuclideandefault yang didukung. Anda tidak dapat menentukan metrik jarak menggunakan parameterdistance_method.
6.8
N/A
7.4
N/A
7.7
N/A
6.7.0
1.2.0 atau lebih baru
Plugin aliyun-knn diintegrasikan ke dalam plugin apack, yang diinstal secara default. Untuk menginstal atau menguninstal plugin aliyun-knn, Anda harus mengelola plugin apack. Untuk informasi lebih lanjut, lihat Gunakan fitur replikasi fisik plugin apack.
Untuk menggunakan fitur lanjutan seperti pencarian berbasis skrip, pemanasan indeks, dan fungsi tambahan, Anda harus meningkatkan versi kernel ke 1.3.0 atau lebih baru. Untuk petunjuknya, lihat Tingkatkan versi.
Jika terjadi kesalahan parsing mapping saat membuat indeks vektor, tingkatkan versi kernel ke 1.3.0 atau lebih baru dan coba lagi.
7.10.0
1.4.0 atau lebih baru
Plugin aliyun-knn diintegrasikan ke dalam plugin apack, yang diinstal secara default. Untuk menginstal atau menguninstal plugin aliyun-knn, Anda harus mengelola plugin apack. Untuk informasi lebih lanjut, lihat Gunakan fitur replikasi fisik plugin apack.
Jika versi minor kernel adalah 1.4.0 atau lebih baru, plugin apack merupakan versi terbaru dan tidak memerlukan pembaruan. Untuk memeriksa versi plugin, jalankan perintah GET _cat/plugins?v.
Versi lainnya
N/A
Pencarian vektor tidak didukung.
CatatanVersi kernel berbeda dengan versi plugin apack. Untuk memeriksa versi plugin apack, jalankan perintah GET _cat/plugins?v.
Rencanakan indeks Anda.
Algoritma
Kasus penggunaan
In-memory
Lainnya
hnsw
Dataset single-machine kecil.
Kebutuhan latensi rendah.
Kebutuhan recall tinggi.
Ya
Algoritma hnsw didasarkan pada gagasan bahwa "tetangga dari tetangga kemungkinan besar juga merupakan tetangga." Metrik jarak algoritma ini harus memenuhi pertidaksamaan segitiga (jumlah dua sisi segitiga lebih besar dari sisi ketiga). Misalnya, ruang vektor hasil kali dalam tidak memenuhi pertidaksamaan segitiga dan harus dikonversi ke ruang Euclidean atau bola agar dapat menggunakan metode pencarian hnsw.
Setelah menulis data, jalankan forceMerge secara berkala selama jam sepi untuk mengurangi latensi kueri.
linear
Pencarian brute-force.
Recall 100%.
Latensi meningkat seiring volume data.
Gunakan untuk perbandingan garis dasar.
Ya
Tidak ada.
Rencanakan kluster Anda.
Parameter
Deskripsi
Spesifikasi node data (Wajib)
16-core 64 GB atau lebih tinggi.
CatatanPembuatan indeks dengan plugin aliyun-knn sangat intensif sumber daya. Kluster dengan spesifikasi rendah dapat menjadi bottleneck dan memengaruhi stabilitas. Gunakan kluster dengan spesifikasi 16-core 64 GB atau lebih tinggi.
Jenis node
Kluster harus memiliki node master khusus.
Memori off-heap kluster
Lebih dari dua kali ukuran total data vektor dalam kluster.
Contoh: Sebuah indeks berisi satu bidang float berdimensi 960 dan 400 dokumen. Karena float menempati 4 byte, memori yang digunakan untuk data vektor dihitung sebagai berikut: 960 × 400 × 4 = 1,5 MB. Oleh karena itu, memori off-heap harus melebihi 3 MB (1,5 MB × 2).
CatatanJika Anda melakukan operasi force merge, data lama dan baru dimuat ke memori secara bersamaan. Dalam kasus ini, Anda harus menggandakan nilai yang dihitung menggunakan rumus di atas.
Untuk kluster dengan memori 64 GB atau lebih, ukuran memori off-heap kira-kira sama dengan total memori dikurangi 32 GB (memori off-heap ≈ total memori - 32 GB).
Throughput tulis
Pembuatan indeks vektor merupakan tugas yang intensif CPU. Untuk node data 16-core 64 GB, batasi throughput tulis puncak hingga 5.000 tps per node.
Selain itu, selama kueri vektor, semua file indeks dimuat ke memori sistem. Oleh karena itu, hindari penulisan volume besar saat melayani kueri bisnis. Hal ini membantu mencegah restart shard akibat tekanan memori.
CatatanNilai-nilai ini merupakan perkiraan. Rencanakan berdasarkan beban kerja aktual Anda, lakukan pengujian beban terlebih dahulu, dan sediakan memori yang cukup.
Batasan
Plugin aliyun-knn tidak didukung pada instans versi 6.7 dengan fitur shared elastic storage yang diaktifkan.
Untuk menginstal plugin aliyun-knn, node data instans Alibaba Cloud Elasticsearch Anda harus berukuran 16-core 64 GB atau lebih besar. Jika node Anda tidak memenuhi persyaratan ini, Anda harus meningkatkan spesifikasinya. Untuk informasi lebih lanjut, lihat Tingkatkan konfigurasi kluster.
Plugin aliyun-knn tidak kompatibel dengan beberapa fitur kernel AliES yang ditingkatkan, seperti fitur replikasi fisik. Jika fitur ini diaktifkan, Anda harus menonaktifkannya sebelum menggunakan plugin. Untuk petunjuknya, lihat Gunakan fitur replikasi fisik plugin apack.
Anda tidak dapat menggunakan snapshot OSS atau DataWorks untuk migrasi data pada instans yang menggunakan plugin aliyun-knn. Kami merekomendasikan penggunaan Logstash sebagai gantinya.
Buat indeks vektor
Masuk ke konsol Kibana kluster Elasticsearch Anda.
Untuk petunjuknya, lihat Masuk ke konsol Kibana.
CatatanContoh di sini menggunakan Elasticsearch V6.7.0. Operasi mungkin sedikit berbeda untuk versi lainnya.
Di bilah navigasi kiri, pilih .
Di tab Console, jalankan perintah berikut untuk membuat indeks vektor.
PUT test { "settings": { "index.codec": "proxima", "index.vector.algorithm": "hnsw" }, "mappings": { "_doc": { "properties": { "feature": { "type": "proxima_vector", "dim": 2, "vector_type": "float", "distance_method": "SquaredEuclidean" } } } } }CatatanAnda dapat menambahkan jenis bidang lain yang didukung Elasticsearch ke indeks vektor.
Jika terjadi kesalahan parsing mapping saat membuat indeks vektor:
"type": "mapper_parsing_exception",
 "reason": "Mapping definition for [feature] has unsupported parameters: [distance_method : SquaredEuclidean]"
, tingkatkan kernel ke versi terbaru dan coba lagi.
Jenis
Parameter
Default
Deskripsi
setting
index.codec
proxima
Menentukan apakah akan membangun indeks kNN proxima di lapisan dasar. Nilai yang valid:
proxima (Direkomendasikan): Indeks kNN proxima dibangun di lapisan dasar untuk mendukung pencarian vektor.
null: Tidak membangun indeks kNN proxima. Sebagai gantinya, hanya membangun indeks maju. Dalam kasus ini, bidang bertipe proxima_vector hanya mendukung pencarian berbasis skrip dan tidak mendukung pencarian hnsw atau linear.
CatatanUntuk dataset besar di mana latensi kueri bukan prioritas utama, Anda dapat menghapus parameter ini atau mengaturnya ke null. Hal ini memungkinkan Anda melakukan kueri vektor kNN menggunakan pencarian berbasis skrip. Pencarian berbasis skrip didukung jika instans Anda adalah V6.7.0 dengan versi plugin apack 1.2.1 atau lebih baru, atau jika instans Anda adalah V7.10.0 dengan versi plugin apack 1.4.0 atau lebih baru.
index.vector.algorithm
hnsw
Algoritma pencarian vektor. Nilai yang valid:
hnsw: Algoritma HNSW.
linear: Algoritma linear.
index.vector.general.builder.offline_mode
false
Menentukan apakah akan menggunakan mode optimasi offline untuk membangun indeks kNN. Nilai yang valid:
false: Menonaktifkan mode optimasi offline.
true: Mengaktifkan mode optimasi offline. Mode ini mengurangi fragmentasi segmen selama penulisan dan meningkatkan throughput tulis.
CatatanUntuk mengaktifkan mode optimasi offline, instans Anda harus V6.7.0 dengan versi plugin apack 1.2.1 atau lebih baru, atau V7.10.0 dengan versi plugin apack 1.4.0 atau lebih baru. Indeks yang dibangun dalam mode optimasi offline tidak mendukung pencarian data berbasis skrip.
Kami merekomendasikan mengaktifkan mode optimasi offline untuk impor massal satu kali dataset lengkap.
mapping
type
proxima_vector
Jenis bidang vektor. Misalnya, mengatur bidang feature ke proxima_vector menentukan bahwa feature adalah bidang vektor.
dim
2
Dimensi vektor. Parameter ini wajib diisi. Nilainya harus berupa bilangan bulat dari 1 hingga 2048.
vector_type
float
Tipe data vektor. Nilai yang valid:
float: Bilangan floating-point.
short: Bilangan bulat pendek.
binary: Biner.
Untuk tipe binary, data vektor harus direpresentasikan sebagai array bilangan bulat tak bertanda 32-bit (uint32), dan nilai dim harus kelipatan 32.
Misalnya, jika data bisnis Anda adalah nilai biner 64-bit 1000100100100101111000001001111101000011010010011010011010000100, maka vektor yang ditulis adalah [-1994006369, 1128900228].
CatatanKetiga tipe data vektor ini didukung pada instans V6.7.0 dengan versi plugin apack 1.2.1 atau lebih baru, atau V7.10.0 dengan versi plugin apack 1.4.0 atau lebih baru. Versi sebelumnya hanya mendukung tipe float.
distance_method
SquaredEuclidean
Fungsi jarak. Nilai yang valid:
SquaredEuclidean: Jarak Euclidean (tanpa akar kuadrat).
InnerProduct: Hasil kali dalam.
Cosine: Kemiripan kosinus.
Hamming: Jarak Hamming (hanya untuk tipe binary).
CatatanKeempat fungsi jarak ini didukung pada instans V6.7.0 dengan versi plugin apack 1.2.1 atau lebih baru, atau V7.10.0 dengan versi plugin apack 1.4.0 atau lebih baru. Versi sebelumnya hanya mendukung fungsi SquaredEuclidean default. Anda tidak dapat menentukan fungsi jarak lain menggunakan parameter
distance_method.Untuk informasi lebih lanjut tentang fungsi jarak, lihat Fungsi jarak.
Karena fungsi
Hammingmemiliki implementasi khusus, kueriknnstandar tidak didukung saat Anda menggunakan indekshnswataulinear. Hanya kueri berbasis skrip yang kompatibel dengan script_score yang didukung. Anda perlu menguji pernyataan kueri dalam berbagai skenario untuk memastikan bahwa kueri tersebut sesuai dengan kebutuhan bisnis spesifik Anda.
CatatanAnda dapat menjalankan perintah GET /_cat/plugins?v untuk memeriksa versi plugin apack. Jika versinya tidak memenuhi persyaratan, Anda dapat mengajukan tiket untuk meminta peningkatan.
Pencarian vektor kNN juga menyediakan parameter kueri lanjutan. Untuk informasi lebih lanjut, lihat Parameter lanjutan.
Jalankan perintah berikut untuk menambahkan dokumen.
POST test/_doc { "feature": [1.0, 2.0] }CatatanUntuk semua jenis array kecuali binary, panjang array harus sesuai dengan dim. Untuk tipe binary, data vektor harus dikonversi ke array bilangan bulat tak bertanda 32-bit (uint32), dan dim harus kelipatan bulat dari 32.
Pencarian vektor
Pencarian standar
Jalankan perintah berikut untuk melakukan pencarian standar.
GET test/_search
{
  "query": {
    "hnsw": {
      "feature": {
        "vector": [1.5, 2.5],
        "size": 10
      }
    }
  }
}
Tabel berikut menjelaskan parameter umum.
Parameter
Deskripsi
hnsw
Algoritma pencarian vektor. Ini harus sesuai dengan algoritma yang ditentukan saat membuat indeks.
vector
Vektor kueri. Panjang array harus sama dengan dim yang ditentukan dalam mapping saat membuat indeks.
size
Menentukan jumlah dokumen yang akan dikembalikan.
CatatanParameter size dalam pencarian vektor berbeda dengan parameter size bawaan Elasticsearch. Yang pertama mengontrol jumlah dokumen yang dikembalikan oleh plugin kNN, sedangkan yang terakhir mengontrol jumlah total dokumen yang dikembalikan oleh seluruh kueri. Saat menjalankan kueri, sistem terlebih dahulu menggunakan parameter size pencarian vektor untuk mengambil jumlah dokumen teratas yang ditentukan. Kemudian, sistem menerapkan parameter size bawaan Elasticsearch pada hasil sebelum mengembalikan set dokumen akhir.
Kami merekomendasikan agar Anda mengatur parameter size pencarian vektor ke nilai yang sama dengan parameter size bawaan Elasticsearch, yang default-nya adalah 10.
CatatanPencarian vektor kNN juga menyediakan parameter kueri lanjutan. Untuk informasi lebih lanjut, lihat Parameter lanjutan.
Kueri skrip
Kueri skrip vektor hanya dapat digunakan dengan script_score. Misalnya, Anda dapat menggunakan script_score untuk memberi skor setiap dokumen yang dikembalikan berdasarkan rumus
1/(1+l2Squared(params.queryVector, doc['feature'])). Perintah berikut menunjukkan contohnya.GET test/_search { "query": { "match_all": {} }, "rescore": { "query": { "rescore_query": { "function_score": { "functions": [{ "script_score": { "script": { "source": "1/(1+l2Squared(params.queryVector, doc['feature'])) ", "params": { "queryVector": [2.0, 2.0] } } } }] } } } } }Kueri skrip vektor kNN tidak mendukung fungsi yang disediakan oleh X-Pack. Hanya fungsi-fungsi berikut yang didukung:
Fungsi
Deskripsi
l2Squared(float[] queryVector, DocValues docValues)Fungsi jarak Euclidean.
hamming(float[] queryVector, DocValues docValues)Fungsi jarak Hamming.
cosineSimilarity(float[] queryVector, DocValues docValues)cosine(float[] queryVector, DocValues docValues)
Fungsi kemiripan kosinus.
CatatanUntuk Alibaba Cloud Elasticsearch V6.7, gunakan fungsi
cosineSimilarity(float[] queryVector, DocValues docValues). Untuk V7.10, gunakan fungsicosine(float[] queryVector, DocValues docValues).CatatanUntuk menggunakan fitur kueri skrip, pengaturan Anda harus memenuhi salah satu persyaratan berikut: versi kluster 6.7.0 dengan plugin apack V1.2.1 atau lebih baru, atau versi kluster 7.10.0 dengan plugin apack V1.4.0 atau lebih baru. Anda dapat menjalankan perintah GET /_cat/plugins?v untuk memeriksa versi plugin apack. Jika versinya tidak memenuhi persyaratan, Anda dapat mengajukan tiket untuk meminta peningkatan.
Parameter fungsi:
float[] queryVector: Vektor kueri.
DocValues docValues: Vektor dokumen.
Kueri skrip vektor tidak didukung untuk indeks yang dibangun dengan mode optimasi offline (
index.vector.builder.offlineMode = true).
Pemanasan indeks
Indeks kNN melakukan pencarian penuh dalam memori, yang dapat menyebabkan latensi kueri tinggi dari cold start saat indeks pertama kali dimuat. Fitur pemanasan indeks plugin kNN mencegah hal ini dengan memuat indeks ke memori lokal sebelum melayani permintaan pencarian, sehingga secara signifikan mengurangi latensi cold start.
Panaskan semua indeks vektor.
POST _vector/warmupPanaskan indeks vektor tertentu.
POST _vector/{indexName}/warmup
CatatanUntuk menggunakan fitur pemanasan indeks, pengaturan Anda harus memenuhi salah satu persyaratan berikut: versi kluster 6.7.0 dengan plugin apack V1.2.1 atau lebih baru, atau versi kluster 7.10.0 dengan plugin apack V1.4.0 atau lebih baru. Anda dapat menjalankan perintah GET _cat/plugins?v untuk memeriksa versi plugin apack. Jika versinya tidak memenuhi persyaratan, Anda dapat mengajukan tiket untuk meminta peningkatan.
Jika kluster Anda berisi banyak indeks vektor besar tetapi aplikasi Anda hanya melakukan pencarian vektor pada sebagian kecilnya, panaskan hanya indeks-indeks tertentu tersebut untuk meningkatkan kinerja pencarian dalam memori.
Skor vektor
Pencarian vektor menggunakan rumus skor terpadu berdasarkan fungsi metrik jarak, yang secara langsung memengaruhi peringkat pencarian.
Rumus skor:
skor = 1 / (fungsi jarak vektor + 1)
Secara default, mekanisme skor vektor menggunakan jarak Euclidean kuadrat.
Dalam praktiknya, Anda dapat mengoptimalkan data vektor dan meningkatkan skor dengan bekerja mundur dari skor kueri untuk menentukan jarak antar vektor.
Fungsi pengukuran jarak
Fungsi pengukuran jarak yang berbeda menggunakan mekanisme skor yang berbeda. Tabel berikut merinci fungsi pengukuran jarak yang didukung oleh plugin aliyun-knn.
Fungsi jarak | Deskripsi | Rumus skor | Paling cocok untuk | Contoh |
SquaredEuclidean (Jarak Euclidean kuadrat) | Jarak Euclidean adalah jarak garis lurus antara dua titik dalam ruang multidimensi. Di ruang 2D dan 3D, jarak ini sesuai dengan jarak fisik. | Untuk dua vektor n-dimensi, A = [A1, A2, ..., An] dan B = [B1, B2, ..., Bn]:
Catatan Secara default, skor vektor menggunakan jarak Euclidean kuadrat. | Jarak Euclidean mencerminkan perbedaan absolut dalam nilai komponen vektor. Paling cocok digunakan untuk analisis di mana besarnya perbedaan signifikan, seperti menganalisis kemiripan atau variansi nilai pengguna berdasarkan metrik perilaku. | Untuk vektor 2D [0,0] dan [1,2], jarak Euclidean kuadratnya adalah (1-0)² + (2-0)² = 5. |
Cosine (kemiripan kosinus) | Kemiripan kosinus mengevaluasi kemiripan antara dua vektor dengan menghitung kosinus sudut di antara keduanya. | Untuk dua vektor n-dimensi, A = [A1, A2, ..., An] dan B = [B1, B2, ..., Bn]:
| Kemiripan kosinus berfokus pada orientasi vektor daripada besarnya, sehingga tidak sensitif terhadap nilai absolut. Sangat ideal untuk membandingkan minat pengguna berdasarkan peringkat konten, karena dapat mengoreksi inkonsistensi skala peringkat di antara pengguna yang berbeda. | Untuk vektor 2D [1,1] dan [1,0], kemiripan kosinusnya adalah 0,707. |
InnerProduct (hasil kali dalam) | Hasil kali dalam, juga dikenal sebagai dot product, adalah operasi yang menggabungkan dua vektor bilangan real untuk menghasilkan satu nilai skalar. | Untuk dua vektor n-dimensi, A = [A1, A2, ..., An] dan B = [B1, B2, ..., Bn]:
| Hasil kali dalam mempertimbangkan baik sudut maupun besarnya dua vektor. Ketika vektor dinormalisasi, hasil kali dalam setara dengan kemiripan kosinus. | Untuk vektor 2D [1,1] dan [1,5], hasil kali dalamnya adalah (1*1) + (1*5) = 6. |
Hamming (hanya untuk vektor biner) | Dalam teori informasi, jarak Hamming antara dua string dengan panjang yang sama adalah jumlah posisi di mana karakter yang bersesuaian berbeda. | Untuk dua string biner n-bit, x dan y:
| Umumnya digunakan untuk deteksi dan koreksi kesalahan dalam transmisi data, di mana jumlah bit yang berbeda antara dua kata biner dihitung untuk memperkirakan kesalahan transmisi. | Misalnya, jarak Hamming antara 1011101 dan 1001001 adalah 2. Catatan Saat menggunakan plugin aliyun-knn, data vektor biner harus direpresentasikan sebagai array bilangan bulat tak bertanda 32-bit (uint32), dan nilai parameter |
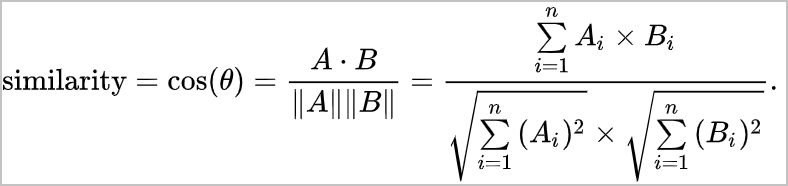
Untuk menggunakan beberapa fungsi pengukuran jarak, pastikan kluster Anda memenuhi salah satu persyaratan berikut: versi kluster 6.7.0 dengan plugin apack V1.2.1 atau lebih baru, atau versi kluster 7.10.0 dengan plugin apack V1.4.0 atau lebih baru. Anda dapat menjalankan perintah GET _cat/plugins?v untuk memeriksa versi plugin apack Anda. Jika versinya tidak memenuhi persyaratan, satu-satunya fungsi pengukuran jarak kNN yang didukung adalah SquaredEuclidean. Jika Anda perlu menggunakan fungsi jarak lain, Anda dapat mengajukan tiket untuk meminta peningkatan plugin.
Anda dapat menentukan fungsi pengukuran jarak menggunakan parameter distance_method dalam mapping indeks.
Parameter pemutus sirkuit
Parameter | Deskripsi | Default |
indices.breaker.vector.native.indexing.limit | Jika penggunaan memori off-heap melebihi ambang batas ini, pemutus sirkuit aktif dan memblokir operasi tulis. Penulisan dilanjutkan setelah proses pembuatan latar belakang selesai dan memori dilepaskan. Aktivasi pemutus sirkuit menunjukkan bahwa konsumsi memori sistem terlalu tinggi. Kami merekomendasikan mengurangi throughput tulis. | 70% |
indices.breaker.vector.native.total.limit | Menentukan persentase maksimum memori off-heap yang dapat digunakan oleh pembuatan indeks vektor latar belakang. Jika penggunaan memori off-heap melebihi batas ini, shard mungkin restart. | 80% |
Parameter pemutus sirkuit vektor merupakan bagian dari konfigurasi kluster. Untuk melihat pengaturannya, jalankan perintah GET _cluster/settings. Jangan mengubah ambang batas pemutus sirkuit.
Parameter lanjutan
Tabel 2. Parameter pembuatan (hnsw)
Parameter | Deskripsi | Default |
index.vector.hnsw.builder.max_scan_num | Mengontrol cakupan pencarian tetangga terdekat selama pembuatan graf untuk memastikan kinerja terburuk. | 100000 |
index.vector.hnsw.builder.neighbor_cnt | Jumlah tetangga untuk setiap node di graf lapisan 0. Kami merekomendasikan nilai 100. Nilai yang lebih tinggi meningkatkan kualitas pembuatan graf tetapi memperbesar ukuran indeks offline. | 100 |
index.vector.hnsw.builder.upper_neighbor_cnt | Jumlah maksimum tetangga untuk setiap node di lapisan atas graf HNSW (semua lapisan kecuali lapisan 0). Kami merekomendasikan mengatur nilai ini menjadi setengah dari nilai neighbor_cnt. Nilai maksimumnya adalah 255. | 50 |
index.vector.hnsw.builder.efconstruction | Mengontrol ukuran daftar kandidat dinamis untuk tetangga terdekat selama pembuatan graf. Nilai yang lebih tinggi meningkatkan kualitas graf offline tetapi memperlambat pembuatan indeks. Kami merekomendasikan nilai awal 400. | 400 |
index.vector.hnsw.builder.max_level | Jumlah total lapisan dalam graf HNSW, termasuk lapisan 0 dan lapisan atas. Misalnya, untuk 10 juta dokumen dengan scaling_factor 30, jumlah lapisannya adalah ceil(log₃₀(10.000.000)), yaitu 5. Parameter ini memiliki dampak kecil terhadap efektivitas. Kami merekomendasikan nilai awal 6. | 6 |
index.vector.hnsw.builder.scaling_factor | Faktor penskalaan eksponensial antar lapisan. Nilai ini biasanya antara 10 dan 100. scaling_factor yang lebih tinggi menghasilkan lebih sedikit lapisan. Kami merekomendasikan nilai awal 50. | 50 |
Parameter di atas harus dikonfigurasi dalam settings indeks dan hanya didukung oleh algoritma hnsw.
Tabel 3. Parameter pencarian (hnsw)
Parameter | Deskripsi | Default |
ef | Mengontrol ukuran daftar kandidat dinamis yang akan dieksplorasi selama pencarian online. Nilai yang lebih tinggi meningkatkan recall tetapi menurunkan kinerja. Kami merekomendasikan nilai antara 100 dan 1000. | 100 |
Contoh kueri:
GET test/_search
{
  "query": {
    "hnsw": {
      "feature": {
        "vector": [1.5, 2.5],
        "size": 10,
        "ef": 100
      }
    }
  }
}
FAQ
T: Bagaimana cara mengevaluasi rasio recall kueri?
J: Buat dua indeks dengan konfigurasi identik, satu menggunakan algoritma HNSW dan yang lain menggunakan algoritma pencarian linear. Dari klien, dorong data vektor yang sama ke kedua indeks. Setelah indeks direfresh, gunakan vektor kueri yang sama untuk mengambil ID dokumen dari keduanya. Rasio recall adalah jumlah ID dokumen yang beririsan dari kedua indeks dibagi dengan jumlah total ID dari indeks pencarian linear.
T: Apa yang harus saya lakukan jika terjadi kesalahan
circuitBreakingExceptionselama penulisan kluster?J: Kesalahan ini menunjukkan bahwa penggunaan memori off-heap telah melebihi ambang batas yang ditentukan oleh indices.breaker.vector.native.indexing.limit (70% secara default), sehingga memicu pemutusan sirkuit pada operasi tulis. Pemutus sirkuit biasanya mereset secara otomatis setelah pembuatan indeks latar belakang selesai dan memori dilepaskan. Kami merekomendasikan menambahkan mekanisme retry pada klien Anda.
T: Mengapa penggunaan CPU tetap tinggi setelah operasi tulis dihentikan?
J: Pembuatan indeks vektor terjadi selama fase refresh atau flush. Bahkan setelah traffic tulis berhenti, tugas latar belakang untuk membangun indeks vektor mungkin terus berjalan. Tugas-tugas ini melepaskan sumber daya komputasi setelah siklus refresh terakhir selesai.
T: Saat melakukan kueri dengan plugin aliyun-knn, saya menerima kesalahan berikut:
class_cast_exception: class org.apache.lucene.index.SoftDeletesDirectoryReaderWrapper$SoftDeletesFilterCodecReader cannot be cast to class org.apache.lucene.index.SegmentReader (org.apache.lucene.index.SoftDeletesDirectoryReaderWrapper$SoftDeletesFilterCodecReader and org.apache.lucene.index.SegmentReader are in unnamed module of loader 'app'). Apa yang harus saya lakukan?J: Nonaktifkan fitur replikasi fisik untuk indeks tersebut. Untuk informasi lebih lanjut, lihat Gunakan fitur replikasi fisik plugin apack.
T: Apa yang dapat saya lakukan jika pencarian vektor dengan plugin aliyun-knn lambat atau terjadi pemutusan sirkuit terkait memori?
J: Plugin aliyun-knn melakukan pencarian vektor menggunakan vektor dalam memori, yang merupakan proses yang intensif memori. Indeks besar dapat menyebabkan kinerja lambat atau memicu pemutusan sirkuit saat dimuat ke memori. Sebagai praktik terbaik, batasi ukuran data indeks Anda hingga setengah dari memori mesin yang tersedia. Jika Anda tidak dapat mengurangi volume data dan memori tetap tidak mencukupi, tingkatkan konfigurasi kluster.
T: Di mana saya dapat menemukan praktik terbaik untuk plugin aliyun-knn?
J: Lihat skenario bisnis dan panduan praktik terbaik di Komunitas Developer Alibaba Cloud.
T: Dalam skenario kNN, kueri
must_not existsgagal memfilter dokumen dengan bidang 'feature' kosong. Bagaimana cara menulis kueri untuk memfilter data ini?J: Mekanisme penyimpanan data kNN bersifat unik dan mungkin tidak kompatibel dengan kueri DSL tertentu. Anda dapat menggunakan skrip berikut untuk memfilter data tersebut.
GET jx-similar-product-v1/_search
{
   "query": {
     "bool": {
       "must": {
         "script": {
           "script": {
             "source": "doc['feature'].empty",
             "lang": "painless"
             }
         }
       }
     }
   }
}