Query Profile mencatat detail eksekusi suatu kueri di instans StarRocks Anda. Gunakan Query Profile untuk mendiagnosis kinerja kueri, mengidentifikasi bottleneck, dan memilih teknik optimasi yang sesuai guna mengatasinya.
Ikhtisar Query Profile
Visualisasi Query Profile
StarRocks Manager mendukung analitik visual untuk Query Profile. Untuk informasi selengkapnya, lihat Pengenalan Query Profile.
Identifikasi bottleneck kueri
Dalam visualisasi Query Profile di StarRocks Manager, operator yang memerlukan waktu lebih lama untuk dijalankan ditampilkan dengan warna lebih gelap. Tiga operator dengan durasi eksekusi terpanjang disorot sehingga bottleneck kueri mudah diidentifikasi.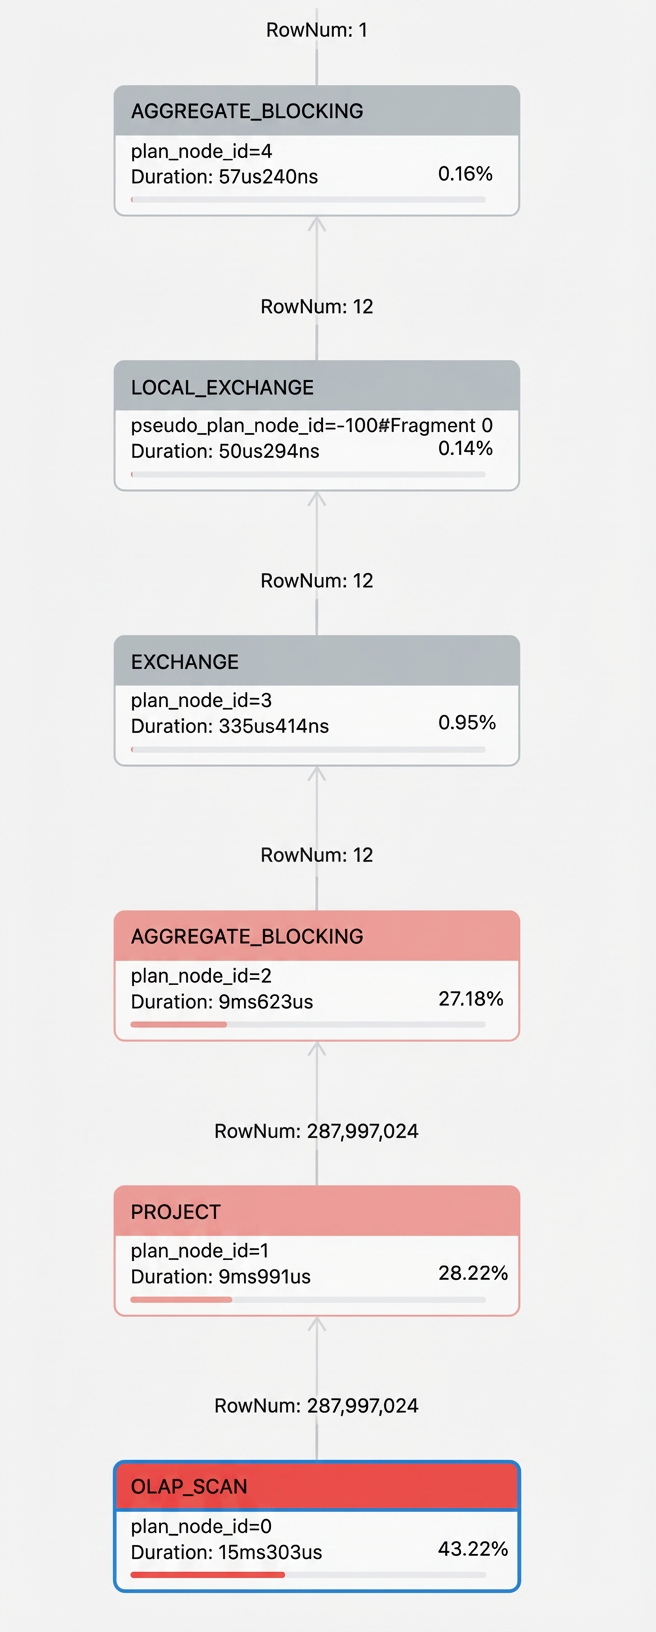
Mengapa waktu CONNECTOR_SCAN lebih lama daripada SCANTIME?
CONNECTOR_SCAN merepresentasikan waktu aktif kumulatif suatu operator di seluruh instans paralelnya. Nilai ini mencakup SCANTIME, IOTaskExecTime, OperatorTotalTime, dan komponen lainnya. Akibatnya, nilai CONNECTOR_SCAN dapat lebih besar secara numerik dibandingkan SCANTIME dari satu instans tunggal.
Studi kasus optimasi
Bagian berikut menjelaskan cara mendiagnosis dan mengatasi masalah umum kinerja kueri di StarRocks:
Optimalkan kueri field besar yang menyebabkan error out-of-memory (OOM)
Saat Anda melakukan kueri pada tabel yang berisi field besar seperti TEXT atau VARCHAR, membaca atau menghitung terlalu banyak data field besar dapat menyebabkan error out-of-memory (OOM). Untuk error batas memori yang disebabkan oleh kesenjangan data, lihat Langkah-langkah optimasi untuk error batas memori (Memory of process exceed limit) yang disebabkan oleh kesenjangan data. Terapkan langkah-langkah berikut untuk mengurangi konsumsi memori:
Hindari
SELECT *. Secara eksplisit tentukan hanya kolom yang Anda butuhkan untuk mengurangi volume data yang dipindai dan dimuat ke dalam memori.Jauhkan field besar dari operasi agregasi seperti
GROUP BYdanDISTINCTguna mencegah pembentukan hasil antara yang terlalu besar.Aktifkan fitur spill to disk untuk mengurangi tekanan memori dengan mengatur variabel sesi
enable_spill=true.Optimalkan skema tabel dengan memindahkan field teks besar ke tabel terpisah, dan simpan hanya indeks serta field kecil di tabel utama. Pendekatan pemisahan tabel ini tidak berlaku dalam skenario agregasi.
Indeks Bitmap
Indeks Bitmap adalah jenis khusus indeks database yang menggunakan larik bit. Setiap bit dalam larik tersebut berkorespondensi dengan satu baris di tabel data. Nilai bit tersebut, yaitu 0 atau 1, ditentukan oleh nilai baris yang bersesuaian.
Gunakan indeks Bitmap untuk meningkatkan kinerja kueri pada kolom yang memiliki kardinalitas rendah dan banyak nilai berulang, seperti kolom
gender.Untuk memeriksa apakah kueri mengenai indeks Bitmap, lihat bidang
BitmapIndexFilterRowsdi Query Profile.
Buat indeks
Buat indeks Bitmap saat Anda membuat tabel.
CREATE TABLE `student_info` (
  `s_stukey` bigint(20) NULL COMMENT "",
  `s_name` varchar(65533) NULL COMMENT "",
  `s_gender` varchar(65533) NULL COMMENT "",
  INDEX index1 (s_gender) USING BITMAP COMMENT 'index1'
) ENGINE=OLAP
DUPLICATE KEY(`s_stukey`)
COMMENT "OLAP"
DISTRIBUTED BY HASH(`s_stukey`);
INSERT INTO student_info
VALUES
    (001,'student#000000019','male'),
    (002,'student#000000020','male'),
    (003,'student#000000021','male'),
    (004,'student#000000022','female');
Buat indeks Bitmap pada tabel yang sudah ada dengan menggunakan
CREATE INDEX.
CREATE INDEX index_name ON table_name (column_name) [USING BITMAP] [COMMENT ''];Periksa progres pembuatan indeks
Jalankan perintah berikut untuk memeriksa progres tugas pembuatan indeks:
SHOW ALTER TABLE COLUMN [FROM db_name];Lihat indeks
Jalankan perintah berikut untuk melihat indeks pada suatu tabel:
SHOW {INDEX[ES] | KEY[S] } FROM [db_name.]table_name [FROM db_name];Output berikut dikembalikan:
MySQL [db_test]> show index from student_info;
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
| Table                  | Non_unique | Key_name | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment |
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
| db_test.student_info   |            | index1   |              | s_gender    |           |             |          |        |      | BITMAP     | index1  |
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
1 row in set (0.01 sec)
Hapus indeks
Jalankan perintah berikut untuk menghapus indeks:
DROP INDEX index_name ON [db_name.]table_name;Uji kueri kolom tunggal
Jalankan kueri yang memfilter kolom
s_gender.select * from student_info where s_gender='male';Lihat Profil.
Klik OLAP_SCAN, lalu klik tab Node Details di sebelah kanan. Filter metrik untuk
Bitmapguna memastikan bahwa indeks Bitmap telah berlaku.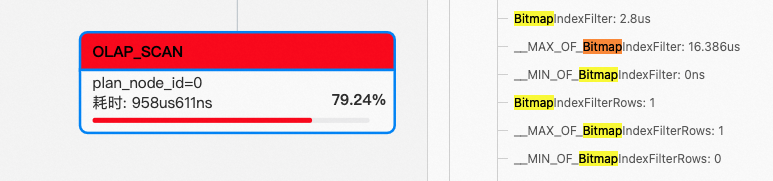
Indeks Bloom filter
Indeks Bloom filter secara cepat menentukan apakah suatu file data berisi data target. Jika tidak, file tersebut dilewati, sehingga mengurangi volume data yang dipindai. Bloom filter hemat ruang dan cocok untuk kolom dengan kardinalitas tinggi, seperti kolom ID.
Pada model Primary Key dan Duplicate, Anda dapat membuat indeks Bloom filter pada kolom apa pun. Pada model Aggregate dan Update, Anda hanya dapat membuat indeks Bloom filter pada kolom kunci.
Indeks Bloom filter tidak didukung untuk kolom dengan tipe data TINYINT, FLOAT, DOUBLE, atau DECIMAL.
Indeks Bloom filter hanya meningkatkan kinerja untuk kueri yang mengandung predikat
inatau=, sepertiSELECT ... WHERE ... IN ()danSELECT ... WHERE column = ....Untuk memeriksa apakah kueri mengenai indeks Bloom filter, lihat bidang
BloomFilterFilterRowsdi Query Profile.
Buat indeks
Saat membuat tabel, Anda dapat membuat indeks Bloom filter dengan menentukan bloom_filter_columns dalam klausa PROPERTIES. Contoh berikut menunjukkan cara melakukannya.
CREATE TABLE table1
(
  k1 BIGINT,
  k2 LARGEINT,
  v1 VARCHAR(2048) REPLACE,
  v2 SMALLINT DEFAULT "10"
)
ENGINE = olap
PRIMARY KEY(k1, k2)
DISTRIBUTED BY HASH (k1, k2) BUCKETS 10
PROPERTIES("bloom_filter_columns" = "k1,k2"); -- Pisahkan beberapa kolom indeks dengan koma (,).
Lihat indeks
Jalankan perintah berikut untuk melihat indeks pada suatu tabel:
SHOW CREATE TABLE table1;Ubah indeks
Contohnya:
Tambahkan indeks Bloom filter untuk kolom
v1.
ALTER TABLE table1 SET ("bloom_filter_columns" = "k1,k2,v1");Hapus indeks Bloom filter untuk kolom
k2.
ALTER TABLE table1 SET ("bloom_filter_columns" = "k1");Hapus semua indeks Bloom filter dari
table1.
ALTER TABLE table1 SET ("bloom_filter_columns" = "");Contoh
Ambil tabel
customerdari TPC-H sebagai contoh. Tambahkan indeks Bloom filter pada kolom kardinalitas tinggi yang bukan kunci pengurutan, seperti kolomc_phone.ALTER TABLE tpc_h_sf100.customer SET ("bloom_filter_columns" = "c_custkey, c_phone");Lihat indeks untuk memastikan bahwa indeks Bloom filter telah ditambahkan.
SHOW CREATE TABLE tpc_h_sf100.customer;| customer | CREATE TABLE `customer` ( `c_custkey` bigint(20) NULL COMMENT "", `c_name` varchar(65533) NULL COMMENT "", `c_address` varchar(65533) NULL COMMENT "", `c_nationkey` bigint(20) NULL COMMENT "", `c_phone` varchar(65533) NULL COMMENT "", `c_acctbal` double NULL COMMENT "", `c_mktsegment` varchar(65533) NULL COMMENT "", `c_comment` varchar(65533) NULL COMMENT "", `Gender` varchar(65533) NULL DEFAULT "default_value" COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`c_custkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`c_custkey`) BUCKETS 24 PROPERTIES ( "replication_num" = "1", "bloom_filter_columns" = "c_custkey, c_phone", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false", "compression" = "LZ4" ); |Jalankan kueri yang memfilter kolom
c_phone.select * from tpc_h_sf100.customer where c_phone = "10-334-921-5346";Lihat Profil.
Klik OLAP_SCAN, lalu klik tab Node Details di sebelah kanan. Temukan metrik
BloomFilterFilterRowsuntuk memastikan bahwa indeks Bloom filter aktif.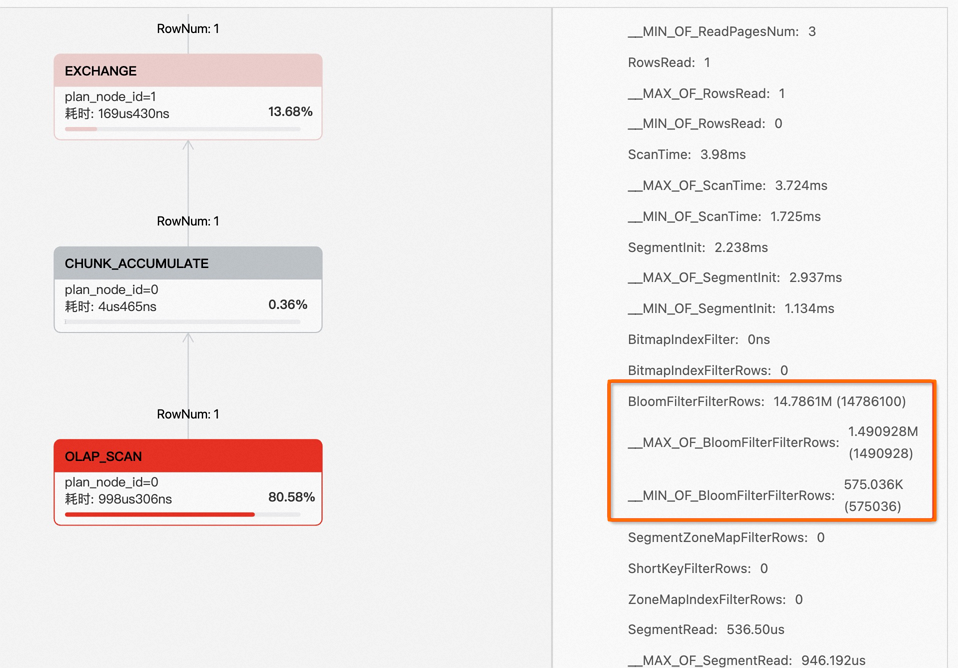
Optimalkan untuk kesenjangan data
Contoh ini menggunakan tabel lineitem dari TPC-H dan memilih kolom dengan distribusi nilai tidak merata sebagai kunci bucketing untuk menunjukkan masalah kesenjangan data. Dalam contoh ini, kolom l_tag memiliki nilai yang sama di setiap baris, sehingga menghasilkan kesenjangan data ekstrem.
Buat data uji. Tambahkan kolom baru ke tabel
lineitemdari TPC-H untuk digunakan sebagai kunci distribusi.CREATE TABLE `lineitem_tag` ( `l_orderkey` bigint(20) NULL COMMENT "", `l_partkey` bigint(20) NULL COMMENT "", `l_suppkey` bigint(20) NULL COMMENT "", `l_linenumber` int(11) NULL COMMENT "", `l_quantity` double NULL COMMENT "", `l_extendedprice` double NULL COMMENT "", `l_discount` double NULL COMMENT "", `l_tax` double NULL COMMENT "", `l_returnflag` varchar(65533) NULL COMMENT "", `l_linestatus` varchar(65533) NULL COMMENT "", `l_shipdate` date NULL COMMENT "", `l_commitdate` date NULL COMMENT "", `l_receiptdate` date NULL COMMENT "", `l_shipinstruct` varchar(65533) NULL COMMENT "", `l_shipmode` varchar(65533) NULL COMMENT "", `l_comment` varchar(65533) NULL COMMENT "", `l_tag` varchar(65533) default 'false' COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`l_orderkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`l_tag`) BUCKETS 96 PROPERTIES ( "replication_num" = "1", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false" ); insert into lineitem_tag select *, 'false' as l_tag from tpc_h_sf100.lineitem;Jalankan kueri untuk melakukan pemindaian tabel penuh.
select count(1) from lineitem_tag;Lihat Profil.
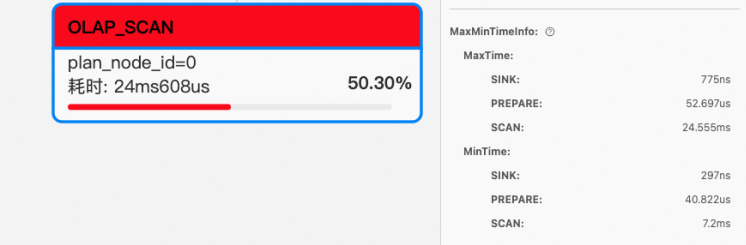
Klik OLAP_SCAN dan buka tab Node di sebelah kanan. Bandingkan waktu SCAN di bawah MaxTime dan MinTime. Jika waktu tersebut berbeda hingga beberapa orde besaran, kemungkinan besar telah terjadi kesenjangan data.
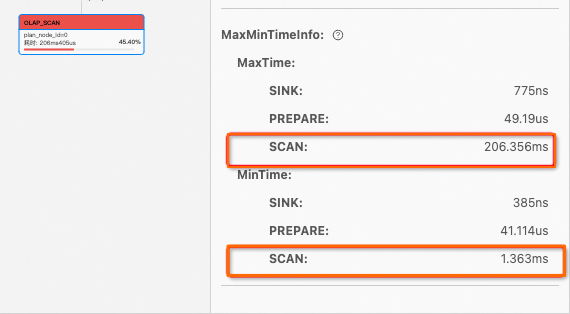
Optimalkan skema tabel dengan mendefinisikan ulang kunci distribusi. Buat tabel baru bernama
lineitem2dan ubah kunci bucketing daril_tagmenjadil_orderkeyuntuk mengatasi kesenjangan data. Pernyataan berikut membuat tabel tersebut, di mana perubahan pentingnya adalahDISTRIBUTED BY HASH(`l_orderkey`) BUCKETS 96.CREATE TABLE `lineitem2` ( `l_orderkey` bigint(20) NULL COMMENT "", `l_partkey` bigint(20) NULL COMMENT "", `l_suppkey` bigint(20) NULL COMMENT "", `l_linenumber` int(11) NULL COMMENT "", `l_quantity` double NULL COMMENT "", `l_extendedprice` double NULL COMMENT "", `l_discount` double NULL COMMENT "", `l_tax` double NULL COMMENT "", `l_returnflag` varchar(65533) NULL COMMENT "", `l_linestatus` varchar(65533) NULL COMMENT "", `l_shipdate` date NULL COMMENT "", `l_commitdate` date NULL COMMENT "", `l_receiptdate` date NULL COMMENT "", `l_shipinstruct` varchar(65533) NULL COMMENT "", `l_shipmode` varchar(65533) NULL COMMENT "", `l_comment` varchar(65533) NULL COMMENT "", `l_tag` varchar(65533) NULL DEFAULT "default_value" COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`l_orderkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`l_orderkey`) BUCKETS 96 PROPERTIES ( "replication_num" = "1", "bloom_filter_columns" = "l_orderkey", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false", "compression" = "LZ4" );Lihat Profil lagi. Bandingkan waktu SCAN di bawah MaxTime dan MinTime. Anda dapat melihat bahwa masalah kesenjangan data telah dikurangi.
Langkah-langkah optimasi untuk error batas memori (Memory of process exceed limit) yang disebabkan oleh kesenjangan data
Kesenjangan data juga dapat menyebabkan kueri gagal dengan error Memory of process exceed limit. Untuk error OOM yang disebabkan oleh field besar, lihat Optimalkan kueri field besar yang menyebabkan error out-of-memory (OOM). Jika Anda mengalami error batas memori akibat kesenjangan data, coba optimasi berikut selain mengubah kunci bucketing:
Optimalkan strategi bucketing: Gunakan kolom kardinalitas tinggi sebagai kunci bucketing, gabungkan beberapa kolom untuk bucketing, atau terapkan salting atau bucketing acak pada nilai panas.
Sesuaikan strategi eksekusi JOIN: Gunakan Broadcast Join saat menggabungkan tabel kecil dengan tabel besar. Saat menggabungkan dua tabel besar, pastikan kunci gabungan tersebar merata, atau gunakan
DISTRIBUTE BYuntuk mendistribusikan ulang data.Sesuaikan dan optimalkan parameter resource secara dinamis: Ubah metode bucketing tabel yang ada, tingkatkan parameter eksekusi konkuren BE seperti
parallel_fragment_exec_instance_num, atau tambahkan lebih banyak node BE atau replika untuk menyebarkan beban.
Tampilan yang di-materialisasi tabel tunggal
Tampilan yang di-materialisasi tabel tunggal (juga dikenal sebagai Rollup) di StarRocks adalah jenis khusus indeks yang tidak dapat dikueri secara langsung. Jika gudang data Anda berisi banyak kueri kompleks atau berulang, Anda dapat membuat tampilan yang di-materialisasi tabel tunggal untuk mempercepatnya.
Uji kueri
Ambil tabel
lineitemdari TPC-H sebagai contoh dan jalankan kueri.select l_returnflag,l_linestatus,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode;Kueri awal membutuhkan waktu 1.115 ms untuk diselesaikan karena belum ada tampilan yang di-materialisasi.
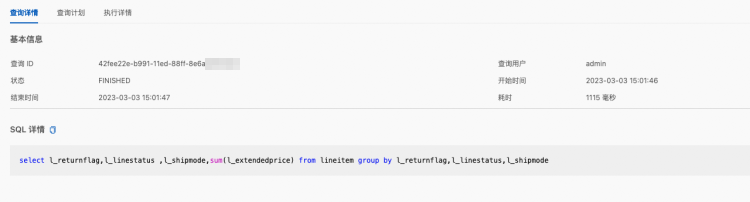
Lihat Profil.
Klik OLAP_SCAN dan buka tab Node di sebelah kanan. Anda dapat melihat bahwa Rollup memindai tabel
lineitemitu sendiri.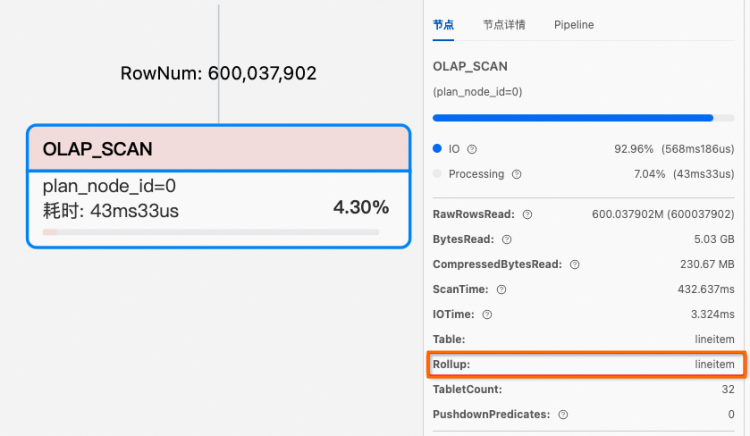
Buat tampilan yang di-materialisasi
Jalankan perintah berikut untuk membuat tampilan yang di-materialisasi tabel tunggal:
CREATE MATERIALIZED VIEW material_test AS select l_returnflag,l_linestatus ,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode;Verifikasi keberhasilan penggunaan tampilan yang di-materialisasi
Gunakan perintah
EXPLAINuntuk memeriksa apakah kueri mengenai tampilan yang di-materialisasi tabel tunggal.explain select l_returnflag,l_linestatus ,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode;Dalam hasil yang dikembalikan,
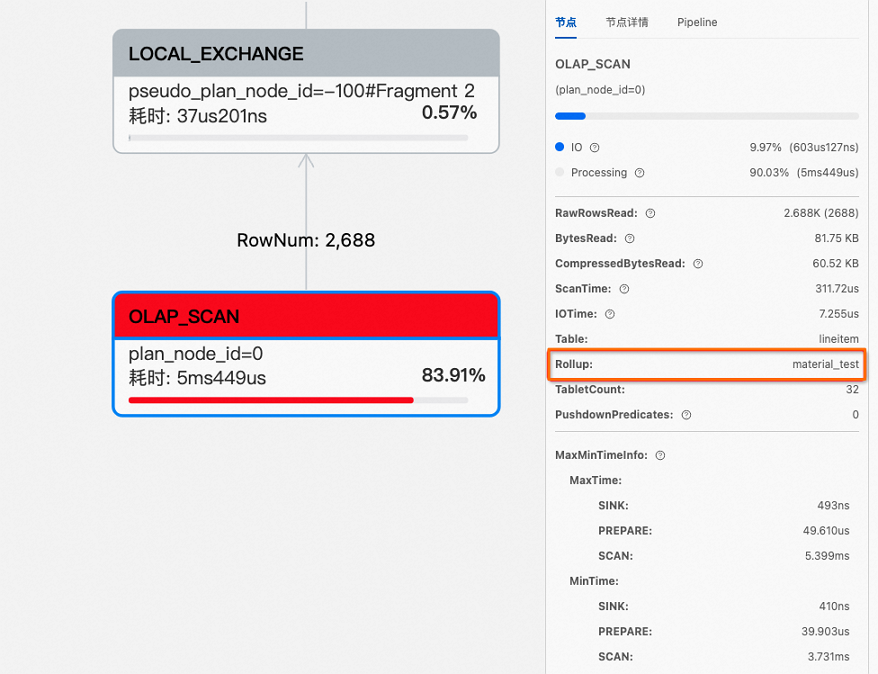
rollup: material_testmenunjukkan bahwa kueri mengenai tampilan yang di-materialisasi bernamamaterial_test.0:OlapScanNode TABLE: lineitem PREAGGREGATION: OFF. Reason: null partitions=1/1 rollup: material_test tabletRatio=96/96 tabletList=15646,15648,15650,15652,15654,15656,15658,15660,15662,15664 ... cardinality=600037902 avgRowSize=14.285666 numNodes=0Lihat Profil.
Klik OLAP_SCAN. Di tab Node di sebelah kanan, Anda dapat melihat bahwa kueri mengenai tampilan yang di-materialisasi dan waktu kueri berkurang menjadi 0,05 ms.
Verifikasi apakah JoinRuntimeFilter aktif
Saat tabel kanan dalam operasi JOIN membangun tabel hash, Runtime Filter dibuat. Filter ini dikirim ke sisi kiri pohon kueri dan didorong ke operator scan bila memungkinkan. Anda dapat melihat metrik terkait JoinRuntimeFilter di tab Node Details operator scan.
Ambil
query72.sqldari TPC-DS sebagai contoh.select i_item_desc, w_warehouse_name, d1.d_week_seq, sum(case when p_promo_sk is null then 1 else 0 end) no_promo, sum(case when p_promo_sk is not null then 1 else 0 end) promo, count(*) total_cnt from inventory join catalog_sales on (cs_item_sk = inv_item_sk) join warehouse on (w_warehouse_sk=inv_warehouse_sk) join item on (i_item_sk = cs_item_sk) join customer_demographics on (cs_bill_cdemo_sk = cd_demo_sk) join household_demographics on (cs_bill_hdemo_sk = hd_demo_sk) join date_dim d1 on (cs_sold_date_sk = d1.d_date_sk) join date_dim d2 on (inv_date_sk = d2.d_date_sk) join date_dim d3 on (cs_ship_date_sk = d3.d_date_sk) left outer join promotion on (cs_promo_sk=p_promo_sk) left outer join catalog_returns on (cr_item_sk = cs_item_sk and cr_order_number = cs_order_number) where d1.d_week_seq = d2.d_week_seq and inv_quantity_on_hand < cs_quantity and d3.d_date > (cast(d1.d_date AS DATE) + interval '5' day) and hd_buy_potential = '>10000' and d1.d_year = 1999 and cd_marital_status = 'D' group by i_item_desc,w_warehouse_name,d1.d_week_seq order by total_cnt desc, i_item_desc, w_warehouse_name, d1.d_week_seq limit 100;Lihat Profil.
Klik OLAP_SCAN, lalu klik tab Node Details di sebelah kanan. Anda dapat melihat bahwa JoinRuntimeFilter dipicu saat operator scan memindai tabel
inventory.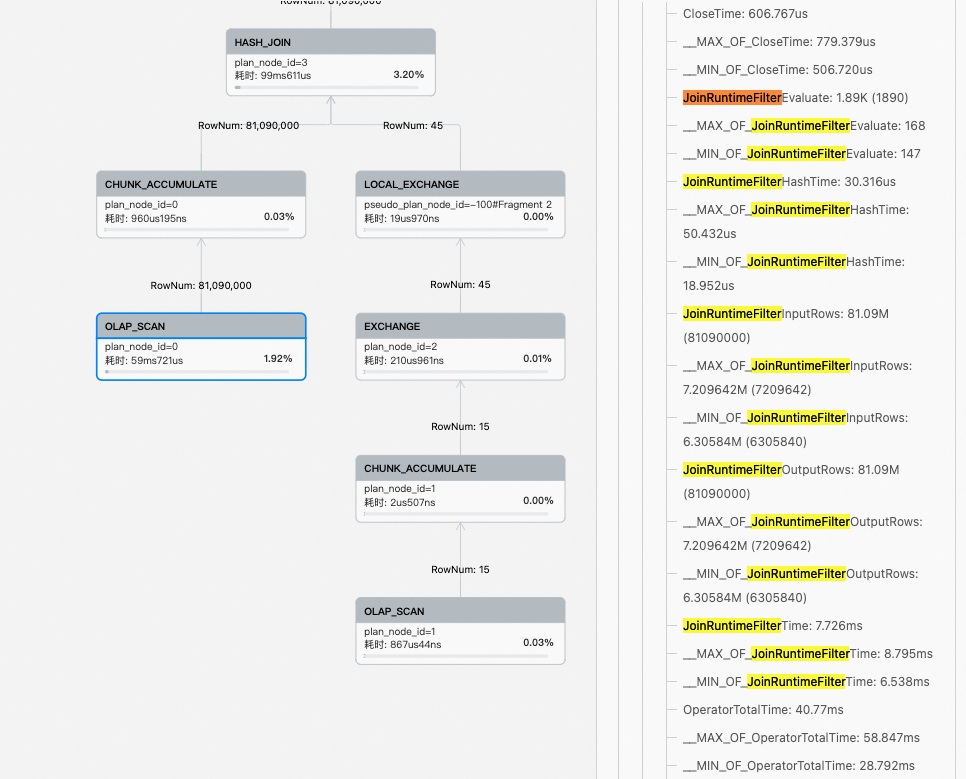
Colocate Join
Untuk menggunakan Colocate Join di StarRocks, tetapkan tabel ke Colocation Group (CG) saat Anda membuatnya. Tabel dalam CG yang sama harus mengikuti Colocation Group Schema (CGS) yang sama agar datanya didistribusikan di set node BE yang sama. Saat kolom gabungan juga merupakan kunci bucketing, node komputasi hanya perlu melakukan join lokal, sehingga mengurangi waktu transfer data antar node. Berbeda dengan Shuffle Join atau Broadcast Join, Colocate Join menghindari transfer data jaringan dan meningkatkan kinerja kueri.
Buat tabel colocated
StarRocks hanya mendukung operasi Colocate Join pada tabel dalam database yang sama.
Jalankan pernyataan berikut untuk membuat tabel dalam Colocation Group:
CREATE TABLE tbl (k1 int, v1 int sum)
DISTRIBUTED BY HASH(k1)
BUCKETS 8
PROPERTIES(
    "colocate_with" = "group1"
);
Penghapusan otomatis Colocation Group
Saat tabel terakhir dalam suatu Grup dihapus secara permanen, Grup tersebut juga secara otomatis dihapus. Penghapusan permanen berarti tabel dihapus dari Recycle Bin. Setelah Anda menghapus tabel menggunakan perintah DROP TABLE, tabel tersebut tetap berada di Recycle Bin selama satu hari secara default sebelum dihapus secara permanen.
Lihat informasi grup
Contohnya, jalankan perintah berikut untuk melihat informasi grup.
SHOW PROC '/colocation_group';Perintah tersebut mengembalikan informasi berikut.
+-------------+--------------+----------+------------+----------------+----------+----------+
| GroupId     | GroupName    | TableIds | BucketsNum | ReplicationNum | DistCols | IsStable |
+-------------+--------------+----------+------------+----------------+----------+----------+
| 11912.11916 | 11912_group1 | 11914    | 8          | 3              | int(11)  | true     |
+-------------+--------------+----------+------------+----------------+----------+----------+
Tabel berikut menjelaskan kolom-kolom tersebut.
Kolom | Deskripsi |
GroupId | Identifier unik grup di seluruh kluster. Bagian pertama adalah ID database, dan bagian kedua adalah ID grup. |
GroupName | Nama lengkap grup. |
TableIds | Daftar ID tabel yang termasuk dalam grup ini. |
BucketsNum | Jumlah bucket. |
ReplicationNum | Jumlah replika. |
DistCols | Tipe data kolom distribusi. |
IsStable | Menunjukkan apakah grup tersebut stabil. |
Anda dapat menjalankan perintah berikut untuk melihat distribusi data grup tertentu.
SHOW PROC '/colocation_group/GroupId';
SHOW PROC '/colocation_group/11912.11916';
Perintah tersebut mengembalikan informasi berikut.
+-------------+---------------------+
| BucketIndex | BackendIds          |
+-------------+---------------------+
| 0           | 10002, 10004, 10003 |
| 1           | 10002, 10004, 10003 |
| 2           | 10002, 10004, 10003 |
| 3           | 10002, 10004, 10003 |
| 4           | 10002, 10004, 10003 |
| 5           | 10002, 10004, 10003 |
| 6           | 10002, 10004, 10003 |
| 7           | 10002, 10004, 10003 |
+-------------+---------------------+
8 rows in set (0.00 sec)
Ubah properti grup
Jalankan pernyataan berikut untuk memindahkan tabel ke Colocation Group yang berbeda:
ALTER TABLE tbl SET ("colocate_with" = "group_name");Contoh
Tetapkan tabel
ordersdanlineitemdalam dataset TPC-H ke Colocation Group yang sama.use tpc_h_sf100; ALTER TABLE orders SET ("colocate_with" = "cg_tpc_orders"); ALTER TABLE lineitem SET ("colocate_with" = "cg_tpc_orders");Jalankan kueri berikut.
select count(1) from orders as o join lineitem as l on o.o_orderkey = l.l_orderkey;Periksa apakah Colocate Join aktif di tab Query Plan untuk kueri di antarmuka StarRocks Manager.
Saat
colocatebernilai true, Colocate Join telah berlaku. Dalam rencana eksekusi, hal ini muncul sebagaicolocate: true. Fragmen rencana kueri yang bersesuaian adalah:
2:HASH JOIN
|  join op: INNER JOIN (COLOCATE)
|  colocate: true
|  equal join conjunct: 10: l_orderkey = 1: o_orderkey
|
|----1:OlapScanNode
|       TABLE: orders
|       PREAGGREGATION: ON
|       PREDICATES: 1: o_orderkey IS NOT NULL
|       partitions=1/1
|       rollup: orders
|       tabletRatio=96/96
|       tabletList=12403,12405,12407,12409,12411,12413,12415,12417,12419,12421 ...
|       cardinality=135000000
|       avgRowSize=1.0
|       numNodes=0
Verifikasi pemangkasan bucket dan partisi
Di tab Query Plan untuk kueri Anda di antarmuka StarRocks Manager, Anda dapat melihat parameter partition atau tabletRatio untuk memverifikasi apakah pemangkasan partisi atau pemangkasan bucket aktif.
Bagaimana cara mengatasi kenaikan memori FE yang terus-menerus hingga memicu peringatan memori?
Saat memori FE terus meningkat dan memicu peringatan memori, atasi masalah tersebut dengan urutan berikut:
Periksa pembengkakan metadata — Jalankan
SHOW PROC '/statistic'dan periksa totalTabletNum. TotalTabletNumdi atas 1.000.000 menunjukkan adanya pembengkakan metadata.Temukan kueri yang memakan banyak resource — Jika
TabletNumnormal, kueri tabel log audit_starrocks_audit_db_.starrocks_audit_tbl, urutkan catatan berdasarkan konsumsi CPU atau memori, lalu optimalkan pernyataan SQL berbeban tinggi tersebut.Atasi ketidakseimbangan beban — Konfigurasikan SLB dan kolam koneksi sisi klien untuk mengaktifkan penyeimbangan beban di seluruh node FE. Hal ini mencegah permintaan terkonsentrasi pada satu FE Leader, yang menyebabkan lonjakan memori dan GC yang sering.
Optimalkan metode penulisan — Ganti penyisipan
VALUESbesar dengan Stream Load untuk menghilangkan hotspot parsing FE di sumbernya.