Node assignment meneruskan hasil kueri atau output dari node hulu ke node hilir. Node ini mendukung MaxCompute SQL, Python 2, dan Shell, serta secara otomatis menetapkan hasil kueri atau output terakhir ke parameter output (outputs) node tersebut. Node hilir mereferensikan parameter ini untuk mengambil hasilnya.
Catatan penggunaan
Persyaratan versi: Hanya tersedia di DataWorks Edisi Standar dan yang lebih baru.
Izin: Akun RAM Anda harus ditambahkan ke workspace target dan diberi peran developer atau administrator workspace. Untuk informasi selengkapnya, lihat Tambahkan anggota ke workspace.
Konsep utama: Pengiriman dan referensi parameter
Fungsi inti node assignment adalah pengiriman parameter, yang mentransfer data dari node hulu ke node hilir.
Node assignment hulu: Menghasilkan data dan secara otomatis menetapkan output atau hasil kueri terakhir ke parameter output yang dihasilkan sistem dengan nama
outputs.Node bisnis hilir: Menerima dan menggunakan data tersebut. Konfigurasikan parameter input (misalnya,
param) dan atur nilainya agar mereferensikan parameteroutputsdari node hulu. Hal ini membuat data tersedia untuk kode Anda.
Format parameter
Tabel berikut menjelaskan format parameter yang dikirimkan.
Bahasa | Nilai | Format |
MaxCompute SQL | Output dari pernyataan | Node meneruskan output ke node hilir sebagai array dua dimensi. |
Python 2 | Output dari pernyataan | DataWorks memisahkan string output berdasarkan koma ( Misalnya, jika baris terakhir node assignment menghasilkan Penting Jika output itu sendiri berisi koma, Anda harus melakukan escape terhadap koma tersebut. Misalnya, jika output-nya adalah |
Shell | Output dari pernyataan |
Prosedur
Membuat dan menggunakan node penetapan di konsol
Contoh berikut menunjukkan prosedur umum dengan meneruskan hasil node assignment ke node Shell. Dalam praktiknya, jenis node apa pun dapat berfungsi sebagai node hilir.
Konfigurasikan node assignment hulu
Di alur kerja target, buat dan edit node assignment. Pilih MaxCompute SQL, Python 2, atau Shell, lalu tulis kode yang menghasilkan output yang ingin Anda teruskan ke node hilir.
print '10,20,30,40'Konfigurasikan node Shell hilir
Buat node Shell. Di halaman pengeditan node Shell, referensikan hasil hulu:
Di panel Scheduling Settings di sisi kanan, pilih tab Node Context Parameters.
Di bagian Input Parameters, klik Add parameters.
Di dialog yang muncul, atur parameter output node hulu ke parameter
outputsdari node assignment yang dikonfigurasi pada langkah sebelumnya, dan tentukan Parameter Name kustom untuk parameter input node saat ini (misalnya,param).CatatanSetelah dikonfigurasi, node hilir secara otomatis membuat dependensi terhadap node assignment hulu.
Setelah konfigurasi parameter, Anda dapat menggunakan nilai yang diteruskan dari node hulu dalam kode node Shell hilir dengan format
${param}.
Konfigurasikan node Data Integration hilir
Dalam praktiknya, node sinkronisasi offline Data Integration juga dapat berfungsi sebagai node hilir dari node assignment:
Buat node sinkronisasi offline Data Integration dan hubungkan sebagai node hilir dari node assignment.
Di halaman konfigurasi penjadwalan node sinkronisasi offline, klik tab Node Context Parameters.
Klik Add parameters untuk menambahkan parameter input, lalu atur sumber nilainya ke parameter
outputsdari node assignment hulu.Referensikan parameter tersebut dalam kode node: apit nilai dengan tanda kutip ganda (
"") jika parameter bertipe string. Jangan tambahkan tanda kutip jika parameternya bertipe non-string.
Verifikasi hasil
Kembali ke alur kerja dan klik Deploy di bilah alat. Pilih deployment penuh.
Buka halaman di Pusat Operasi, lalu lakukan Pengujian asap.
Di instans pengujian, periksa apakah hasil akhir sesuai harapan Anda.
Buat node assignment menggunakan OpenAPI
Anda juga dapat membuat node assignment dengan memanggil operasi CreateNode DataWorks OpenAPI.
Untuk membuat node assignment menggunakan OpenAPI, Anda harus menggunakan DataWorks Edisi Standar atau yang lebih baru. Jika Anda menggunakan Edisi Dasar, kesalahan berikut akan dikembalikan: Node type CONTROLLER_ASSIGNMENT requires STANDARD edition or higher.
Untuk membuat node di alur kerja yang sudah ada, panggil ListWorkflowDefinitions untuk mengkueri alur kerja tersebut. Lalu, gunakan Id tingkat atas dari objek alur kerja dalam respons sebagai ContainerId. Jangan gunakan Script.Id.
Konfigurasikan parameter permintaan berikut saat memanggil CreateNode:
ProjectId: ID workspace DataWorks.Scene: atur parameter ini keDATAWORKS_PROJECTsaat membuat node di proyek DataWorks.ContainerId:Idtingkat atas dari alur kerja target. Tentukan parameter ini hanya jika Anda ingin membuat node di alur kerja yang sudah ada.Spec: string JSON FlowSpec yang telah diserialisasi.
Contoh FlowSpec berikut membuat node assignment MaxCompute SQL. Pastikan bahasa skrip, sumber data, dan konten skrip konsisten.
{
  "version": "1.1.0",
  "kind": "Node",
  "spec": {
    "nodes": [
      {
        "recurrence": "Normal",
        "instanceMode": "T+1",
        "datasource": {
          "name": "<MAXCOMPUTE_DATASOURCE_NAME>",
          "type": "odps"
        },
        "script": {
          "language": "odps-sql",
          "runtime": {
            "command": "CONTROLLER_ASSIGNMENT",
            "commandTypeId": 1100
          },
          "content": "SELECT '10' AS value UNION ALL SELECT '20';"
        },
        "trigger": {
          "type": "Scheduler",
          "cron": "00 00 00 * * ?",
          "startTime": "1970-01-01 00:00:00",
          "endTime": "9999-01-01 00:00:00",
          "timezone": "Asia/Shanghai",
          "delaySeconds": 0
        },
        "runtimeResource": {
          "resourceGroup": "<RESOURCE_GROUP_IDENTIFIER>"
        },
        "name": "assignment_node_demo",
        "owner": "<OWNER_ID>"
      }
    ]
  }
}
Parameter Spec dari CreateNode berupa string. Jika Anda menggunakan Python SDK, panggil json.dumps(flow_spec, ensure_ascii=False) untuk menserialisasi FlowSpec sebelum meneruskan nilainya ke CreateNodeRequest.spec. Jangan meneruskan langsung dictionary Python.
Tentukan identifier kelompok sumber daya di spec.nodes[].runtimeResource.resourceGroup. Gunakan identifier kelompok sumber daya, bukan nama tampilannya.
Setelah Anda menentukan ContainerId, field script.path dalam FlowSpec tidak lagi menentukan lokasi node.
Id yang dikembalikan oleh CreateNode adalah ID node aktual yang dihasilkan server dan mungkin berbeda dari nodes[].id dalam FlowSpec. Setelah node dibuat, panggil GetNode dengan Id yang dikembalikan. Verifikasi tipe node, alur kerja, sumber data, dan kelompok sumber daya dalam respons.
Catatan
Hierarki pengiriman: Parameter node assignment hanya dapat diteruskan ke node anak hilir langsung. Pengiriman parameter lintas level tidak didukung.
Batas ukuran: Ukuran maksimum nilai yang dikirimkan adalah 2 MB. Jika output melebihi batas ini, node assignment akan gagal.
Batasan sintaksis:
Komentar tidak didukung dalam kode node assignment. Menambahkan komentar dapat menyebabkan hasil yang tidak terduga.
Sintaksis WITH tidak didukung dalam mode MaxCompute SQL.
Persyaratan sumber data: Jika Anda menggunakan MaxCompute SQL untuk menetapkan nilai, Anda harus mengonfigurasi sumber daya komputasi MaxCompute dan memilih sumber data MaxCompute yang sesuai. Jika Anda menggunakan Python atau Shell untuk menetapkan nilai, Anda tidak perlu mengonfigurasi sumber data MaxCompute. Anda dapat langsung meneruskan hasil assignment ke node hilir, seperti node percabangan.
Contoh: Penjelasan detail berdasarkan bahasa
Format output outputs dan cara node hilir mereferensikannya bervariasi tergantung bahasa. Contoh berikut menggunakan node Shell sebagai node hilir.
Contoh 1: Teruskan hasil kueri MaxCompute SQL
Hasil kueri SQL diteruskan ke node hilir sebagai array dua dimensi.
Konfigurasi node hulu (node assignment - SQL)
Asumsikan kode SQL sebagai berikut dan kueri mengembalikan dua baris dan dua kolom:
SELECT 'beijing', '1001'
UNION ALL
SELECT 'hangzhou', '1002';
Konfigurasi dan output node hilir (node Shell)
Di node Shell, tambahkan parameter input bernama
regiondan referensikan parameteroutputsdari node SQL hulu.Tulis kode berikut untuk membaca data:
echo "Entire result set: ${region}"
echo "First row: ${region[0]}"
echo "First row, second field: ${region[0][1]}"
DataWorks langsung mengurai parameter dan melakukan substitusi statis. Output-nya sebagai berikut:
Entire result set: beijing,1001
hangzhou,1002
First row: beijing,1001
First row, second field: 1001
Contoh 2: Teruskan hasil output Python 2
Output pernyataan print Python 2 dipisahkan berdasarkan koma (,) dan diteruskan ke node hilir sebagai array satu dimensi.
Konfigurasi node hulu (node assignment - Python 2)
Kode Python 2 sebagai berikut:
print 'Electronics, Clothing, Books';Konfigurasi dan output node hilir (node Shell)
Di node Shell, tambahkan parameter input bernama
typesdan referensikan parameteroutputsdari node assignment hulu.Tulis kode berikut untuk membaca data:
# Directly output the entire one-dimensional array
echo "Entire result set: ${types}"

# Output elements by index
echo "Second element: ${types[1]}"
DataWorks langsung mengurai parameter dan melakukan substitusi statis. Output-nya sebagai berikut:
Entire result set: Electronics,Clothing,Books
Second element: Clothing
Logika pemrosesan untuk node Shell mirip dengan Python 2 dan tidak diulang di sini.
Skenario: Pemrosesan batch data tabel partisi lintas beberapa lini bisnis
Contoh ini menunjukkan cara menggunakan node assignment dan node for-each untuk memproses data perilaku pengguna secara batch lintas beberapa lini bisnis, mengotomatiskan pemrosesan data dengan satu set logika yang melayani beberapa lini produk.

Latar belakang
Asumsikan Anda adalah insinyur pengembangan data di perusahaan internet terpadu, bertanggung jawab untuk memproses data dari tiga lini bisnis inti: e-dagang (ecom), keuangan (finance), dan logistik (logistics), dengan kemungkinan penambahan lini bisnis lain di masa depan. Anda perlu menjalankan logika agregasi yang sama pada log perilaku pengguna dari ketiga lini bisnis ini setiap hari untuk menghitung jumlah tampilan halaman harian (PV) per pengguna dan menyimpan hasilnya di tabel agregat terpadu.
Tabel sumber hulu (layer DWD):
dwd_user_behavior_ecom_d: Tabel perilaku pengguna e-dagang.dwd_user_behavior_finance_d: Tabel perilaku pengguna keuangan.dwd_user_behavior_logistics_d: Tabel perilaku pengguna logistik.dwd_user_behavior_${business_line}_d: Tabel perilaku pengguna untuk lini bisnis potensial lain di masa depan.Tabel-tabel ini memiliki skema yang sama dan dipartisi berdasarkan hari (
dt).
Tabel target hilir (layer DWS):
dws_user_summary_d: Tabel agregat pengguna.Tabel ini dipartisi ganda berdasarkan lini bisnis (
biz_line) dan hari (dt) untuk menyimpan hasil agregasi dari semua lini bisnis secara terpadu.
Membuat tugas terpisah untuk setiap lini bisnis mengakibatkan biaya maintenance tinggi dan rentan terhadap kesalahan. Dengan node for-each, Anda hanya perlu memelihara satu set logika pemrosesan, dan sistem secara otomatis melakukan iterasi melalui semua lini bisnis untuk menyelesaikan komputasi.
Persiapan data
Pertama, buat tabel sampel dan masukkan data uji (menggunakan tanggal bisnis 20251010 sebagai contoh).
Kaitkan sumber daya komputasi dengan workspace.
Buka Data Studio untuk pengembangan data dan buat node MaxCompute SQL.
Buat tabel sumber (layer DWD): Tambahkan kode berikut ke node MaxCompute SQL dan jalankan.
-- E-commerce user behavior table
CREATE TABLE IF NOT EXISTS dwd_user_behavior_ecom_d (
    user_id     STRING COMMENT 'User ID',
    action_type STRING COMMENT 'Action type',
    event_time  BIGINT COMMENT 'Event timestamp in milliseconds (Unix)'
)
COMMENT 'E-commerce user behavior log detail table'
PARTITIONED BY (dt STRING COMMENT 'Date partition, format yyyymmdd');
INSERT OVERWRITE TABLE dwd_user_behavior_ecom_d PARTITION (dt='20251010') VALUES
('user001', 'click',        1760004060000), -- 2025-10-10 10:01:00.000
('user002', 'browse',       1760004150000), -- 2025-10-10 10:02:30.000
('user001', 'add_to_cart',  1760004300000); -- 2025-10-10 10:05:00.000
-- Verify e-commerce user behavior table created successfully
SELECT * FROM dwd_user_behavior_ecom_d where dt='20251010';
-- Finance user behavior table
CREATE TABLE IF NOT EXISTS dwd_user_behavior_finance_d (
    user_id     STRING COMMENT 'User ID',
    action_type STRING COMMENT 'Action type',
    event_time  BIGINT COMMENT 'Event timestamp in milliseconds (Unix)'
)
COMMENT 'Finance user behavior log detail table'
PARTITIONED BY (dt STRING COMMENT 'Date partition, format yyyymmdd');
INSERT OVERWRITE TABLE dwd_user_behavior_finance_d PARTITION (dt='20251010') VALUES
('user003', 'open_app',      1760020200000), -- 2025-10-10 14:30:00.000
('user003', 'transfer',      1760020215000), -- 2025-10-10 14:30:15.000
('user003', 'check_balance', 1760020245000), -- 2025-10-10 14:30:45.000
('user004', 'open_app',      1760020300000); -- 2025-10-10 14:31:40.000
-- Verify finance user behavior table created successfully
SELECT * FROM dwd_user_behavior_finance_d where dt='20251010';
-- Logistics user behavior table
CREATE TABLE IF NOT EXISTS dwd_user_behavior_logistics_d (
    user_id     STRING COMMENT 'User ID',
    action_type STRING COMMENT 'Action type',
    event_time  BIGINT COMMENT 'Event timestamp in milliseconds (Unix)'
)
COMMENT 'Logistics user behavior log detail table'
PARTITIONED BY (dt STRING COMMENT 'Date partition, format yyyymmdd');
INSERT OVERWRITE TABLE dwd_user_behavior_logistics_d PARTITION (dt='20251010') VALUES
('user001', 'check_status',    1760032800000), -- 2025-10-10 18:00:00.000
('user005', 'schedule_pickup', 1760032920000); -- 2025-10-10 18:02:00.000
-- Verify logistics user behavior table created successfully
SELECT * FROM dwd_user_behavior_logistics_d where dt='20251010';
Buat tabel target (layer DWS): Tambahkan kode berikut ke node MaxCompute SQL dan jalankan.
CREATE TABLE IF NOT EXISTS dws_user_summary_d ( user_id STRING COMMENT 'User ID', pv BIGINT COMMENT 'Daily activity count' ) COMMENT 'User daily activity summary table' PARTITIONED BY ( dt STRING COMMENT 'Date partition, format yyyymmdd', biz_line STRING COMMENT 'Business line partition, e.g. ecom, finance, logistics' );PentingJika workspace menggunakan mode standar, Anda perlu menerapkan node ini ke lingkungan produksi dan melakukan backfill data.
Implementasi alur kerja
Buat alur kerja. Di bagian Scheduling Parameters di sisi kanan, atur parameter penjadwalan bizdate ke hari sebelumnya:
$[yyyymmdd-1].Di alur kerja, buat node assignment bernama get_biz_list dan tulis kode berikut dalam MaxCompute SQL. Node ini mengeluarkan daftar lini bisnis yang akan diproses:
-- Output all business lines to be processed
SELECT 'ecom' AS biz_line
UNION ALL
SELECT 'finance' AS biz_line
UNION ALL
SELECT 'logistics' AS biz_line;
Konfigurasikan node for-each
Kembali ke halaman alur kerja dan buat node for-each hilir untuk node assignment get_biz_list.
Buka halaman pengaturan node for-each. Di bagian di bawah schedule settings di sisi kanan, bind parameter loopDataArray ke outputs dari node get_biz_list.
Di badan loop node for-each, klik Create Internal Node dan buat node MaxCompute SQL. Tulis logika pemrosesan di dalam badan loop.
CatatanSkrip ini digerakkan oleh node for-each dan dieksekusi sekali untuk setiap lini bisnis.
Variabel bawaan ${dag.foreach.current} secara dinamis diganti dengan nama lini bisnis saat ini pada setiap iterasi. Nilai iterasi yang diharapkan adalah: 'ecom', 'finance', 'logistics'.
SET odps.sql.allow.dynamic.partition=true;
INSERT OVERWRITE TABLE dws_user_summary_d PARTITION (dt='${bizdate}', biz_line)
SELECT
    user_id,
    COUNT(*) AS pv,
    '${dag.foreach.current}' AS biz_line
FROM
    dwd_user_behavior_${dag.foreach.current}_d
WHERE
    dt = '${bizdate}'
GROUP BY
    user_id;
Tambahkan node verifikasi
Kembali ke alur kerja. Klik Create Downstream pada node for-each untuk membuat node MaxCompute SQL dan tambahkan kode berikut.
SELECT * FROM dws_user_summary_d WHERE dt='20251010' ORDER BY biz_line, user_id;
Penerapan dan hasil
Terapkan alur kerja ke lingkungan produksi. Buka halaman di Operation Center. Temukan alur kerja target dan lakukan Pengujian asap dengan tanggal bisnis diatur ke '20251010'.
Setelah eksekusi selesai, lihat log waktu proses di instans pengujian. Output yang diharapkan dari node terakhir adalah sebagai berikut:
user_id | pv | dt | biz_line |
user001 | 2 | 20251010 | ecom |
user002 | 1 | 20251010 | ecom |
user003 | 3 | 20251010 | finance |
user004 | 1 | 20251010 | finance |
user001 | 1 | 20251010 | logistics |
user005 | 1 | 20251010 | logistics |
Keunggulan
Skalabilitas tinggi: Untuk menambahkan lini bisnis baru, cukup tambahkan satu baris SQL di node assignment tanpa mengubah logika pemrosesan.
Maintenance mudah: Semua lini bisnis berbagi satu set logika pemrosesan. Satu modifikasi berlaku untuk semuanya.
FAQ
T: Dalam mode MaxCompute SQL, muncul error "find no select sql in sql assignment!".
J: Kode MaxCompute SQL tidak memiliki pernyataan
SELECT. Tambahkan pernyataanSELECT. Sintaksis WITH tidak didukung; penggunaan pernyataan WITH juga akan menghasilkan error ini.T: Dalam mode Shell atau Python, muncul pesan error "OutPut Result is null, cannot handle!".
J: Output tidak ada. Periksa apakah kode berisi pernyataan print (
printatauecho).T: Dalam mode Shell atau Python, bagaimana menangani elemen output yang berisi koma?
J: Lakukan escape terhadap koma (
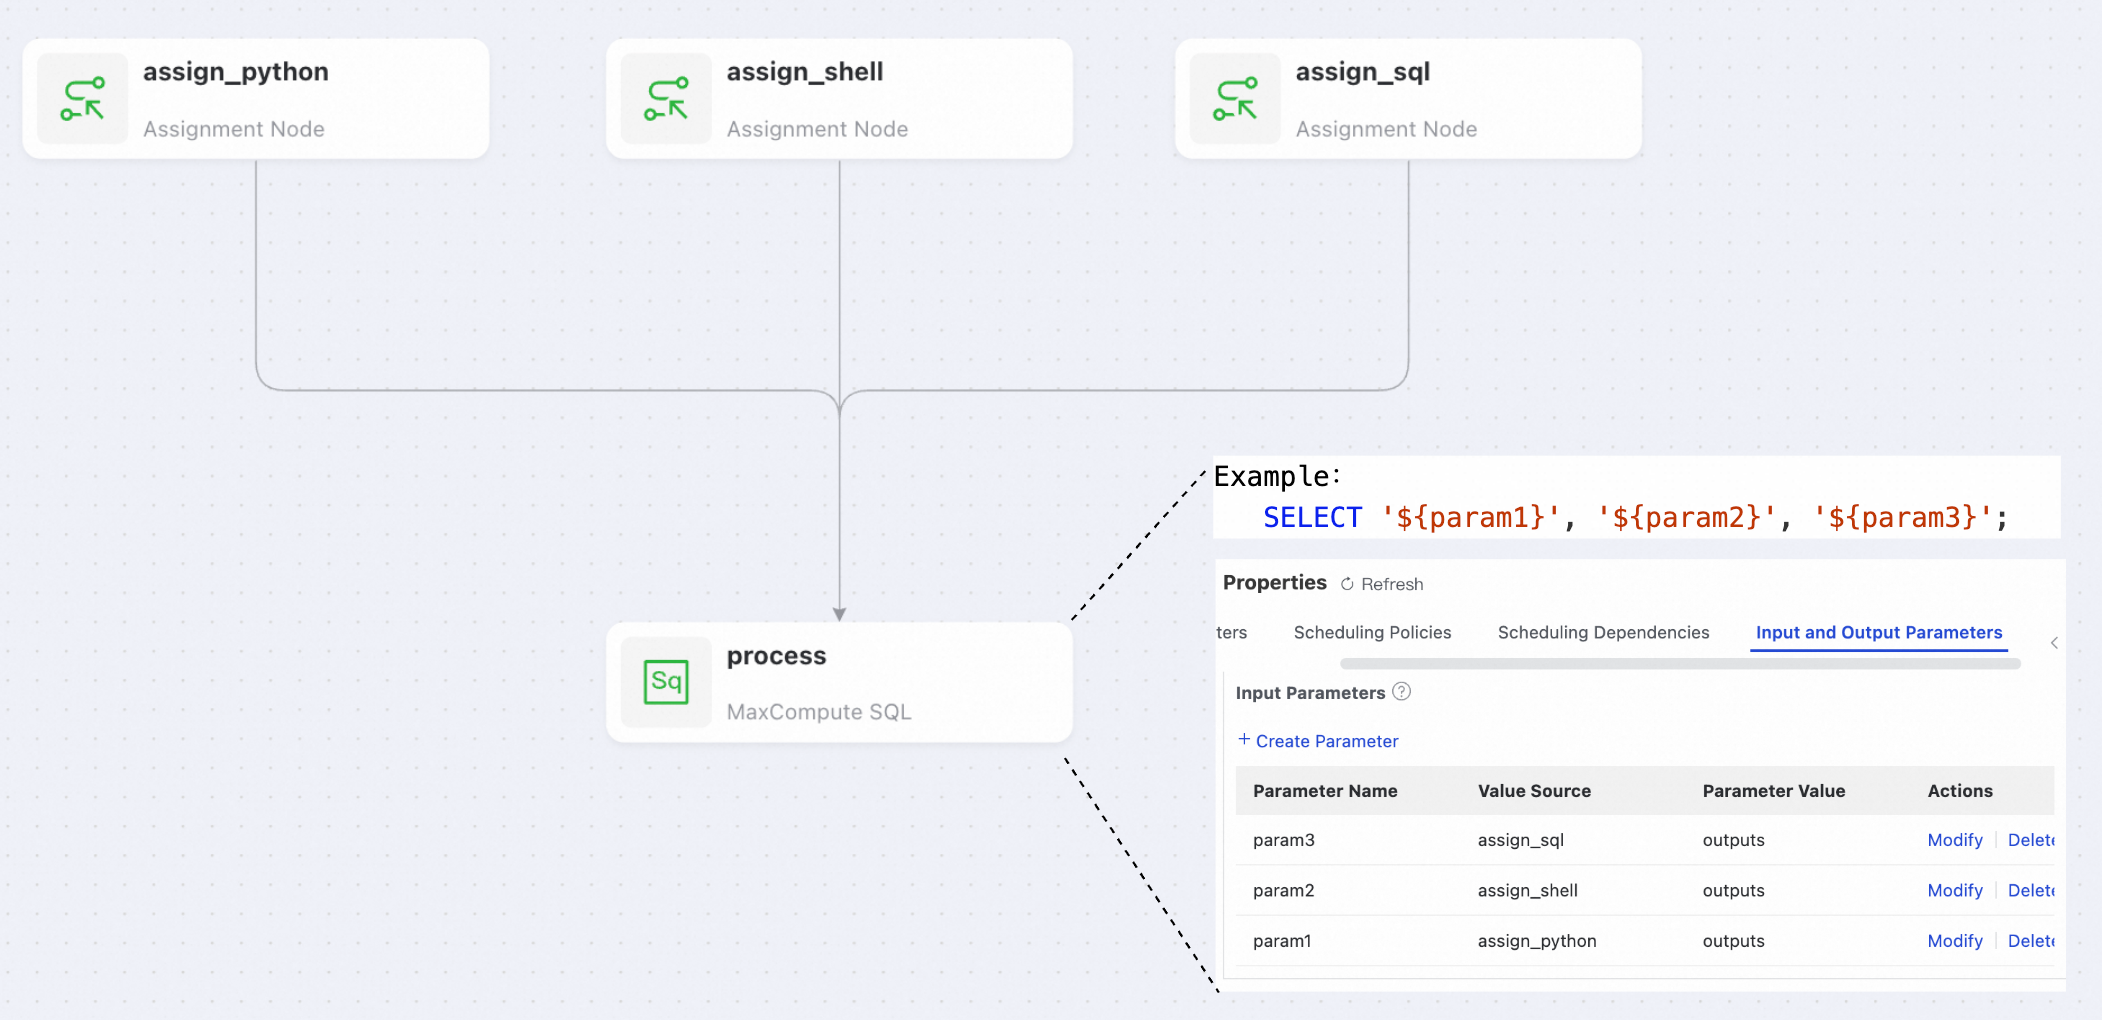
,) dengan menggunakan\,. Contoh berikut menggunakan Python:categories = ["Electronics", "Clothing, Shoes & Accessories"] # Escape commas contained in each element # Replace ',' with '\,' escaped_categories = [cat.replace(",", "\,") for cat in categories] # Join escaped elements with commas output_string = ",".join(escaped_categories) print output_string # The final string output to downstream is: # Electronics,Clothing\, Shoes & AccessoriesT: Apakah node hilir dapat menerima hasil dari beberapa node assignment hulu?
J: Ya. Anda hanya perlu menetapkan hasil dari node yang berbeda ke parameter yang berbeda.
T: Apakah node assignment mendukung jenis bahasa lain?
J: Node assignment saat ini hanya mendukung MaxCompute SQL, Python 2, dan Shell. Beberapa jenis node, seperti EMR Hive, Hologres SQL, EMR Spark SQL, AnalyticDB for PostgreSQL, ClickHouse SQL, dan MySQL, secara native mendukung fitur parameter assignment, yang mencapai efek yang sama.
Di bagian Node Output Parameters, klik + Add Assignment Parameter. Untuk detailnya, lihat:Konfigurasikan dan gunakan parameter konteks node。
Referensi
Jika node hilir perlu melakukan iterasi dan memproses data dalam loop, lihat Node Do-while dan Node For-each.
Jika Anda perlu meneruskan parameter lintas level, lihat Node virtual.
Untuk informasi selengkapnya tentang konfigurasi pengiriman parameter, lihat Parameter konteks node.