Model penskalaan multi-kluster memungkinkan kelompok sumber daya interaktif secara otomatis menskalakan sumber daya komputasi berdasarkan beban kerja kueri. Dengan mendistribusikan kueri ke satu atau beberapa kluster, model ini mendukung isolasi sumber daya dan skenario konkurensi tinggi.
Prasyarat
Kluster AnalyticDB for MySQL Enterprise Edition, Basic Edition, atau Data Lakehouse Edition telah dibuat.
-
Versi minor kluster Anda adalah 3.1.10.0 atau lebih baru.
CatatanUntuk melihat dan memperbarui versi minor, buka bagian Configuration Information pada halaman Cluster Information di Konsol AnalyticDB for MySQL.
Kelompok sumber daya multi-kluster
Tanpa fitur multi-kluster, sebuah kelompok sumber daya hanya menggunakan satu kluster untuk mengeksekusi kueri. Semua kueri yang dikirimkan ke kelompok sumber daya tersebut berbagi sumber daya komputasinya. Jika terlalu banyak kueri berjalan secara bersamaan, mereka saling bersaing untuk mendapatkan sumber daya, sehingga memperlambat performa. Ketika batas konkurensi tercapai, kueri berikutnya akan masuk antrian.
Kelompok sumber daya multi-kluster terdiri dari satu atau beberapa kluster. Kelompok ini menangani beban kerja yang fluktuatif dengan menyediakan sumber daya kluster secara statis atau dinamis. Saat sebuah node akses menerima kueri, sistem menggunakan load balancing untuk menetapkan kueri tersebut ke kluster tertentu dalam kelompok sumber daya. Kueri pada kluster yang berbeda berjalan secara independen dan tidak saling mengganggu, seperti yang ditunjukkan pada gambar berikut.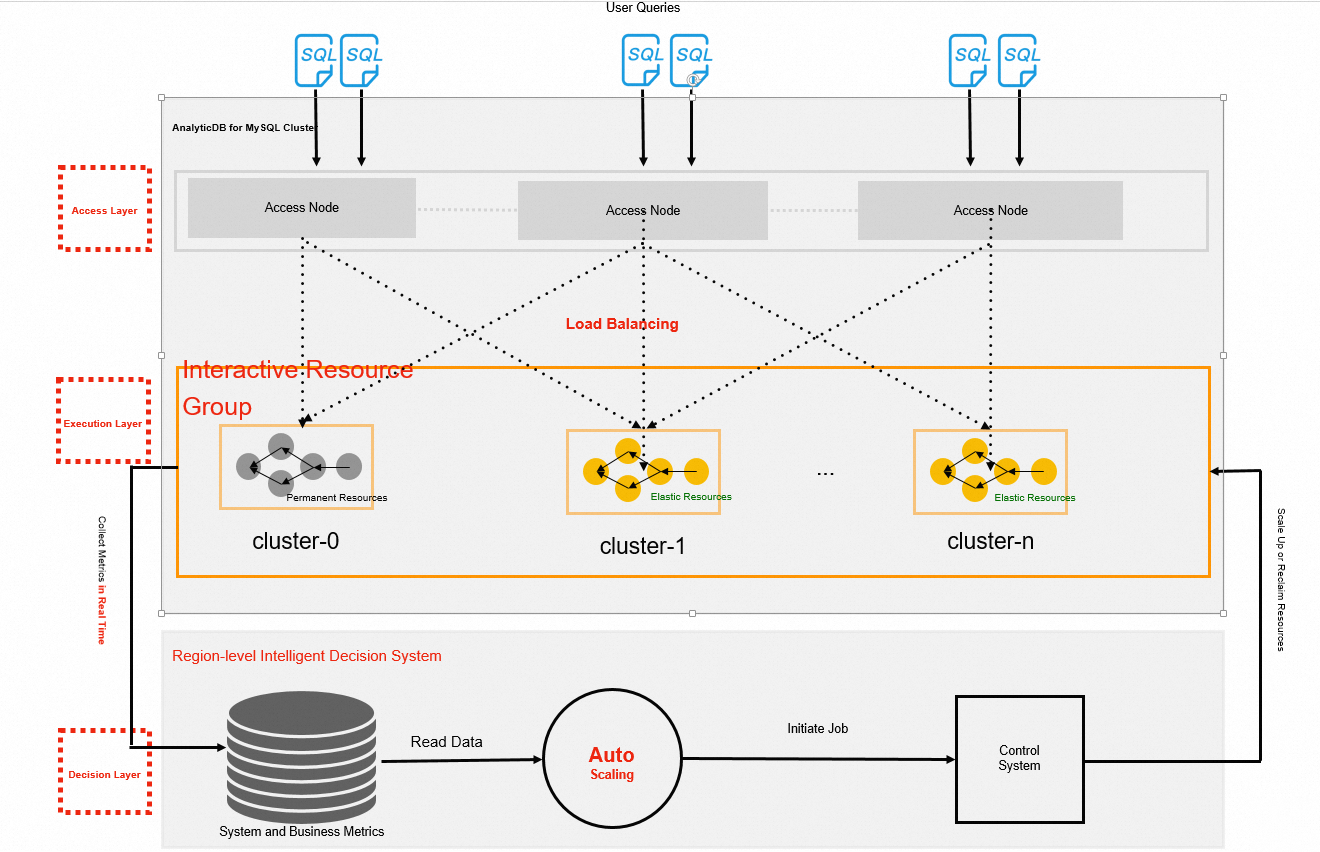
Kelompok sumber daya multi-kluster sangat ideal untuk meningkatkan konkurensi pada kueri berukuran kecil dan menengah serta mengurangi konflik sumber daya. Fitur ini tidak meningkatkan kecepatan kueri yang berjalan lambat atau pekerjaan ETL.
Manfaat fitur multi-kluster
Untuk kelompok sumber daya yang belum mengaktifkan fitur multi-kluster, Anda harus melakukan operasi manual berikut ketika beban kerja kueri meningkat dan sumber daya komputasi menjadi tidak mencukupi:
-
Menyesuaikan sumber daya kelompok sumber daya secara manual agar sesuai dengan kebutuhan bisnis.
-
Jika kueri besar dan kecil saling bersaing untuk sumber daya dan memperlambat waktu respons kueri kecil, Anda harus mengalihkan kueri besar ke kelompok sumber daya lain.
-
Saat beban kerja kueri menurun dan terdapat sumber daya komputasi berlebih, lakukan penskalaan turun (scale down) sumber daya kelompok sumber daya secara manual untuk menghemat biaya.
Kelompok sumber daya yang telah mengaktifkan fitur multi-kluster terdiri dari beberapa kluster dengan ukuran yang sama, sehingga memberikan manfaat berikut:
-
Dalam mode elastis, Anda tidak perlu menyesuaikan ukuran kelompok sumber daya secara manual untuk menangani beban kerja kueri yang fluktuatif. AnalyticDB for MySQL secara otomatis menyesuaikan jumlah kluster berdasarkan beban kueri.
-
Dalam mode maksimum, Anda dapat mengontrol total sumber daya komputasi kelompok sumber daya dengan menyesuaikan jumlah kluster.
-
Kluster dalam satu kelompok sumber daya saling terisolasi. Kueri besar hanya memengaruhi kluster tempat kueri tersebut berjalan dan tidak memengaruhi kueri di kluster lain.
Batasan
-
Model penskalaan multi-kluster hanya berlaku untuk kelompok sumber daya interaktif.
-
Kelompok sumber daya yang dibuat pada kluster dengan versi minor sebelum 3.1.10.0 tidak mendukung model penskalaan multi-kluster. Untuk menggunakan fitur ini, buatlah kelompok sumber daya interaktif baru.
-
Untuk kluster Data Lakehouse Edition, kelompok sumber daya interaktif tidak dapat secara bersamaan menggunakan model penskalaan multi-kluster (yaitu, Anda mengatur nilai Maximum Clusters dan Minimum Clusters untuk kelompok sumber daya) serta rencana penskalaan tertentu, seperti rencana penskalaan Interactive Resource Group atau rencana Default Proportional Scaling for EIUs.
Penagihan
Setelah Anda mengaktifkan fitur multi-kluster, jumlah kluster dalam kelompok sumber daya interaktif akan diskalakan secara elastis. Anda dikenai biaya untuk elastic resources berdasarkan penggunaan, yang dihitung menggunakan rumus berikut: Spesifikasi per kluster × Jumlah kluster. Untuk informasi selengkapnya, lihat Harga untuk Enterprise Edition dan Basic Edition dan Harga untuk Data Lakehouse Edition.
Mengaktifkan fitur multi-kluster
Anda dapat mengaktifkan fitur multi-kluster saat membuat kelompok sumber daya atau dengan memodifikasi konfigurasi kelompok sumber daya yang sudah ada.
-
Masuk ke Konsol AnalyticDB for MySQL, lalu di pojok kiri atas, pilih wilayah tempat kluster Anda berada. Di panel navigasi kiri, klik Clusters, kemudian klik ID kluster target.
-
Di panel navigasi kiri, klik dan buka tab Resource Groups.
-
Pada halaman Resource Groups, klik Create Resource Group atau temukan kelompok sumber daya target lalu klik Modify di kolom Actions.
-
Pastikan tipe pekerjaan adalah Interactive, aktifkan fitur multi-kluster, lalu konfigurasikan parameter berikut.
Parameter
Deskripsi
Engine
Pilih Xihe engine atau Spark.
-
Xihe engine: Kelompok sumber daya ini hanya mendukung Xihe SQL.
-
Spark engine: Kelompok sumber daya ini hanya mendukung pekerjaan Spark. Pekerjaan Spark diproses secara interaktif.
Cluster Size
Ukuran satu kluster dalam satuan ACU. Anda dapat menentukan nilai apa pun, tetapi nilai minimumnya adalah 16 ACU.
Jika Anda memilih Spark engine, Anda harus memahami pemetaan antara Cluster Size dan spesifikasi Spark driver serta Spark executor untuk memilih Cluster Size yang sesuai. Untuk informasi selengkapnya, lihat Lampiran: Pemetaan antara ukuran kluster dan spesifikasi Spark driver serta Spark executor.
Minimum Clusters
Jumlah minimum kluster yang harus dipertahankan dalam kelompok sumber daya. Nilai ini harus kurang dari atau sama dengan nilai Maximum Clusters. Nilai minimumnya adalah 1.
-
Jika Anda mengatur nilai Minimum Clusters dan Maximum Clusters yang berbeda, AnalyticDB for MySQL akan secara dinamis melakukan skala-masuk atau skala-keluar antara nilai Minimum Clusters dan Maximum Clusters yang dikonfigurasi berdasarkan beban kueri kelompok sumber daya.
-
Jika Anda mengatur nilai yang sama untuk Minimum Clusters dan Maximum Clusters, AnalyticDB for MySQL akan menjalankan jumlah kluster yang ditentukan setelah kelompok sumber daya dibuat. Hal ini memungkinkan Anda mengontrol total resource komputasi kelompok sumber daya secara statis.
Maximum Clusters
Jumlah maksimum kluster yang dapat diskalakan oleh kelompok sumber daya. Nilai maksimumnya adalah 10.
-
Jika Anda mengatur nilai Minimum Clusters dan Maximum Clusters yang berbeda, AnalyticDB for MySQL akan secara dinamis melakukan skala-masuk atau skala-keluar antara nilai Minimum Clusters dan Maximum Clusters yang dikonfigurasi berdasarkan beban kueri kelompok sumber daya.
-
Jika Anda mengatur nilai yang sama untuk Minimum Clusters dan Maximum Clusters, AnalyticDB for MySQL akan menjalankan jumlah kluster yang ditentukan setelah kelompok sumber daya dibuat. Hal ini memungkinkan Anda mengontrol total resource komputasi kelompok sumber daya secara statis.
Spark Configuration
Parameter konfigurasi aplikasi Spark yang berlaku untuk semua pekerjaan Spark yang dijalankan dalam kelompok sumber daya ini. Untuk mengonfigurasi parameter untuk pekerjaan Spark tertentu, atur parameter tersebut dalam kode saat Anda mengirimkan pekerjaan.
CatatanParameter ini hanya dapat dikonfigurasi ketika Engine diatur ke Spark engine.
-
-
Klik OK untuk mengaktifkan fitur multi-kluster.
Setelah fitur multi-kluster diaktifkan, tab Resource Groups akan menampilkan jumlah minimum, maksimum, dan jumlah kluster yang sedang berjalan untuk kelompok sumber daya tersebut. Anda juga dapat mengklik Monitoring di kolom Actions untuk melihat metrik detail kelompok sumber daya.
Efek modifikasi batas kluster
Mengubah nilai Minimum Clusters dan Maximum Clusters memengaruhi jumlah kluster yang sedang berjalan seperti yang dijelaskan dalam bagian berikut.
Ketika Minimum Clusters dan Maximum Clusters berbeda:
-
Meningkatkan Maximum Clusters: Aksi ini menaikkan batas atas jumlah kluster. Jumlah kluster yang sedang berjalan tidak berubah hingga beban kerja memerlukan lebih banyak sumber daya.
-
Menurunkan Maximum Clusters: Jika jumlah kluster yang sedang berjalan lebih besar daripada nilai maksimum baru, kluster berlebih tidak lagi menerima kueri baru. Sistem akan mengurangi jumlah kluster yang berjalan setelah kueri di dalamnya selesai.
-
Meningkatkan Minimum Clusters: Kluster baru segera dibuat untuk memenuhi jumlah minimum yang ditentukan.
-
Menurunkan Minimum Clusters: Jika jumlah kluster yang sedang berjalan lebih besar daripada nilai minimum baru, AnalyticDB for MySQL terus memantau beban kueri Anda dalam rentang waktu 5 menit. Sistem hanya akan melakukan skala-masuk ke nilai minimum yang dikonfigurasi jika beban kerja memenuhi kondisi skala-masuk.
Ketika Minimum Clusters dan Maximum Clusters sama:
-
Meningkatkan Maximum Clusters dan Minimum Clusters: Jumlah kluster segera dinaikkan ke nilai baru.
-
Menurunkan Maximum Clusters dan Minimum Clusters: Kluster berlebih tidak lagi menerima kueri baru. Kluster tersebut akan diskalakan turun setelah kueri yang sedang berjalan selesai.
Lampiran: Pemetaan ukuran kluster dan spesifikasi Spark
Spesifikasi dan jumlah Spark driver serta Spark executor bergantung pada rasio CPU-memori yang dipilih. Saat Anda mengaktifkan fitur multi-kluster, Anda dapat menambahkan parameter spark.adb.warehouse.instance.spec di bagian Spark Configuration untuk mengatur rasio CPU-memori spesifikasi Spark driver dan Spark executor.
Nilai valid untuk parameter spark.adb.warehouse.instance.spec adalah:
-
MEMORY (default): Menggunakan rasio CPU-memori
1:8untuk Spark driver dan Spark executor. -
GENERAL: Menggunakan rasio CPU-memori
1:4untuk Spark driver dan Spark executor. -
COMPUTE: Menggunakan rasio CPU-memori
1:2untuk Spark driver dan Spark executor.
Tabel berikut mencantumkan pemetaan antara ukuran kluster dan spesifikasi Spark driver serta Spark executor.
|
Ukuran kluster |
MEMORY (rasio CPU-memori 1:8) |
GENERAL (rasio CPU-memori 1:4) |
COMPUTE (rasio CPU-memori 1:2) |
|||
|
Spesifikasi Spark driver |
Spesifikasi Spark executor |
Spesifikasi Spark driver |
Spesifikasi Spark executor |
Spesifikasi Spark driver |
Spesifikasi Spark executor |
|
|
16 ACU (3X-Small) |
4 core, 32 GB |
3 × 2 core, 16 GB |
4 core, 16 GB |
3 × 4 core, 16 GB |
4 core, 8 GB |
4 × 4 core, 8 GB |
|
24 ACU (2X-Small) |
8 core, 64 GB |
1 × 8 core, 64 GB |
8 core, 32 GB |
4 × 4 core, 16 GB |
8 core, 16 GB |
11 × 2 core, 4 GB |
|
36 ACU (X-Small) |
8 core, 64 GB |
2 × 8 core, 64 GB |
8 core, 32 GB |
7 × 4 core, 16 GB |
8 core, 16 GB |
18 × 2 core, 4 GB |
|
72 ACU (Small) |
16 core, 128 GB |
4 × 8 core, 64 GB |
16 core, 64 GB |
7 × 8 core, 32 GB |
16 core, 32 GB |
37 × 2 core, 4 GB |
|
144 ACU (Medium) |
16 core, 128 GB |
10 × 8 core, 64 GB |
16 core, 64 GB |
16 × 8 core, 32 GB |
16 core, 32 GB |
41 × 4 core, 8 GB |
|
240 ACU (Large) |
16 core, 128 GB |
9 × 16 core, 128 GB |
16 core, 64 GB |
28 × 8 core, 32 GB |
16 core, 32 GB |
71 × 4 core, 8 GB |
|
360 ACU |
16 core, 128 GB |
14 × 16 core, 128 GB |
16 core, 64 GB |
43 × 8 core, 32 GB |
16 core, 32 GB |
54 × 8 core, 16 GB |
|
480 ACU (X-Large) |
32 core, 256 GB |
18 × 16 core, 128 GB |
32 core, 128 GB |
56 × 8 core, 32 GB |
32 core, 64 GB |
71 × 8 core, 16 GB |
|
864 ACU (2X-Large) |
64 core, 512 GB |
32 × 16 core, 128 GB |
32 core, 128 GB |
52 × 16 core, 64 GB |
32 core, 64 GB |
131 × 8 core, 16 GB |