Descheduler ack-koordinator mendeteksi node yang kelebihan beban berdasarkan pemanfaatan resource aktual dan mengusir Pod untuk menyeimbangkan kluster.
Topik ini menjelaskan cara menginstal descheduler, mengaktifkan descheduling sadar hotspot, dan mengonfigurasi parameter lanjutannya.
Batasan
Hanya kluster ACK managed Pro yang didukung.
Versi komponen yang diperlukan:
Komponen
Versi
ACK Scheduler
v1.22.15-ack-4.0 atau lebih baru, v1.24.6-ack-4.0 atau lebih baru
ack-koordinator
v1.1.1-ack.1 atau lebih baru
Helm
v3.0 atau lebih baru
Koordinator Descheduler hanya mengusir Pod; penjadwal ulang dilakukan oleh ACK Scheduler. Gunakan descheduling bersama load-aware scheduling untuk mencegah Pod yang diusir kembali ditempatkan pada node hotspot.
Saat descheduling, Pod lama diusir sebelum Pod baru dibuat. Pastikan aplikasi Anda memiliki replika redundan yang cukup untuk menjaga ketersediaan.
Descheduling menggunakan API eviction standar Kubernetes. Pastikan Pod Anda bersifat re-entrant agar restart setelah eviction tidak mengganggu layanan Anda.
Penagihan
ack-koordinator dapat diinstal dan digunakan secara gratis. Biaya tambahan mungkin berlaku dalam skenario berikut:
Resource node pekerja: ack-koordinator adalah komponen self-managed yang mengonsumsi resource node pekerja. Konfigurasikan permintaan resource untuk setiap modul saat instalasi.
Metrik kustom Prometheus: Jika Anda mengaktifkan Enable Prometheus Monitoring for ACK-Koordinator dan menggunakan Managed Service for Prometheus, metrik yang diekspos dihitung sebagai metrik kustom dan dikenai biaya. Biaya tergantung pada ukuran kluster dan jumlah aplikasi. Tinjau penagihan instans Prometheus sebelum mengaktifkan fitur ini. Kueri data penggunaan untuk memantau konsumsi resource Anda.
Cara kerja
Siklus eksekusi
Koordinator Descheduler berjalan secara berkala. Setiap siklus eksekusi terdiri dari tiga tahap:
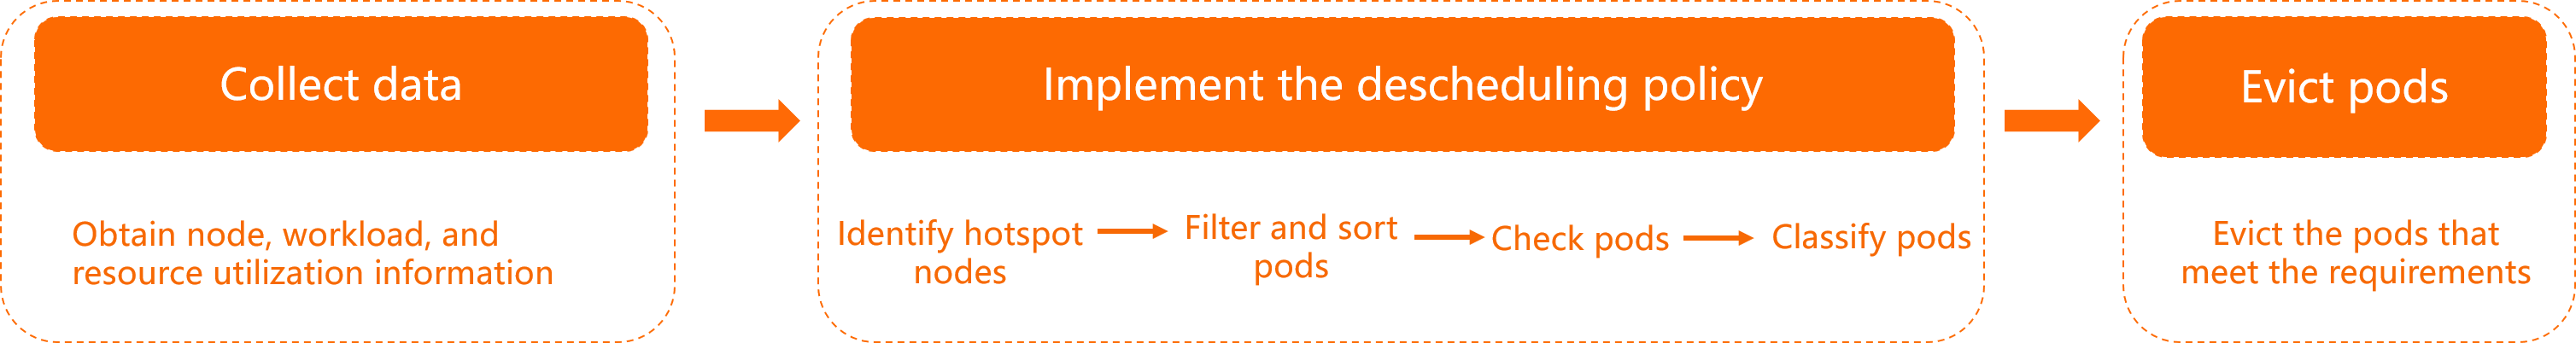
Pengumpulan data: Mengambil informasi node dan workload serta data pemanfaatan resource.
Eksekusi plugin (contoh LowNodeLoad):
Mengidentifikasi node hotspot berdasarkan
highThresholdsdanlowThresholds.Menelusuri semua node hotspot, memberi skor pada Pod yang memenuhi syarat, dan mengurutkannya untuk eviction. Lihat Kebijakan penskoran Pod.
Memeriksa setiap Pod kandidat terhadap batasan migrasi—kapasitas kluster, pemanfaatan resource, dan batas rasio replika. Lihat Kebijakan descheduling hotspot sadar beban.
Menandai Pod yang lolos sebagai kandidat migrasi dan melewati sisanya.
Eviction dan migrasi Pod: Mengusir kandidat migrasi melalui API eviction.
Klasifikasi node
Plugin LowNodeLoad mengklasifikasikan node ke dalam tiga kategori berdasarkan dua ambang batas: lowThresholds (ambang batas idle) dan highThresholds (ambang batas hotspot).
Contoh dengan lowThresholds = 45% dan highThresholds = 70%:

Node idle: Pemanfaatan resource di bawah
lowThresholds(< 45%).Node normal: Pemanfaatan resource berada di antara
lowThresholdsdanhighThresholds(45%–70%). Ini adalah rentang target.Node hotspot: Pemanfaatan resource melebihi
highThresholds(> 70%). Pod diusir hingga beban node turun menjadi 70% atau di bawahnya.
Data pemanfaatan resource diperbarui setiap menit dan mencerminkan rata-rata selama 5 menit.
Jika semua node melebihilowThresholds, beban kluster dianggap tinggi dan descheduling ditangguhkan, meskipun beberapa node melebihihighThresholds.
Kebijakan descheduling hotspot sadar beban
Kebijakan | Deskripsi |
Hot spot check retry | Sebuah node diklasifikasikan sebagai hotspot hanya setelah melebihi |
Node sorting | Descheduling dimulai dari node hotspot dengan pemanfaatan tertinggi. CPU dan memori dibandingkan secara berurutan. |
Pod scoring | Untuk setiap node hotspot, Pod diberi skor dan diurutkan sebelum eviction: (1) kelas Priority lebih rendah terlebih dahulu (default adalah 0, yang terendah); (2) kelas QoS lebih rendah; (3) untuk priority dan QoS yang sama, Pod diurutkan berdasarkan pemanfaatan resource dan waktu startup. Konfigurasikan kelas Priority atau QoS untuk mengontrol urutan eviction. |
Filter | Membatasi cakupan descheduling ke namespace, Pod, atau node tertentu menggunakan pemilih label. Lihat |
Pre-check | Sebelum eviction, descheduler memverifikasi: (1) terdapat node yang sesuai dengan Node Affinity, Node Selector, Tolerations, dan kebutuhan resource; (2) node target memiliki kapasitas yang cukup tanpa melebihi |
Migration throttling | Membatasi migrasi Pod konkuren per node, namespace, dan workload. Jendela waktu mencegah Pod dalam workload yang sama bermigrasi terlalu sering. Kompatibel dengan Pod Disruption Budget (PDB) Kubernetes untuk kontrol ketersediaan detail halus. |
Observability | Event migrasi dipancarkan untuk setiap Pod, menunjukkan alasan dan statusnya. Jalankan |
Prasyarat
Sebelum memulai, pastikan Anda telah memiliki:
ACK Scheduler v1.22.15-ack-4.0 atau lebih baru, ack-koordinator v1.1.1-ack.1 atau lebih baru, dan Helm v3.0 atau lebih baru
Langkah 1: Aktifkan descheduling di ack-koordinator
Instalasi baru: Instal ack-koordinator dan pilih Enable ACK-Koordinator Descheduling Module pada halaman konfigurasi.
Instalasi yang sudah ada: Pada halaman konfigurasi, pilih Enable ACK-Koordinator Descheduling Module. Lihat Modifikasi ack-koordinator.
Langkah 2: Aktifkan plugin LowNodeLoad
Buat ConfigMap
koord-descheduler-config.yamluntuk mengaktifkan plugin LowNodeLoad.# koord-descheduler-config.yaml apiVersion: v1 kind: ConfigMap metadata: name: koord-descheduler-config namespace: kube-system data: koord-descheduler-config: | # Konfigurasi sistem untuk koord-descheduler. Jangan ubah bagian ini. apiVersion: descheduler/v1alpha2 kind: DeschedulerConfiguration leaderElection: resourceLock: leases resourceName: koord-descheduler resourceNamespace: kube-system deschedulingInterval: 120s # Interval eksekusi. Descheduler berjalan setiap 120 detik. # Tidak boleh melebihi detectorCacheTimeout (default: 5m). dryRun: false # Atur ke true untuk menjalankan dalam mode read-only (tanpa eviction). # Akhir konfigurasi sistem. profiles: - name: koord-descheduler plugins: balance: enabled: - name: LowNodeLoad # Aktifkan plugin LowNodeLoad untuk descheduling hotspot. evict: enabled: - name: MigrationController # Aktifkan controller eviction dan migrasi. pluginConfig: - name: MigrationController args: apiVersion: descheduler/v1alpha2 kind: MigrationControllerArgs defaultJobMode: EvictDirectly - name: LowNodeLoad args: apiVersion: descheduler/v1alpha2 kind: LowNodeLoadArgs # Sebuah node dianggap idle jika penggunaan SEMUA resource di bawah lowThresholds. lowThresholds: cpu: 20 # Pemanfaatan CPU 20% memory: 30 # Pemanfaatan memori 30% # Sebuah node dianggap hotspot jika penggunaan SALAH SATU resource melebihi highThresholds. highThresholds: cpu: 50 # Pemanfaatan CPU 50% memory: 60 # Pemanfaatan memori 60% # Membatasi cakupan descheduling ke namespace tertentu. # include dan exclude saling eksklusif—konfigurasikan hanya salah satu. evictableNamespaces: include: - default # exclude: # - "kube-system" # - "koordinator-system"Terapkan ConfigMap ke kluster.
kubectl apply -f koord-descheduler-config.yamlRestart Koordinator Descheduler untuk memuat konfigurasi baru.
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 0
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 1
Langkah 3 (opsional): Aktifkan load-aware scheduling
Untuk penyeimbangan beban optimal, aktifkan load-aware scheduling agar ACK Scheduler menghindari penempatan Pod pada node hotspot setelah eviction.
Atur loadAwareThreshold agar sesuai dengan highThresholds. Nilai yang tidak sesuai dapat menyebabkan Pod yang diusir dijadwalkan ulang ke node hotspot, terutama jika hanya sedikit node dengan pemanfaatan serupa.
Langkah 4: Verifikasi descheduling
Contoh ini menggunakan kluster tiga node di mana setiap node memiliki 104 core dan memori 396 GiB.
Buat file
stress-demo.yamldengan konten berikut.apiVersion: apps/v1 kind: Deployment metadata: name: stress-demo namespace: default labels: app: stress-demo spec: replicas: 6 selector: matchLabels: app: stress-demo template: metadata: name: stress-demo labels: app: stress-demo spec: containers: - args: - '--vm' - '2' - '--vm-bytes' - '1600M' - '-c' - '2' - '--vm-hang' - '2' command: - stress image: polinux/stress imagePullPolicy: Always name: stress resources: limits: cpu: '2' memory: 4Gi requests: cpu: '2' memory: 4Gi restartPolicy: AlwaysTerapkan workload pengujian stres.
kubectl create -f stress-demo.yamlOutput yang diharapkan:
deployment.apps/stress-demo createdVerifikasi Pod sedang berjalan dan catat node tempatnya ditempatkan.
kubectl get pod -o wideOutput yang diharapkan:
NAME                           READY   STATUS    RESTARTS   AGE   IP            NODE                     NOMINATED NODE   READINESS GATES
stress-demo-588f9646cf-s****   1/1     Running   0          82s   10.XX.XX.53   cn-beijing.10.XX.XX.53   <none>           <none>
Tingkatkan beban pada
cn-beijing.10.XX.XX.53dan periksa pemanfaatan node.kubectl top nodeOutput yang diharapkan:
NAME                      CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
cn-beijing.10.XX.XX.215   17611m       17%    24358Mi         6%
cn-beijing.10.XX.XX.53    63472m       63%    11969Mi         3%
Node
cn-beijing.10.XX.XX.53berada di 63% CPU, melebihi ambang batas hotspot 50%. Nodecn-beijing.10.XX.XX.215berada di 17% CPU, di bawah ambang batas idle 20%.Aktifkan plugin LowNodeLoad seperti yang dijelaskan dalam Langkah 2: Aktifkan plugin LowNodeLoad.
Amati perubahan Pod.
Secara default, sebuah node harus melebihi
highThresholdsselama lima pemeriksaan berturut-turut (~10 menit dengan interval default 120 detik) untuk diklasifikasikan sebagai hotspot.kubectl get pod -wOutput yang diharapkan:
NAME                           READY   STATUS             RESTARTS   AGE   IP             NODE                     NOMINATED NODE   READINESS GATES
stress-demo-588f9646cf-s****   1/1     Terminating        0          59s   10.XX.XX.53    cn-beijing.10.XX.XX.53   <none>           <none>
stress-demo-588f9646cf-7****   1/1     ContainerCreating  0          10s   10.XX.XX.215   cn-beijing.10.XX.XX.215  <none>           <none>
Periksa event eviction.
kubectl get event | grep stress-demo-588f9646cf-s****Output yang diharapkan:
2m14s   Normal   Evicting        podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" diusir dari node "cn-beijing.10.XX.XX.53" dengan alasan "node kelebihan beban, penggunaan cpu(68,53%)>ambang batas(50,00%)"
101s    Normal   EvictComplete   podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" telah diusir
2m14s   Normal   Descheduled     pod/stress-demo-588f9646cf-s****   Pod diusir dari node "cn-beijing.10.XX.XX.53" dengan alasan "node kelebihan beban, penggunaan cpu(68,53%)>ambang batas(50,00%)"
2m14s   Normal   Killing         pod/stress-demo-588f9646cf-s****   Menghentikan kontainer stress
Pod pada node hotspot telah diusir dan dimigrasikan ke
cn-beijing.10.XX.XX.215.
Konfigurasi lanjutan
Semua parameter Koordinator Descheduler dikonfigurasi dalam ConfigMap dari Langkah 2.
# koord-descheduler-config.yaml
apiVersion: v1
kind: ConfigMap
metadata:
  name: koord-descheduler-config
  namespace: kube-system
data:
  koord-descheduler-config: |
    # Konfigurasi sistem. Jangan ubah bagian ini.
    apiVersion: descheduler/v1alpha2
    kind: DeschedulerConfiguration
    leaderElection:
      resourceLock: leases
      resourceName: koord-descheduler
      resourceNamespace: kube-system
    deschedulingInterval: 120s  # Interval eksekusi. Tidak boleh melebihi detectorCacheTimeout.
    dryRun: false               # Atur ke true untuk mode read-only (tanpa eviction).
    # Akhir konfigurasi sistem.

    profiles:
    - name: koord-descheduler
      plugins:
        deschedule:
          disabled:
            - name: "*"  # Semua plugin dinonaktifkan secara default (ditampilkan hanya sebagai referensi).
        balance:
          enabled:
            - name: LowNodeLoad
        evict:
          disabled:
            - name: "*"  # Semua plugin dinonaktifkan secara default (ditampilkan hanya sebagai referensi).
          enabled:
            - name: MigrationController

      pluginConfig:
      - name: MigrationController
        args:
          apiVersion: descheduler/v1alpha2
          kind: MigrationControllerArgs
          defaultJobMode: EvictDirectly
          maxMigratingPerNode: 1       # Maksimum Pod yang bermigrasi secara simultan per node. 0 = tak terbatas.
          maxMigratingPerNamespace: 1  # Maksimum Pod yang bermigrasi secara simultan per namespace.
          maxMigratingPerWorkload: 1   # Maksimum Pod yang bermigrasi secara simultan per workload (misalnya, Deployment).
          maxUnavailablePerWorkload: 2 # Maksimum replika tidak tersedia per workload selama migrasi.
          evictLocalStoragePods: false # Apakah akan mengusir Pod yang menggunakan volume HostPath atau emptyDir.
          objectLimiters:
            workload:               # Paling banyak 1 replika dimigrasikan per workload dalam 5 menit.
              duration: 5m
              maxMigrating: 1

      - name: LowNodeLoad
        args:
          apiVersion: descheduler/v1alpha2
          kind: LowNodeLoadArgs

          lowThresholds:
            cpu: 20
            memory: 30
          highThresholds:
            cpu: 50
            memory: 60

          anomalyCondition:
            consecutiveAbnormalities: 5  # Jumlah pemeriksaan berturut-turut di atas highThresholds
                                          # sebelum sebuah node diklasifikasikan sebagai hotspot.
                                          # Penghitung direset setelah eviction.

          detectorCacheTimeout: "5m"  # Durasi cache untuk pemeriksaan hotspot.
                                      # Harus >= deschedulingInterval.

          evictableNamespaces:
            include:
              - default
            # exclude:
            #   - "kube-system"
            #   - "koordinator-system"

          nodeSelector:  # Proses hanya node yang ditentukan.
            matchLabels:
              alibabacloud.com/nodepool-id: np77f520e1108f47559e63809713ce****

          podSelectors:  # Proses hanya Pod yang ditentukan.
          - name: lsPods
            selector:
              matchLabels:
                koordinator.sh/qosClass: "LS"
Konfigurasi sistem Koordinator Descheduler
Parameter | Tipe | Nilai | Deskripsi | Contoh |
| boolean |
| Sakelar mode read-only. Saat diaktifkan, tidak ada migrasi Pod yang dimulai. |
|
| time.Duration | > 0s | Interval eksekusi. Tidak boleh melebihi |
|
Konfigurasi kontrol eviction dan migrasi
Parameter | Tipe | Nilai | Deskripsi | Contoh |
| int64 | ≥ 0 (default: 2) | Maksimum Pod yang bermigrasi secara konkuren per node. |
|
| int64 | ≥ 0 (default: tak terbatas) | Maksimum Pod yang bermigrasi secara konkuren per namespace. |
|
| intOrString | ≥ 0 (default: 10%) | Maksimum Pod atau persentase yang bermigrasi per workload (misalnya, Deployment). |
|
| intOrString | ≥ 0 (default: 10%), kurang dari total replika | Maksimum replika tidak tersedia atau persentase per workload. |
|
| boolean |
| Apakah akan mengusir Pod dengan volume HostPath atau emptyDir. Dinonaktifkan secara default demi keamanan data. |
|
| struct | Durasi > 0s (default: | Throttling migrasi tingkat workload. |
|
Konfigurasi plugin LowNodeLoad
Parameter | Tipe | Nilai | Deskripsi | Contoh |
| map[string]float64 | [0, 100] (CPU dan memori, dalam persentase) | Ambang batas hotspot. Pod pada node di atas nilai ini memenuhi syarat untuk eviction. Jika semua node melebihi |
|
| map[string]float64 | [0, 100] (CPU dan memori, dalam persentase) | Ambang batas idle. Jika semua node melebihi nilai ini, beban keseluruhan kluster dianggap tinggi dan descheduling ditangguhkan. |
|
| int64 | > 0 (default: 5) | Jumlah siklus berturut-turut sebuah node harus melebihi |
|
| \*metav1.Duration | Lihat Format Duration (default: | Durasi cache untuk pemeriksaan hotspot. Harus ≥ |
|
| include: string / exclude: string | Namespace dalam kluster | Membatasi cakupan descheduling ke namespace tertentu. Biarkan kosong untuk memproses semua Pod. |
|
| metav1.LabelSelector | Lihat Label dan pemilih | Membatasi cakupan descheduling ke node tertentu menggunakan pemilih label. Mendukung kelompok node tunggal ( |
|
| daftar PodSelector | Lihat Label dan pemilih | Membatasi cakupan descheduling ke Pod tertentu menggunakan pemilih label. Mendukung beberapa kelompok pemilih. |
|
FAQ
Pemanfaatan node melebihi ambang batas tetapi Pod tidak diusir
Penyebab paling umum adalah konfigurasi descheduler yang tidak aktif. Periksa secara berurutan:
Cakupan tidak dikonfigurasi: Descheduler hanya memproses namespace dan node yang secara eksplisit disertakan (atau tidak dikecualikan). Verifikasi
evictableNamespacesdannodeSelector.Descheduler tidak direstart setelah perubahan konfigurasi: Perubahan konfigurasi memerlukan restart. Lihat Langkah 2 untuk instruksi.
Interval lebih panjang daripada timeout cache:
deschedulingInterval(default: 2 menit) tidak boleh melebihidetectorCacheTimeout(default: 5 menit), atau deteksi hotspot gagal. Sesuaikan dan restart.Node tidak konsisten di atas ambang batas: Descheduler menggunakan rata-rata terhaluskan. Sebuah node diklasifikasikan sebagai hotspot hanya setelah melebihi
highThresholdsselamaconsecutiveAbnormalitiessiklus berturut-turut (default: 5, ~10 menit).kubectl top nodehanya mencerminkan menit terakhir—pantau dalam periode yang lebih lama untuk memastikan pemanfaatan berkelanjutan.Kapasitas kluster tidak mencukupi: Sebelum mengusir Pod, descheduler memverifikasi bahwa node lain memiliki kapasitas bebas yang cukup. Jika tidak ada, eviction dilewati. Tambahkan node untuk meningkatkan kapasitas.
Workload satu replika: Pod satu replika tidak diusir secara default. Untuk mengganti, tambahkan anotasi
descheduler.alpha.kubernetes.io/evict: "true"ke Pod atauspec.template.metadataworkload. Tidak didukung di ack-koordinator v1.3.0-ack1.6 hingga v1.3.0-ack1.8. Tingkatkan ke versi terbaru untuk menggunakan fitur ini.Pod menggunakan HostPath atau emptyDir: Dikecualikan dari descheduling secara default. Atur
evictLocalStoragePods: truedi MigrationController untuk mengaktifkan eviction. Lihat Konfigurasi kontrol eviction dan migrasi.Terlalu banyak replika tidak tersedia atau sedang bermigrasi: Jika replika tidak tersedia atau sedang bermigrasi mencapai
maxUnavailablePerWorkloadataumaxMigratingPerWorkload, eviction lebih lanjut diblokir. Tunggu eviction yang sedang berlangsung atau tingkatkan batas ini.Jumlah replika ≤ batas migrasi: Jika total replika ≤
maxMigratingPerWorkloadataumaxUnavailablePerWorkload, workload dilewati. Kurangi nilai-nilai ini atau gunakan persentase.
Descheduler sering restart
ConfigMap yang tidak valid atau hilang menyebabkan loop restart. Verifikasi format ConfigMap terhadap Konfigurasi lanjutan, lalu restart seperti yang dijelaskan dalam Langkah 2.
Bagaimana load-aware scheduling dan hot spot descheduling bekerja bersama
Aktifkan kedua fitur untuk penyeimbangan beban optimal. Descheduling mengusir Pod dari node yang kelebihan beban; load-aware scheduling menempatkan Pod yang dijadwalkan ulang pada node dengan pemanfaatan lebih rendah.
Atur loadAwareThreshold agar sesuai dengan highThresholds. Lihat Gunakan load-aware scheduling dan Kebijakan penjadwalan.
Data pemanfaatan apa yang digunakan descheduler?
Descheduler menghitung rata-rata terhaluskan selama beberapa siklus. Eviction dipicu hanya ketika penggunaan rata-rata tetap di atas highThresholds selama siklus berturut-turut yang dikonfigurasi (default: ~10 menit).
Descheduler mengecualikan page cache dari perhitungan memori (dapat diklaim kembali oleh OS). kubectl top node menyertakan page cache—gunakan Managed Service for Prometheus untuk melihat metrik aktual.