ACK menggunakan Scheduling Framework untuk memilih kombinasi GPU optimal pada node yang sama dalam pelatihan terdistribusi TensorFlow, sehingga mengurangi overhead sinkronisasi lintas node dan meningkatkan throughput.
Prasyarat
Pastikan Anda telah:
-
Kluster ACK Pro dengan tipe instans Elastic GPU Service. Lihat Membuat kluster ACK yang dikelola.
-
Menginstal Arena.
-
add-on penjadwalan GPU yang memperhatikan topologi telah terinstal.
-
Versi komponen yang diperlukan:
| Komponen | Versi yang diperlukan | Perintah pemeriksaan |
|---|---|---|
| Kubernetes | 1.18.8 dan yang lebih baru | kubectl version --short |
| driver NVIDIA | 418.87.01 dan yang lebih baru | nvidia-smi --query-gpu=driver_version --format=csv,noheader |
| NCCL (NVIDIA Collective Communications Library) | 2.7 dan yang lebih baru | python3 -c "import torch; print(torch.cuda.nccl.version())" |
| Sistem operasi | CentOS 7.6, CentOS 7.7, Ubuntu 16.04, Ubuntu 18.04, Alibaba Cloud Linux 2, Alibaba Cloud Linux 3 | cat /etc/os-release |
| GPU | V100 | nvidia-smi --query-gpu=name --format=csv,noheader |
Lengkapi prasyarat secara berurutan: buat kluster ACK Pro, instal Arena, lalu instal add-on penjadwalan GPU yang memperhatikan topologi. Instalasi yang tidak sesuai urutan dapat gagal.
Batasan
Penjadwalan GPU yang memperhatikan topologi hanya berlaku untuk pekerjaan Message Passing Interface (MPI) yang menggunakan framework terdistribusi.
Penjadwalan GPU biasa hanya menetapkan GPU berdasarkan ketersediaan, tanpa mempertimbangkan topologi interkoneksi. Worker dapat ditempatkan pada GPU di node berbeda yang dihubungkan oleh jaringan lebih lambat, sehingga komunikasi antar-GPU menjadi bottleneck. Sebaliknya, penjadwalan yang memperhatikan topologi mengelompokkan worker pada GPU dalam satu node yang terhubung melalui NVLink, sehingga mengurangi latensi sinkronisasi gradien.
Pod hanya dibuat ketika semua sumber daya yang diminta tersedia (gang scheduling). Jika sumber daya tidak mencukupi, pekerjaan akan tetap dalam status pending hingga cukup GPU tersedia.
Konfigurasi node
Beri label pada node untuk mengaktifkan penjadwalan GPU yang memperhatikan topologi:
kubectl label node <your-node-name> ack.node.gpu.schedule=topologyPenjadwalan yang memperhatikan topologi pada suatu node akan menonaktifkan penjadwalan GPU biasa untuk node tersebut. Untuk mengembalikan penjadwalan biasa, jalankan:
kubectl label node <your-node-name> ack.node.gpu.schedule=default --overwriteKirim pekerjaan
Kirim pekerjaan MPI dengan --gputopology=true dan --gang:
arena submit mpi --gputopology=true --gang <other-parameters>Kedua flag wajib digunakan: --gputopology=true mengaktifkan pemilihan GPU yang memperhatikan topologi; --gang menerapkan gang scheduling agar semua worker dimulai bersamaan.
Contoh 1: Latih VGG16
Contoh ini menggunakan kluster dengan dua node, masing-masing memiliki delapan GPU V100.
Penjadwalan GPU yang memperhatikan topologi
-
Kirim pekerjaan pelatihan:
arena submit mpi \ --name=tensorflow-topo-4-vgg16 \ --gpus=1 \ --workers=4 \ --gang \ --gputopology=true \ --image=registry.cn-hangzhou.aliyuncs.com/kubernetes-image-hub/tensorflow-benchmark:tf2.3.0-py3.7-cuda10.1 \ "mpirun --allow-run-as-root -np 4 -bind-to none -map-by slot -x NCCL_DEBUG=INFO -x NCCL_SOCKET_IFNAME=eth0 -x LD_LIBRARY_PATH -x PATH --mca pml ob1 --mca btl_tcp_if_include eth0 --mca oob_tcp_if_include eth0 --mca orte_keep_fqdn_hostnames t --mca btl ^openib python /tensorflow/benchmarks/scripts/tf_cnn_benchmarks/tf_cnn_benchmarks.py --model=vgg16 --batch_size=64 --variable_update=horovod" -
Periksa status pekerjaan:
arena get tensorflow-topo-4-vgg16 --type mpijobOutput yang diharapkan:
Name:      tensorflow-topo-4-vgg16
Status:    RUNNING
Namespace: default
Priority:  N/A
Trainer:   MPIJOB
Duration:  2m

Instances:
  NAME                                    STATUS   AGE  IS_CHIEF  GPU(Requested)  NODE
  ----                                    ------   ---  --------  --------------  ----
  tensorflow-topo-4-vgg16-launcher-lmhjl  Running  2m   true      0               cn-shanghai.192.168.16.172
  tensorflow-topo-4-vgg16-worker-0        Running  2m   false     1               cn-shanghai.192.168.16.173
  tensorflow-topo-4-vgg16-worker-1        Running  2m   false     1               cn-shanghai.192.168.16.173
  tensorflow-topo-4-vgg16-worker-2        Running  2m   false     1               cn-shanghai.192.168.16.173
  tensorflow-topo-4-vgg16-worker-3        Running  2m   false     1               cn-shanghai.192.168.16.173
Keempat worker berjalan pada satu node, berbagi bandwidth NVLink.
-
Lihat log pelatihan:
arena logs -f tensorflow-topo-4-vgg16Output yang diharapkan:
total images/sec: 991.92
Penjadwalan GPU biasa
-
Kirim pekerjaan tanpa flag topologi:
arena submit mpi \ --name=tensorflow-4-vgg16 \ --gpus=1 \ --workers=4 \ --image=registry.cn-hangzhou.aliyuncs.com/kubernetes-image-hub/tensorflow-benchmark:tf2.3.0-py3.7-cuda10.1 \ "mpirun --allow-run-as-root -np 4 -bind-to none -map-by slot -x NCCL_DEBUG=INFO -x NCCL_SOCKET_IFNAME=eth0 -x LD_LIBRARY_PATH -x PATH --mca pml ob1 --mca btl_tcp_if_include eth0 --mca oob_tcp_if_include eth0 --mca orte_keep_fqdn_hostnames t --mca btl ^openib python /tensorflow/benchmarks/scripts/tf_cnn_benchmarks/tf_cnn_benchmarks.py --model=vgg16 --batch_size=64 --variable_update=horovod" -
Periksa status pekerjaan:
arena get tensorflow-4-vgg16 --type mpijobOutput yang diharapkan:
Name:      tensorflow-4-vgg16
Status:    RUNNING
Namespace: default
Priority:  N/A
Trainer:   MPIJOB
Duration:  9s

Instances:
  NAME                               STATUS   AGE  IS_CHIEF  GPU(Requested)  NODE
  ----                               ------   ---  --------  --------------  ----
  tensorflow-4-vgg16-launcher-xc28k  Running  9s   true      0               cn-shanghai.192.168.16.172
  tensorflow-4-vgg16-worker-0        Running  9s   false     1               cn-shanghai.192.168.16.172
  tensorflow-4-vgg16-worker-1        Running  9s   false     1               cn-shanghai.192.168.16.173
  tensorflow-4-vgg16-worker-2        Running  9s   false     1               cn-shanghai.192.168.16.172
  tensorflow-4-vgg16-worker-3        Running  9s   false     1               cn-shanghai.192.168.16.173
Worker tersebar di dua node, sehingga setiap langkah sinkronisasi gradien memerlukan komunikasi lintas node.
-
Lihat log pelatihan:
arena logs -f tensorflow-4-vgg16Output yang diharapkan:
total images/sec: 200.47
Contoh 2: Latih ResNet50
Penjadwalan GPU yang memperhatikan topologi
-
Kirim pekerjaan pelatihan:
arena submit mpi \ --name=tensorflow-topo-4-resnet50 \ --gpus=1 \ --workers=4 \ --gang \ --gputopology=true \ --image=registry.cn-hangzhou.aliyuncs.com/kubernetes-image-hub/tensorflow-benchmark:tf2.3.0-py3.7-cuda10.1 \ "mpirun --allow-run-as-root -np 4 -bind-to none -map-by slot -x NCCL_DEBUG=INFO -x NCCL_SOCKET_IFNAME=eth0 -x LD_LIBRARY_PATH -x PATH --mca pml ob1 --mca btl_tcp_if_include eth0 --mca oob_tcp_if_include eth0 --mca orte_keep_fqdn_hostnames t --mca btl ^openib python /tensorflow/benchmarks/scripts/tf_cnn_benchmarks/tf_cnn_benchmarks.py --model=resnet50 --batch_size=64 --variable_update=horovod" -
Periksa status pekerjaan:
arena get tensorflow-topo-4-resnet50 --type mpijobOutput yang diharapkan:
Name: tensorflow-topo-4-resnet50 Status: RUNNING Namespace: default Priority: N/A Trainer: MPIJOB Duration: 8s Instances: NAME STATUS AGE IS_CHIEF GPU(Requested) NODE ---- ------ --- -------- -------------- ---- tensorflow-topo-4-resnet50-launcher-7ln8j Running 8s true 0 cn-shanghai.192.168.16.172 tensorflow-topo-4-resnet50-worker-0 Running 8s false 1 cn-shanghai.192.168.16.173 tensorflow-topo-4-resnet50-worker-1 Running 8s false 1 cn-shanghai.192.168.16.173 tensorflow-topo-4-resnet50-worker-2 Running 8s false 1 cn-shanghai.192.168.16.173 tensorflow-topo-4-resnet50-worker-3 Running 8s false 1 cn-shanghai.192.168.16.173 -
Lihat log pelatihan:
arena logs -f tensorflow-topo-4-resnet50Output yang diharapkan:
total images/sec: 1471.55
Penjadwalan GPU biasa
-
Kirim pekerjaan tanpa flag topologi:
arena submit mpi \ --name=tensorflow-4-resnet50 \ --gpus=1 \ --workers=4 \ --image=registry.cn-hangzhou.aliyuncs.com/kubernetes-image-hub/tensorflow-benchmark:tf2.3.0-py3.7-cuda10.1 \ "mpirun --allow-run-as-root -np 4 -bind-to none -map-by slot -x NCCL_DEBUG=INFO -x NCCL_SOCKET_IFNAME=eth0 -x LD_LIBRARY_PATH -x PATH --mca pml ob1 --mca btl_tcp_if_include eth0 --mca oob_tcp_if_include eth0 --mca orte_keep_fqdn_hostnames t --mca btl ^openib python /tensorflow/benchmarks/scripts/tf_cnn_benchmarks/tf_cnn_benchmarks.py --model=resnet50 --batch_size=64 --variable_update=horovod" -
Periksa status pekerjaan:
arena get tensorflow-4-resnet50 --type mpijobOutput yang diharapkan:
Name: tensorflow-4-resnet50 Status: RUNNING Namespace: default Priority: N/A Trainer: MPIJOB Duration: 9s Instances: NAME STATUS AGE IS_CHIEF GPU(Requested) NODE ---- ------ --- -------- -------------- ---- tensorflow-4-resnet50-launcher-q24hv Running 9s true 0 cn-shanghai.192.168.16.172 tensorflow-4-resnet50-worker-0 Running 9s false 1 cn-shanghai.192.168.16.172 tensorflow-4-resnet50-worker-1 Running 9s false 1 cn-shanghai.192.168.16.173 tensorflow-4-resnet50-worker-2 Running 9s false 1 cn-shanghai.192.168.16.172 tensorflow-4-resnet50-worker-3 Running 9s false 1 cn-shanghai.192.168.16.173 -
Lihat log pelatihan:
arena logs -f tensorflow-4-resnet50Output yang diharapkan:
total images/sec: 745.38
Perbandingan performa
Throughput untuk pelatihan VGG16 dan ResNet50 dengan penjadwalan GPU yang memperhatikan topologi dan penjadwalan biasa:
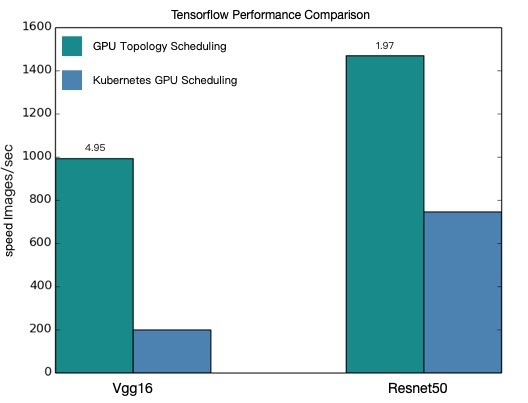
| Model | Memperhatikan Topologi (images/sec) | Regular (images/second) | Peningkatan |
|---|---|---|---|
| VGG16 | 991,92 | 200,47 | ~4,9x |
| ResNet50 | 1471,55 | 745,38 | ~2,0x |
Nilai performa bersifat teoretis. Hasil aktual bervariasi tergantung model, konfigurasi kluster, dan kondisi jaringan. Jalankan contoh-contoh ini di kluster Anda untuk mengukur peningkatan yang diperoleh.