System Observer Monitoring (SysOM) menyediakan observabilitas kontainer tingkat kernel serta mendukung penerapan, migrasi, dan pemantauan berbasis kontainer. Topik ini menjelaskan cara mengaktifkan dan menggunakan ack-sysom-monitor serta menguraikan metrik terkait.
Prasyarat
Sebelum memulai, pastikan Anda telah:
-
Kluster ACK yang dikelola atau kluster ACK Serverless yang dibuat setelah Oktober 2021 dengan Kubernetes versi 1.18.8 atau lebih baru. Lihat Buat kluster ACK yang dikelola atau Buat kluster ACK Serverless. Untuk memperbarui, lihat Memperbarui kluster ACK secara manual.
-
Mengaktifkan Managed Service for Prometheus. Lihat Enable Managed Service for Prometheus.
Apa yang dikumpulkan oleh ack-sysom-monitor
ack-sysom-monitor adalah komponen System Observer Monitoring (SysOM) yang menggunakan extended Berkeley Packet Filter (eBPF) untuk mengumpulkan dan memperkaya metrik tingkat kernel untuk node dan kontainer. Selain metrik sistem standar, komponen ini menyediakan metrik tambahan untuk pemantauan tingkat kernel pod dan node, membantu mengidentifikasi masalah seperti jitter sistem, keterlambatan, kebocoran resource, dan anomali memori pod.
Penagihan
Setelah ack-sysom-monitor diaktifkan, komponen terkait secara otomatis mengirim metrik pemantauan ke Managed Service for Prometheus. Metrik ini ditagih sebagai custom metrics.
Sebelum mengaktifkan fitur ini, baca Billing overview untuk memahami cara penagihan custom metrics. Biaya bervariasi tergantung pada ukuran kluster dan jumlah aplikasi yang berjalan. Untuk memantau dan mengontrol penggunaan resource, lihat View resource usage.
Aktifkan ack-sysom-monitor
-
Login ke ARMS console.
-
Di panel navigasi sebelah kiri, klik Integration Center.
-
Di bagian Infrastructure pada halaman Integration Center, klik SysOM System Observation.
-
Pada langkah Start Integration di panel SysOM System Observation, pilih kluster ACK lalu klik OK.
Lihat data pemantauan
-
Login ke ACK console. Di panel navigasi sebelah kiri, klik Clusters.
-
Pada halaman Clusters, klik nama kluster Anda. Di panel sebelah kiri, pilih Operations > Prometheus Monitoring.
-
Pada halaman Prometheus Monitoring, klik tab SysOM.
ack-sysom-monitormendukung dua tampilan pemantauan:-
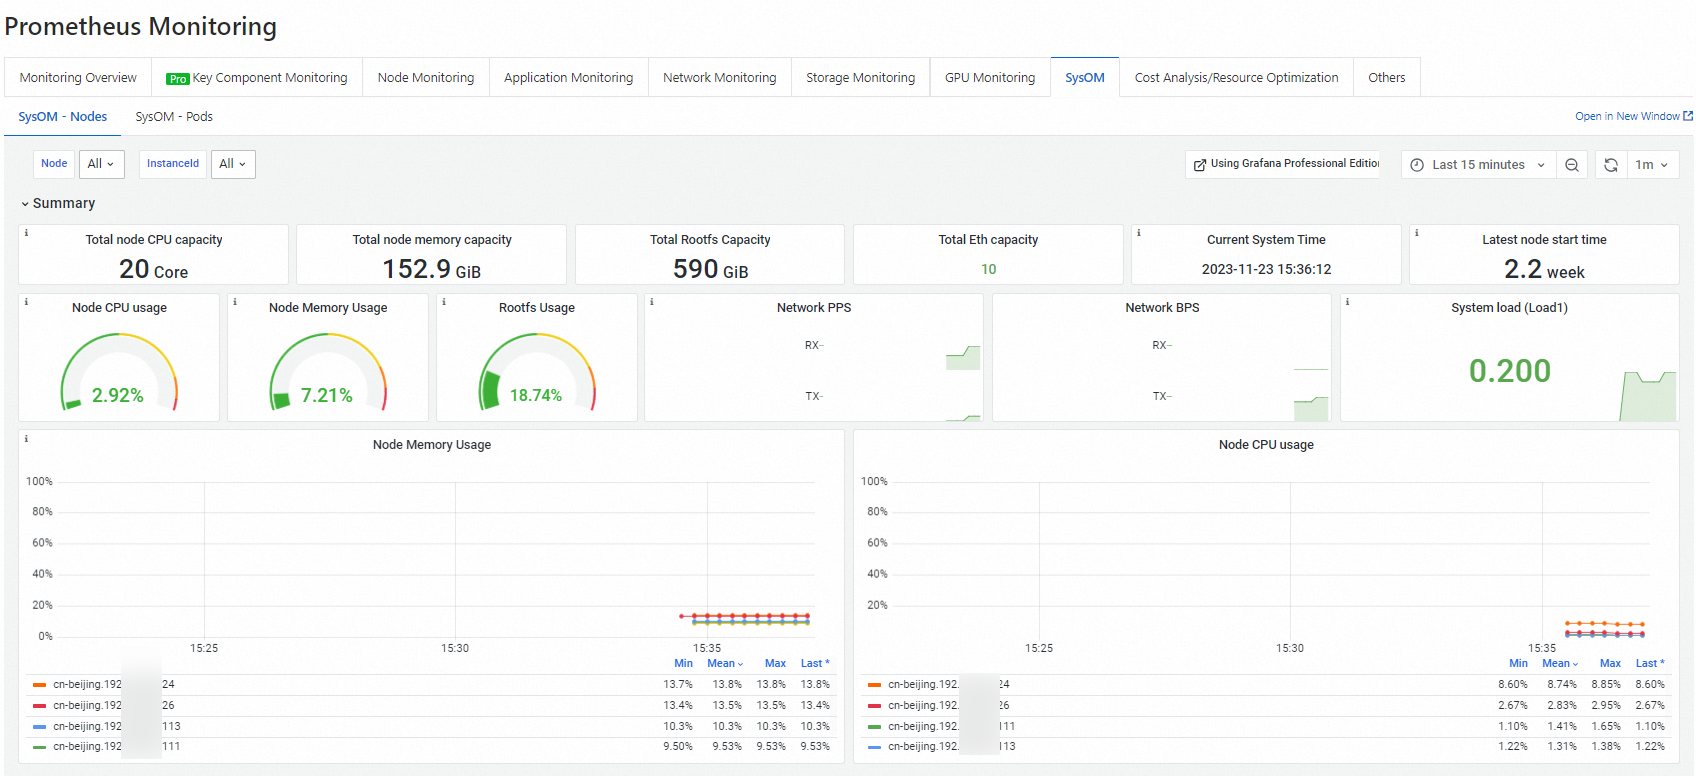
Node kernel-level monitoring — Pada tab SysOM - Nodes, lihat metrik CPU, memori, penjadwalan, penyimpanan, dan jaringan untuk setiap node.
-
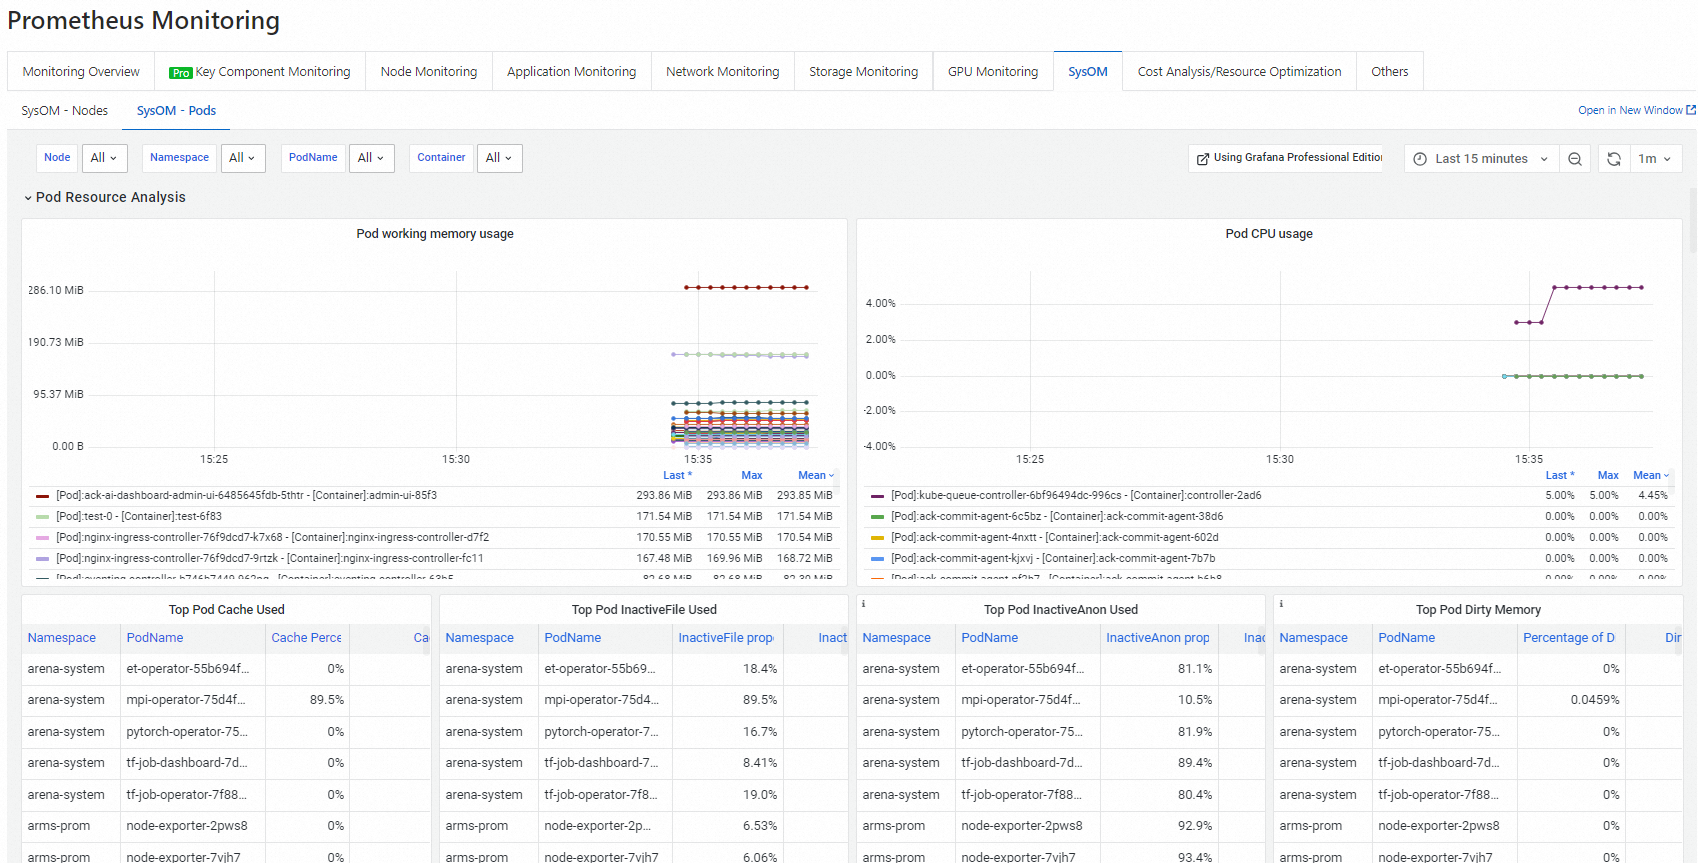
Pod kernel-level monitoring — Pada tab SysOM - Pods, lihat metrik memori, CPU, jaringan, dan I/O untuk setiap pod secara real time.
-
Langkah selanjutnya
Untuk menghentikan biaya yang terus berjalan, uninstall komponen ack-sysom-monitor. Lihat Manage components.
Metrik
Semua metrik yang disediakan oleh ack-sysom-monitor mengikuti Prometheus data model.
Semua jenis metrik yang tercantum di bawah ini bertipe gauge.
Skenario diagnosis
Gunakan tabel berikut untuk menelusuri dari gejala ke metrik terkait.
| Gejala | Metrik terkait |
|---|---|
| Throttling CPU atau keterlambatan penjadwalan | sysom_proc_schedstat, sysom_cpu_dist, sysom_container_cpu_stat, sysom_container_cpu_cfsquota |
| Beban tinggi atau terlalu banyak proses dalam status D | sysom_proc_stat_counters, sysom_proc_loadavg |
| Tekanan memori atau event OOM | sysom_proc_vmstat, sysom_container_memory_gdrcm_latency, sysom_container_memory_cdrcm_latency, sysom_container_memory_cpt_latency |
| Page cache menyebabkan jitter memori | sysom_container_memory_filecache |
| Kebocoran cgroup | sysom_cgroups |
| Latensi atau masalah throughput I/O disk | sysom_proc_disks, sysom_container_blkio_stat |
| Kehilangan paket jaringan atau pengiriman ulang | sysom_proc_pkt_status, sysom_net_retrans_count |
| RTT TCP tinggi atau anomali koneksi | sysom_net_health_hist, sysom_net_health_count, sysom_net_tcp_count |
| Kehabisan socket atau buffer | sysom_sock_stat |
Metrik node
Metrik node mencakup CPU dan penjadwalan, memori, penyimpanan, jaringan, serta metrik sistem lainnya.
CPU dan penjadwalan
|
Metric |
Type |
Unit |
Description |
|
sysom_proc_cpu_total |
gauge |
% |
Rincian uptime CPU untuk seluruh node berdasarkan status: mode user, mode kernel, softirq, hardirq, idle, dan iowait. Mengidentifikasi status mana yang mengonsumsi waktu CPU. |
|
sysom_proc_cpus |
gauge |
% |
Rincian uptime CPU per core berdasarkan status: mode user, mode kernel, softirq, hardirq, idle, dan iowait. Mendeteksi ketidakseimbangan per core. |
|
sysom_proc_sirq |
gauge |
% |
Jumlah kejadian per jenis softirq: HI, TIMER, NET_TX, NET_RX, BLOCK, IRQ_POLL, TASKLET, SCHED, HRTIMER, dan RCU. Lonjakan pada NET_RX atau NET_TX dapat mengindikasikan saturasi jaringan. |
|
sysom_proc_stat_counters |
gauge |
- |
Jumlah proses dalam status Running atau D, waktu startup sistem, dan jumlah context switch. Jumlah status D yang tinggi mengindikasikan contention I/O atau lock. |
|
sysom_proc_loadavg |
gauge |
- |
Rata-rata beban pada interval 1 menit, 5 menit, dan 15 menit, serta panjang run-queue dan jumlah total proses. Menilai tren beban berkelanjutan. |
|
sysom_proc_schedstat |
gauge |
ns (nanodetik) |
Latensi penjadwalan CPU: waktu tunggu dalam run queue dan durasi time slice CPU. Waktu tunggu yang tinggi mengindikasikan tekanan penjadwalan. |
|
sysom_cpu_dist |
gauge |
- |
Distribusi interval penjadwalan CPU: waktu dari melepas CPU hingga dijadwalkan ulang. Dibagi menjadi bucket 1 µs, 10 µs, 100 µs, 1 ms, 10 ms, 100 ms, dan 1 s. Latensi ekor panjang mengindikasikan jitter penjadwalan. |
Memori
|
Metric |
Type |
Unit |
Description |
|
sysom_proc_meminfo |
gauge |
KiB |
Penggunaan memori tingkat node: Total, Free, Available, Cache, Buffers, SReclaimable, dan SUnreclaim. Menilai tekanan memori secara keseluruhan. |
|
sysom_proc_vmstat |
gauge |
- |
Statistik halaman memori: jumlah halaman bebas, halaman kotor, halaman yang dibaca/ditulis, halaman yang direklaim dari daftar inactive, dan jumlah pemanggilan OOM killer. Aktivitas OOM killer menandakan kehabisan memori kritis. |
|
sysom_proc_buddyinfo |
gauge |
- |
Status alokator buddy system: jumlah blok tersedia berdasarkan ukuran di setiap zona memori dan node. Mendeteksi fragmentasi memori yang dapat menyebabkan kegagalan alokasi. |
Penyimpanan
|
Metric |
Type |
Unit |
Description |
|
sysom_proc_disks |
gauge |
- |
Statistik I/O per disk dan partisi: jumlah permintaan baca/tulis dan byte, jumlah penggabungan, jumlah permintaan sedang berjalan (inflight), dan total waktu penyelesaian permintaan. Mendiagnosis masalah throughput dan latensi disk. |
|
sysom_fs_stat |
gauge |
- |
Penggunaan file system per titik mount: ukuran blok, blok yang digunakan dan tersedia, serta inode yang digunakan dan tersedia. Mendeteksi kehabisan disk atau inode sebelum menyebabkan kegagalan. |
Jaringan
|
Metric |
Type |
Unit |
Description |
|
sysom_proc_networks |
gauge |
- |
Statistik transfer data per NIC: jumlah paket dan byte yang diterima dan dikirim, jumlah discard tingkat driver, serta error pengiriman/penerimaan. Mendeteksi kehilangan paket tingkat NIC. |
|
sysom_proc_pkt_status |
gauge |
- |
Event tumpukan protokol jaringan: kehilangan paket, luapan buffer, dan kegagalan assertion. Mengidentifikasi lokasi kehilangan paket dalam stack. |
|
sysom_sock_stat |
gauge |
- |
Penggunaan socket dan buffer: jumlah total socket raw, TCP, dan UDP, jumlah socket TCP dalam status TIME_WAIT atau orphan, serta penggunaan memori socket TCP/UDP. Jumlah TIME_WAIT atau orphan yang tinggi dapat mengindikasikan masalah penanganan koneksi akibat logika aplikasi atau parameter sistem. |
|
sysom_softnets |
gauge |
- |
Statistik softirq NIC per CPU: jumlah paket yang diterima dan dikirim per softirq, serta jumlah pemanggilan |
|
sysom_net_health_hist |
gauge |
- |
Distribusi round-trip time (RTT) di seluruh koneksi TCP pada node, dibagi menjadi bucket 10 ms, 100 ms, dan 1 s. Mendeteksi degradasi latensi TCP. |
|
sysom_net_health_count |
gauge |
- |
RTT rata-rata koneksi TCP pada node. Mirip dengan |
|
sysom_net_retrans_count |
gauge |
- |
Statistik retransmisi TCP: jumlah paket yang diretransmisi berdasarkan jenis (SYN, SYN-ACK, RESET), termasuk retransmisi akibat timeout. Jumlah yang meningkat mengindikasikan ketidakstabilan atau kemacetan jaringan. |
|
sysom_net_tcp_count |
gauge |
- |
Statistik koneksi TCP: jumlah koneksi aktif, segmen yang diterima dan dikirim, segmen yang diretransmisi, dan kegagalan penerimaan. |
|
sysom_net_udp_count |
gauge |
- |
Statistik UDP: paket yang diterima dan dikirim, error buffer kirim/terima, serta paket yang dibuang karena tidak tersedia port. |
|
sysom_net_ip_count |
gauge |
- |
Statistik lapisan IP: paket yang diteruskan, diterima, dan dikirim. |
|
sysom_net_icmp_count |
gauge |
- |
Statistik ICMP: paket yang diterima dan dikirim, serta kegagalan kirim/terima. |
Metrik sistem lainnya
|
Metric |
Type |
Unit |
Description |
|
sysom_cgroups |
gauge |
- |
Jumlah cgroup yang digunakan di berbagai subsistem: CPU, Cpuacct, Memory, Pids, Blkio, dan Devices. Jumlah yang terus meningkat tanpa penurunan dapat mengindikasikan kebocoran cgroup. |
|
sysom_uptime |
gauge |
s (detik) |
Waktu uptime sistem sejak boot terakhir, dan waktu idle. |
Metrik kontainer
Metrik kontainer mencakup CPU dan penjadwalan, memori, I/O, serta metrik jaringan.
CPU dan penjadwalan
|
Metric |
Type |
Unit |
Description |
|
sysom_container_cpu_stat |
gauge |
- |
Statistik throttling CPU per cgroup: jumlah kali batas CPU diberlakukan, total jumlah pemberlakuan, dan total durasi pemberlakuan. Menentukan apakah kuota resource perlu disesuaikan. |
|
sysom_container_cpu_acctstat |
gauge |
% |
Pemanfaatan CPU untuk tugas kontainer, dirinci berdasarkan mode: user, kernel, dan total. Menunjukkan cara kontainer mengonsumsi CPU di ruang kernel dan user. |
|
sysom_container_cpu_cfsquota |
gauge |
- |
Konfigurasi Completely Fair Scheduler (CFS) untuk cgroup kontainer: |
Memori
|
Metric |
Type |
Unit |
Description |
|
sysom_container_memory_stat |
gauge |
KiB |
Penggunaan memori kontainer berdasarkan kategori: Total, Free, Available, Cache, Buffers, SReclaimable, dan SUnreclaim. Menilai konsumsi memori per kontainer. |
|
sysom_container_memory_filecache |
gauge |
KiB |
Penggunaan page cache per kontainer: 10 file teratas yang paling banyak mengonsumsi page cache, ukuran file, dan total page cache yang digunakan. Mengidentifikasi kontainer tempat penggunaan berlebihan page cache menyebabkan tekanan memori, latensi, atau jitter. |
|
sysom_container_memory_gdrcm_latency |
gauge |
Times |
Keterlambatan akibat reklamasi memori karena sumber daya memori tidak mencukupi. Menghitung keterlambatan dalam enam rentang: 1–5 ms, 5–10 ms, 10–100 ms, 100–500 ms, 500–1.000 ms, dan lebih dari 1.000 ms. Mendeteksi tekanan memori tingkat node yang memengaruhi kinerja kontainer. |
|
sysom_container_memory_cdrcm_latency |
gauge |
Times |
Keterlambatan akibat reklamasi memori karena cgroup memori tidak mencukupi. Menghitung keterlambatan dalam rentang yang sama seperti
Note
Metrik ini hanya berlaku jika cgroup memori saat ini bukan root cgroup atau batas memori telah dikonfigurasi untuk cgroup memori saat ini. |
|
sysom_container_memory_cpt_latency |
gauge |
Times |
Keterlambatan akibat penyesuaian memori kernel, dipicu ketika suatu proses dalam kontainer meminta memori tetapi node tidak memiliki memori yang cukup atau terdapat jumlah fragmen memori yang berlebihan. Menghitung keterlambatan dalam rentang yang sama. Mendeteksi fragmentasi memori yang memengaruhi alokasi kontainer. |
I/O
|
Metric |
Type |
Unit |
Description |
|
sysom_container_blkio_stat |
gauge |
- |
Statistik Block I/O untuk disk kontainer: jumlah permintaan baca/tulis dan byte, jumlah permintaan dan byte dalam antrian, serta waktu tunggu permintaan. Mendiagnosis bottleneck I/O tingkat kontainer. |
Jaringan
|
Metric |
Type |
Unit |
Description |
|
sysom_container_network_stat |
gauge |
- |
Statistik transfer data NIC virtual per kontainer: jumlah paket dan byte yang diterima dan dikirim, serta jumlah discard tingkat perangkat. Paket yang dibuang oleh tumpukan protokol jaringan tidak termasuk. |