Volume persisten (PV) OSS mendukung beberapa klien, tetapi dukungan penulisan penuh menurunkan performa pembacaan. Pemisahan baca/tulis mengatasi masalah ini dengan mengarahkan operasi baca dan tulis melalui jalur mount terpisah, sehingga meningkatkan throughput pada beban kerja yang intensif membaca, seperti Pelatihan model, Inferensi, dan analitik data.
Terapkan Pemisahan baca/tulis untuk PV OSS menggunakan ossfs atau OSS SDK, sebagaimana ditunjukkan dalam pekerjaan pelatihan pengenalan tulisan tangan MNIST.
Prasyarat
Pastikan Anda telah:
Menginstal versi terbaru komponen Container Storage Interface (CSI). Klien berbeda memerlukan versi CSI yang berbeda. Lihat Mengelola komponen csi-plugin dan csi-provisioner.
Sebuah Bucket OSS di akun Alibaba Cloud yang sama dengan kluster tersebut.
Akses OSS lintas akun tidak disarankan.
Pilih client
PV OSS mendukung tiga klien — ossfs 1.0, ossfs 2.0, dan strmvol. Masing-masing klien mendukung akses read-only; kemampuan menulisnya berbeda-beda:
Client | Read-only | Read/write | Terbaik untuk |
ossfs 1.0 | Yes | Full write | Beban kerja baca/tulis umum; mode direct read tersedia (v1.91+) |
ossfs 2.0 | Yes | Sequential append writes only | Beban kerja yang banyak membaca; memerlukan CSI >= 1.33.1 |
strmvol | Yes | — | Banyak file kecil (set data, log time-series, backtesting kuantitatif) |
Lihat Referensi pemilihan klien.
Kasus penggunaan
Akses read-only
Tetapkan mode akses PV ke ReadOnlyMany untuk mencegah modifikasi data yang tidak disengaja — cocok untuk Inferensi, analitik data, dan kueri log.
Untuk beban kerja yang banyak membaca, gunakan ossfs 2.0 (CSI >= 1.33.1). Lihat Menggunakan PV ossfs 2.0.
Untuk banyak file kecil, gunakan strmvol. Lihat Menggunakan PV strmvol.
Konfigurasikan parameter otherOpts berikut untuk menyesuaikan ossfs 1.0 pada skenario read-only. Sebagian besar beban kerja dapat menggunakan nilai default.
Parameter | Default | Deskripsi |
| Disabled | Mengaktifkan cache buffer kernel untuk pembacaan non-real-time. Menggunakan memori bebas untuk caching. |
| 20 | Shard konkuren untuk upload dan download file besar. |
| 20 | Jumlah maksimum permintaan listing metadata konkuren. Harus >= |
| 1000 | Jumlah entri metadata yang di-cache. Tetapkan ke |
| Disabled | Mode direct read untuk skenario read-only (ossfs >= 1.91). Lihat Fitur dan pengujian performa versi baru ossfs 1.0 dan Optimasi performa untuk skenario read-only. |
Akses read/write
Tetapkan mode akses PV ke ReadWriteMany untuk beban kerja yang menulis data.
ossfs tidak menjamin konsistensi untuk penulisan konkuren — beberapa penulis pada objek yang sama dapat menyebabkan korupsi data. Gunakan satu penulis per path untuk penulisan checkpoint.
Menghapus atau memodifikasi file di path yang dimount juga akan menghapus atau memodifikasi objek di Bucket OSS. Aktifkan Pengendalian versi untuk melindungi dari kehilangan data.
Untuk beban kerja yang intensif membaca dengan path baca dan tulis terpisah (seperti Pelatihan model), mount path baca sebagai ReadOnlyMany dengan caching diaktifkan, dan tangani penulisan melalui PV ReadWriteMany atau OSS SDK.
Cara kerja Pemisahan baca/tulis
Pemisahan baca/tulis mengarahkan operasi baca dan tulis melalui titik mount terpisah, masing-masing mengarah ke subpath berbeda dari Bucket OSS yang sama. Hal ini mengisolasi I/O baca dari I/O tulis.
Path baca — Mount subpath (misalnya,
/tf-train/train/data) sebagaiReadOnlyManydengan caching diaktifkan. Pembacaan berulang dilayani dari memori.Path tulis — Mount subpath berbeda (misalnya,
/tf-train/training_logs) sebagaiReadWriteMany, atau tulis langsung melalui SDK.
Contoh: Pelatihan pengenalan tulisan tangan MNIST
Pekerjaan pelatihan:
Membaca set data pelatihan dari
/tf-train/train/datadi Bucket OSS menggunakan PV read-only.Menulis checkpoint pelatihan ke
/tf-train/training_logsmenggunakan PV read/write atau OSS SDK.
Unduh set data MNIST dan unggah ke /tf-train/train/data di Bucket OSS Anda:
Struktur file di Bucket OSS:

Implementasikan operasi baca/tulis menggunakan ossfs
Karena penulisan checkpoint bersifat sequential append, baik ossfs 1.0 maupun ossfs 2.0 dapat digunakan untuk path tulis.
Deploy aplikasi pelatihan. Aplikasi melakukan mount subpath
/tf-traindari Bucket OSS ke direktori/mntPod. Lihat Menggunakan volume provisioned statis ossfs 1.0 atau Menggunakan PV ossfs 2.0.Buat PV ossfs 1.0:
cat << EOF | kubectl apply -f -
apiVersion: v1
kind: Secret
metadata:
  name: oss-secret
  namespace: default
stringData:
  akId: "<your-accesskey-id>"
  akSecret: "<your-accesskey-secret>"
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: tf-train-pv
  labels:
    alicloud-pvname: tf-train-pv
spec:
  capacity:
    storage: 10Gi
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  csi:
    driver: ossplugin.csi.alibabacloud.com
    volumeHandle: tf-train-pv
    nodePublishSecretRef:
      name: oss-secret
      namespace: default
    volumeAttributes:
      bucket: "<your-bucket-name>"
      url: "oss-<region>.aliyuncs.com"
      otherOpts: "-o max_stat_cache_size=0 -o allow_other"
      path: "/tf-train"
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: tf-train-pvc
spec:
  accessModes:
  - ReadWriteMany
  resources:
    requests:
      storage: 10Gi
  selector:
    matchLabels:
      alicloud-pvname: tf-train-pv
EOF
Buat Pod pelatihan:
Selama pelatihan, ossfs mengunggah file dari
/mnt/training_logs(Pod) ke/tf-train/training_logs(Bucket OSS).cat << EOF | kubectl apply -f - apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:rw imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc EOF
Verifikasi pembacaan dan penulisan data.
Periksa status Pod:
kubectl get pod tf-mnistTunggu hingga status berubah dari
RunningmenjadiCompleted:NAME READY STATUS RESTARTS AGE tf-mnist 0/1 Completed 0 2m12sPeriksa waktu pemuatan data:
kubectl logs tf-mnist | grep dataloadOutput yang diharapkan:
dataload cost time: 1.54191803932Login ke Konsol Manajemen OSS dan verifikasi bahwa file ada di bawah
/tf-train/training_logsdi bucket.
Optimalkan performa baca menggunakan Pemisahan baca/tulis
Pisahkan PV baca/tulis tunggal menjadi dua: PV read-only dengan tuning cache untuk set data, dan PV write untuk checkpoint. Hanya konfigurasi mount yang berubah — kode pelatihan tetap sama.
Dua opsi penulisan:
Opsi 1: Gunakan PV ossfs read/write terpisah untuk penulisan checkpoint.
Opsi 2: Gunakan OSS SDK untuk menulis checkpoint secara langsung, melewati ossfs sepenuhnya.
Opsi 1: Menulis menggunakan PV ossfs read/write
Buat PV ossfs 1.0 read-only untuk set data. Perubahan konfigurasi utama:
Tetapkan
accessModeskeReadOnlyManypada PV dan PVC. Mount subpath set data/tf-train/train/data.Pada
otherOpts, tambahkan-o kernel_cache -o max_stat_cache_size=10000 -o umask=022:kernel_cachemengaktifkan caching baca di memori.max_stat_cache_size=10000menyimpan cache 10.000 entri metadata (~40 MB). Sesuaikan berdasarkan tipe instans dan ukuran set data.umask=022memberikan akses baca ke proses kontainer non-root.
cat << EOF | kubectl apply -f -
apiVersion: v1
kind: Secret
metadata:
  name: oss-secret
  namespace: default
stringData:
  akId: "<your-accesskey-id>"
  akSecret: "<your-accesskey-secret>"
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: tf-train-pv
  labels:
    alicloud-pvname: tf-train-pv
spec:
  capacity:
    storage: 10Gi
  accessModes:
    - ReadOnlyMany
  persistentVolumeReclaimPolicy: Retain
  csi:
    driver: ossplugin.csi.alibabacloud.com
    volumeHandle: tf-train-pv
    nodePublishSecretRef:
      name: oss-secret
      namespace: default
    volumeAttributes:
      bucket: "<your-bucket-name>"
      url: "oss-<region>.aliyuncs.com"
      otherOpts: "-o kernel_cache -o max_stat_cache_size=10000 -o umask=022 -o allow_other"
      path: "/tf-train/train/data"
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: tf-train-pvc
spec:
  accessModes:
  - ReadOnlyMany
  resources:
    requests:
      storage: 10Gi
  selector:
    matchLabels:
      alicloud-pvname: tf-train-pv
EOF
Buat PV ossfs 1.0 read/write untuk checkpoint, mount subpath
/tf-train/training_logs. Caching metadata dinonaktifkan (max_stat_cache_size=0) karena penulisan checkpoint sequential tidak mendapat manfaat dari caching.cat << EOF | kubectl apply -f - apiVersion: v1 kind: PersistentVolume metadata: name: tf-logging-pv labels: alicloud-pvname: tf-logging-pv spec: capacity: storage: 10Gi accessModes: - ReadWriteMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-logging-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o max_stat_cache_size=0 -o allow_other" path: "/tf-train/training_logs" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-logging-pvc spec: accessModes: - ReadWriteMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-logging-pv EOFDeploy Pod pelatihan dengan kedua PV dimount.
Tidak diperlukan perubahan kode. Mount kedua PV — PV read-only di
/mnt/train/datadan PV read/write di/mnt/training_logs.cat << EOF | kubectl apply -f - apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:rw imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt/train/data" - name: logging mountPath: "/mnt/training_logs" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc - name: logging persistentVolumeClaim: claimName: tf-logging-pvc EOF
Opsi 2: Menulis menggunakan OSS SDK
Tulis checkpoint langsung ke OSS dengan SDK — tidak diperlukan PV read/write. Pod membaca dari PV read-only dan menulis melalui SDK.
Tambahkan OSS Python SDK ke gambar kontainer:
RUN pip install oss2Lihat Instalasi.
Modifikasi kode pelatihan untuk mengunggah checkpoint menggunakan SDK. Kode asli menyimpan checkpoint ke
log_dirsetiap 100 iterasi menggunakantf.train.Saverdenganmax_to_keep=0, menghasilkan 10 set checkpoint setelah 1.000 iterasi.Tetapkan
max_to_keep=1untuk hanya menyimpan checkpoint terbaru, mengurangi Penggunaan memori.Unggah setiap checkpoint ke OSS dengan
put_object_from_filesetelah disimpan.
Gunakan I/O asinkron dengan SDK untuk lebih meningkatkan throughput ketika path baca dan tulis dipisahkan.
def train():
    ...
saver = tf.train.Saver(max_to_keep=0)

    for i in range(FLAGS.max_steps):
        if i % 10 == 0:  # Record summaries and test-set accuracy
            summary, acc = sess.run([merged, accuracy], feed_dict=feed_dict(False))
            print('Accuracy at step %s: %s' % (i, acc))
            if i % 100 == 0:
                print('Save checkpoint at step %s: %s' % (i, acc))
                saver.save(sess, FLAGS.log_dir + '/model.ckpt', global_step=i)
Ganti dengan unggahan berbasis SDK. Dua perubahan mengurangi Penggunaan memori dan menghilangkan PV read/write: baca pengaturan AccessKey dan bucket dari Variabel lingkungan. Lihat Mengonfigurasi kredensial akses.
import oss2
from oss2.credentials import EnvironmentVariableCredentialsProvider

auth = oss2.ProviderAuth(EnvironmentVariableCredentialsProvider())
url = os.getenv('URL','<default-url>')
bucketname = os.getenv('BUCKET','<default-bucket-name>')
bucket = oss2.Bucket(auth, url, bucketname)

...
def train():
  ...
  saver = tf.train.Saver(max_to_keep=1)

 for i in range(FLAGS.max_steps):
    if i % 10 == 0:  # Record summaries and test-set accuracy
      summary, acc = sess.run([merged, accuracy], feed_dict=feed_dict(False))
      print('Accuracy at step %s: %s' % (i, acc))
      if i % 100 == 0:
        print('Save checkpoint at step %s: %s' % (i, acc))
        saver.save(sess, FLAGS.log_dir + '/model.ckpt', global_step=i)
        # FLAGS.log_dir = os.path.join(os.getenv('TEST_TMPDIR', '/mnt'),'training_logs')
        for path,_,file_list in os.walk(FLAGS.log_dir) :
          for file_name in file_list:
            bucket.put_object_from_file(os.path.join('tf-train/training_logs', file_name), os.path.join(path, file_name))
Gambar kontainer yang dimodifikasi adalah
registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:ro.Deploy Pod dengan PV read-only dan kredensial SDK. Pod menetapkan
accessModeskeReadOnlyManydan meneruskanOSS_ACCESS_KEY_IDdanOSS_ACCESS_KEY_SECRETagar SDK melakukan autentikasi dengan kredensial yang sama seperti PV.cat << EOF | kubectl apply -f - apiVersion: v1 kind: Secret metadata: name: oss-secret namespace: default stringData: akId: "<your-accesskey-id>" akSecret: "<your-accesskey-secret>" --- apiVersion: v1 kind: PersistentVolume metadata: name: tf-train-pv labels: alicloud-pvname: tf-train-pv spec: capacity: storage: 10Gi accessModes: - ReadOnlyMany persistentVolumeReclaimPolicy: Retain csi: driver: ossplugin.csi.alibabacloud.com volumeHandle: tf-train-pv nodePublishSecretRef: name: oss-secret namespace: default volumeAttributes: bucket: "<your-bucket-name>" url: "oss-<region>.aliyuncs.com" otherOpts: "-o kernel_cache -o max_stat_cache_size=10000 -o umask=022 -o allow_other" path: "/tf-train/train/data" --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: tf-train-pvc spec: accessModes: - ReadOnlyMany resources: requests: storage: 10Gi selector: matchLabels: alicloud-pvname: tf-train-pv --- apiVersion: v1 kind: Pod metadata: labels: app: tfjob name: tf-mnist namespace: default spec: containers: - command: - sh - -c - python /app/main.py env: - name: NVIDIA_VISIBLE_DEVICES value: void - name: gpus value: "0" - name: workers value: "1" - name: TEST_TMPDIR value: "/mnt" - name: OSS_ACCESS_KEY_ID #The source of the AccessKey is the same as that of the PV. valueFrom: secretKeyRef: name: oss-secret key: akId - name: OSS_ACCESS_KEY_SECRET #The source of the AccessKey is the same as that of the PV. valueFrom: secretKeyRef: name: oss-secret key: akSecret - name: URL #You can ignore this if a default URL is configured. value: "https://oss-<region>.aliyuncs.com" - name: BUCKET #You can ignore this if a default BUCKET is configured. value: "<bucket-name>" image: registry.cn-beijing.aliyuncs.com/tool-sys/tf-train-demo:ro imagePullPolicy: Always name: tensorflow ports: - containerPort: 20000 name: tfjob-port protocol: TCP volumeMounts: - name: train mountPath: "/mnt/train/data" workingDir: /root priority: 0 restartPolicy: Never securityContext: {} terminationGracePeriodSeconds: 30 volumes: - name: train persistentVolumeClaim: claimName: tf-train-pvc EOF
Verifikasi Pemisahan baca/tulis
Setelah deploy dengan salah satu opsi penulisan:
Periksa status Pod:
kubectl get pod tf-mnistTunggu hingga status berubah menjadi
Completed:NAME READY STATUS RESTARTS AGE tf-mnist 0/1 Completed 0 2m25sPeriksa waktu pemuatan data:
kubectl logs tf-mnist | grep dataloadDengan Pemisahan baca/tulis dan kernel cache diaktifkan, waktu pemuatan data turun:
dataload cost time: 0.843528985977Garis dasar tanpa pemisahan sekitar 1,54 detik. Pekerjaan pelatihan yang lebih besar dan pemuatan data berulang menunjukkan peningkatan yang lebih signifikan.
Login ke Konsol Manajemen OSS dan verifikasi bahwa file checkpoint ada di bawah
/tf-train/training_logsdi bucket.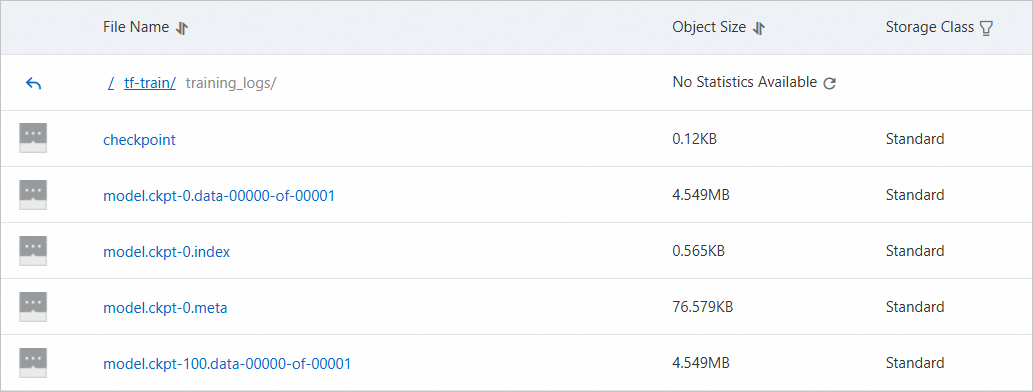
Referensi
Referensi OSS SDK
Topik ini menggunakan SDK Python. SDK lain yang tersedia:
Untuk SDK lainnya (PHP, Node.js, Browser.js, .NET, Android, iOS, Ruby), lihat Referensi SDK.
Alat tulis lainnya
Alat-alat berikut juga mendukung penulisan ke OSS:
Tool | Referensi |
OpenAPI | |
antarmuka baris perintah ossutil | |
alat manajemen grafis ossbrowser |