Si vous rencontrez des difficultés pour collecter les journaux depuis des conteneurs standard ou Kubernetes avec Logtail, utilisez cette rubrique pour diagnostiquer le problème, vérifier l'état d'exécution et effectuer d'autres opérations de maintenance.
Vérification du signal de maintien de connexion (heartbeat) du groupe de machines
Si la liste Machine Groups dans la console Simple Log Service n'affiche aucun groupe de machines, ou si vous ne pouvez pas sélectionner un groupe de machines source lors de la création d'une configuration Logtail après avoir installé le plugin de journalisation (LoongCollector ou Logtail-ds) dans un cluster ACK ou ACS, vérifiez le signal de maintien de connexion (heartbeat) du groupe de machines en suivant l'ordre ci-dessous. Un groupe de machines utilise un identifiant unique (UID), tel que l'ID de compte Alibaba Cloud, comme identifiant personnalisé. Chaque serveur du groupe de machines signale une adresse IP au backend Simple Log Service.
Vérifiez le projet : un groupe de machines est visible uniquement dans le projet auquel il appartient et n'est pas accessible entre différents projets. Le projet créé automatiquement pour un cluster ACK ou ACS porte généralement un nom au format
k8s-log-${cluster_id}. Assurez-vous d'avoir ouvert ce projet et recherchez le groupe de machines dans ce même projet.Vérifiez l'état d'installation du composant : sur la page des détails du cluster dans la console ACK, choisissez Component Management et vérifiez que le composant LoongCollector ou Logtail-ds est installé et en cours d'exécution. En cas d'échec de l'installation, réinstallez le composant selon les instructions affichées.
Vérifiez les autorisations et effectuez une vérification manuelle : assurez-vous que le compte actuel dispose des autorisations nécessaires pour afficher les groupes de machines dans ce projet. Accédez à Simple Log Service Console > Resources > Machine Groups et vérifiez l'existence d'un groupe de machines nommé
k8s-group-${cluster_id}. La configuration du groupe de machines utilise un identifiant personnalisé pour identifier le cluster. Assurez-vous que l'identifiant personnalisé dans le groupe de machines correspond à celui de la configuration de collecte Logtail. Si le groupe de machines n'existe pas, réinstallez le composant de journalisation dans le cluster ACK.
Vérifiez le signal de maintien de connexion (heartbeat) du groupe de machines pour confirmer que Logtail est correctement installé dans vos conteneurs.
-
Vérifiez l'état du signal de maintien de connexion (heartbeat) du groupe de machines.
Connectez-vous à la console Simple Log Service.
-
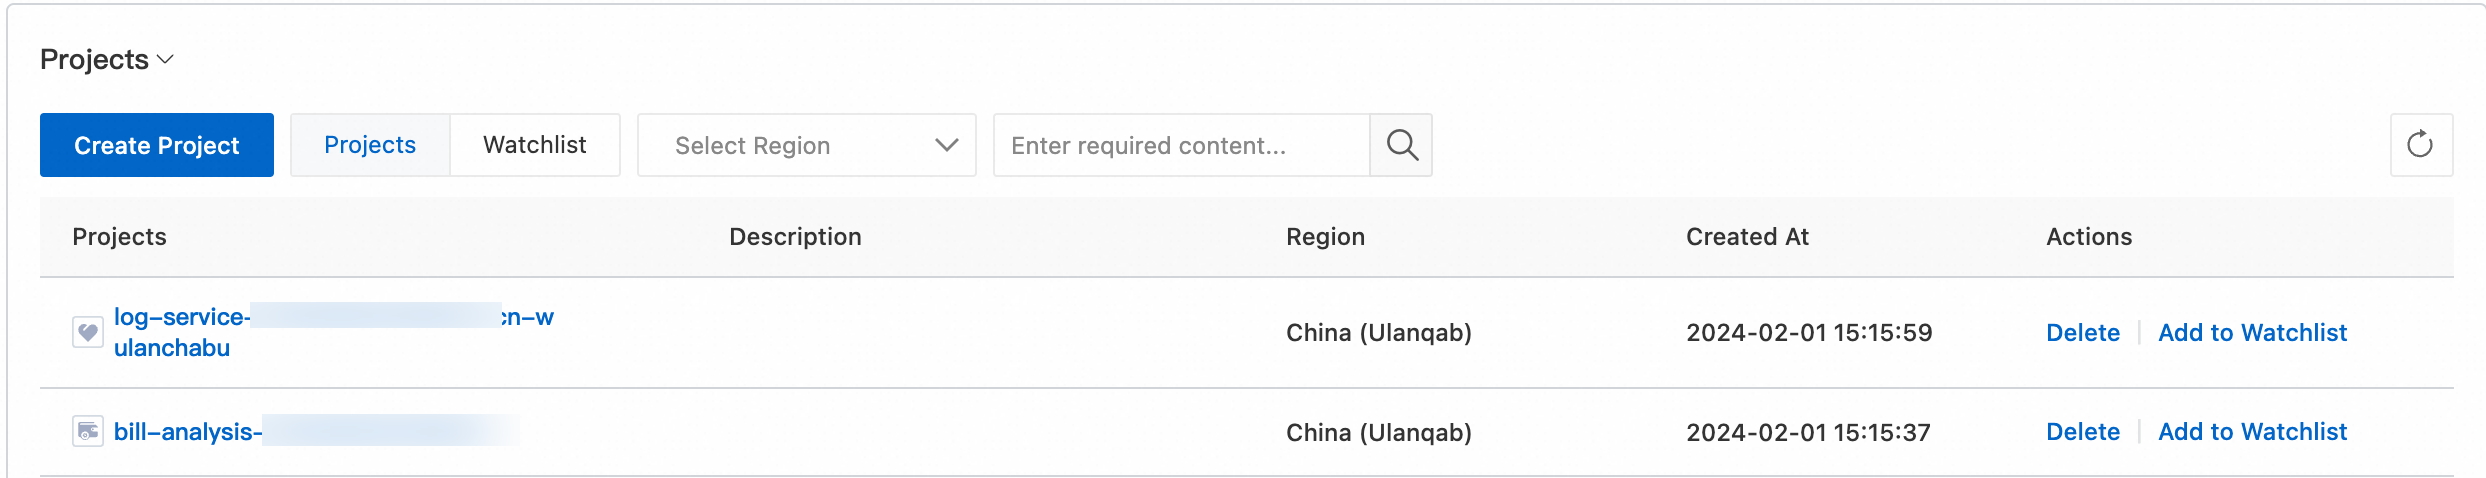
Dans la section Projects, cliquez sur le projet souhaité.
Dans le volet de navigation de gauche, choisissez .
Dans la liste des groupes de machines, cliquez sur le groupe de machines cible.
Cliquez sur Check Status dans la colonne Actions du groupe de machines. Dans la boîte de dialogue View Machine Group Status, consultez l'état du signal de maintien de connexion (heartbeat) et notez le nombre de nœuds dont l'état est OK.
-
Vérifiez le nombre de nœuds de travail dans le cluster de conteneurs.
-
Exécutez la commande suivante pour afficher le nombre de nœuds de travail dans le cluster.
kubectl get node | grep -v masterLe résultat ressemble à ce qui suit :
NAME                                 STATUS    ROLES     AGE       VERSION
cn-hangzhou.i-bp17enxc2us3624wexh2   Ready     <none>    238d      v1.10.4
cn-hangzhou.i-bp1ad2b02jtqd1shi2ut   Ready     <none>    220d      v1.10.4
-
Comparez le nombre de nœuds dont l'état du signal de maintien de connexion (heartbeat) est OK avec le nombre de nœuds de travail dans le cluster de conteneurs. Diagnostiquez le problème en fonction du résultat.
-
L'état du signal de maintien de connexion (heartbeat) de tous les nœuds du groupe de machines est Failed.
Si vous collectez les journaux depuis des conteneurs Docker standard, reportez-vous à la rubrique Collecte de journaux depuis des conteneurs Docker (sortie standard et fichiers) pour vérifier que les paramètres
${your_region_name},${your_aliyun_user_id}et${your_machine_group_user_defined_id}sont corrects.-
Si vous utilisez un cluster Kubernetes géré par vos soins, reportez-vous à la rubrique Collecte de journaux texte depuis des conteneurs Kubernetes à l'aide d'un sidecar pour vérifier que les paramètres
{regionId},{aliuid},{access-key-id}et{access-key-secret}sont corrects.Si les paramètres sont incorrects, exécutez la commande
helm del --purge alibaba-log-controllerpour supprimer le package d'installation, puis réinstallez-le.
-
Le nombre de nœuds dont l'état du signal de maintien de connexion (heartbeat) est OK est inférieur au nombre de nœuds de travail dans le cluster.
-
Vérifiez si un DaemonSet a été déployé manuellement à l'aide d'un fichier YAML.
-
Exécutez la commande suivante. Si un résultat est renvoyé, cela signifie qu'un DaemonSet a été déployé manuellement à l'aide d'un fichier YAML.
kubectl get po -n kube-system -l k8s-app=logtail Définissez les paramètres tels que ${your_region_name}, ${your_aliyun_user_id} et ${your_machine_group_name} avec leurs valeurs réelles.
-
Exécutez la commande suivante pour appliquer le fichier mis à jour.
kubectl apply -f ./logtail-daemonset.yaml
-
-
-
Absence de signal de maintien de connexion (heartbeat) après la réutilisation d'un groupe de sécurité existant par un cluster ACK
Lorsqu'un cluster ACK utilise un groupe de sécurité existant, LoongCollector ou Logtail peut échouer à signaler le signal de maintien de connexion (heartbeat) d'un groupe de machines. Cela se produit lorsque le groupe de sécurité ECS n'autorise pas le trafic entrant depuis le CIDR des Pods. LoongCollector ne peut alors pas accéder à CoreDNS pour résoudre l'endpoint Simple Log Service.
Résolvez le problème comme suit :
Connectez-vous à la console ECS et localisez le groupe de sécurité utilisé par le cluster ACK.
Ajoutez une règle entrante qui autorise tous les protocoles et ports depuis le CIDR des Pods. Par exemple, utilisez
10.229.0.0/16si cette valeur correspond au CIDR des Pods du cluster.Confirmez que les Pods peuvent accéder à CoreDNS et résoudre l'endpoint Simple Log Service.
-
Redémarrez le DaemonSet
loongcollector-dsdans le namespacekube-system:kubectl rollout restart daemonset/loongcollector-ds -n kube-system Vérifiez à nouveau le signal de maintien de connexion (heartbeat) des Machine Groups et confirmez que la collecte des journaux reprend.
FAQ : Pourquoi n'y a-t-il aucun signal de maintien de connexion (heartbeat) après le déploiement de Docker/LoongCollector ?
Si LoongCollector ou Logtail n'affiche aucun signal de maintien de connexion (heartbeat) ou échoue à s'enregistrer auprès du groupe de machines après le déploiement Docker, la cause racine est généralement une configuration manquante de l'identifiant utilisateur (AliUID).
Solution :
-
Sur la machine hôte, créez le répertoire
/etc/ilogtail/users/.mkdir -p /etc/ilogtail/users/ -
Dans le répertoire
/etc/ilogtail/users/, créez un fichier vide nommé avec votre ID de compte Alibaba Cloud.touch /etc/ilogtail/users/<your-alibaba-cloud-account-id> -
Lors du démarrage du conteneur LoongCollector ou Logtail, montez le répertoire en lecture seule en ajoutant l'indicateur suivant :
-v /etc/ilogtail/users:/etc/ilogtail/users:ro Redémarrez le conteneur LoongCollector ou Logtail.
Vérification : connectez-vous à la console SLS, accédez à Resources > Machine Groups, et trouvez le groupe de machines cible. Cliquez sur Check Status dans la colonne Actions. Dans la boîte de dialogue View Machine Group Status, confirmez que l'état du signal de maintien de connexion (heartbeat) du groupe de machines est passé à OK.
FAQ : Pourquoi le groupe de machines n'affiche-t-il qu'un seul serveur lorsque plusieurs serveurs Docker Swarm signalent la même adresse IP ?
Cause : dans un cluster Docker Swarm, plusieurs serveurs peuvent signaler la même adresse IP interne via le réseau de conteneurs. Si ces serveurs partagent également la même valeur de variable d'environnement ALIYUN_LOGTAIL_USER_DEFINED_ID, le système ne peut pas les distinguer et la section Machine Groups n'affiche qu'une seule entrée.
Solution 1 : définissez une variable d'environnement ALIYUN_LOGTAIL_USER_DEFINED_ID unique pour le conteneur Logtail sur chaque serveur.
Définissez une valeur différente sur chaque serveur et assurez-vous que la valeur correspond à la configuration du Machine Groups correspondante. Par exemple :
-e ALIYUN_LOGTAIL_USER_DEFINED_ID=<unique-id-for-this-server>Solution 2 : définissez la variable d'environnement ALIYUN_LOGTAIL_WORKING_IP pour spécifier manuellement une adresse IP unique pour chaque serveur.
Utilisez une valeur qui identifie de manière unique chaque hôte, telle que l'adresse IP publique de l'hôte ou une adresse IP de réseau interne unique sur tous les serveurs :
-e ALIYUN_LOGTAIL_WORKING_IP=<unique-ip-for-this-server>Dépannage de la collecte de journaux de conteneurs
Si vous ne trouvez aucun journal sur la page Preview ou sur la page de requête du Logstore dans la console Simple Log Service, il est possible que Simple Log Service ne collecte pas vos journaux de conteneurs. Vérifiez l'état du conteneur, puis effectuez les contrôles suivants.
-
Lors de la collecte de journaux depuis des fichiers dans des conteneurs, tenez compte des éléments suivants :
Après l'application d'une configuration Logtail, Logtail ne collecte pas les journaux d'un fichier tant que celui-ci n'est pas mis à jour. Pour plus d'informations, reportez-vous à la rubrique Lecture des journaux.
Logtail peut collecter les journaux uniquement depuis des fichiers stockés dans le stockage par défaut du conteneur ou montés sur un chemin local. Les autres méthodes de stockage ne sont pas prises en charge.
Après la collecte des journaux, vous devez créer un index pour les interroger et les analyser dans le Logstore. Pour plus d'informations, reportez-vous à la rubrique Création d'un index.
Vérifiez les problèmes liés au signal de maintien de connexion (heartbeat) du groupe de machines. Pour plus d'informations, reportez-vous à la rubrique Vérification du signal de maintien de connexion (heartbeat) du groupe de machines.
-
Vérifiez si la configuration Logtail est correcte.
Vérifiez si les paramètres IncludeLabel (Label Whitelist), ExcludeLabel (Label Blacklist), IncludeEnv (Environment Variable Whitelist) et ExcludeEnv (Environment Variable Blacklist) dans la configuration Logtail répondent à vos exigences de collecte de journaux.
RemarqueLes libellés spécifiés ici sont des libellés de conteneurs issus de la sortie de la commande
docker inspect, et non des libellés Kubernetes.Vous pouvez temporairement supprimer les paramètres IncludeLabel (Label Whitelist), ExcludeLabel (Label Blacklist), IncludeEnv (Environment Variable Whitelist) et ExcludeEnv (Environment Variable Blacklist) pour vérifier si les journaux peuvent être collectés. Si les journaux sont collectés, cela signifie que les paramètres sont incorrects.
RemarqueSi vous utilisez un nœud Docker géré par vos soins (non-Kubernetes) avec une ancienne configuration Logtail, tenez compte des points suivants :
Le champ
_container_name_ne prend pas en charge la correspondance par expression régulière pour plusieurs valeurs. Vous ne pouvez pas utiliser une seule expression régulière pour filtrer plusieurs noms de conteneurs spécifiques.Si vous devez collecter les journaux depuis plusieurs conteneurs spécifiques (par exemple, des conteneurs nommés
aetb), créez deux configurations Logtail distinctes, chacune avec sa propre liste d'autorisation, et liez-les toutes deux au même Machine Groups.Les noms de libellés en double dans une seule configuration Logtail ne sont pas reconnus. Si vous devez faire correspondre différentes valeurs pour le même nom de libellé, utilisez une expression régulière ou créez plusieurs configurations Logtail indépendantes.
RemarqueLes champs tels que
_image_nameet_container_name_affichés sur la page d'aperçu ou de requête de la console Simple Log Service sont des champs d'aperçu de métadonnées de conteneur, et non des libellés de conteneur. Vous ne pouvez pas les utiliser directement comme valeurs de filtre IncludeLabel (liste d'autorisation) ou ExcludeLabel (liste de blocage). Les valeurs de filtre prennent en charge la correspondance par expression régulière. Pour filtrer en fonction des libellés de conteneur, exécutez la commande suivante sur le nœud où le conteneur s'exécute afin d'obtenir les libellés réels du conteneur :docker inspect <container_id> --format='{{json .Config.Labels}}'Le résultat ressemble à ce qui suit :
{"com.docker.compose.service":"my-svc","maintainer":"..."}Utilisez les paires clé-valeur de libellé réelles présentes dans la sortie, par exemple
com.docker.compose.service=my-svc, comme valeurs IncludeLabel ou ExcludeLabel dans la configuration Logtail.
Dépannage des journaux sidecar Istio manquants
Un journal sidecar Istio peut ne pas être collecté lorsque le fichier journal du conteneur correspondant n'existe plus. La collecte peut également échouer si ContainerFilters ne correspond pas exactement au conteneur sidecar Istio.
Effectuez les vérifications suivantes dans l'ordre :
-
Vérifiez le Deployment ou StatefulSet du Pod et assurez-vous qu'il contient la variable d'environnement correcte pour la configuration Logtail. Par exemple :
aliyun_logs_reconfig-zltx-test-stdout: "stdout" Confirmez que le composant Logtail est installé et en cours d'exécution. Vérifiez que son ConfigMap contient la configuration attendue.
Dans la configuration de collecte, utilisez
ContainerFilterspour configurer une correspondance exacte avec le conteneur sidecar Istio. Vérifiez que le filtre identifie le sidecar plutôt que uniquement le conteneur d'application.Appliquez la charge de travail ou la configuration de collecte corrigée, générez une nouvelle entrée de journal sidecar et vérifiez si Simple Log Service la reçoit.
Le groupe de machines ne couvre pas tous les nœuds de conteneurs
Symptôme : le signal de maintien de connexion (heartbeat) du groupe de machines est normal, mais la collecte des journaux depuis certains conteneurs s'est arrêtée.
Ce problème peut survenir lorsque les conteneurs s'exécutent sur des serveurs qui ne sont pas inclus dans les Machine Groups.
Étapes de dépannage :
-
Sur tous les serveurs concernés, exécutez la commande suivante pour identifier les nœuds sur lesquels les conteneurs s'exécutent réellement :
docker ps -a | grep <container-name> Si un conteneur s'exécute sur un serveur qui n'a pas été ajouté au groupe de machines, ajoutez l'adresse IP de ce serveur aux Machine Groups dans la console SLS.
FAQ : Pourquoi ne puis-je pas trouver le Pod dans l'aperçu des métadonnées du conteneur, ou pourquoi les journaux ne peuvent-ils pas être collectés depuis emptyDir ?
Cause : Logtail, exécuté en mode DaemonSet, ne peut pas accéder directement au stockage temporaire emptyDir à l'intérieur d'un conteneur. Cela empêche Logtail de lire les fichiers journaux et d'extraire les métadonnées du conteneur, de sorte que le Pod ne peut pas être trouvé dans l'aperçu des métadonnées du conteneur Preview.
Solution 1 (recommandée) : redirigez la sortie des journaux de l'application vers la sortie standard (stdout/stderr).
Modifiez votre application pour qu'elle écrive les journaux dans stdout ou stderr au lieu de fichiers.
-
Dans la console SLS, configurez le chemin de collecte pour utiliser le chemin de journal Kubernetes standard :
/logtail_host/var/log/pods/<namespace>_<pod-name>-<uid>/<container-name>/*.log
Solution 2 : si votre application doit écrire les journaux dans des fichiers, modifiez le montage du volume de journaux de emptyDir vers un hostPath ou un PVC.
Dans la spécification de votre Pod, remplacez le volume
emptyDirpar une définitionhostPathou PVC afin que les journaux soient persistés sur un chemin accessible depuis l'hôte.-
Ajustez le chemin de collecte SLS pour pointer vers le chemin de montage réel sur l'hôte, par exemple :
/logtail_host/var/log/your-app/*.log
FAQ : Comment gérer les échecs de création de fichier ou les erreurs d'autorisation lors de la collecte de journaux de conteneurs ?
Symptôme : un message d'erreur indique que Logtail doit créer un fichier vide spécifique à l'intérieur du conteneur, mais la création du fichier échoue ou une erreur d'autorisation est signalée.
Solution :
Créez manuellement le fichier vide spécifié dans le message d'erreur à l'intérieur du conteneur.
-
Définissez les autorisations du fichier sur
-rw-r--r--(644) :chmod 644 <file-path> Redémarrez le conteneur.
Alternative : si le problème persiste après les étapes ci-dessus, montez le répertoire des journaux du conteneur sur la machine hôte et configurez SLS pour collecter les journaux depuis le chemin hôte correspondant. Cette approche est plus stable que la collecte de fichiers à l'intérieur du conteneur.
FAQ : Comment gérer l'erreur « parse cri docker line error: invalid CRI log, timestamp not found » ?
Cause : l'analyse des journaux échoue. Cette erreur est généralement causée par une configuration incorrecte des journaux multilignes.
Solution :
-
Vérifiez et ajustez l'expression régulière de début de ligne, ou désactivez le mode multiligne :
Dans la configuration YAML : commentez la section de configuration
multiline.Dans la console SLS : ouvrez la configuration Logtail et désactivez le mode multiligne.
Vérifiez que le champ K8s Namespace Regex et les autres champs de format sont corrects. Si vous devez spécifier plusieurs namespaces, assurez-vous qu'ils sont séparés par le délimiteur approprié.
-
Après avoir modifié la configuration YAML, réappliquez-la pour prendre en compte les changements :
kubectl apply -f <your-config-file>.yaml
FAQ : Que faire si un point d'exclamation rouge apparaît à côté du plugin d'analyse JSON et que la configuration Logtail ne peut pas être enregistrée ?
Symptôme : après avoir ajouté un plugin d'analyse JSON à une configuration Logtail, un point d'exclamation rouge apparaît à côté de l'icône du plugin et la configuration ne peut pas être enregistrée dans la boîte de dialogue.
Cause : le point d'exclamation rouge indique généralement que le plugin n'est pas configuré ou que la configuration a été modifiée mais non appliquée.
Solution :
Sur la page de modification de la configuration Logtail, supprimez le plugin d'analyse JSON ajouté par défaut.
Ajoutez manuellement à nouveau un plugin d'analyse JSON et renseignez tous les champs requis, tels que l'exemple de journal et les règles d'analyse.
Une fois la configuration terminée, le point d'exclamation rouge disparaît et vous pouvez enregistrer la configuration Logtail.
L'ajout d'un plugin d'analyse temporelle après le plugin d'analyse JSON est une pratique standard. Vous pouvez utiliser le plugin d'analyse temporelle pour extraire le champ horaire du contenu du journal en tant qu'heure du journal.
FAQ : Que faire si aucune donnée n'est collectée car plusieurs configurations Logtail correspondent au même fichier (MULTI CONFIG MATCH ALARM) ?
Symptôme : l'alerte MULTI CONFIG MATCH ALARM apparaît dans les journaux opérationnels de Logtail et aucune donnée n'est collectée depuis le fichier cible.
Cause : par défaut, un fichier journal ne peut correspondre qu'à une seule configuration Logtail. Lorsque plusieurs configurations Logtail correspondent au même fichier, une seule d'entre elles prend effet. Les autres configurations ne peuvent pas collecter de données et déclenchent l'alerte MULTI CONFIG MATCH ALARM.
Solution :
Supprimez les configurations Logtail redondantes : dans la console Simple Log Service, vérifiez toutes les configurations Logtail liées aux Machine Groups. Supprimez les configurations dupliquées ou inutilisées afin que chaque fichier ne corresponde qu'à une seule configuration.
Séparez la correspondance par nom de pod : si vous avez besoin de plusieurs configurations pour le même fichier, par exemple pour séparer la collecte par nom de pod, modifiez les configurations comme décrit dans la documentation officielle. Assurez-vous que chaque configuration Logtail ne correspond qu'à son propre fichier cible grâce à un chemin ou un filtre de libellé plus précis, et évitez les chevauchements de chemins.
Après la modification, vérifiez les journaux opérationnels de Logtail et confirmez que l'alerte MULTI CONFIG MATCH ALARM a disparu et que les données sont collectées comme prévu.
FAQ : Comment gérer l'erreur Logtail no such file or directory lors de la collecte de journaux de conteneurs ?
Symptôme : les journaux opérationnels de Logtail contiennent l'erreur no such file or directory et les journaux du conteneur cible ne peuvent pas être collectés. Assurez-vous qu'un index est créé pour le LogStore afin que les journaux puissent être interrogés et analysés après la collecte.
Cause : le chemin de collecte cible n'existe pas sur le nœud. Ce problème est généralement lié au cycle de vie des pods Kubernetes ou au mécanisme de rotation des journaux.
Solution :
Vérifiez si le pod existe toujours : si le pod a été supprimé, le chemin de journal correspondant n'existe plus et vous pouvez ignorer l'erreur. Si le pod est toujours en cours d'exécution, connectez-vous au serveur (nœud) et vérifiez si le chemin de journal réel existe.
Utilisez la collecte stdout du conteneur lorsque cela est possible : lors de la création d'une configuration de collecte de journaux dans la console ACK, sélectionnez le type Container Stdout et faites correspondre le conteneur cible par libellé de conteneur ou nom de conteneur, au lieu de vous fier au chemin de fichier interne au conteneur.
Suggestions de configuration lorsque la collecte de fichiers est requise : utilisez un chemin avec caractère générique, par exemple
/logtail_host/var/log/pods/*/*.log, et activez la découverte automatique des nouveaux fichiers dans la configuration Logtail afin que Logtail puisse suivre les nouveaux chemins après la rotation des journaux ou la recréation des pods.Vérifiez que la configuration Logtail est appliquée au groupe de machines : assurez-vous que la configuration Logtail est liée aux Machine Groups qui contiennent le pod cible.
Vérifiez les journaux opérationnels de Logtail : si un grand nombre d'erreurs sont concentrées sur des pods déjà détruits, vous pouvez les ignorer. Si les erreurs persistent et que le pod est toujours en cours d'exécution, corrigez le chemin de collecte ou vérifiez le montage du nœud.
FAQ : Comment gérer l'interruption de la collecte causée par Logtail ignorant les fichiers en raison de logfiletoobig ?
Symptôme : l'alerte logfiletoobig apparaît dans les journaux opérationnels de Logtail, le fichier cible est ignoré et la collecte des journaux est interrompue.
Cause : la taille du fichier journal cible dépasse la limite par défaut de Logtail. Logtail ignore le fichier pour protéger sa stabilité.
Solution :
-
Ajustez les paramètres de collecte de Logtail : dans la configuration Logtail ou dans les paramètres globaux des Machine Groups, apportez les modifications suivantes :
Augmentez
MaxLogFileSize, par exemple à1GB, pour éviter que les fichiers volumineux ne soient ignorés.Augmentez
MaxLogFileInodeCacheSize, par exemple à2000, pour améliorer le suivi des fichiers après rotation.Définissez
EnableContainerDiscoverysurtrueafin que Logtail puisse découvrir automatiquement les chemins de journaux des conteneurs et créer automatiquement des entrées de suivi pour les nouveaux pods.
-
Déclenchez une nouvelle analyse : dans le cluster ACK, exécutez la commande suivante pour supprimer le pod loongcollector-ds (ou Logtail-ds). Le DaemonSet recrée automatiquement le pod et réanalyse tous les chemins de journaux des conteneurs :
kubectl delete pod -n kube-system -l k8s-app=loongcollector-ds Vérifiez le résultat ou utilisez une alternative : vérifiez l'état de réception des journaux dans la console Simple Log Service et examinez si des erreurs résiduelles subsistent dans le pod Logtail. Si les méthodes précédentes ne fonctionnent pas, essayez la configuration K8s-Stdout-New et activez l'aperçu des métadonnées du conteneur pour collecter les journaux via le chemin stdout au lieu du chemin de fichier.
Dépannage complémentaire pour ACK
Dans un cluster ACK, si la collecte des journaux ne renvoie toujours aucune donnée après les vérifications précédentes, examinez les deux points suivants :
-
Vérifiez la configuration de collecte CRD d'ACK : exécutez la commande suivante pour afficher les configurations de collecte CRD du cluster ACK :
kubectl get ClusterAliyunPipelineConfig -AVérifiez que le LogStore et les règles de collecte dans la sortie correspondent à vos attentes.
-
Vérifiez la déclaration de volume de l'image du conteneur : exécutez la commande
docker inspectsur l'image du conteneur et vérifiez le champConfig.Volumes:docker inspect <image-name> | grep -A5 VolumesSi
Config.Volumesn'est pas vide, l'image déclare unVOLUMEqui peut écraser le chemin du fichier journal. Supprimez la déclarationVOLUMEou montez le volume suremptyDir.
Autres opérations de maintenance
Connexion à un conteneur Logtail
-
Docker standard
-
Sur l'hôte, exécutez la commande suivante pour trouver le conteneur Logtail.
docker ps | grep logtailLe résultat ressemble à ce qui suit :
223****6e registry.cn-hangzhou.aliyuncs.com/log-service/logtail "/usr/local/ilogta..." 8 days ago Up 8 days logtail-iba -
Exécutez la commande suivante pour démarrer un shell bash dans le conteneur Logtail.
docker exec -it 223****6e bashRemplacez
223****6epar l'ID réel du conteneur.
-
-
Kubernetes
-
Exécutez la commande suivante pour trouver le pod Logtail.
kubectl get po -n kube-system | grep logtailLe résultat ressemble à ce qui suit :
logtail-ds-****d 1/1 Running 0 8d logtail-ds-****8 1/1 Running 0 8d -
Exécutez la commande suivante pour vous connecter au pod.
kubectl exec -it -n kube-system logtail-ds-****d -- bashRemplacez
logtail-ds-****dpar l'ID réel du pod.
-
Affichage des journaux d'exécution de Logtail
Logtail stocke ses journaux dans le répertoire /usr/local/ilogtail/ du conteneur Logtail. Les fichiers journaux sont ilogtail.LOG et logtail_plugin.LOG.
Connectez-vous au conteneur Logtail. Pour plus d'informations, reportez-vous à la rubrique Connexion à un conteneur Logtail.
-
Accédez au répertoire /usr/local/ilogtail/.
cd /usr/local/ilogtail -
Consultez les fichiers ilogtail.LOG et logtail_plugin.LOG.
cat ilogtail.LOG
cat logtail_plugin.LOG
Sortie standard (stdout) du conteneur Logtail
La sortie standard d'un conteneur Logtail ne fournit pas d'informations utiles pour le dépannage. Vous pouvez ignorer le contenu suivant.
start umount useless mount points, /shm$|/merged$|/mqueue$
umount: /logtail_host/var/lib/docker/overlay2/3fd0043af174cb0273c3c7869500fbe2bdb95d13b1e110172ef57fe840c82155/merged: must be superuser to unmount
umount: /logtail_host/var/lib/docker/overlay2/d5b10aa19399992755de1f85d25009528daa749c1bf8c16edff44beab6e69718/merged: must be superuser to unmount
umount: /logtail_host/var/lib/docker/overlay2/5c3125daddacedec29df72ad0c52fac800cd56c6e880dc4e8a640b1e16c22dbe/merged: must be superuser to unmount
......
xargs: umount: exited with status 255; aborting
umount done
start logtail
ilogtail is running
logtail status:
ilogtail is running
Vérification de l'état des composants Kubernetes
Exécutez la commande suivante pour afficher l'état et les informations du déploiement Simple Log Service.
kubectl get deploy -n kube-system | grep -E 'alibaba-log-controller|loongcollector-operator'La sortie suivante est renvoyée :
NAME                     READY   UP-TO-DATE   AVAILABLE   AGE
alibaba-log-controller   1/1     1            1           11d
Exécutez la commande suivante pour afficher les informations d'état de la ressource DaemonSet.
kubectl get ds -n kube-system | grep -E 'logtail-ds|loongcollector-ds'La sortie suivante est renvoyée :
NAME         DESIRED   CURRENT   READY   UP-TO-DATE   AVAILABLE   NODE SELECTOR  AGE
logtail-ds   2         2         2       2            2           **ux           11d
Version de Logtail, adresse IP et heure de démarrage
-
Sur l'hôte, exécutez la commande suivante pour afficher la version, l'adresse IP et l'heure de démarrage de Logtail.
Les informations sont stockées dans le fichier
/usr/local/ilogtail/app_info.jsondu conteneur Logtail.kubectl exec logtail-ds-****k -n kube-system cat /usr/local/ilogtail/app_info.jsonLe résultat ressemble à ce qui suit :
{
   "UUID" : "",
   "hostname" : "logtail-****k",
   "instance_id" : "0EB****_172.20.4.2_1517810940",
   "ip" : "172.20.4.2",
   "logtail_version" : "0.16.2",
   "os" : "Linux; 3.10.0-693.2.2.el7.x86_64; #1 SMP Tue Sep 12 22:26:13 UTC 2017; x86_64",
   "update_time" : "2018-02-05 06:09:01"
}
Obtention d'informations de dépannage pour les journaux de Pod dans un cluster ACK
Si la collecte des journaux pour un Pod dans un cluster ACK est anormale, vous pouvez utiliser les étapes suivantes pour obtenir les informations de base nécessaires à l'auto-dépannage ou pour les fournir au support technique.
Étape 1 : trouvez le nom du pod Logtail ou LoongCollector.
kubectl get pods -n kube-system | grep loongcollectorÉtape 2 : obtenez l'adresse IP de l'instance Logtail ou LoongCollector à partir du fichier app_info.json.
kubectl exec <pod-name> -n kube-system cat /usr/local/ilogtail/app_info.jsonLe champ ip dans la sortie JSON renvoyée correspond à l'adresse IP de l'instance Logtail.
Lorsque vous sollicitez le support, fournissez les informations suivantes pour faciliter le dépannage :
Nom du projet SLS
Nom de la configuration de collecte Logtail
Nom du Pod cible
Nom du conteneur cible
Gestion des Logstores CRD supprimés accidentellement
Si vous supprimez un Logstore créé automatiquement par une Custom Resource Definition (CRD), les données collectées sont irrécupérables et la configuration CRD pour le Logstore devient invalide. Pour éviter des problèmes de collecte de journaux, choisissez l'une des solutions suivantes :
Dans la configuration CRD, utilisez un Logstore différent de celui que vous avez supprimé.
-
Redémarrez le pod alibaba-log-controller.
Exécutez la commande suivante pour trouver le pod.
kubectl get po -n kube-system | grep alibaba-log-controller
FAQ
FAQ : L'exécution de docker pull pour télécharger l'image LoongCollector ou Logtail affecte-t-elle les autres services sur l'hôte ?
Conclusion : l'exécution de la seule commande docker pull pour télécharger l'image LoongCollector ou Logtail n'affecte pas les autres services exécutés sur l'hôte. Cela s'applique aux instances ECS Alibaba Cloud ainsi qu'aux serveurs sur site. La commande docker pull télécharge uniquement les couches d'image dans le référentiel d'images local. Elle ne démarre pas de conteneur ni ne consomme de ressources CPU ou mémoire supplémentaires.
Précautions :
Lorsque vous exécutez ultérieurement
docker runpour démarrer un conteneur, assurez-vous que l'hôte dispose de suffisamment de ressources CPU et mémoire afin que le nouveau conteneur n'entre pas en concurrence avec les charges de travail existantes.Vérifiez si le mappage de port du conteneur entre en conflit avec les ports déjà utilisés par les services existants sur l'hôte.
Si vous souhaitez exécuter le composant de collecte de journaux dans Kubernetes sur le long terme, installez LoongCollector en mode DaemonSet via Component Management dans la console ACK (recommandé). Cela permet au cluster de planifier les ressources de manière unifiée.
FAQ : Que faire si l'option K8s-Stdout-New est absente de la page d'accès aux journaux du cluster ACK dans la console Simple Log Service ?
Symptôme : l'entrée K8s-Stdout-New est absente de la page d'accès aux journaux du cluster ACK dans la console Simple Log Service.
Cause : l'entrée peut être temporairement indisponible car la fonctionnalité backend est retirée pour réparation.
Solutions / Alternatives :
Utilisez temporairement la méthode d'accès héritée : dans la console, sélectionnez l'entrée héritée K8s-Stdout pour terminer l'accès. La version héritée a atteint sa fin de maintenance et ne doit être utilisée que comme solution de contournement temporaire.
-
Utilisez une CRD au lieu de l'entrée de la console (recommandé) : utilisez
kubectldans le cluster pour créer une CRDAliyunPipelineConfigafin de configurer la collecte stdout de la nouvelle version, sans dépendre de l'entrée de la console. Reportez-vous à l'exemple YAML dans la section Container Stdout - New Version de ce document, remplacez les paramètres par votre projet, LogStore et informations de cluster réels, puis exécutez la commande suivante :kubectl apply -f aliyun-pipeline-config.yamlCette méthode équivaut à la configuration créée via la console et est plus facile à gérer selon une approche GitOps.
FAQ : Un Pod qui n'est pas en état Running affecte-t-il la collecte de journaux de fichiers ?
Conclusion : oui. LoongCollector et Logtail collectent les fichiers depuis l'intérieur du conteneur. Si le service ne parvient pas à démarrer et que le Pod n'est pas en état Running, le conteneur peut ne pas créer le fichier journal ou son répertoire. Le collecteur ne peut pas lire ni collecter un fichier depuis un chemin qui n'existe pas.
Pour vérifier la collecte de journaux de fichiers, définissez temporairement la commande de démarrage du service pour maintenir le conteneur en cours d'exécution. Par exemple :
sleep 3600Une fois que le Pod est en état Running, écrivez manuellement une entrée de journal de test dans le chemin de fichier configuré. Vérifiez ensuite si LoongCollector ou Logtail collecte la nouvelle entrée. Restaurez la commande de démarrage d'origine après le test.
FAQ : Pourquoi ne puis-je pas interroger les journaux stdout des conteneurs par nom de méthode ou par un autre champ métier ?
Simple Log Service peut interroger des champs uniquement s'ils existent dans le journal collecté et si un index a été créé pour eux. Si le stdout du conteneur ou le journal de l'application ne contient pas de nom de méthode, d'informations sur l'appelant ou un autre champ métier, vous ne pouvez pas interroger ce champ directement dans Simple Log Service.
Vérifiez la configuration de journalisation dans votre application ou passerelle, telle que NGINX ou Spring Cloud Gateway. Assurez-vous que chaque champ métier requis est écrit dans stdout ou dans le fichier journal collecté.
Un champ de contenu de journal fait partie du texte émis par l'application ou la passerelle. Un tag de métadonnées est attaché lors de la collecte pour enrichir le contexte du journal. L'enrichissement des tags ne crée pas de nom de méthode ou de champ d'appelant manquant dans le contenu original du journal.