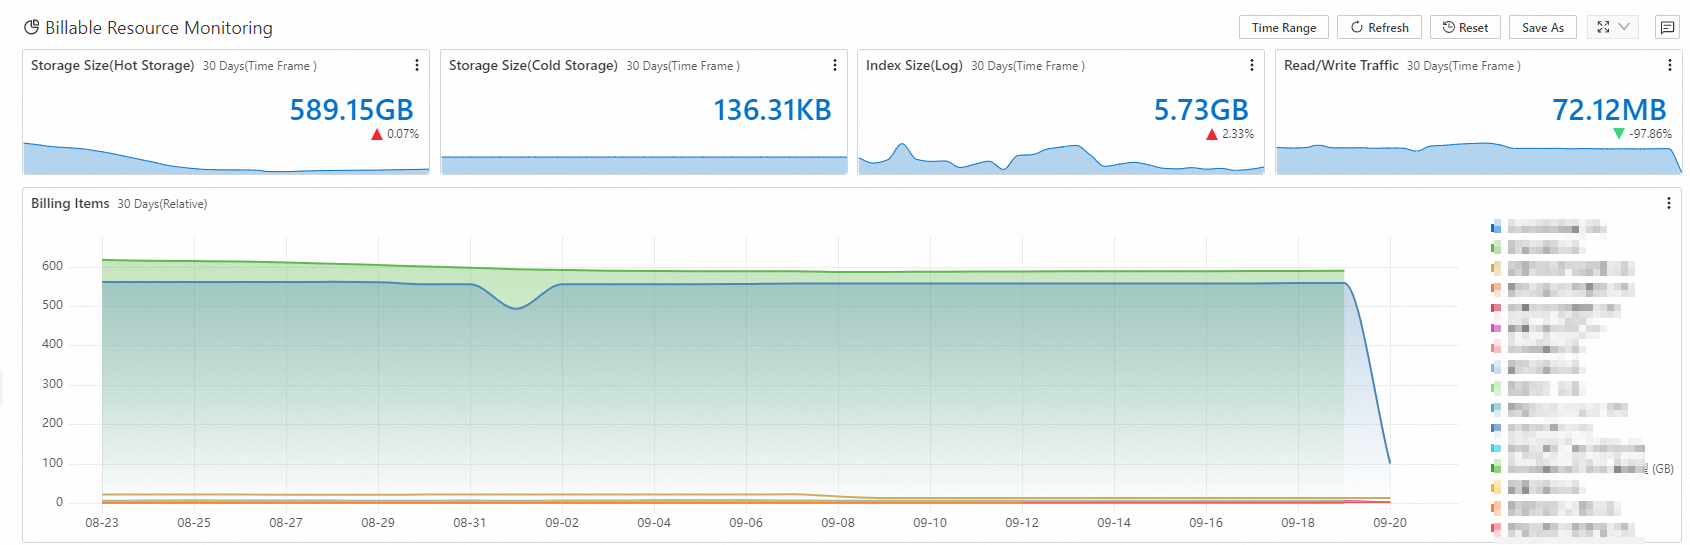
CloudLens for SLS met à votre disposition des tableaux de bord prêts à l’emploi pour analyser et surveiller l’utilisation de Simple Log Service.
Prérequis
Activez la collecte de journaux pour les journaux importants, les journaux détaillés, les journaux d’exécution des tâches, les journaux d’audit, les journaux de facturation, les journaux d’erreur et les métriques du projet cible. Pour plus d’informations, consultez la rubrique Activer la fonctionnalité de collecte de journaux.
Procédure
Connectez-vous à la console Simple Log Service.
Dans la section Log Application, sous l’onglet Cloud Service Lens, cliquez sur CloudLens for SLS.
Dans le volet de navigation de gauche, sous Report Center, cliquez sur le rapport souhaité.
Dans le coin supérieur gauche de la page, sélectionnez le projet cible.
Aperçu
Le tableau de bord Overview affiche des informations relatives à votre projet Simple Log Service, notamment des graphiques présentant le nombre de requêtes en lecture/écriture, les taux de réussite des requêtes en lecture/écriture, le nombre de requêtes 4xx, le nombre de requêtes 5xx, le trafic d’écriture (taille brute), le trafic d’écriture (compressé), le taux de compression du trafic d’écriture et le trafic de lecture.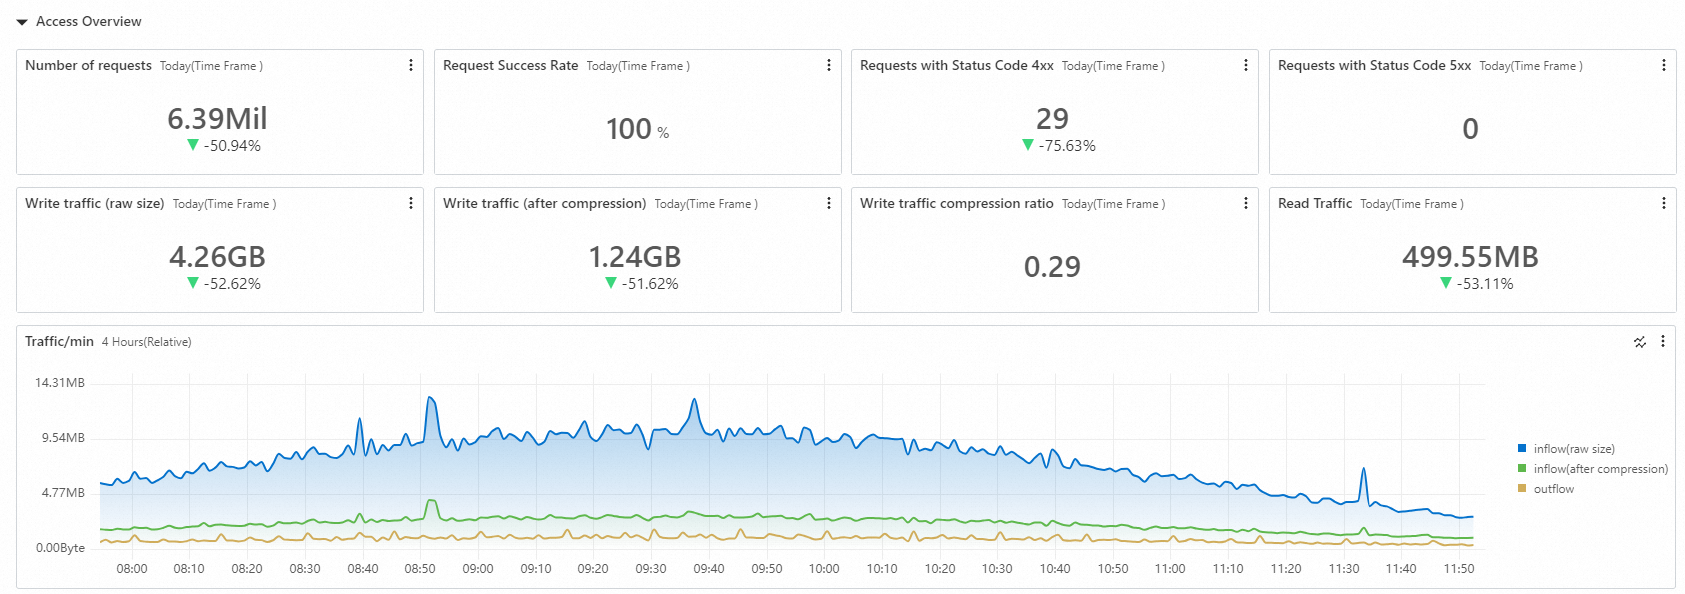
Surveillance du trafic d’accès
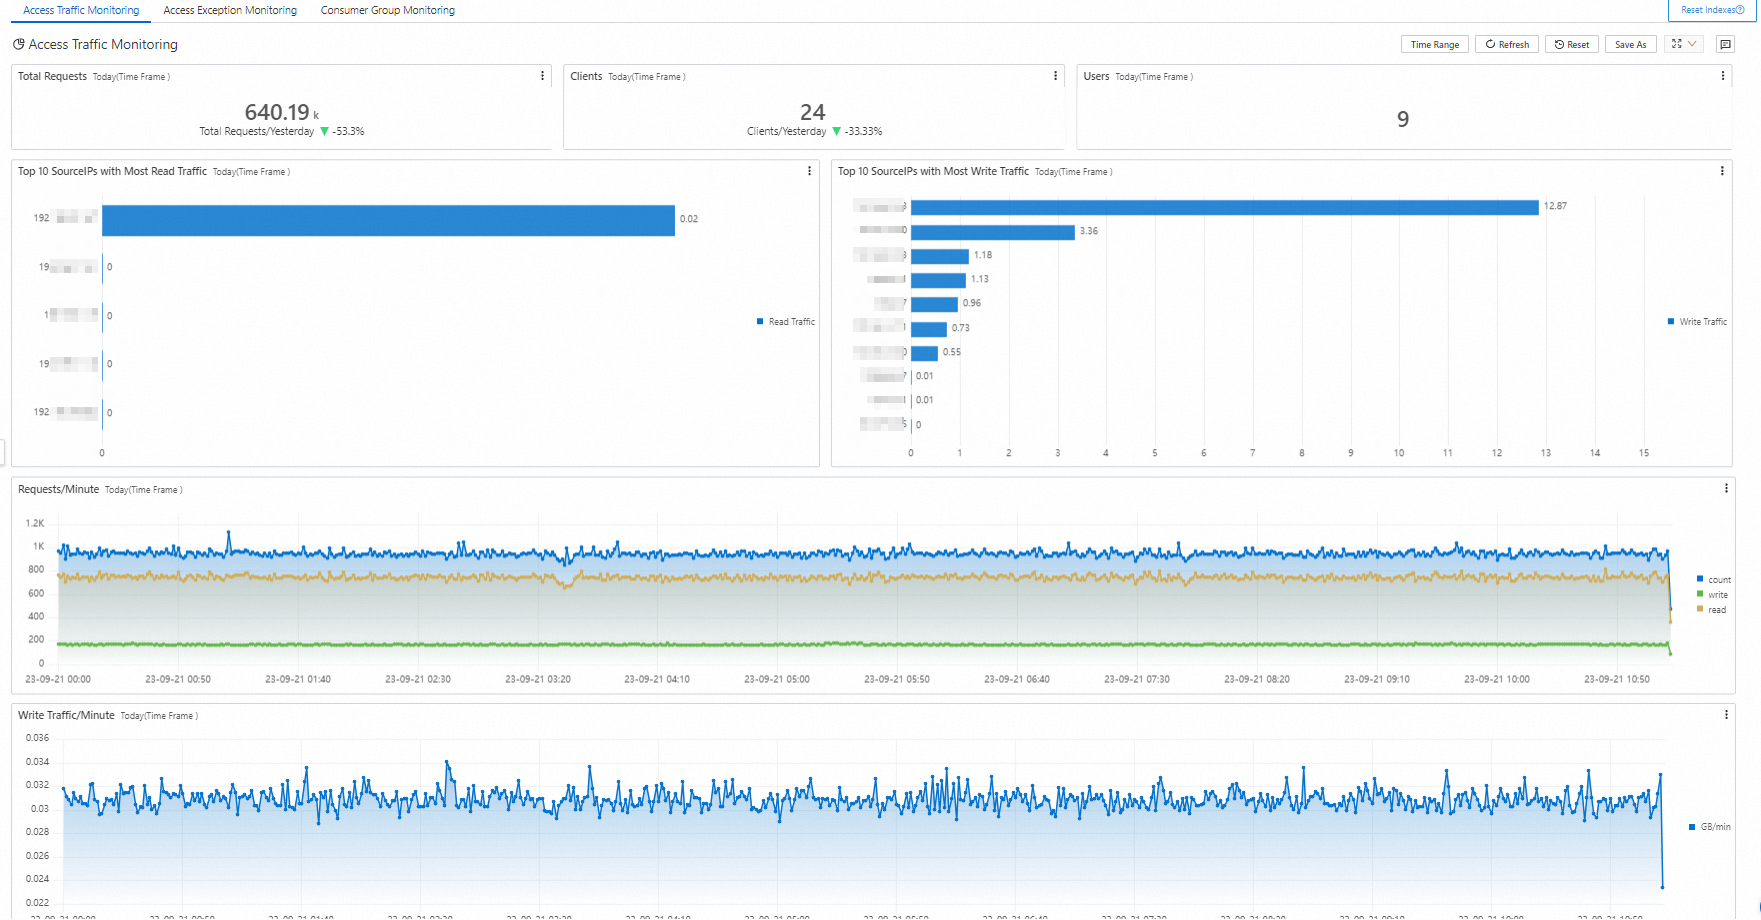
Le tableau de bord Access Traffic Monitoring présente l’activité d’accès dans Simple Log Service. Il comprend des graphiques indiquant le total des requêtes du jour, le nombre de clients, le nombre total d’utilisateurs du jour, les 10 adresses IP source les plus consommatrices de trafic de lecture, les 10 adresses IP source les plus consommatrices de trafic d’écriture, le nombre de requêtes, le trafic d’écriture, les tendances du trafic d’écriture par shard, les tendances du trafic de consommation par shard, les variations du trafic de lecture/écriture par minute et la répartition des sources d’accès.
Surveillance des exceptions d’accès
Le tableau de bord Access Exception Monitoring affiche les informations relatives aux accès anormaux dans Simple Log Service. Cela inclut des graphiques présentant le total des requêtes du jour, le ratio de requêtes ayant échoué, les erreurs de limitation de débit, la répartition des statuts d’erreur des requêtes, les Logstores dépassant les limites d’écriture, le nombre d’exceptions de requête et les tendances de la latence de traitement des requêtes.
Surveillance des groupes de consommateurs
Le tableau de bord Consumer Group Monitoring fournit des informations sur les groupes de consommateurs. Il comprend des graphiques indiquant le nombre de groupes de consommateurs, le nombre de Logstores consommés, le nombre de shards consommés, le retard de consommation, le pourcentage de données par groupe de consommateurs, la liste des groupes de consommateurs, les 10 groupes de consommateurs avec le plus grand retard de consommation et la durée du retard de consommation.
État global de Logtail
Le tableau de bord Logtail Overall Status affiche des informations concernant Logtail. Il comprend des graphiques présentant le nombre d’agents Logtail actifs, le trafic de données brutes, la répartition des statuts d’exécution, la répartition de l’utilisation de la mémoire, l’état global de Logtail, les tendances du CPU, les tendances de la mémoire et le trafic de données envoyées.
Surveillance de la collecte de fichiers par Logtail
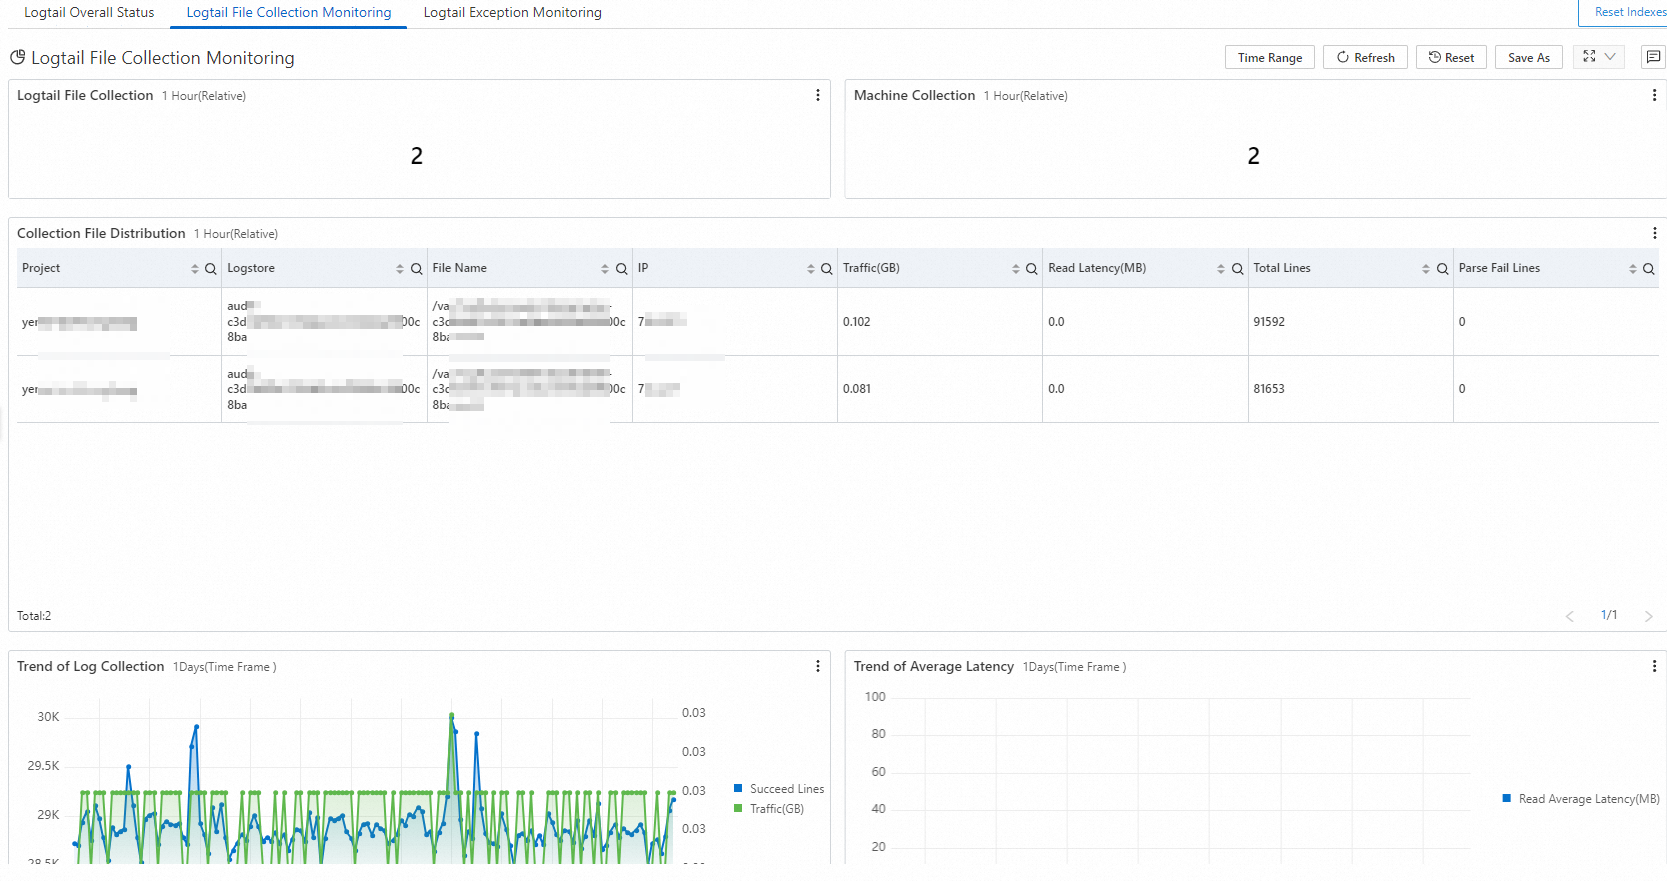
Le tableau de bord Logtail File Collection Monitoring affiche des informations sur les fichiers à collecter. Il comprend des graphiques indiquant le nombre de fichiers à collecter, le nombre de machines de collecte, la répartition des fichiers collectés, le volume de journaux collectés, la latence moyenne de collecte, le taux d’échec d’analyse et les tendances du nombre d’envois.
Surveillance des exceptions Logtail
Le tableau de bord Logtail Exception Monitoring affiche les informations relatives aux exceptions Logtail. Il comprend des graphiques présentant le nombre d’agents Logtail actifs, une liste des agents Logtail redémarrés, le nombre de clients redémarrés et les informations d’erreur complètes.
La section des informations d’erreur complètes inclut des catégories telles que Critical errors (must be handled), Logtail write exceptions (must be handled), Duplicate log file configuration issues (MULTI_CONFIG_MATCH_ALARM), Directory count exceeding limit issues (STAT_LIMIT_ALARM, DIR_EXCEED_LIMIT_ALARM) et Logtail configuration exceptions (CATEGORY_CONFIG_ALARM). Un tableau dans chaque catégorie affiche l’heure de la dernière occurrence, l’adresse IP, le type d’alarme, le nombre d’alarmes et les détails de l’alarme.
Surveillance des opérations
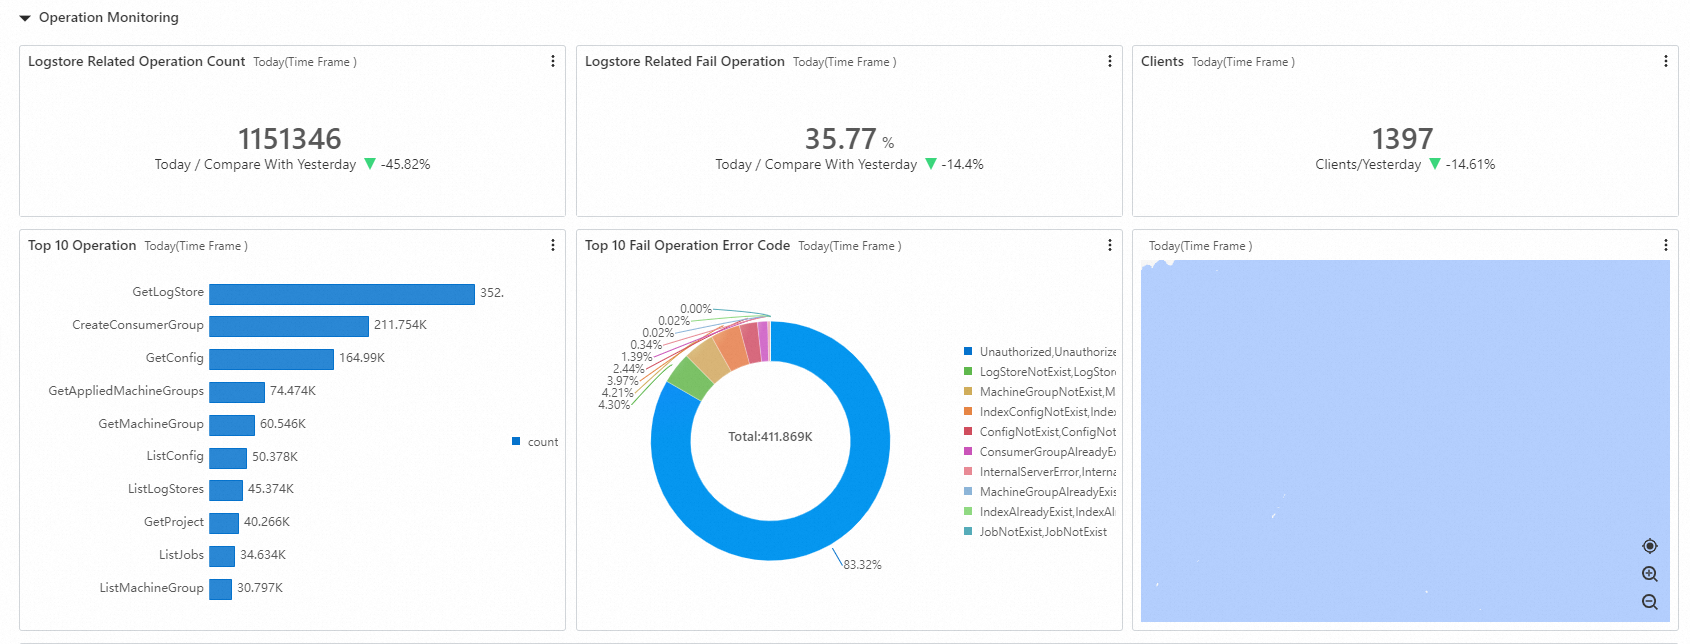
Le tableau de bord Operation Monitoring affiche les enregistrements d’opérations pour Simple Log Service. Il comprend des graphiques indiquant le nombre total d’opérations sur les Logstores, le taux d’échec des opérations sur les Logstores et le nombre de clients effectuant des opérations.
Surveillance des tâches
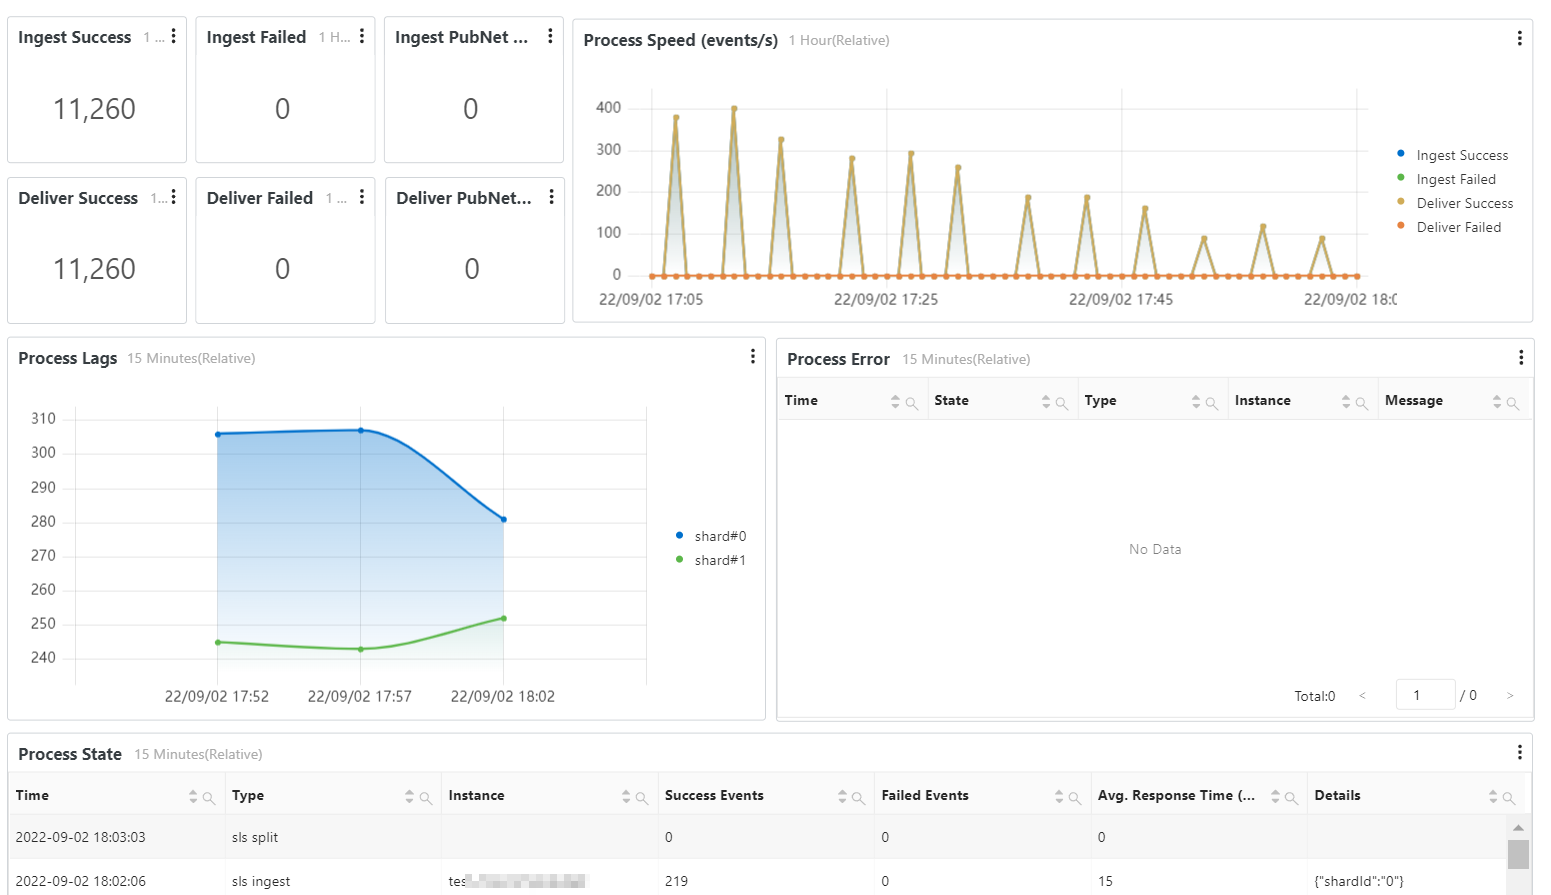
Le tableau de bord Job Monitoring affiche l’état d’exécution des tâches d’importation de données (nouvelles), des tâches d’expédition de données (nouvelles) ou des tâches Scheduled SQL. Il comprend des graphiques indiquant le nombre de lectures réussies, le nombre de lectures ayant échoué, le nombre d’écritures réussies, le nombre d’écritures ayant échoué, le trafic de lecture sur le réseau public, le trafic d’écriture sur le réseau public, le taux de traitement, le retard de traitement et les exceptions d’exécution.
Surveillance des quotas
Le tableau de bord Quota Monitoring affiche des informations sur les dépassements de quota de ressources. Il comprend des graphiques présentant l’aperçu des alertes au seuil de 80 % pour les quotas de ressources, la répartition des dépassements de quota, la répartition des pourcentages de seuil par Logstore, la répartition des pourcentages de seuil par groupe de machines, la répartition des pourcentages de seuil par configuration Logtail, la répartition des pourcentages de seuil pour le trafic d’écriture du projet, les détails du quota de ressources de base du projet, les détails du quota de ressources de lecture/écriture de données du projet et les détails des dépassements de ressources du projet.
Surveillance de la qualité SQL
Le tableau de bord SQL Quality Monitoring propose une analyse multidimensionnelle de vos requêtes SQL. Il comprend un aperçu, des métriques de service SQL, une analyse des modèles SQL (SQL Pattern) et des suggestions d’optimisation pour vous aider à surveiller et optimiser les requêtes SQL et améliorer l’efficacité de l’analyse.
Le rapport peut inclure les cinq sections suivantes :
Aperçu
Métriques de service SQL
Métriques détaillées d’exécution
Analyse des modèles SQL
Optimisation et suggestions
Aperçu
Cette section affiche le score de santé SQL, le rapport d’utilisation SQL et les performances globales SQL pour vous aider à évaluer rapidement l’état général de vos requêtes SQL.
En haut de la page, filtrez les résultats à l’aide des listes déroulantes ParentAccount, Project et Logstore. Le SQL Health Score s’affiche en gros caractères. Le SQL Usage Report détaille l’utilisation de l’analyse SQL, y compris le nombre de projets et de Logstores participants ainsi que le nombre total de requêtes. Il met également en évidence les ressources les plus fréquemment utilisées, les principaux UserAgents, le taux de réussite des requêtes et les principaux types d’erreurs avec des suggestions d’optimisation. La section SQL Overall Performance comprend des métriques telles que la latence moyenne, la latence P50, la latence P95, le volume moyen de données traitées, le nombre moyen de lignes traitées, le nombre moyen de lignes renvoyées et la concurrence moyenne estimée.
Score de santé SQL
Formule du score de santé : (1 - Query failure rate) * 100.
Métriques de service SQL
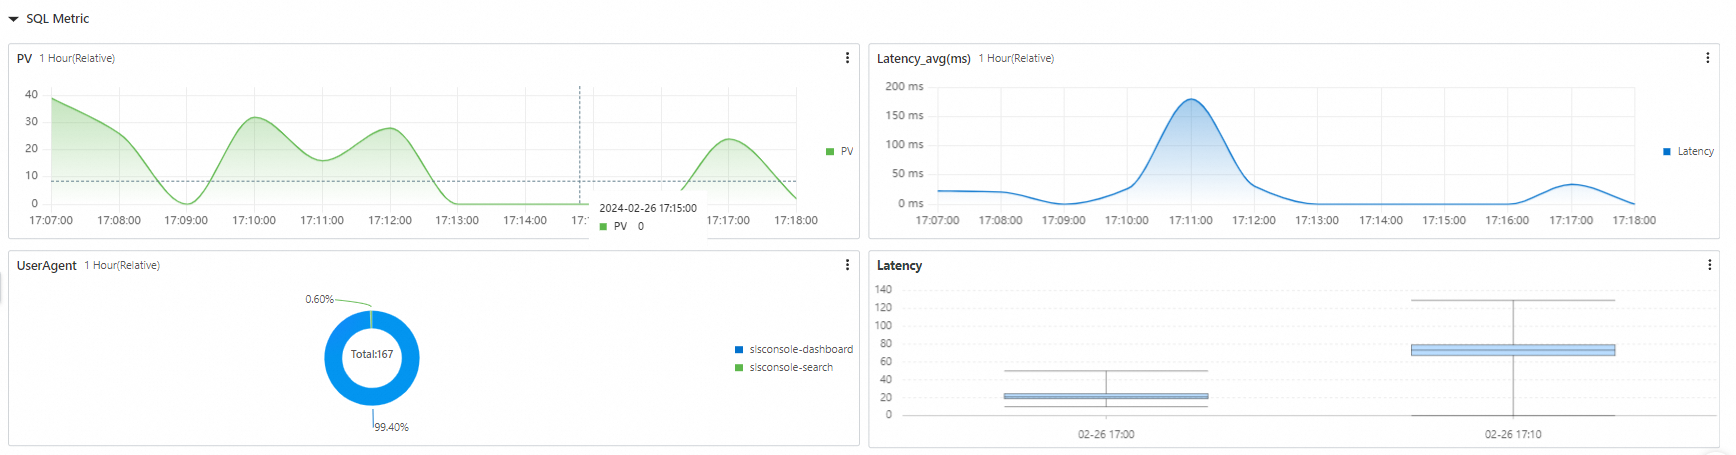
Cette section décrit les métriques de service globales pour l’utilisation SQL, notamment le nombre de requêtes par minute (PV), la latence moyenne, la répartition des User-Agent et la répartition de la latence.
Métriques d’exécution SQL
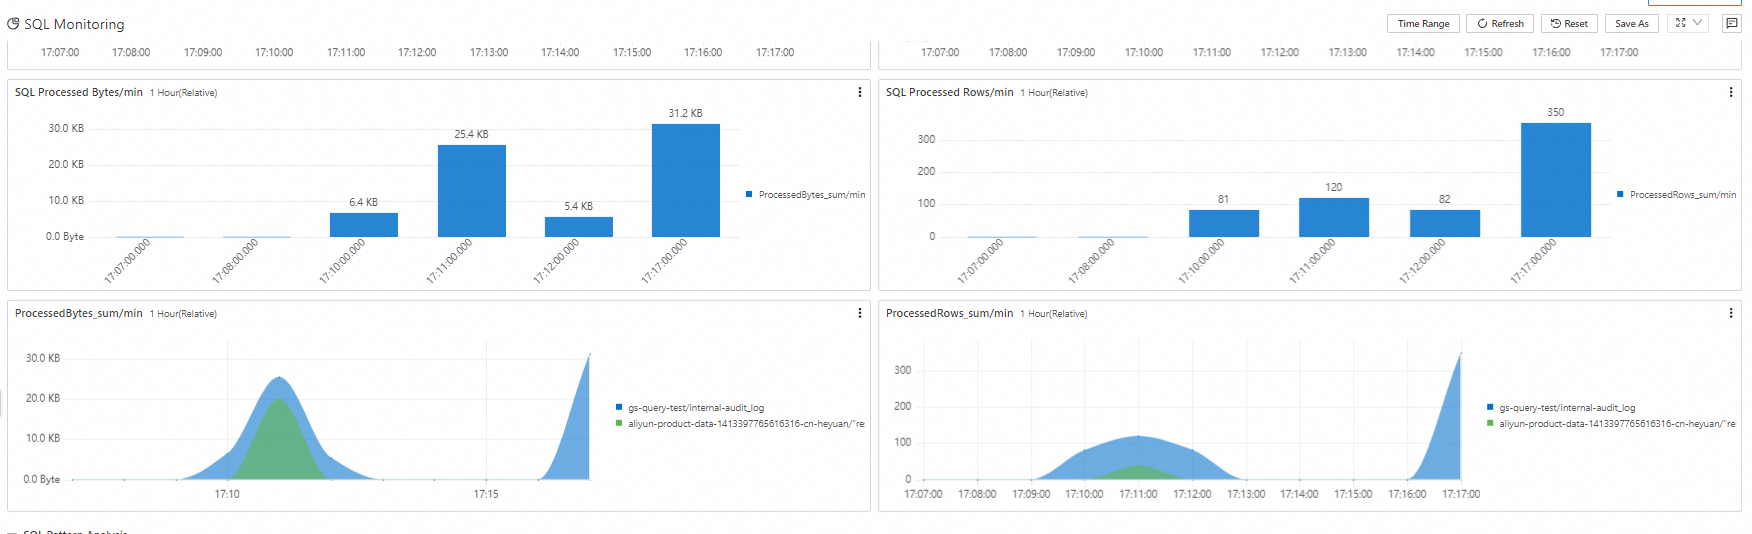
Cette section décrit les métriques principales de l’exécution interne SQL, notamment le volume de requêtes simultanées, la latence à chaque étape, le volume de données traitées par SQL par minute et le nombre de lignes traitées par SQL par minute.
Analyse des modèles SQL
Cette section traite les requêtes SQL à l’aide de modèles et les agrège en modèles SQL (SQL Patterns). Cela vous aide à identifier les caractéristiques SQL, les modèles SQL les plus exécutés et les modèles SQL les plus gourmands en ressources.
La page d’analyse des modèles SQL affiche un tableau avec des métriques pour chaque modèle SQL, y compris le project correspondant, le Logstore, le pourcentage de requêtes, la latence moyenne, le volume moyen de données traitées et le nombre moyen de lignes traitées. Vous pouvez trier selon ces métriques pour identifier les principaux modèles SQL.
Optimisation et suggestions
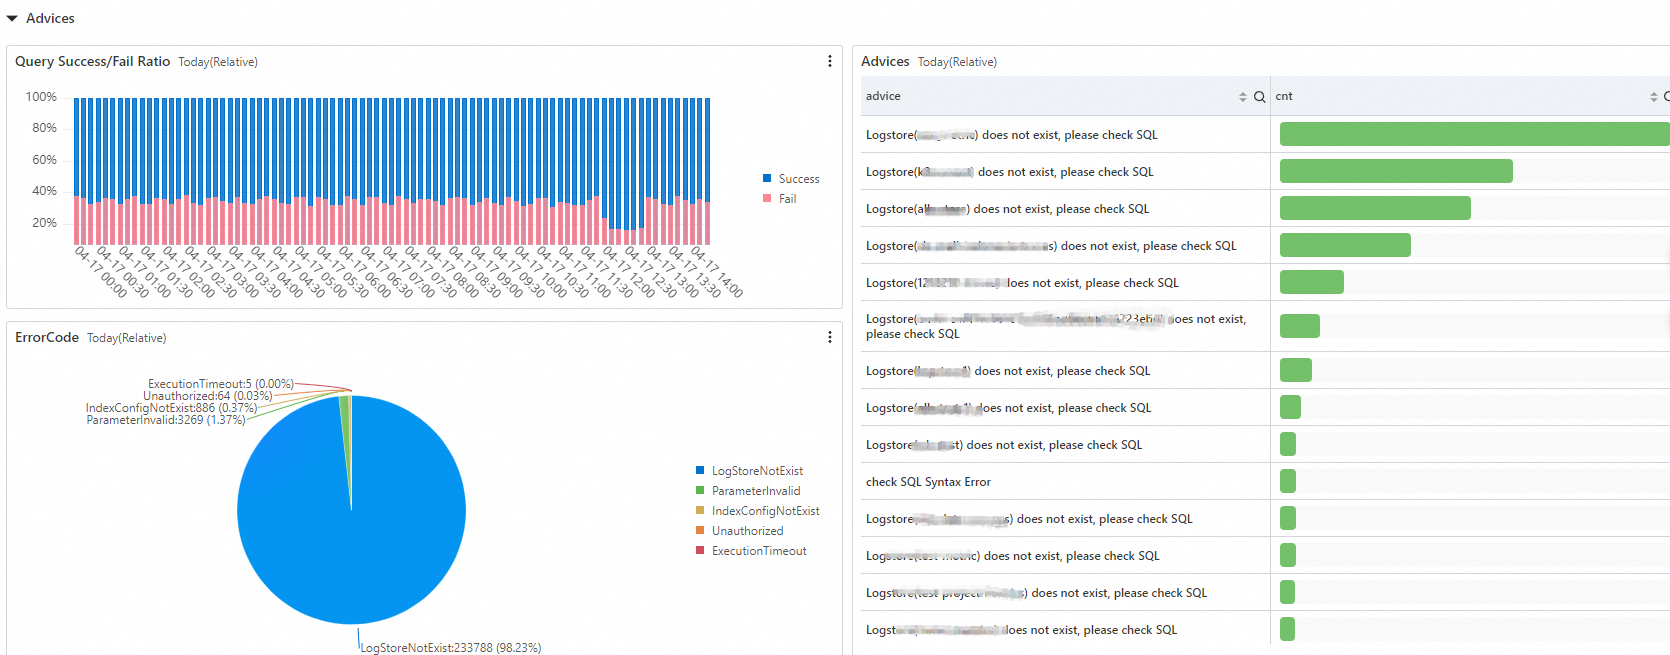
Cette section fournit des suggestions pour améliorer l’exécution SQL en analysant les requêtes SQL ayant rencontré des erreurs d’exécution.
Surveillance des ressources facturables
Le tableau de bord Billable Resource Monitoring affiche des informations sur les ressources facturables pour Simple Log Service. Cela inclut le stockage chaud, le stockage froid, le trafic d’index, le trafic de lecture/écriture, les tendances d’utilisation des éléments facturables (après déduction du plan de ressources), les détails d’utilisation des principaux projets et les détails d’utilisation des principaux Logstores.