Cette rubrique décrit la syntaxe et les paramètres des fonctions de ressource. Elle fournit également des exemples d'utilisation de ces fonctions.
Fonctions
Lorsque vous appelez les fonctions de ressource suivantes, vous devez configurer le mode Aperçu avancé pour extraire les données requises. Pour plus d'informations sur la configuration du mode Aperçu avancé, consultez la rubrique Aperçu avancé.
|
Fonction |
Description |
|
Extrait les valeurs des paramètres avancés de la tâche de transformation de données actuelle. Cette fonction peut être utilisée conjointement avec d'autres fonctions. Pour plus d'informations, consultez la rubrique Enrichissement des données à partir d'ApsaraDB RDS for MySQL. |
|
|
Extrait les données d'une table spécifiée dans une base de données créée sur une instance ApsaraDB RDS for MySQL ou obtient le résultat de l'exécution d'une instruction SQL. Les données et les résultats peuvent être mis à jour à intervalles réguliers. Cette fonction peut être utilisée conjointement avec d'autres fonctions. Pour plus d'informations, consultez la rubrique Enrichissement des données à partir d'ApsaraDB RDS for MySQL. |
|
|
Extrait les données d'un autre Logstore lors de la transformation des données dans un Logstore. L'extraction des données peut s'effectuer de manière continue. Cette fonction peut être utilisée conjointement avec d'autres fonctions. Pour plus d'informations, consultez la rubrique Extraction des données d'un Logstore pour enrichir les données journalisées d'un autre Logstore. |
|
|
Extrait les données d'un objet situé dans un compartiment Object Storage Service (OSS) spécifié. Les données peuvent être mises à jour à intervalles réguliers. Cette fonction peut être utilisée conjointement avec d'autres fonctions. Pour plus d'informations, consultez la rubrique Extraction d'un fichier CSV depuis OSS pour enrichir les données. |
res_local
La fonction res_local extrait les valeurs des paramètres avancés de la tâche de transformation de données actuelle.
-
Syntaxe
res_local(param, default=None, type="auto") -
Paramètres
Paramètre
Type
Obligatoire
Description
param
String
Oui
Clé spécifiée dans Advanced Parameter Settings pour la tâche de transformation de données actuelle.
default
String
Non
Valeur renvoyée si la clé spécifiée pour le paramètre param n'existe pas. Valeur par défaut : None.
type
String
Non
Format des données de sortie. Valeurs possibles :
-
auto : les données brutes sont converties en chaîne JSON. En cas d'échec de la conversion, les données brutes sont renvoyées. Il s'agit de la valeur par défaut.
-
JSON : les données brutes sont converties en chaîne JSON. En cas d'échec de la conversion, la valeur du paramètre default est renvoyée.
-
raw : les données brutes sont renvoyées.
-
-
Réponse
Une chaîne JSON ou des données brutes est renvoyée selon les paramètres configurés.
-
Conversions réussies
Données brutes
Valeur de retour
Type de données de la valeur de retour
1
1
Integer
1,2
1,2
Float
true
True
Boolean
false
False
Boolean
"123"
123
String
null
None
None
["v1", "v2", "v3"]
["v1", "v2", "v3"]
List
["v1", 3, 4.0]
["v1", 3, 4.0]
List
{"v1": 100, "v2": "good"}
{"v1": 100, "v2": "good"}
List
{"v1": {"v11": 100, "v2": 200}, "v3": "good"}
{"v1": {"v11": 100, "v2": 200}, "v3": "good"}
List
-
Échecs de conversion
Le tableau suivant présente quelques exemples d'échecs de conversion. Les données brutes ci-dessous ne peuvent pas être converties en chaînes JSON ; elles sont donc renvoyées sous forme de chaînes.
Données brutes
Valeur de retour
Description
(1,2,3)
"(1,2,3)"
Les tuples ne sont pas pris en charge. Utilisez des listes.
True
"True"
Une valeur de type Boolean ne peut être que true ou false. Les valeurs doivent être en minuscules.
{1: 2, 3: 4}
"{1: 2, 3: 4}"
Une clé de dictionnaire ne peut être qu'une chaîne.
-
-
Exemples
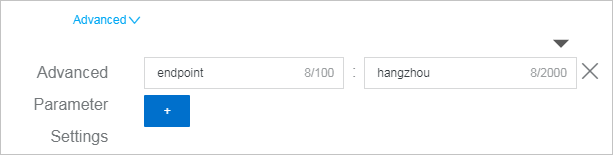
Récupérez la clé spécifiée dans Advanced Parameter Settings et attribuez la valeur de cette clé au paramètre local.
Dans Advanced Parameter Settings, la clé est endpoint et la valeur est hangzhou.
-
Journal brut
content: 1 -
Règle de transformation
e_set("local", res_local('endpoint')) -
Résultat
content: 1
local: hangzhou
-
-
Références
Cette fonction peut être utilisée conjointement avec d'autres fonctions. Pour plus d'informations, consultez la rubrique Enrichissement des données à partir d'ApsaraDB RDS for MySQL.
res_rds_mysql
La fonction res_rds_mysql extrait les données d'une table spécifiée dans une base de données créée sur une instance ApsaraDB RDS for MySQL, ou obtient le résultat de l'exécution d'une instruction SQL. Log Service vous permet d'extraire les données selon les méthodes suivantes :
Si vous utilisez la fonction
res_rds_mysqlpour extraire des données d'une base de données créée sur une instance ApsaraDB RDS for MySQL, vous devez créer une liste blanche sur l'instance et y ajouter0.0.0.0. Cette configuration autorise l'accès à la base de données depuis toutes les adresses IP, mais peut présenter des risques de sécurité. Si vous souhaitez ajouter uniquement l'adresse IP de Log Service à la liste blanche, vous devez soumettre un ticket.Log Service peut accéder à une base de données créée sur une instance ApsaraDB RDS for MySQL via un endpoint public ou interne. Si vous utilisez un endpoint interne, vous devez configurer les paramètres avancés. Pour plus d'informations, consultez la rubrique Enrich data from ApsaraDB RDS for MySQL.
-
Extraire toutes les données une seule fois
Lors de la première exécution d'une tâche de transformation de données, Log Service extrait l'intégralité des données de la table spécifiée, puis cesse toute extraction ultérieure. Nous vous recommandons d'utiliser cette méthode si votre base de données n'est pas mise à jour.
-
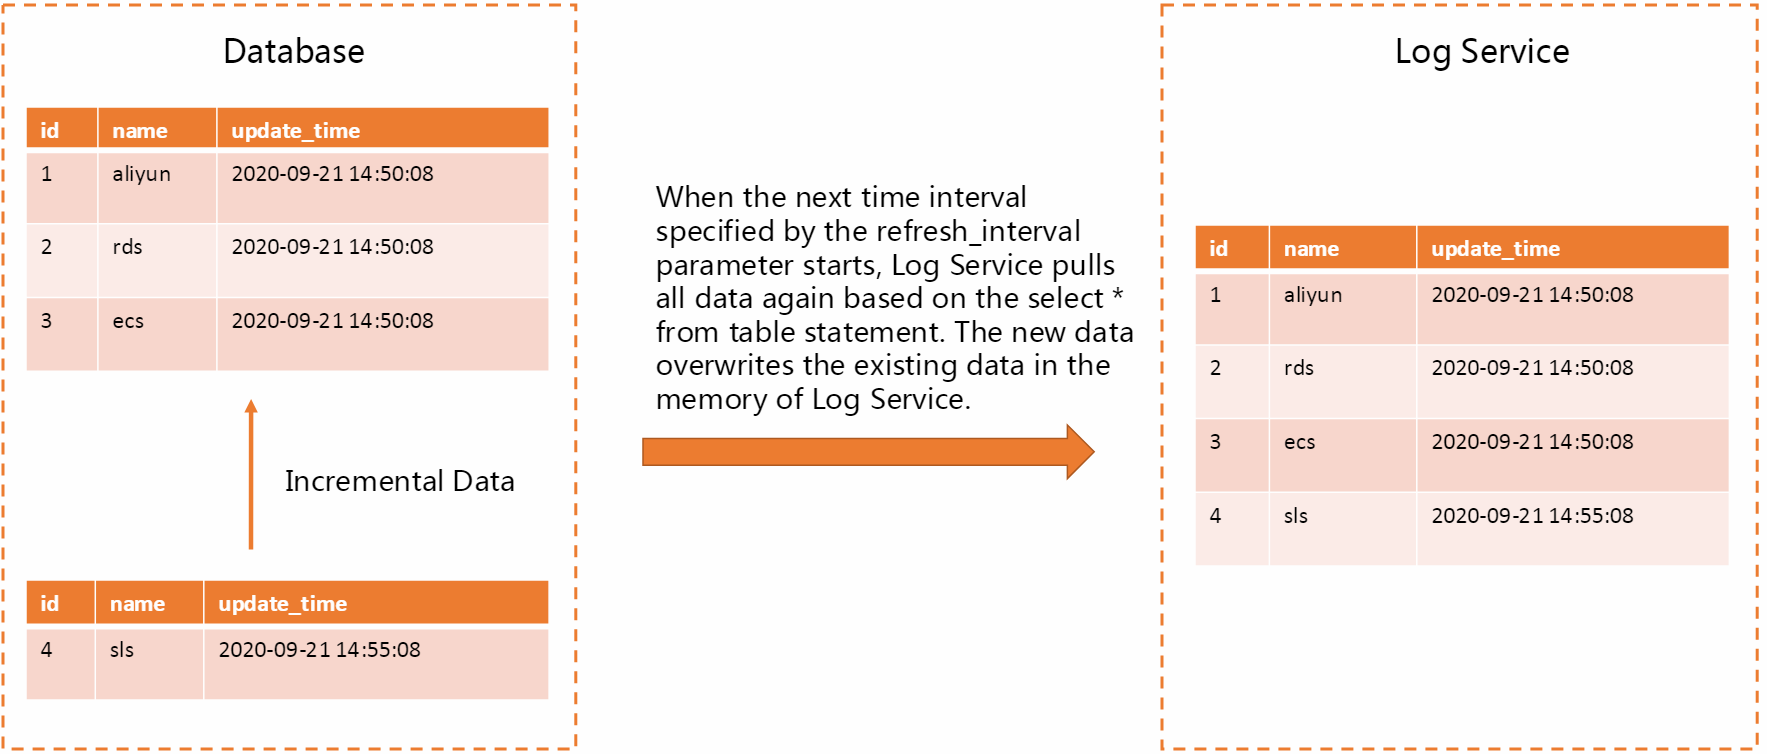
Extraire toutes les données à intervalles réguliers
Lors de l'exécution d'une tâche de transformation de données, Log Service extrait l'intégralité des données de la table spécifiée à intervalles réguliers. Cette approche permet de synchroniser les données avec votre base de données en temps opportun. Toutefois, elle nécessite un temps de traitement plus long. Nous vous recommandons cette méthode si le volume de données de votre base de données est inférieur ou égal à 2 Go et si la valeur du paramètre refresh_interval est supérieure ou égale à 300 secondes.
-
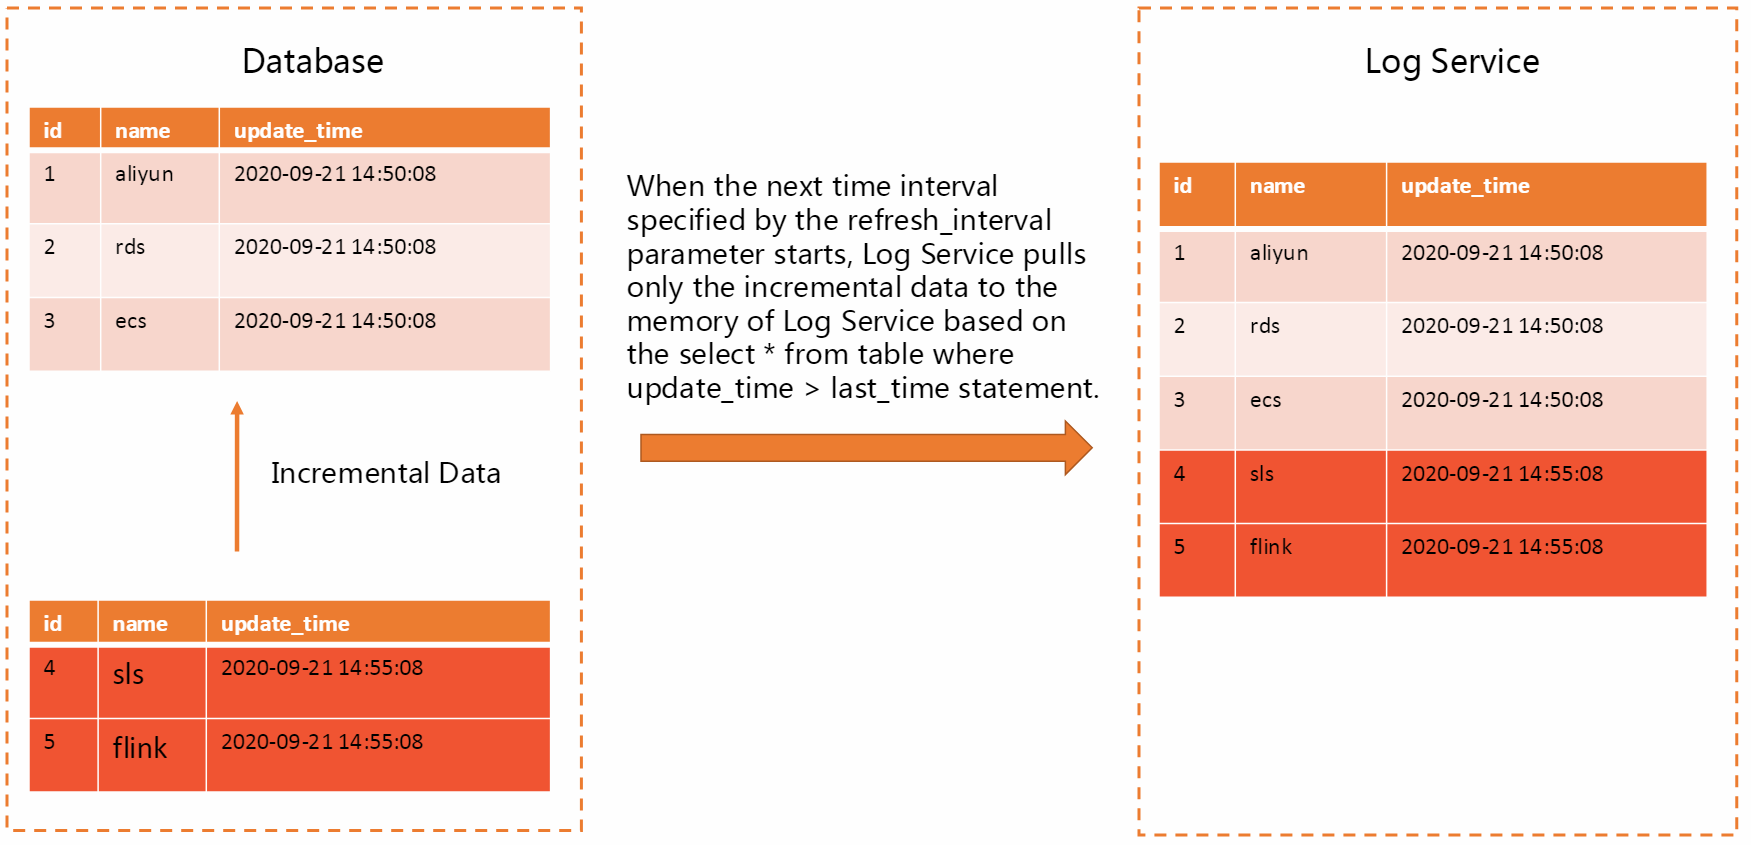
Extraire les données incrémentielles à intervalles réguliers
Lors de l'exécution d'une tâche de transformation de données, Log Service extrait uniquement les données incrémentielles en se basant sur le champ d'horodatage de la base de données spécifiée. Avec cette méthode, seules les nouvelles données sont extraites, ce qui améliore l'efficacité. Vous pouvez définir le paramètre refresh_interval sur 1 seconde pour synchroniser les données en quelques secondes. Nous vous recommandons cette méthode si le volume de données de votre base de données est important, si vos données sont fréquemment mises à jour ou si vous avez besoin d'une extraction rapide des données.
-
Syntaxe
res_rds_mysql(address="The address of the database from which data is pulled", username="The username used to connect to the database", password="The password used to connect to the database", database="The name of the database", table=None, sql=None, fields=None, fetch_include_data=None, fetch_exclude_data=None, refresh_interval=0, base_retry_back_off=1, max_retry_back_off=60, primary_keys=None, use_ssl=false, update_time_key=None, deleted_flag_key=None)RemarqueVous pouvez également utiliser la fonction
res_rds_mysqlpour extraire des données d'une base de données créée dans un cluster AnalyticDB for MySQL ou PolarDB for MySQL. Dans ces scénarios, il vous suffit de remplacer l'adresse, le nom d'utilisateur, le mot de passe et le nom de la base de données dans la règle de transformation par les valeurs réelles. -
Paramètres
Parameter
Type
Required
Description
address
String
Yes
The endpoint or IP address of the database to which you want to connect. If the port number is not 3306, specify a value in the
IP address:Portformat. For more information, see View or modify endpoints and ports.username
String
Yes
The username that is used to connect to the database.
password
String
Yes
The password that is used to connect to the database.
database
String
Yes
The name of the database to which you want to connect.
table
String
Yes
The name of the table from which you want to pull data. If the sql parameter is configured, this parameter is not required.
sql
String
Yes
Use a SQL SELECT statement to retrieve all relevant data from the database and load it into processing memory. SQL can optimize memory usage by filtering fields and rows, reducing the space occupied by the processing memory table. If the table parameter is configured, this parameter is not required.
fields
String list
No
The string list or string alias list. If you do not configure this parameter, all columns returned for the sql or table parameter are used. For example, if you want to rename the name column in the ["user_id", "province", "city", "name", "age"] list to user_name, you must set the fields parameter to ["user_id", "province", "city", ("name", "user_name"), ("nickname", "nick_name"), "age"].
RemarqueIf you configure the sql, table, and fields parameters together, the SQL statement in the sql parameter is executed. The table and fields parameters do not take effect.
fetch_include_data
String
No
The field whitelist. Logs whose fields match the fetch_include_data parameter are retained. Logs whose fields do not match this parameter are discarded.
-
If you do not configure this parameter or set this parameter to None, the field whitelist feature is disabled.
-
If you set this parameter to a specific field and field value, the logs that contain the field and field value are retained.
fetch_exclude_data
String
No
The field blacklist. Logs whose fields match the fetch_exclude_data parameter are discarded. Logs whose fields do not match this parameter are retained.
-
If you do not configure this parameter or set this parameter to None, the field blacklist feature is disabled.
-
If you set this parameter to a specific field and field value, the logs that contain the field and field value are discarded.
RemarqueIf you configure both the fetch_include_data and fetch_exclude_data parameters, data is pulled first based on the setting of the fetch_include_data parameter and then based on the setting of the fetch_exclude_data parameter.
refresh_interval
Numeric string or number
No
The interval at which data is pulled from ApsaraDB RDS for MySQL. Unit: seconds. Default value: 0. This value indicates that all data is pulled only once.
base_retry_back_off
Number
No
The interval at which the system attempts to pull data again after a pulling failure. Default value: 1. Unit: seconds.
max_retry_back_off
Int
No
The maximum interval between two consecutive retries after a pulling failure. Default value: 60. Unit: seconds. We recommend that you use the default value.
primary_keys
String/List
No
The primary key in the key-value store of the in-memory dimension table. If you configure this parameter, data in the table is saved to memory as a dictionary in the Key:Value format. A key in the dictionary is the value of the primary_keys parameter. A value in the dictionary is an entire row of data in the table.
Remarque-
The primary_keys parameter must be set. Otherwise, performance will be significantly impacted and task delays may be caused.
-
The value of the primary_keys parameter must exist in the fields that are pulled from the table.
-
The value of the primary_keys parameter is case-sensitive.
use_ssl
Boolean
No
Specifies whether to use the SSL protocol to connect to the ApsaraDB RDS for MySQL instance. Default value: false.
RemarqueIf SSL encryption is enabled on the ApsaraDB RDS for MySQL instance, Log Service connects to the instance over SSL. However, the server certificate is not verified. The server certificate cannot be used to establish connections.
update_time_key
String
No
The time field that is used to pull incremental data. If you do not configure this parameter, all data is pulled. For example, update_time in update_time_key="update_time" indicates the time field of data update in the database. The time field supports the following data types: datetime, timestamp, integer, float, and decimal. Make sure that the values of the time field increase in chronological order.
RemarqueLog Service pulls incremental data based on the time field. Make sure that an index is configured for this field in the table. If the index is not configured, a full table scan is performed. In addition, an error is reported, which indicates a failure to pull incremental data.
deleted_flag_key
String
No
The data that does not need to be transformed and is discarded when incremental data is pulled. For example, if the value of key in update_time_key="key" meets the following condition, the value is parsed as deleted data:
-
Boolean: true
-
Datetime and timestamp: not empty
-
Char and varchar: 1, true, t, yes, and y
-
Integer: non-zero
Remarque-
You must configure the deleted_flag_key parameter together with the update_time_key parameter.
-
If you configure the update_time_key parameter but do not configure the deleted_flag_key parameter, no data is discarded when incremental data is pulled.
connector
String
No
The connector that is used to remotely connect to the database. Valid values: mysql and pgsql. Default value: mysql.
-
-
Réponse
Un tableau contenant plusieurs colonnes est renvoyé. Les colonnes sont définies par le paramètre fields.
-
Gestion des erreurs
Si une erreur survient lors de l'extraction des données, celle-ci est signalée, mais la tâche de transformation de données continue de s'exécuter. Des tentatives de nouvelle extraction sont effectuées selon la valeur du paramètre base_retry_back_off. Par exemple, le premier intervalle de tentative est de 1 seconde. Si cette tentative échoue, le deuxième intervalle est doublé par rapport au premier. Le processus se poursuit jusqu'à ce que l'intervalle atteigne la valeur du paramètre max_retry_back_off. Si l'erreur persiste, les tentatives sont effectuées selon la valeur du paramètre max_retry_back_off. Si une tentative réussit, l'intervalle de tentative est réinitialisé à sa valeur initiale, soit 1 seconde.
-
Exemples
-
Extraire toutes les données
-
Exemple 1 : Extraire les données de la table
test_tabledans la base de donnéestest_dbà des intervalles de 300 secondes.res_rds_mysql( address="rm-uf6wjk5****mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", refresh_interval=300, ) -
Exemple 2 : Extraire les données de la table
test_table, en excluant les enregistrements dont la valeur status est delete.res_rds_mysql( address="rm-uf6wjk5****mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", refresh_interval=300, fetch_exclude_data="'status':'delete'", ) -
Exemple 3 : Extraire de la table
test_tableles enregistrements dont la valeur status est exit.res_rds_mysql( address="rm-uf6wjk5***mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", refresh_interval=300, fetch_include_data="'status':'exit'", ) -
Exemple 4 : Extraire de la table
test_tableles enregistrements dont la valeur status est exit, en excluant ceux dont la valeur name est aliyun.res_rds_mysql( address="rm-uf6wjk5***mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", refresh_interval=300, fetch_include_data="'status':'exit'", fetch_exclude_data="'name':'aliyun'", ) -
Exemple 5 : Utiliser le connecteur pgsql pour se connecter à une base de données Hologres et extraire les données de la table
test_table.res_rds_mysql( address="hgpostcn-cn-****-cn-hangzhou.hologres.aliyuncs.com:80", username="test_username", password="****", database="aliyun", table="test_table", connector="pgsql", ) -
Exemple 6 : Extraire les données en utilisant le paramètre
primary_keys.Si vous configurez le paramètre primary_keys, sa valeur est extraite en tant que clé. Les données extraites de la table sont enregistrées en mémoire au format {"10001":{"userid":"10001","city_name":"beijing","city_number":"12345"}}. Dans ce cas, l'extraction des données est rapide. Nous vous recommandons d'utiliser cette méthode pour extraire un grand volume de données. Si vous ne configurez pas le paramètre
primary_keys, la fonction parcourt la table ligne par ligne. Elle extrait ensuite les données et les enregistre en mémoire au format [{"userid":"10001","city_name":"beijing","city_number":"12345"}]. Dans ce cas, l'extraction des données est plus lente, mais occupe moins de mémoire. Nous vous recommandons d'utiliser cette méthode pour extraire un petit volume de données.-
Table
userid
city_name
city_number
10001
beijing
12345
-
Journal brut
# Data Record 1 userid:10001 gdp:1000 # Data Record 2 userid:10002 gdp:800 -
Règle de transformation
e_table_map( res_rds_mysql( address="rm-uf6wjk5***mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", primary_keys="userid", ), "userid", ["city_name", "city_number"], ) -
Résultat
# Data Record 1
userid:10001
gdp:1000
city_name: beijing
city_number:12345
# Data Record 2
userid:10002
gdp:800
-
-
-
Extraire les données incrémentielles
-
Exemple 1 : Extraire les données incrémentielles.
RemarqueVous pouvez extraire les données incrémentielles d'une table uniquement si les conditions suivantes sont remplies :
La table possède une clé primaire unique et un champ temporel, tels que les champs item_id et update_time.
Les paramètres primary_keys, refresh_interval et update_time_key sont configurés.
-
Table
item_id
item_name
price
1001
Orange
10
1002
Apple
12
1003
Mango
16
-
Journal brut
# Data Record 1 item_id: 1001 total: 100 # Data Record 2 item_id: 1002 total: 200 # Data Record 3 item_id: 1003 total: 300 -
Règle de transformation
e_table_map( res_rds_mysql( address="rm-uf6wjk5***mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", primary_key="item_id", refresh_interval=1, update_time_key="update_time", ), "item_id", ["item_name", "price"], ) -
Résultat
# Data Record 1
item_id: 1001
total: 100
item_name: Orange
price:10

# Data Record 2
item_id: 1002
total: 200
item_name: Apple
price:12

# Data Record 3
item_id: 1003
total: 300
item_name: Mango
price:16
-
Exemple 2 : Configurer le paramètre deleted_flag_key pour ignorer les données spécifiées lors de l'extraction des données incrémentielles.
-
Table
item_id
item_name
price
update_time
Is_deleted
1001
Orange
10
1603856138
False
1002
Apple
12
1603856140
False
1003
Mango
16
1603856150
False
-
Journal brut
# Data Record 1 item_id: 1001 total: 100 # Data Record 2 item_id: 1002 total: 200 # Data Record 3 item_id: 1003 total: 300 -
Règle de transformation
e_table_map( res_rds_mysql( address="rm-uf6wjk5***mo.mysql.rds.aliyuncs.com", username="test_username", password="****", database="test_db", table="test_table", primary_key="item_id", refresh_interval=1, update_time_key="update_time", deleted_flag_key="is_deleted", ), "item_id", ["item_name", "price"], ) -
Résultat
La fonction
res_rds_mysqlextrait trois enregistrements de données de la table vers la mémoire du serveur sur lequel Log Service s'exécute. Ces enregistrements sont comparés aux enregistrements existants dans le Logstore source pour vérifier leur correspondance. Si vous souhaitez ignorer l'enregistrement dont l'item_idest 1001, localisez l'enregistrement dont l'item_idest 1001 dans la table et modifiez la valeur du champ Is_deleted en true. Ainsi, l'enregistrement 1001 sera ignoré lors de la prochaine mise à jour de la table de dimension en mémoire.# Data Record 2 item_id: 1002 total: 200 item_name: Apple price:12 # Data Record 3 item_id: 1003 total: 300 item_name: Mango price:1
-
-
-
-
Références
Cette fonction peut être utilisée conjointement avec d'autres fonctions. Pour plus d'informations, consultez la rubrique Enrich data from ApsaraDB RDS for MySQL.
res_log_logstore_pull
La fonction res_log_logstore_pull extrait des données d’un autre Logstore lors de la transformation des données dans un Logstore.
-
Syntaxe
res_log_logstore_pull(endpoint, ak_id, ak_secret, project, logstore, fields, from_time="begin", to_time=None, fetch_include_data=None, fetch_exclude_data=None, primary_keys=None, fetch_interval=2, delete_data=None, base_retry_back_off=1, max_retry_back_off=60, ttl=None, role_arn=None) -
Paramètres
Parameter
Type
Required
Description
endpoint
String
Yes
L’endpoint. Pour plus d’informations, consultez Endpoint. Par défaut, un endpoint HTTPS est utilisé. Vous pouvez également utiliser un endpoint HTTP. Dans certains cas particuliers, il peut être nécessaire d’utiliser un port autre que le port 80 ou 443.
ak_id
String
Yes
L’AccessKey ID de votre compte Alibaba Cloud. Pour garantir la sécurité des données, nous vous recommandons de configurer ce paramètre dans Advanced Parameter Settings. Pour savoir comment configurer les paramètres avancés, consultez Create a data transformation job.
ak_secret
String
Yes
L’AccessKey secret de votre compte Alibaba Cloud. Pour garantir la sécurité des données, nous vous recommandons de configurer ce paramètre dans Advanced Parameter Settings. Pour savoir comment configurer les paramètres avancés, consultez Create a data transformation job.
project
String
Yes
Le nom du projet à partir duquel vous souhaitez extraire les données.
logstore
String
Yes
Le nom du Logstore à partir duquel vous souhaitez extraire les données.
fields
String list
Yes
La liste de chaînes ou la liste d’alias de chaînes. Si un journal ne contient pas un champ spécifié, la valeur de ce champ est une chaîne vide. Par exemple, si vous souhaitez renommer la colonne name dans la liste ["user_id", "province", "city", "name", "age"] en user_name, vous devez définir ce paramètre sur ["user_id", "province", "city", ("name", "user_name"), ("nickname", "nick_name"), "age"].
from_time
String
No
L’heure serveur à laquelle débute la première extraction de données depuis le Logstore. Valeur par défaut : begin. Cette valeur indique que Log Service commence à extraire les données à partir du premier journal. Les formats d’heure suivants sont pris en charge :
-
Horodatage UNIX.
-
Chaîne d’heure.
-
Chaîne personnalisée, telle que begin ou end.
-
Expression : l’heure renvoyée par la fonction dt_. Par exemple, la fonction dt_totimestamp(dt_truncate(dt_today(tz="Asia/Shanghai"), day=op_neg(-1))) renvoie l’heure de début de l’extraction des données, soit un jour avant l’heure actuelle. Si l’heure actuelle est 2019-5-5 10:10:10 (UTC+8), l’heure renvoyée est 2019-5-4 10:10:10 (UTC+8).
to_time
String
No
L’heure serveur à laquelle se termine la première extraction de données depuis le Logstore. Valeur par défaut : None. Cette valeur indique que Log Service arrête l’extraction des données au dernier journal. Les formats d’heure suivants sont pris en charge :
-
Horodatage UNIX.
-
Chaîne d’heure.
-
Chaîne personnalisée, telle que begin ou end.
-
Expression : l’heure renvoyée par la fonction dt_.
Si vous ne configurez pas ce paramètre ou si vous le définissez sur None, les données sont extraites continuellement à partir des derniers journaux.
RemarqueSi vous définissez ce paramètre sur une heure postérieure à l’heure actuelle, seules les données existantes dans le Logstore sont extraites. Les nouvelles données ne sont pas extraites.
fetch_include_data
String
No
La liste d’autorisation de champs. Les journaux dont les champs correspondent au paramètre fetch_include_data sont conservés. Les journaux dont les champs ne correspondent pas à ce paramètre sont ignorés.
-
Si vous ne configurez pas ce paramètre ou si vous le définissez sur None, la fonctionnalité de liste d’autorisation de champs est désactivée.
-
Si vous définissez ce paramètre sur un champ et une valeur de champ spécifiques, les journaux contenant ce champ et cette valeur sont conservés.
fetch_exclude_data
String
No
La liste de blocage de champs. Les journaux dont les champs correspondent au paramètre fetch_exclude_data sont ignorés. Les journaux dont les champs ne correspondent pas à ce paramètre sont conservés.
-
Si vous ne configurez pas ce paramètre ou si vous le définissez sur None, la fonctionnalité de liste de blocage de champs est désactivée.
-
Si vous définissez ce paramètre sur un champ et une valeur de champ spécifiques, les journaux contenant ce champ et cette valeur sont ignorés.
RemarqueSi vous configurez à la fois les paramètres de liste de blocage et de liste d’autorisation, les journaux dont les champs correspondent au paramètre de liste de blocage sont d’abord ignorés, puis les journaux restants dont les champs correspondent au paramètre de liste d’autorisation sont conservés.
primary_keys
String list
No
La liste des champs de clé primaire utilisés pour maintenir une table. Si vous modifiez le nom d’un champ de clé primaire à l’aide du paramètre fields, vous devez utiliser le nouveau nom pour spécifier le champ de clé primaire pour ce paramètre.
Remarque-
La valeur du paramètre primary_keys ne peut contenir que les chaînes à valeur unique spécifiées dans la valeur du paramètre fields.
-
Ce paramètre est valide uniquement lorsqu’un seul shard existe dans le Logstore à partir duquel les données sont extraites.
-
Le paramètre primary_keys doit être défini. Sinon, les performances seront considérablement impactées et des retards de tâche peuvent survenir.
-
La valeur du paramètre primary_keys est sensible à la casse.
fetch_interval
Int
No
L’intervalle entre deux requêtes d’extraction de données consécutives lors d’une extraction continue. Valeur par défaut : 2. Unité : secondes. La valeur doit être supérieure ou égale à 1 seconde.
delete_data
String
No
L’opération de suppression des données de la table. Les enregistrements de données qui répondent aux conditions spécifiées et contiennent la valeur de
primary_keyssont supprimés. Pour plus d’informations, consultez Query string syntax.base_retry_back_off
Number
No
L’intervalle auquel le système tente à nouveau d’extraire les données après un échec d’extraction. Valeur par défaut : 1. Unité : secondes.
max_retry_back_off
Int
No
L’intervalle maximal entre deux tentatives consécutives après un échec d’extraction. Valeur par défaut : 60. Unité : secondes. Nous vous recommandons d’utiliser la valeur par défaut.
ttl
Int
No
Le nombre de secondes utilisé pour déterminer la plage d’extraction des données en mode continu. L’extraction des données commence lorsque les données de journal sont générées et se termine ttl secondes après la génération des données de journal. Unité : secondes. Valeur par défaut : None. Cette valeur indique que toutes les données de journal sont extraites.
role_arn
String
No
Le nom de ressource Alibaba Cloud (ARN) du rôle RAM utilisé. Le rôle RAM doit disposer des autorisations de lecture sur le Logstore à partir duquel les données sont extraites. Dans la console RAM, vous pouvez afficher l’ARN d’un rôle RAM dans la section Basic Information de la page de détails du rôle. Exemple :
acs:ram::137944:role/role-a. Pour savoir comment obtenir l’ARN d’un rôle RAM, consultez View a RAM role. -
-
Réponse
Une table contenant plusieurs colonnes est renvoyée.
-
Gestion des erreurs
Si une erreur se produit lors de l’extraction des données, l’erreur est signalée, mais la tâche de transformation des données continue de s’exécuter. Des nouvelles tentatives sont effectuées en fonction de la valeur du paramètre base_retry_back_off. Par exemple, le premier intervalle de nouvelle tentative est de 1 seconde et la première tentative échoue. Le deuxième intervalle de nouvelle tentative est deux fois plus long que le premier. Le processus se poursuit jusqu’à ce que l’intervalle atteigne la valeur du paramètre max_retry_back_off. Si l’erreur persiste, les nouvelles tentatives sont effectuées en fonction de la valeur du paramètre max_retry_back_off. Si une nouvelle tentative réussit, l’intervalle de nouvelle tentative est réinitialisé à la valeur initiale, soit 1 seconde.
-
Exemples
-
Dans cet exemple, les données des champs key1 et key2 sont extraites du Logstore test_logstore du projet test_project. L’extraction des données commence lorsque les données de journal sont écrites dans le Logstore. L’extraction des données se termine lorsque l’opération d’écriture des données est terminée. Les données sont extraites une seule fois.
res_log_logstore_pull( "cn-hangzhou.log.aliyuncs.com", "LT****Gw", "ab****uu", "test_project", "test_logstore", ["key1", "key2"], from_time="begin", to_time="end", ) -
Dans cet exemple, les données des champs key1 et key2 sont extraites du Logstore test_logstore du projet test_project. L’extraction des données commence lorsque les données de journal sont écrites dans le Logstore. L’extraction des données se termine lorsque l’opération d’écriture des données est terminée. Les données sont extraites de manière continue à des intervalles de 30 secondes.
res_log_logstore_pull( "cn-hangzhou.log.aliyuncs.com", "LT****Gw", "ab****uu", "test_project", "test_logstore", ["key1", "key2"], from_time="begin", to_time=None, fetch_interval=30, ) -
Dans cet exemple, une liste de blocage est configurée pour ignorer les enregistrements de données contenant key1:value1 lors de l’extraction des données d’un Logstore.
res_log_logstore_pull( "cn-hangzhou.log.aliyuncs.com", "LT****Gw", "ab****uu", "test_project", "test_logstore", ["key1", "key2"], from_time="begin", to_time=None, fetch_interval=30, fetch_exclude_data="key1:value1", ) -
Dans cet exemple, une liste d’autorisation est configurée pour extraire les enregistrements de données contenant key1:value1 d’un Logstore.
res_log_logstore_pull( "cn-hangzhou.log.aliyuncs.com", "LT****Gw", "ab****uu", "test_project", "test_logstore", ["key1", "key2"], from_time="begin", to_time=None, fetch_interval=30, fetch_include_data="key1:value1", ) -
Dans cet exemple, les données des champs key1 et key2 sont extraites du Logstore test_logstore du projet test_project. L’extraction des données commence lorsque les données de journal sont générées et se termine 40 000 000 secondes après la génération des données de journal.
res_log_logstore_pull( "cn-hangzhou.log.aliyuncs.com", "LTAI*****Cajvr", "qO0Tp*****jJ9", "test_project", "test_logstore", fields=["key1","key2"], ttl="40000000" ) -
Dans cet exemple, les données des champs key1 et key2 sont extraites du Logstore test-logstore du projet project-test1. Le rôle lié au service de Log Service est utilisé pour l’autorisation. L’extraction des données commence lorsque les données de journal sont écrites dans le Logstore. L’extraction des données se termine lorsque l’opération d’écriture des données est terminée. Les données sont extraites une seule fois.
res_log_logstore_pull( "pub-cn-hangzhou-staging-intranet.log.aliyuncs.com", "", "", "project-test1", "test-logstore", ["key1", "key2"], from_time="2022-7-27 10:10:10 8:00", to_time="2022-7-27 14:30:10 8:00", role_arn="acs:ram::***:role/aliyunserviceroleforslsaudit", ) -
Dans cet exemple, les données des champs key1 et key2 sont extraites du Logstore test-logstore du projet project-test1. Un rôle par défaut est utilisé pour l’autorisation. L’extraction des données commence lorsque les données de journal sont écrites dans le Logstore. L’extraction des données se termine lorsque l’opération d’écriture des données est terminée. Les données sont extraites une seule fois.
res_log_logstore_pull(
    "cn-chengdu.log.aliyuncs.com",
    "",
    "",
    "project-test1",
    "test-logstore",
     ["key1", "key2"],
    from_time="2022-7-21 10:10:10 8:00",
    to_time="2022-7-21 10:30:10 8:00",
    role_arn="acs:ram::***:role/aliyunlogetlrole",
)
-
-
Références
Cette fonction peut être utilisée conjointement avec d’autres fonctions. Pour plus d’informations, consultez Extraire des données d’un Logstore pour enrichir les données de journal dans un autre Logstore.
res_oss_file
La fonction res_oss_file extrait les données d'un objet stocké dans un bucket OSS spécifié. Ces données peuvent être actualisées à intervalles réguliers.
Nous vous recommandons d'utiliser un projet Log Service situé dans la même région que le bucket OSS. Cette configuration permet d'extraire les données de l'objet via le réseau interne d'Alibaba Cloud, qui offre stabilité et rapidité.
-
Syntaxe
res_oss_file(endpoint, ak_id, ak_key, bucket, file, format='text', change_detect_interval=0, base_retry_back_off=1, max_retry_back_off=60, encoding='utf8', error='ignore') -
Paramètres
Parameter
Type
Required
Description
endpoint
String
Yes
Endpoint du bucket OSS. Pour plus d'informations, consultez Régions et endpoints. Par défaut, un endpoint HTTPS est utilisé. Vous pouvez également utiliser un endpoint HTTP. Dans certains cas particuliers, il peut être nécessaire d'utiliser un port autre que 80 ou 443.
ak_id
String
Yes
AccessKey ID de votre compte Alibaba Cloud. Pour garantir la sécurité des données, nous vous recommandons de configurer ce paramètre dans Advanced Parameter Settings. Pour savoir comment configurer les paramètres avancés, consultez Créer une tâche de transformation de données.
ak_key
String
Yes
Secret AccessKey de votre compte Alibaba Cloud. Pour garantir la sécurité des données, nous vous recommandons de configurer ce paramètre dans Advanced Parameter Settings. Pour savoir comment configurer les paramètres avancés, consultez Créer une tâche de transformation de données.
bucket
String
Yes
Nom du bucket OSS depuis lequel vous souhaitez extraire les données.
file
String
Yes
Chemin d'accès à l'objet depuis lequel vous souhaitez extraire les données. Exemple : test/data.txt. Ne commencez pas le chemin par une barre oblique (/).
format
String
Yes
Format du fichier de sortie. Valeurs possibles :
-
Text : format texte
-
Binary : format flux binaire
change_detect_interval
String
No
Intervalle d'extraction des données de l'objet depuis OSS par Log Service, exprimé en secondes. Le système vérifie si l'objet a été mis à jour lors de l'extraction. Si c'est le cas, seules les données incrémentielles sont extraites. Valeur par défaut : 0. Cette valeur indique qu'aucune donnée incrémentielle n'est extraite ; toutes les données sont récupérées une seule fois lors de l'appel de la fonction.
base_retry_back_off
Number
No
Intervalle avant la nouvelle tentative d'extraction des données après un échec. Valeur par défaut : 1 seconde.
max_retry_back_off
Int
No
Intervalle maximal entre deux tentatives consécutives après un échec d'extraction. Valeur par défaut : 60 secondes. Nous vous recommandons de conserver la valeur par défaut.
encoding
String
No
Format d'encodage. Si vous définissez le paramètre format sur Text, ce paramètre est automatiquement défini sur utf8.
error
String
No
Méthode de gestion des erreurs. Ce paramètre n'est valide que lorsque le message UnicodeError est signalé. Valeurs possibles :
-
ignore : le système ignore les données au format invalide et poursuit l'encodage.
-
xmlcharrefreplace : le système remplace les caractères impossibles à encoder par des références de caractères XML appropriées.
Pour plus d'informations, consultez Gestionnaires d'erreurs.
decompress
String
No
Indique s'il faut décompresser l'objet. Valeurs possibles :
-
None : l'objet n'est pas décompressé. Il s'agit de la valeur par défaut.
-
gzip : l'objet est décompressé à l'aide de gzip.
-
-
Réponse
Les données de l'objet sont renvoyées sous forme de flux binaire ou de texte.
-
Gestion des erreurs
En cas d'erreur lors de l'extraction des données, celle-ci est signalée, mais la tâche de transformation de données continue de s'exécuter. Les nouvelles tentatives sont effectuées selon la valeur du paramètre base_retry_back_off. Par exemple, si le premier intervalle de nouvelle tentative est d'une seconde et que cette tentative échoue, le deuxième intervalle sera doublé. Le processus se poursuit jusqu'à ce que l'intervalle atteigne la valeur du paramètre max_retry_back_off. Si l'erreur persiste, les nouvelles tentatives sont effectuées selon la valeur du paramètre max_retry_back_off. Si une tentative réussit, l'intervalle de nouvelle tentative est réinitialisé à sa valeur initiale, soit 1 seconde.
-
Exemples
-
Exemple 1 : Extraire des données JSON depuis OSS.
-
Données JSON
{ "users": [ { "name": "user1", "login_historys": [ { "date": "2019-10-10 0:0:0", "login_ip": "203.0.113.10" }, { "date": "2019-10-10 1:0:0", "login_ip": "203.0.113.10" } ] }, { "name": "user2", "login_historys": [ { "date": "2019-10-11 0:0:0", "login_ip": "203.0.113.20" }, { "date": "2019-10-11 1:0:0", "login_ip": "203.0.113.30" }, { "date": "2019-10-11 1:1:0", "login_ip": "203.0.113.50" } ] } ] } -
Journal brut
content: 123 -
Règle de transformation
e_set( "json_parse", json_parse( res_oss_file( endpoint="http://oss-cn-hangzhou.aliyuncs.com", ak_id="LT****Gw", ak_key="ab****uu", bucket="log-etl-staging", file="testjson.json", ) ), ) -
Résultat
content: 123
    prjson_parse:
'{
  "users": [
    {
        "name": "user1",
        "login_historys": [
          {
            "date": "2019-10-10 0:0:0",
            "login_ip": "203.0.113.10"
          },
          {
            "date": "2019-10-10 1:0:0",
            "login_ip": "203.0.113.10"
          }
        ]
    },
    {
        "name": "user2",
        "login_historys": [
          {
            "date": "2019-10-11 0:0:0",
            "login_ip": "203.0.113.20"
          },
          {
            "date": "2019-10-11 1:0:0",
            "login_ip": "203.0.113.30"
          },
          {
            "date": "2019-10-11 1:1:0",
            "login_ip": "203.0.113.50"
          }
        ]
    }
  ]
}'
-
-
Exemple 2 : Extraire du contenu textuel depuis OSS.
-
Contenu textuel
Test bytes -
Journal brut
content: 123 -
Règle de transformation
e_set( "test_txt", res_oss_file( endpoint="http://oss-cn-hangzhou.aliyuncs.com", ak_id="LT****Gw", ak_key="ab****uu", bucket="log-etl-staging", file="test.txt", ), ) -
Résultat
content: 123
test_txt: Test bytes
-
-
Exemple 3 : Extraire des données depuis un objet OSS compressé et décompresser l'objet.
-
Contenu de l'objet compressé
Test bytes\nupdate\n123 -
Journal brut
content:123 -
Règle de transformation
e_set( "text", res_oss_file( endpoint="http://oss-cn-hangzhou.aliyuncs.com", ak_id="LT****Gw", ak_key="ab****uu", bucket="log-etl-staging", file="test.txt.gz", format="binary", change_detect_interval=30, decompress="gzip", ), ) -
Résultat
content:123
text: Test bytes\nupdate\n123
-
-
Exemple 4 : Accéder à un objet dans un bucket OSS dont la liste de contrôle d'accès (ACL) est définie sur public-read-write. Aucune paire AccessKey n'est utilisée.
-
Contenu de l'objet compressé
Test bytes -
Journal brut
content:123 -
Règle de transformation
e_set( "test_txt", res_oss_file( endpoint="http://oss-cn-hangzhou.aliyuncs.com", bucket="log-etl-staging", file="test.txt", ), ) -
Résultat
content: 123
test_txt: Test bytes
-
-
-
Références
Cette fonction peut être utilisée conjointement avec d'autres fonctions. Pour plus d'informations, consultez Extraire un fichier CSV depuis OSS pour enrichir les données.