Simple Log Service (SLS) prend en charge la consommation basée sur des règles, qui utilise des instructions SPL côté serveur pour prétraiter les données de journal avant leur livraison à votre consommateur.
Fonctionnement
La consommation basée sur des règles applique des instructions SPL côté serveur pour prétraiter les données de journal semi-structurées — filtrage des lignes, élagage des colonnes, extraction basée sur des expressions régulières et extraction de champs JSON — et livre des données propres et structurées à votre client. Syntaxe SPL.
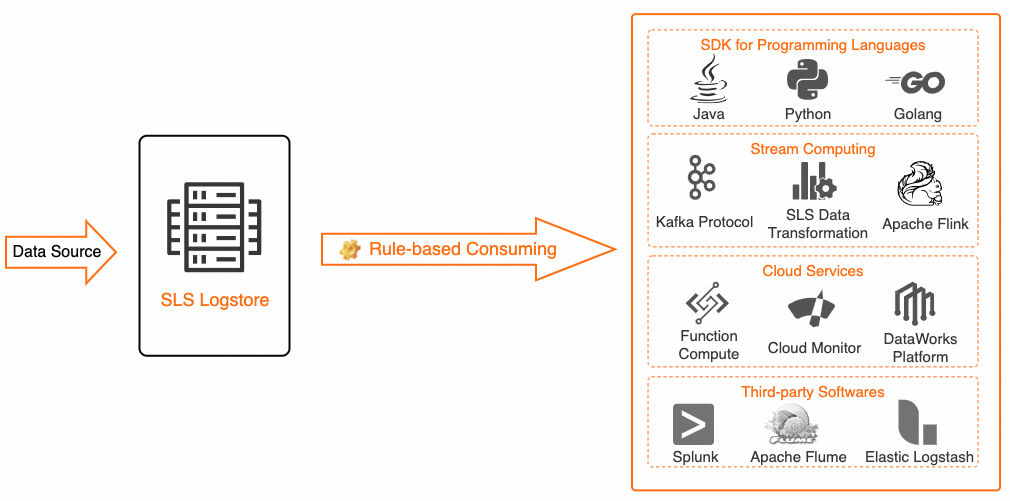
La consommation basée sur des règles et la requête et l'analyse lisent toutes deux des données. Pour plus d'informations, consultez les Différences entre la consommation de journaux et la requête de journaux.
Cas d'utilisation
La consommation basée sur des règles convient aux scénarios de calcul de flux et en temps réel qui nécessitent un prétraitement des données — tel que le filtrage des lignes, l'élagage des colonnes ou l'extraction par expression régulière/chemin JSON — avant la consommation. Elle offre une faible latence, généralement de l'ordre de quelques secondes, et prend en charge des périodes de rétention des données personnalisées.
Avantages
-
Réduction des coûts de trafic Internet.
Le filtrage côté serveur supprime les données inutiles avant la transmission, ce qui réduit le trafic réseau.
-
Économisez les ressources CPU locales et accélérez le traitement.
Déchargez les calculs complexes vers SLS, libérant ainsi les ressources locales et accélérant le flux de travail global.
Facturation
Si votre Logstore utilise le mode de facturation par données ingérées, la consommation basée sur des règles est gratuite. Toutefois, l'extraction de données depuis un endpoint SLS public entraîne des frais de trafic Internet en lecture basés sur la taille des données compressées. Consultez les Éléments facturables du mode par données ingérées.
Si votre Logstore utilise le mode de facturation par fonctionnalité, vous êtes facturé pour le calcul côté serveur et pouvez également encourir des frais de trafic Internet lors de l'utilisation d'un endpoint SLS public. Consultez les Éléments facturables du mode par fonctionnalité.
Consommateurs
Le tableau suivant répertorie les consommateurs pris en charge.
|
Type |
Consommateur |
Description |
|
Applications multilingues |
Applications multilingues |
Les applications Java, Python et Go peuvent consommer des données SLS via un groupe de consommateurs basé sur des règles. Consultez Consommer des données à l'aide d'une API et Consommer des journaux à l'aide d'un groupe de consommateurs. Meilleures pratiques : Utiliser un SDK pour consommer des journaux basés sur un processeur de consommation (SPL) |
|
Service cloud |
Realtime Compute for Apache Flink |
Realtime Compute for Apache Flink peut consommer des données SLS en temps réel. Consultez Simple Log Service. Meilleures pratiques : |
|
Calcul de flux |
Kafka |
Pour demander cette intégration, soumettez un ticket. |
Notes d'utilisation
Le traitement SPL côté serveur peut ajouter une latence de lecture de 10 à 100 ms par 5 Mo, selon la complexité de la requête et les caractéristiques des données. Cependant, la latence de bout en bout — de l'extraction des données jusqu'à la fin du calcul local — est généralement plus faible.
Des erreurs de syntaxe SPL ou l'absence de champs source peuvent entraîner des résultats incomplets ou des échecs. Consultez la section Gestion des erreurs.
La longueur maximale d'une instruction SPL est de 4 Ko.
Les limites de lecture par shard sont identiques pour la consommation basée sur des règles et la consommation standard. Le trafic de lecture est calculé sur la base de la taille des données brutes avant le traitement SPL. Consultez la section Lecture et écriture de données.
FAQ
-
Comment résoudre l'erreur
ShardReadQuotaExceedlors de la consommation basée sur des règles ?-
Solution :
Configurez votre client consommateur pour qu'il attende et réessaie lorsque cette erreur se produit.
Divisez manuellement le shard pour réduire la vitesse de lecture par shard pour les nouvelles données.
-
-
Comment le trafic est-il limité pour la consommation basée sur des règles ?
-
La politique de limitation est la même que pour la consommation standard. Le trafic est calculé sur la base de la taille des données brutes avant le traitement SPL. Consultez la section Lecture et écriture de données.
Par exemple, si les données brutes compressées totalisent 100 Mo et que l'instruction SPL * | where method = 'POST' renvoie 20 Mo au client, le trafic de lecture est toujours calculé sur la base des 100 Mo initiaux.
-
-
Pourquoi le trafic sortant est-il faible dans le graphique Traffic/min sur la page Project Monitoring après l'activation de la consommation basée sur des règles ?
Le graphique Traffic/min affiche la taille des données après le traitement SPL. Si votre instruction SPL filtre des lignes ou élague des colonnes, le trafic sortant est inférieur au trafic entrant.