Simple Log Service (SLS) vous permet d'importer des fichiers journaux depuis Amazon S3 pour les interroger, les analyser et les traiter. Les objets S3 individuels jusqu'à 5 Go sont pris en charge (la taille compressée s'applique aux objets compressés).
Prérequis
Téléchargez les fichiers journaux vers Amazon S3.
Créez un projet et un logstore. Gérer un projet, Créer un logstore.
-
Configurez des autorisations personnalisées :
-
Créez une politique personnalisée accordant les autorisations nécessaires à la gestion des ressources S3, comme illustré dans l'exemple suivant (AWS : Ensembles d'autorisations personnalisés).
RemarqueDes autorisations S3 personnalisées sont requises pour importer des fichiers dans SLS.
{ "Version": "1", "Statement": [ { "Effect": "Allow", "Action": [ "s3:GetObject", "s3:ListBucket" ], "Resource": [ "arn:aws:s3:::your_bucket_name", "arn:aws:s3:::your_bucket_name/*" ] } ] } -
Créez une politique personnalisée accordant les autorisations nécessaires à la gestion des ressources SQS (AWS : Ensembles d'autorisations personnalisés).
RemarqueCette étape n'est nécessaire que si vous activez l'intégration SQS. Une file d'attente SQS doit être dédiée à une seule tâche d'importation. N'utilisez pas la file d'attente pour d'autres tâches d'importation ni à d'autres fins. Si les données de la file d'attente ne correspondent pas aux conditions de filtre de la tâche d'importation, le système les efface par défaut.
{
  "Effect": "Allow",
  "Action": [
    "sqs:ReceiveMessage",
    "sqs:DeleteMessage",
    "sqs:GetQueueAttributes",
    "kms:Decrypt"
  ],
  "Resource": "*"
}
-
Créer une configuration d'importation de données
Connectez-vous à la console Simple Log Service.
Accédez à Import Data > Data Import et sélectionnez S3 - Data Import.
Sélectionnez le projet et le logstore de destination, puis cliquez sur Next.
-
Configurez les paramètres d'importation.
-
À l'étape Import Configuration, définissez les paramètres suivants.
Paramètre
Description
Task Name
Le nom unique de la tâche d'importation de données.
S3 Region
La région où se trouve le bucket source.
AWS AccessKey ID
L'ID AWS AccessKey utilisé pour accéder à votre compte AWS.
ImportantAssurez-vous que votre ID AccessKey dispose des autorisations requises pour accéder aux ressources AWS concernées.
AWS Secret AccessKey
La clé secrète AWS Secret AccessKey correspondant à votre ID AccessKey.
SQS Queue URL
L'URL de la file d'attente SQS (AWS : Identifiants de file d'attente et de message).
ImportantCe paramètre est requis uniquement si vous activez l'intégration SQS.
File Path Prefix Filter
Filtre les objets S3 par préfixe de clé. Par exemple, définissez le préfixe sur
csv/pour importer uniquement les objets de ce répertoire.Si vous laissez ce paramètre vide, l'intégralité du bucket S3 est analysée.
RemarqueConfigurez un préfixe pour les buckets volumineux. L'analyse d'un bucket entier ralentit l'importation.
File Path Regex Filter
Filtre les objets S3 à l'aide d'une expression régulière correspondant au chemin complet de l'objet. Seuls les objets correspondants sont importés. Vide par défaut (aucun filtrage).
Par exemple, si un objet S3 se trouve à l'emplacement
testdata/csv/bill.csv, vous pouvez définir l'expression régulière sur(testdata/csv/)(.*).File Modification Time Filter
Filtre les objets S3 selon leur date de dernière modification.
All : Sélectionnez cette option pour importer tous les objets répondant aux conditions spécifiées.
From Specific Time : Sélectionnez cette option pour importer les objets modifiés après un moment précis.
Specific Time Range : Sélectionnez cette option pour importer les objets modifiés dans une plage horaire spécifique.
Data Format
Le format d'analyse des fichiers journaux :
CSV : Texte délimité. Vous pouvez utiliser la première ligne du fichier comme noms de champs ou spécifier manuellement les noms de champs. Chaque ligne suivante est analysée comme les valeurs d'une entrée de journal.
Single-line JSON : Lit l'objet S3 ligne par ligne et analyse chaque ligne comme un objet JSON. Les clés de l'objet JSON deviennent les noms de champs dans le journal.
Single-line Text Log : Analyse chaque ligne de l'objet S3 comme une entrée de journal distincte.
Multi-line Text Logs : Analyse plusieurs lignes comme une seule entrée de journal. Vous devez spécifier une expression régulière pour faire correspondre le début ou la fin d'une entrée de journal.
Compression Format
Le format de compression des objets S3 source. SLS décompresse les objets selon le format sélectionné avant de lire les données.
Encoding Format
Le format d'encodage des objets S3 source. Seuls UTF-8 et GBK sont pris en charge.
New File Check Cycle
Si de nouveaux objets sont continuellement ajoutés au chemin S3 source, définissez le New File Check Cycle selon vos besoins. La tâche d'importation découvre et lit périodiquement les nouveaux objets. Chaque objet S3 est importé au maximum une fois.
Si aucun nouvel objet ne sera ajouté, sélectionnez Never Check. La tâche s'arrête après avoir importé tous les objets correspondants.
Log Time Configuration
Time Field
Si Data Format ou Single-line JSON est sélectionné comme Single-line JSON, vous pouvez spécifier un champ contenant l'horodatage. SLS utilise ce champ comme horodatage du journal.
Time Field Extraction Regular Expression
Vous pouvez utiliser une expression régulière pour extraire l'horodatage du contenu du journal.
Par exemple, si une entrée de journal type est 127.0.0.1 - - [10/Sep/2018:12:36:49 0800] "GET /index.html HTTP/1,1", vous pouvez définir l'Time Field Extraction Regular Expression sur
[0-9]{0,2}\/[0-9a-zA-Z]+\/[0-9:,]+.RemarquePour les autres formats de données, vous pouvez également utiliser une expression régulière pour extraire uniquement une partie d'un champ temporel.
Time Field Format
Le format utilisé pour analyser la valeur du champ temporel.
Prend en charge la syntaxe Java SimpleDateFormat, telle que
yyyy-MM-dd HH:mm:ss. Formats d'heure.Les formats Epoch sont pris en charge, notamment epoch, epochMillis, epochMicro et epochNano.
Time Zone
Sélectionnez le fuseau horaire pour le champ temporel. Un fuseau horaire n'est pas requis pour les formats epoch.
Pour prendre en compte l'heure d'été, sélectionnez un format UTC. Sinon, sélectionnez un format GMT.
RemarqueLe fuseau horaire par défaut est UTC+8.
Si vous sélectionnez Data Format comme Data Format, vous devez configurer les paramètres supplémentaires décrits dans le tableau suivant.
-
Paramètres spécifiques au CSV
Paramètre
Description
Delimiter
Le délimiteur utilisé pour séparer les champs. La valeur par défaut est une virgule (,).
Quote
Le caractère de guillemet utilisé pour les chaînes CSV.
Quote
Le caractère d'échappement utilisé pour échapper les caractères spéciaux. La valeur par défaut est une barre oblique inverse (\).
Maximum Lines
Si vous activez First Line as Field Name, la première ligne du fichier CSV est utilisée comme noms de champs.
Custom Fields
Si vous désactivez First Line as Field Name, vous devez spécifier des noms de champs personnalisés pour les journaux. Séparez plusieurs noms de champs par des virgules (,).
Lines to Skip
Le nombre de lignes de journal à ignorer au début du fichier. Par exemple, si vous définissez cette valeur sur 1, la collecte des données commence à partir de la deuxième ligne du fichier CSV.
-
Paramètres spécifiques aux journaux texte multilignes
Paramètre
Description
Position to Match Regular Expression
La position à laquelle faire correspondre l'expression régulière. Les options suivantes sont disponibles :
Regular Expression to Match First Line : Utilise une expression régulière pour faire correspondre la première ligne d'une entrée de journal. Les lignes non correspondantes sont considérées comme faisant partie de l'entrée de journal actuelle jusqu'à ce que le nombre maximal de lignes soit atteint.
Regular Expression to Match Last Line : Utilise une expression régulière pour faire correspondre la dernière ligne d'une entrée de journal. Les lignes non correspondantes sont considérées comme faisant partie de la prochaine entrée de journal jusqu'à ce que le nombre maximal de lignes soit atteint.
Regular Expression
L'expression régulière qui définit le début ou la fin d'une entrée de journal.
Maximum Lines
Le nombre maximal de lignes pour une seule entrée de journal.
Cliquez sur Preview pour vérifier le résultat de l'importation.
Après avoir confirmé les paramètres, cliquez sur Next.
-
-
Prévisualisez les données, créez un index, puis cliquez sur Next.
SLS active l'index en texte intégral par défaut. Vous pouvez également créer manuellement des index de champs ou cliquer sur Automatic Index Generation pour les générer automatiquement. Créer un index.
ImportantPour interroger et analyser les journaux, vous devez activer soit un index en texte intégral, soit un index de champ. Si les deux sont activés, l'index de champ est prioritaire.
Afficher la configuration d'importation
Consultez les détails de la configuration et les rapports statistiques dans la console.
Dans la liste des projets, cliquez sur le projet de destination.
Dans la section , recherchez le logstore de destination, choisissez , puis cliquez sur le nom de la configuration.
Affichez les informations de base et les rapports statistiques de la configuration d'importation.
-
Vous pouvez également modifier, démarrer, arrêter ou supprimer la configuration d'importation.
AvertissementCette opération est irréversible. Procédez avec prudence.
Facturation
SLS ne facture pas la fonctionnalité Data Import. Toutefois, des frais de transfert de données et de requêtes API peuvent s'appliquer de la part de votre fournisseur cloud. Le modèle suivant décrit les coûts potentiels. Reportez-vous à la facture de votre fournisseur pour connaître les frais réels.
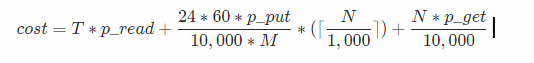
|
Champ |
Description |
|
T |
Volume total quotidien d'importation de données, en Go. |
|
p_read |
Coût par Go de trafic Internet sortant. |
|
p_put |
Coût par 10 000 requêtes PUT. |
|
p_get |
Coût par 10 000 requêtes GET. |
|
M |
Intervalle de vérification des nouveaux fichiers, en minutes. Vous pouvez définir le New File Check Cycle lors de la création de la configuration d'importation de données. |
|
N |
Le nombre d'objets listables dans le bucket qui correspondent au préfixe spécifié. |
FAQ
Problème | Cause possible | Solution |
L'aperçu n'affiche aucune donnée. | Il n'y a aucun objet dans le bucket S3, les objets ne contiennent aucune donnée ou aucun objet ne correspond aux conditions de filtre. |
|
Les données importées contiennent du texte illisible. | Les paramètres Data Format, Compression Format ou Encoding Format ne correspondent pas au fichier source. | Confirmez le format réel des objets S3, puis ajustez les paramètres Data Format, Compression Format ou Encoding Format en conséquence. Pour corriger les données illisibles existantes, vous devez créer un nouveau logstore et une nouvelle configuration d'importation. |
Les horodatages des journaux dans SLS ne correspondent pas aux horodatages des données source. | Le champ temporel du journal n'a pas été spécifié, ou le format d'heure ou le fuseau horaire a été configuré incorrectement dans la configuration d'importation. | Spécifiez le champ temporel du journal et définissez le format d'heure et le fuseau horaire corrects. Log Time Configuration. |
Les données ne peuvent pas être interrogées ou analysées après leur importation. |
|
|
Le nombre d'entrées de journal importées est inférieur aux attentes. | Les entrées de journal uniques supérieures à 3 Mo sont ignorées lors de l'importation (Limites de collecte de données). | Lors de l'écriture des données dans les fichiers S3, assurez-vous qu'une seule ligne de données ne dépasse pas 3 Mo. |
Certains fichiers ne sont pas importés. | Les conditions de filtre sont définies incorrectement, ou certains fichiers dépassent la limite de taille de 5 Go (Limites de collecte de données). |
|
Les journaux texte multilignes sont analysés incorrectement. | L'expression régulière pour faire correspondre la première ou la dernière ligne est incorrecte. | Vérifiez que l'expression régulière pour faire correspondre la première ou la dernière ligne est correcte. |
L'importation de nouveaux fichiers présente une latence élevée. | Trop d'objets existants correspondent au filtre de préfixe de chemin de fichier. | Si le nombre d'objets correspondant au filtre de préfixe de chemin de fichier est trop élevé (par exemple, plus d'un million), définissez un préfixe plus spécifique et créez plusieurs tâches d'importation. Sinon, la découverte de nouveaux fichiers est considérablement ralentie. |
Gestion des erreurs
|
Erreur |
Description |
|
Échec de lecture du fichier |
Si la lecture d'un fichier échoue en raison de problèmes réseau, de corruption ou d'autres erreurs, la tâche d'importation effectue jusqu'à trois tentatives avant d'ignorer le fichier. L'intervalle de nouvelle tentative est identique au New File Check Cycle. Si New File Check Cycle est défini sur Never Check, l'intervalle de nouvelle tentative est de 5 minutes. |
|
Erreur d'analyse du format de compression |
Si une erreur de format de compression invalide se produit lors de la décompression d'un fichier, la tâche d'importation ignore le fichier. |
|
Erreur d'analyse du format de données |
Lorsque l'analyse des données échoue, la tâche d'importation stocke le contenu textuel original dans le champ content du journal. |
|
Le bucket S3 n'existe pas |
La tâche d'importation effectue des nouvelles tentatives périodiquement. Après la recréation du bucket, la tâche d'importation reprend automatiquement. |
|
Erreur d'autorisation |
Si une erreur d'autorisation se produit lors de la lecture depuis S3 ou de l'écriture dans un logstore, la tâche d'importation effectue des nouvelles tentatives périodiquement et reprend après la correction des autorisations. Aucun fichier n'est ignoré lors d'une erreur d'autorisation. Une fois le problème résolu, la tâche importe tous les objets non traités. |