La fonctionnalité de transformation de données de Simple Log Service utilise des groupes de consommateurs pour ingérer et traiter les données de journal. Vous pouvez orchestrer plus de 200 fonctions intégrées afin de créer des règles de transformation. Cette rubrique explique comment les données sont planifiées lors de la transformation et comment le moteur de règles fonctionne.
Principes de base de la planification
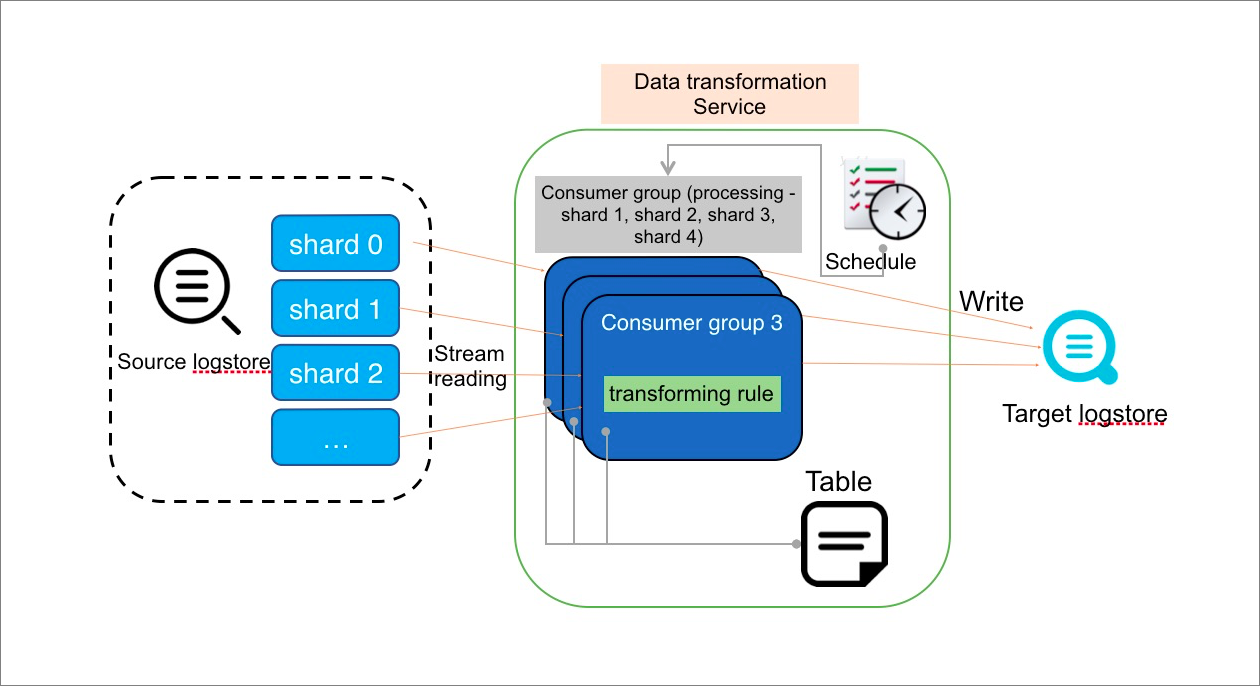
La fonctionnalité de transformation de données de Simple Log Service utilise un groupe de consommateurs pour ingérer les données de journal du Logstore source sous forme de flux. Elle traite chaque journal à l'aide d'une règle de transformation, puis produit le résultat.
-
Scheduling mechanism
Pour chaque règle de transformation, le planificateur démarre une ou plusieurs instances en cours d'exécution. Chaque instance agit en tant que consommateur pour un ou plusieurs shards du Logstore source. Le planificateur détermine le nombre d'instances parallèles en fonction de leur utilisation de la mémoire et du CPU. Le nombre maximal d'instances est égal au nombre de shards dans le Logstore source.
-
Running instance
Une instance en cours d'exécution lit les journaux source depuis les shards qui lui sont attribués, conformément à votre configuration. Elle traite les données à l'aide de la règle de transformation et produit le résultat dans le Logstore de destination. Les règles de transformation peuvent utiliser des ressources externes pour enrichir les données de journal. L'instance utilise le mécanisme de groupe de consommateurs pour enregistrer sa position de consommation dans un shard. Cela garantit que si l'instance s'arrête de manière inattendue, elle peut reprendre la consommation à partir du dernier point de contrôle enregistré.
-
Task stop
Si vous ne configurez pas d'heure de fin pour la tâche, les instances en cours d'exécution continuent de s'exécuter par défaut et la tâche de transformation de données ne s'arrête pas.
Si vous configurez une heure de fin pour la tâche, les instances en cours d'exécution traitent tous les journaux reçus jusqu'à cette heure. Ensuite, les instances se terminent automatiquement et la tâche de transformation de données s'arrête.
Si une tâche s'arrête pour une raison quelconque et est redémarrée, elle reprend la consommation à partir de la dernière position enregistrée par défaut.
Principes de base du moteur de règles : Opérations de base
Vous pouvez utiliser les fonctions intégrées fournies par le SLS DSL pour écrire des règles de transformation. Chaque fonction représente une étape de transformation et le moteur de règles exécute les fonctions séquentiellement.
e_set("log_type", "access_log")
e_drop_fields("__action")
e_if(e_search("ret: pass"), e_set("result", "pass"))
e_if(e_search("ret: unknown"), DROP)
La figure suivante illustre la logique.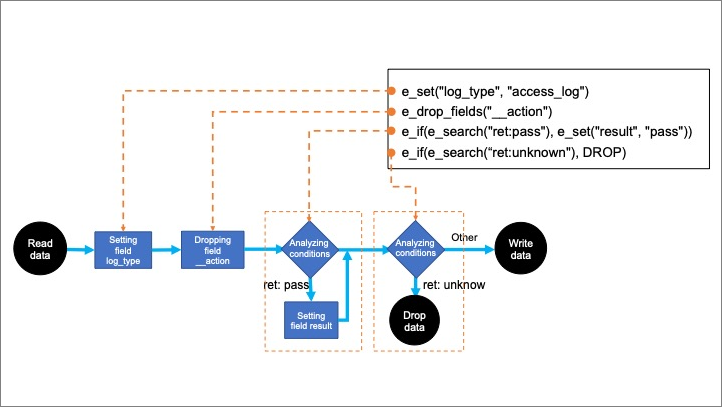
-
Logique de base
Chaque fonction d'événement dans une règle est exécutée séquentiellement. Chaque fonction traite et modifie un événement avant de transmettre l'événement modifié à la fonction suivante.
Par exemple,
e_set("log_type", "access_log")ajoute un champ nommélog_typeavec la valeur access_log à chaque événement. La fonction suivante reçoit alors l'événement mis à jour, qui inclut désormais le champlog_type. -
Logique conditionnelle
Les étapes peuvent comporter des conditions. Si un événement ne remplit pas une condition, il ignore l'opération de cette étape.
Par exemple, la fonction
e_if(e_search("ret: pass"), e_set("result", "pass"))vérifie d'abord si le champretcontient pass. Si la condition n'est pas remplie, aucune action n'est entreprise. Si la condition est remplie, la fonction définit la valeur du champresultsur pass. -
Arrêt du traitement
Si une étape renvoie zéro événement, l'événement est considéré comme supprimé.
Par exemple,
e_if(e_search("ret: unknown"), DROP)ignore les événements dont la valeur du champretest unknown. Une fois qu'un événement est ignoré, aucune opération ultérieure n'est effectuée sur celui-ci et le traitement commence sur l'événement suivant.
Principes de base du moteur de règles : Production, copie et fractionnement
Le moteur de règles prend également en charge la copie, la production et le fractionnement des événements.
e_coutput("archive_Logstore") )
e_split("log_type")
e_if(e_search("log_type: alert"), e_output("alert_Logstore") )
e_set("result", "pass")
Supposons que le journal source à traiter soit le suivant :
log_type: access,alert
content: admin login to database.
La figure suivante illustre la logique.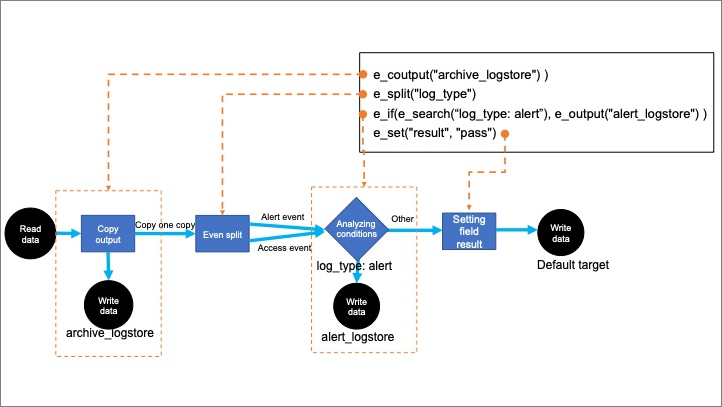
-
Production d'événement
Une opération de production peut être considérée comme un type spécial d'arrêt du traitement. Par exemple, à l'étape 3, si un événement possède un champ
log_typeavec la valeur alert, la fonctione_output("alert_Logstore")est appelée. Cette fonction produit l'événement vers la destination spécifiée, puis supprime l'événement. Les opérations ultérieures ne sont pas effectuées sur cet événement. -
Copie et production d'événement
La fonction
e_coutputcopie l'événement actuel et produit la copie. L'événement original continue vers l'étape de traitement suivante. Par exemple, à l'étape 1, tous les événements reçus sont copiés, puis produits vers la destinationarchive_Logstore. -
Fractionnement et traitement parallèle
À l'étape 2, si le champ
log_typecontient les valeurs access et alert,e_split("log_type")fractionne l'événement en deux événements distincts en fonction des valeurs du champlog_type. Les deux nouveaux événements sont identiques, à l'exception du champ log_type, qui aura la valeur access dans un événement et alert dans l'autre. Chaque nouvel événement poursuit ensuite indépendamment son parcours à travers les étapes suivantes.Après le fractionnement, chaque événement résultant poursuit indépendamment son parcours à travers les étapes suivantes.