Lorsqu'une seule clé TairSearch accumule trop de documents, son utilisation mémoire peut dépasser la capacité du shard de données, provoquant une erreur d'épuisement de la mémoire (OOM). La commande TFT.MSEARCH résout ce problème en permettant de diviser une clé volumineuse en clés plus petites réparties sur plusieurs shards de données, puis d'interroger l'ensemble en une seule requête. TairProxy diffuse la requête vers chaque shard en parallèle, puis note, trie et agrège les résultats avant de les renvoyer au client.
Types d'instances pris en charge
Nous vous recommandons d'utiliser TFT.MSEARCH avec des instances à séparation lecture/écriture ou des instances en cluster en mode proxy incluant TairProxy. Nous vous déconseillons d'utiliser TFT.MSEARCH avec des instances en cluster en mode de connexion directe ou des instances standard sans TairProxy.
Fonctionnement
TairSearch propose deux commandes de recherche :
| Commande | Portée |
|---|---|
TFT.SEARCH |
Interroge une seule clé |
TFT.MSEARCH |
Interroge plusieurs clés ayant la même configuration de schéma |
Chemin d'écriture
Lorsque le client envoie des requêtes d'écriture à TairProxy, ce dernier achemine chaque clé vers le shard de données approprié en fonction des slots de hachage.
Figure 1. Chemin d'écriture : distribution des clés vers les shards de données par TairProxy 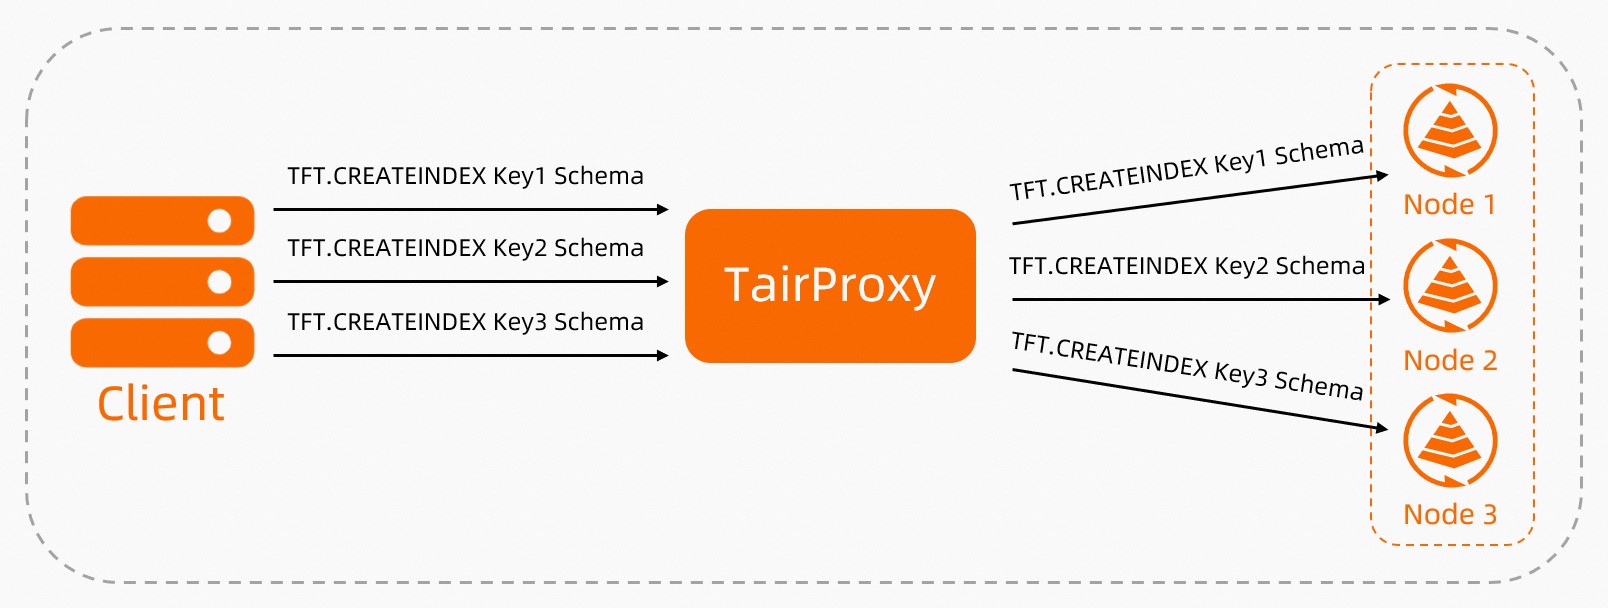
Chemin de lecture
Lorsque le client envoie une requête TFT.MSEARCH, TairProxy :
Transmet la requête à chaque shard de données contenant les clés demandées.
Chaque shard recherche dans ses clés et renvoie les documents correspondants.
TairProxy note, trie et agrège tous les résultats.
Renvoie l'ensemble de résultats final au client.
Figure 2. Chemin de lecture : TFT.MSEARCH across data shards 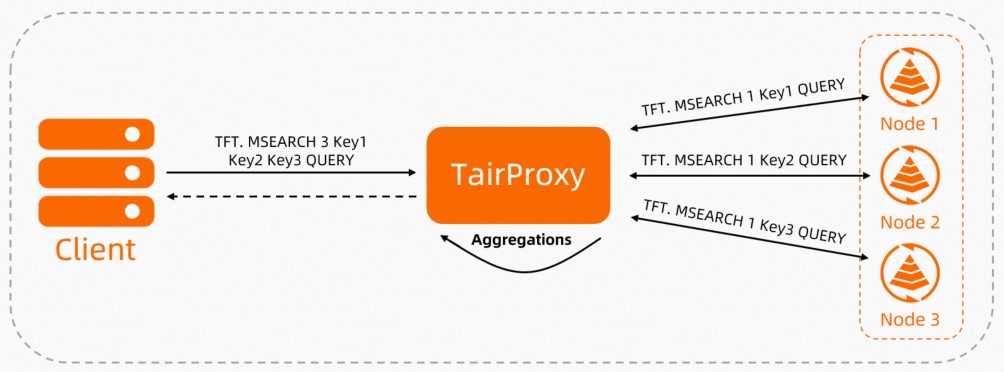
TFT.MSEARCH vous oblige à définir votre propre logique de fractionnement des clés. Tair ne distribue pas automatiquement les documents entre les clés. Vous contrôlez le routage des documents et la nomenclature des clés.
Prérequis
Avant d'utiliser TFT.MSEARCH :
Toutes les clés que vous souhaitez interroger doivent partager la même configuration de schéma (mêmes
mappingsetsettings).Vous avez divisé la clé volumineuse en plusieurs clés plus petites et les avez réparties sur les shards de données d'une instance en cluster. Si vous utilisez une instance autonome, commencez par la mettre à niveau vers une instance en cluster, puis divisez la clé volumineuse en petites clés et répartissez-les sur les shards de données.
Rechercher des documents sur plusieurs shards de données
Syntaxe de la commande
TFT.MSEARCH <num_keys> <key1> [key2 ...] '<JSON query>'Le premier argument après TFT.MSEARCH indique le nombre de clés à interroger. Cette valeur doit correspondre au nombre de noms de clés répertoriés. Le corps de la requête JSON utilise la même syntaxe que TFT.SEARCH.
Exemple : rechercher des données fréquentes sur des clés hebdomadaires
Cet exemple illustre l'utilisation de TFT.MSEARCH pour rechercher du contenu tendance stocké dans des clés partitionnées temporellement.
Configuration du scénario :
Chaque clé stocke une semaine de données fréquentes, soit environ 1 000 000 de documents par jour (7 000 000 par clé).
Une nouvelle clé est créée au début de chaque semaine et conservée pendant deux semaines. Les clés expirées sont supprimées.
Les noms de clés suivent le format
FLOW_<start_date>_<end_date>.Chaque document comporte quatre champs :
datetime(long),author(text),uid(long) etcontent(text, analysé avecjieba).
Étape 1 : Créer les index
Créez deux clés avec des configurations de schéma identiques. Le nom de la clé encode la plage de dates.
TFT.CREATEINDEX FLOW_20230109_15 '{
    "mappings": {
        "properties": {
            "datetime": {
                "type": "long"
            },
            "author": {
                "type": "text"
            },
            "uid": {
                "type": "long"
            },
            "content": {
                "type": "text",
                "analyzer": "jieba"
            }
        }
    }
}'

TFT.CREATEINDEX FLOW_20230116_23 '{
    "mappings": {
        "properties": {
            "datetime": {
                "type": "long"
            },
            "author": {
                "type": "text"
            },
            "uid": {
                "type": "long"
            },
            "content": {
                "type": "text",
                "analyzer": "jieba"
            }
        }
    }
}'
Étape 2 : Ajouter des documents
TFT.ADDDOC FLOW_20230109_15 '{
    "datetime": 20230109001209340,
    "author": "Hot TV series",
    "uid": 7884455,
    "content": "The movie will be screened during the Spring Festival"
}'

TFT.ADDDOC FLOW_20230116_23 '{
    "datetime": 20230118011304250,
    "author": "Fashionable commodities",
    "uid": 100093,
    "content": "Launch a new line of zodiac series products for the Year of the Rabbit"
}'
Étape 3 : Interroger les deux clés
Recherchez du contenu lié à « Chinese zodiac of the Year of the Rabbit » sur les deux clés, trié par date :
TFT.MSEARCH 2 FLOW_20230109_15 FLOW_20230116_23 '{
    "query": {
        "match": {
            "content": "Chinese zodiac of the Year of the Rabbit"
        }
    },
    "sort": [
        {"datetime": {"order": "desc"}}
    ],
    "size": 10,
    "reply_with_keys_cursor": true,
    "keys_cursor": {
        "FLOW_2023010916": 0,
        "FLOW_202301623": 0
    }
}'
Sortie attendue :
{
    "hits": {
        "hits": [
            {
                "_id": "20230118011304250",
                "_index": "FLOW_20230116_23",       // (1)
                "_score": 1,
                "_source": {
                    "datetime": 20230118011304250,
                    "author": "Fashionable commodities",
                    "uid": 100093,
                    "content": "Launch a new line of zodiac series products for the Year of the Rabbit"
                }
            }
        ],
        "max_score": 1,
        "total": {
            "relation": "eq",
            "value": 1
        }
    },
    "aux_info": {
        "index_crc64": 14159192555612760957,
        "keys_cursor": {                            // (2)
            "FLOW_20230109_15": 0,
            "FLOW_20230116_23": 1
        }
    }
}
(1) _index identifie la clé d'origine du document.
(2) aux_info.keys_cursor représente l'état de pagination pour la requête suivante. Une valeur de 0 signifie qu'aucun document de cette clé n'a été inclus dans cette page.
Pagination avec TFT.MSEARCH
TFT.SEARCH utilise from + size pour la pagination. TFT.MSEARCH emploie un mécanisme différent car les résultats proviennent de plusieurs clés indépendantes : size contrôle le nombre de documents à renvoyer, et keys_cursor suit la position au sein de chaque clé afin que la requête suivante reprenne là où la précédente s'est arrêtée.
Paramètres de pagination
| Paramètre | Type | Obligatoire | Description |
|---|---|---|---|
size |
integer | Oui | Nombre de documents à renvoyer dans cette page |
reply_with_keys_cursor |
boolean | Non | Définissez sur true pour inclure keys_cursor dans la réponse. Requis pour la pagination. |
keys_cursor |
object | Non | Position de départ au sein de chaque clé pour la requête suivante. Par défaut : 0 pour chaque clé (début). |
Fonctionnement de la pagination
Exécutez TFT.MSEARCH avec
sizeet"reply_with_keys_cursor": true. Tair récupèresizedocuments de chaque clé, puis les note, les trie et les agrège pour obtenir les meilleurs résultatssize.La réponse inclut un objet
keys_cursorqui enregistre le nombre de documents consommés depuis chaque clé pour produire cette page.Transmettez la valeur
keys_cursorde la réponse comme paramètrekeys_cursordans votre requête suivante. Tair reprend chaque clé à partir de la position enregistrée.
Exemple
Avec size=10 et trois clés (key0, key1, key2) :
Tair récupère 10 documents de chaque clé (30 au total), les note, les trie et renvoie les 10 meilleurs.
-
Supposons que les 10 meilleurs résultats proviennent des 2 premiers résultats de
key0, des 5 premiers dekey1et des 3 premiers dekey2. La réponse inclut :{"keys_cursor": {"key0": 2, "key1": 5, "key2": 3}} Dans la requête suivante, transmettez cette valeur
keys_cursor. Tair reprend à la position 3 danskey0, à la position 6 danskey1et à la position 4 danskey2.