Utilisez le mécanisme de pipeline Redis pour effectuer des opérations par lot ou améliorer les performances d'exécution des commandes. Le pipeline envoie plusieurs commandes au serveur simultanément, ce qui réduit la latence réseau et améliore les performances. Tair (Redis OSS-compatible) prend en charge le pipeline Redis natif.
Présentation du pipeline
En général, les clients et les serveurs Redis utilisent un mode d'interaction ping-pong. Dans ce mode, le client envoie une commande et attend la réponse du serveur avant d'envoyer la suivante.
Redis prend également en charge le mode pipeline. Ce mode fonctionne comme une chaîne de montage : le client envoie une commande sans attendre la réponse avant d'envoyer les suivantes. Une fois toutes les commandes envoyées, le client lit les réponses et les associe aux commandes d'origine dans l'ordre. Dans la plupart des implémentations clientes Redis du mode pipeline, les commandes sont envoyées par lot. Les résultats sont renvoyés à l'application une fois tous reçus.
La figure suivante illustre la communication réseau pour les modes ping-pong et pipeline.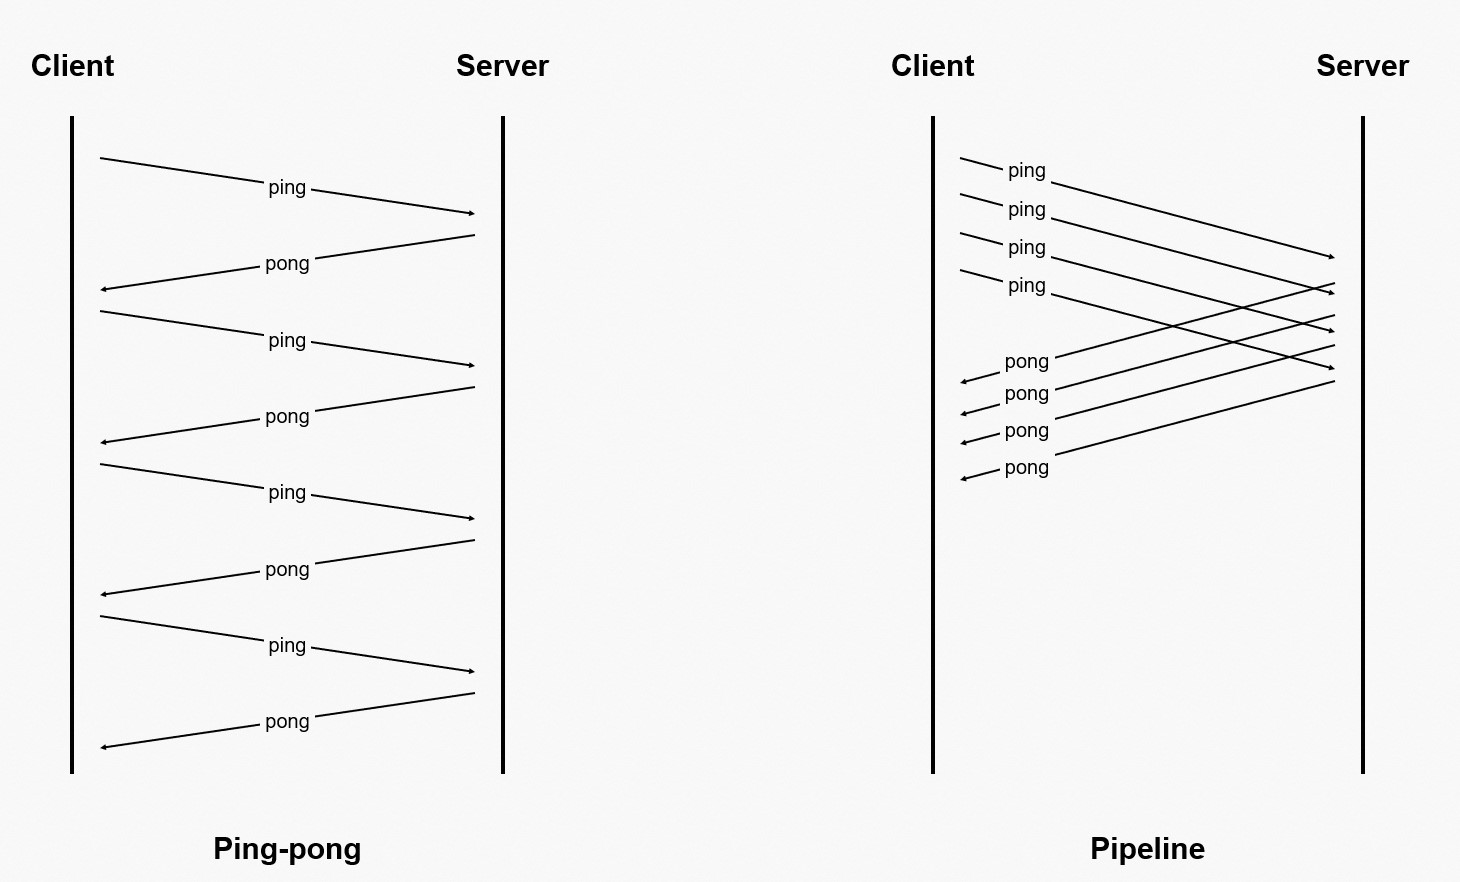
Le pipeline améliore l'efficacité et les performances des programmes en réduisant le temps aller-retour réseau (RTT). Il diminue également le nombre d'appels système read() et write() ainsi que les changements de contexte de processus.
Le pipeline s'avère très efficace dans certains scénarios. Par exemple, pour soumettre rapidement plusieurs commandes au serveur sans nécessiter de réponse immédiate pour chacune, utilisez le pipeline comme outil de traitement par lot afin d'optimiser les performances.
Lorsque vous utilisez le pipeline, le client utilise exclusivement la connexion au serveur. Pendant cette période, vous ne pouvez pas effectuer d'autres opérations hors pipeline tant que le pipeline n'est pas fermé. Pour effectuer d'autres opérations simultanément, créez une connexion distincte pour l'opération de pipeline afin de la séparer des opérations courantes.
Pour plus d'informations, consultez la rubrique Pipeline.
Précautions
-
Le pipeline ne garantit pas l'atomicité.
Le pipeline modifie uniquement la méthode d'envoi du client en un lot de commandes. Le serveur analyse toujours le flux de données en commandes individuelles et les exécute dans l'ordre. Chaque commande est indépendante. Cela signifie que le serveur peut exécuter des commandes provenant d'autres clients pendant ce processus. Pour garantir l'atomicité, utilisez des transactions ou des scripts Lua.
-
La restauration n'est pas prise en charge si une erreur se produit lors de l'exécution du pipeline.
Le pipeline ne possède pas les propriétés d'une transaction. N'utilisez pas le pipeline si les commandes à exécuter dépendent les unes des autres.
RemarqueCertains clients, tels que redis-py, utilisent les commandes de transaction MULTI et EXEC pour simuler un pipeline. Lorsque vous utilisez ces clients, tenez compte des différences entre le pipeline et les transactions. Sinon, des erreurs peuvent survenir. Pour plus d'informations sur les limites des transactions, consultez la rubrique Transactions.
Les serveurs et certains clients ont des limites de tampon. N'utilisez pas trop de commandes dans un seul pipeline.
-
Le pipeline est un mode d'interaction client-serveur indépendant de l'architecture du serveur. Par conséquent, les instances utilisant une architecture de cluster en mode proxy, une architecture de cluster en mode de connexion directe ou une architecture de répartition lecture/écriture prennent toutes en charge le pipeline.
RemarqueL'architecture de cluster a ses propres limites. Par exemple, elle ne prend pas en charge l'accès aux clés sur plusieurs slots dans une seule commande. Si vous essayez d'accéder à des données qui n'appartiennent pas au nœud actuel, une erreur
-MOVEDse produit. Lorsque vous utilisez le pipeline dans une architecture de cluster, assurez-vous que les commandes au sein du pipeline respectent les conditions d'exécution de l'architecture de cluster. Pour plus d'informations sur les limites, consultez la rubrique Limites des commandes pour les instances de cluster et de répartition lecture/écriture.
Exemples de code
Comparaison des performances
Le code suivant montre la différence de performance entre l'utilisation et la non-utilisation d'un pipeline.
package pipeline.kvstore.aliyun.com;
import java.util.Date;
import redis.clients.jedis.Jedis;
import redis.clients.jedis.Pipeline;
public class RedisPipelinePerformanceTest {
        static final String host = "xxxxxx.m.cnhza.kvstore.aliyuncs.com";
        static final int port = 6379;
        static final String password = "password";
        public static void main(String[] args) {
            Jedis jedis = new Jedis(host, port);
                // The password of the Tair instance
                String authString = jedis.auth(password);// password
                if (!authString.equals("OK")) {
                    System.err.println("AUTH Failed: " + authString);
                    jedis.close();
                    return;
                }
                // Run multiple commands consecutively.
                final int COUNT=5000;
                String key = "KVStore-Tanghan";
                // 1 ---Operation without a pipeline---
                jedis.del(key);// Initialize the key.
                Date ts1 = new Date();
                for (int i = 0; i < COUNT; i++) {
                    // Send a request and receive a response.
                    jedis.incr(key);
                }
                Date ts2 = new Date();
                System.out.println("Without pipeline > value is:"+jedis.get(key)+" > Time elapsed: " + (ts2.getTime() - ts1.getTime())+ "ms");
                //2 ----Comparison with a pipeline operation---
                jedis.del(key);// Initialize the key.
                Pipeline p1 = jedis.pipelined();
                Date ts3 = new Date();
                for (int i = 0; i < COUNT; i++) {
                    // Send the request.
                    p1.incr(key);
                }
                // Receive the response.
                p1.sync();
                Date ts4 = new Date();
                System.out.println("With pipeline > value is:"+jedis.get(key)+" > Time elapsed: " + (ts4.getTime() - ts3.getTime())+ "ms");
                jedis.close();
        }
    }
Après avoir saisi le point de terminaison et le mot de passe corrects pour l'instance Tair (Redis OSS-compatible) et exécuté le programme Java, le système renvoie la sortie suivante. Cette sortie montre que l'utilisation d'un pipeline est beaucoup plus rapide.
Without pipeline > value is:5000 > Time elapsed: 5844ms
With pipeline > value is:5000 > Time elapsed: 78ms
Comment gérer les données de réponse
Vous pouvez gérer les données de réponse d'un pipeline Jedis de deux manières. Pour plus d'informations, reportez-vous à l'exemple de code suivant.
package pipeline.kvstore.aliyun.com;
import java.util.List;
import redis.clients.jedis.Jedis;
import redis.clients.jedis.Pipeline;
import redis.clients.jedis.Response;
    public class PipelineClientTest {
        static final String host = "xxxxxxxx.m.cnhza.kvstore.aliyuncs.com";
        static final int port = 6379;
        static final String password = "password";
        public static void main(String[] args) {
            Jedis jedis = new Jedis(host, port);
                // Instance password
                String authString = jedis.auth(password);// password
                if (!authString.equals("OK")) {
                    System.err.println("AUTH Failed: " + authString);
                    jedis.close();
                    return;
                }
                String key = "KVStore-Test1";
                jedis.del(key);// Initialize
                // -------- Method 1
                Pipeline p1 = jedis.pipelined();
                System.out.println("-----Method 1-----");
                for (int i = 0; i < 5; i++) {
                    p1.incr(key);
                    System.out.println("Pipeline sends request");
                }
                // Requests sent. Start receiving responses.
                System.out.println("Requests sent. Start receiving responses.");
                List<Object> responses = p1.syncAndReturnAll();
                if (responses == null || responses.isEmpty()) {
                    jedis.close();
                    throw new RuntimeException("Pipeline error: No response received");
                }
                for (Object resp : responses) {
                    System.out.println("Pipeline receives response: " + resp.toString());
                }
                System.out.println();
                //-------- Method 2
                System.out.println("-----Method 2-----");
                jedis.del(key);// Initialize
                Pipeline p2 = jedis.pipelined();
                // You must declare the Response object first.
                Response<Long> r1 = p2.incr(key);
                System.out.println("Pipeline sends request");
                Response<Long> r2 = p2.incr(key);
                System.out.println("Pipeline sends request");
                Response<Long> r3 = p2.incr(key);
                System.out.println("Pipeline sends request");
                Response<Long> r4 = p2.incr(key);
                System.out.println("Pipeline sends request");
                Response<Long> r5 = p2.incr(key);
                System.out.println("Pipeline sends request");
                try{
                    r1.get();  // This operation fails because the client has not started to receive responses.
                }catch(Exception e){
                    System.out.println(" <<< Pipeline error: The client has not started to receive responses. >>> ");
                }
             // Requests sent. Start receiving responses.
                System.out.println("Requests sent. Start receiving responses.");
                p2.sync();
                System.out.println("Pipeline receives response: " + r1.get());
                System.out.println("Pipeline receives response: " + r2.get());
                System.out.println("Pipeline receives response: " + r3.get());
                System.out.println("Pipeline receives response: " + r4.get());
                System.out.println("Pipeline receives response: " + r5.get());
                jedis.close();
            }
    }
Après avoir saisi le point de terminaison et le mot de passe corrects pour l'instance Tair (Redis OSS-compatible) et exécuté le programme Java, le programme renvoie la sortie suivante :
-----Method 1-----
Pipeline sends request
Pipeline sends request
Pipeline sends request
Pipeline sends request
Pipeline sends request
Requests sent. Start receiving responses.
Pipeline receives response: 1
Pipeline receives response: 2
Pipeline receives response: 3
Pipeline receives response: 4
Pipeline receives response: 5

-----Method 2-----
Pipeline sends request
Pipeline sends request
Pipeline sends request
Pipeline sends request
Pipeline sends request
 <<< Pipeline error: The client has not started to receive responses. >>>
Requests sent. Start receiving responses.
Pipeline receives response: 1
Pipeline receives response: 2
Pipeline receives response: 3
Pipeline receives response: 4
Pipeline receives response: 5