Ce tutoriel explique comment construire un système de recherche multimodale à l'aide de TairVector et de Chinese-CLIP. Une fois ce tutoriel terminé, votre système pourra accepter une requête textuelle pour renvoyer les images correspondantes, ou recevoir une image pour retourner les descriptions textuelles associées.
Fonctionnement
La recherche multimodale est possible car CLIP encode à la fois les images et le texte dans un même espace vectoriel. Étant donné que les embeddings partagent un système de coordonnées commun, il est possible de mesurer directement la distance entre une requête textuelle et n'importe quelle image, sans avoir à traduire une modalité vers l'autre. Une requête telle que « un chien qui court » se situera à proximité des images de chiens en mouvement, même si ces images n'ont jamais été étiquetées avec cette expression exacte.
Chinese-CLIP est un modèle CLIP open source développé par DAMO Academy, basé sur les architectures Text Transformer et ResNet. Ce tutoriel utilise la variante RN50, qui génère des embeddings de 1 024 dimensions.
TairVector stocke ces embeddings et récupère les voisins les plus proches grâce à un algorithme de recherche des plus proches voisins approximatifs (ANN), soutenu par l'indexation HNSW. Pour en savoir plus sur TairVector, consultez la rubrique Vector.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Une instance Tair opérationnelle, avec son endpoint et son mot de passe
Python 3.8 ou version ultérieure
Un GPU compatible CUDA
-
Les packages Python suivants installés :
Chinese-CLIP s'installe depuis GitHub plutôt que depuis PyPI. Exécutez les deux commandes ci-dessus.
Package Objectif tairClient Python Tair pour les opérations TairVector torchEnvironnement d'exécution PyTorch requis par Chinese-CLIP PillowChargement et traitement des images matplotlibAffichage des images résultantes Chinese-CLIP Modèle d'embedding pour les images et le texte pip3 install tair torch Pillow matplotlib pip3 install git+https://github.com/OFA-Sys/Chinese-CLIP.git -
Des exemples de données :
Images : plus de 7 000 images d'animaux de compagnie issues du jeu de données Extreme Mart, téléchargées dans un répertoire local (par exemple,
/home/CLIP_Demo)Texte : trois exemples de descriptions — « a dog », « a white dog » et « a running white dog »
Étape 1 : Se connecter à Tair
Importez toutes les dépendances et définissez une fonction de connexion. Remplacez les valeurs de host et de password par celles de votre instance Tair. Pour les comptes personnalisés, définissez password au format username:password.
# -*- coding: utf-8 -*-
from tair import Tair
from tair.tairvector import DistanceMetric
from tair import ResponseError

from typing import List
import torch
from PIL import Image
import pylab
from matplotlib import pyplot as plt
import os
import cn_clip.clip as clip
from cn_clip.clip import available_models

def get_tair() -> Tair:
    """Connect to a Tair instance.
    * host: the endpoint of your Tair instance.
    * port: the port number. Default: 6379.
    * password: the password. For custom accounts, use the username:password format.
    """
    tair: Tair = Tair(
        host="r-8vbehg90y9rlk9****pd.redis.rds.aliyuncs.com",
        port=6379,
        db=0,
        password="D******3",
        decode_responses=True
    )
    return tair
Étape 2 : Créer les index vectoriels
Créez deux index HNSW : l'un pour les embeddings d'images et l'autre pour les embeddings de texte. Tous deux utilisent le produit intérieur (IP) comme métrique de distance et une dimension de 1 024 afin de correspondre à la sortie du modèle Chinese-CLIP RN50.
def create_index():
    """Create vector indexes for image and text embeddings.
    * Index names: index_images, index_texts
    * Vector dimension: 1024 (matches Chinese-CLIP RN50 output)
    * Distance metric: IP (inner product)
    * Index algorithm: HNSW
    """
    ret = tair.tvs_get_index("index_images")
    if ret is None:
        tair.tvs_create_index("index_images", 1024, distance_type="IP",
                              index_type="HNSW")
    ret = tair.tvs_get_index("index_texts")
    if ret is None:
        tair.tvs_create_index("index_texts", 1024, distance_type="IP",
                              index_type="HNSW")
Étape 3 : Générer et stocker les embeddings
Utilisez Chinese-CLIP pour encoder les images et le texte, puis stockez chaque embedding dans TairVector à l'aide de la commande TVS.HSET.
Embeddings d'images — le chemin d'accès à chaque fichier image devient la clé, et son vecteur de 1 024 dimensions devient la valeur :
def insert_images(image_dir):
    """Generate image embeddings with CLIP and store them in TairVector.
    Each image is stored as:
    * Index: index_images
    * Key: image file path (e.g., test/images/boxer_18.jpg)
    * Value: 1024-dimensional embedding vector
    """
    file_names = [f for f in os.listdir(image_dir) if (f.endswith('.jpg') or f.endswith('.jpeg'))]
    for file_name in file_names:
        image_feature = extract_image_features(image_dir + "/" + file_name)
        tair.tvs_hset("index_images", image_dir + "/" + file_name, image_feature)

def extract_image_features(img_name):
    """Extract a 1024-dimensional embedding from an image using CLIP."""
    image_data = Image.open(img_name).convert("RGB")
    infer_data = preprocess(image_data)
    infer_data = infer_data.unsqueeze(0).to("cuda")
    with torch.no_grad():
        image_features = model.encode_image(infer_data)
    image_features /= image_features.norm(dim=-1, keepdim=True)
    return image_features.cpu().numpy()[0]  # [1, 1024]
Embeddings de texte — chaque chaîne de texte devient la clé :
def upsert_text(text):
    """Generate a text embedding with CLIP and store it in TairVector.
    Each text is stored as:
    * Index: index_texts
    * Key: the text content (e.g., "a running dog")
    * Value: 1024-dimensional embedding vector
    """
    text_features = extract_text_features(text)
    tair.tvs_hset("index_texts", text, text_features)

def extract_text_features(text):
    """Extract a 1024-dimensional embedding from a text string using CLIP."""
    text_data = clip.tokenize([text]).to("cuda")
    with torch.no_grad():
        text_features = model.encode_text(text_data)
    text_features /= text_features.norm(dim=-1, keepdim=True)
    return text_features.cpu().numpy()[0]  # [1, 1024]
Il n'est pas nécessaire de stocker le texte ou l'image de la requête dans TairVector. Seuls les embeddings indexés doivent être stockés au préalable.
Étape 4 : Exécuter la recherche multimodale
Utilisez le paramètre topK pour contrôler le nombre de résultats à renvoyer. Une valeur de distance plus faible indique une similarité plus élevée.
Recherche texte vers image — convertit une requête textuelle en embedding, puis recherche dans l'index des images :
def query_images_by_text(text, topK):
    """Text-to-image search: find images that match a text description.
    Returns image keys and distance scores. Lower distance = higher similarity.
    """
    text_feature = extract_text_features(text)
    result = tair.tvs_knnsearch("index_images", topK, text_feature)
    for k, s in result:
        print(f'key : {k}, distance : {s}')
        img = Image.open(k.decode('utf-8'))
        plt.imshow(img)
        pylab.show()
Recherche image vers texte — convertit une image de requête en embedding, puis recherche dans l'index des textes :
def query_texts_by_image(image_path, topK=3):
    """Image-to-text search: find text descriptions that match an image.
    Returns text keys and distance scores. Lower distance = higher similarity.
    """
    image_feature = extract_image_features(image_path)
    result = tair.tvs_knnsearch("index_texts", topK, image_feature)
    for k, s in result:
        print(f'text : {k}, distance : {s}')
Exécuter le flux de travail complet
if __name__ == "__main__":
    # Connect to Tair and create vector indexes for images and texts.
    tair = get_tair()
    create_index()
    # Load the Chinese-CLIP model (RN50 variant).
    model, preprocess = clip.load_from_name("RN50", device="cuda", download_root="./")
    model.eval()

    # Store image embeddings. Replace the path with your dataset directory.
    insert_images("/home/CLIP_Demo")
    # Store text embeddings.
    upsert_text("a dog")
    upsert_text("a white dog")
    upsert_text("a running white dog")

    # Text-to-image search: find the top 3 images matching "a running dog".
    query_images_by_text("a running dog", 3)
    # Image-to-text search: find text descriptions matching the specified image.
    query_texts_by_image("/home/CLIP_Demo/boxer_18.jpg", 3)
Résultats
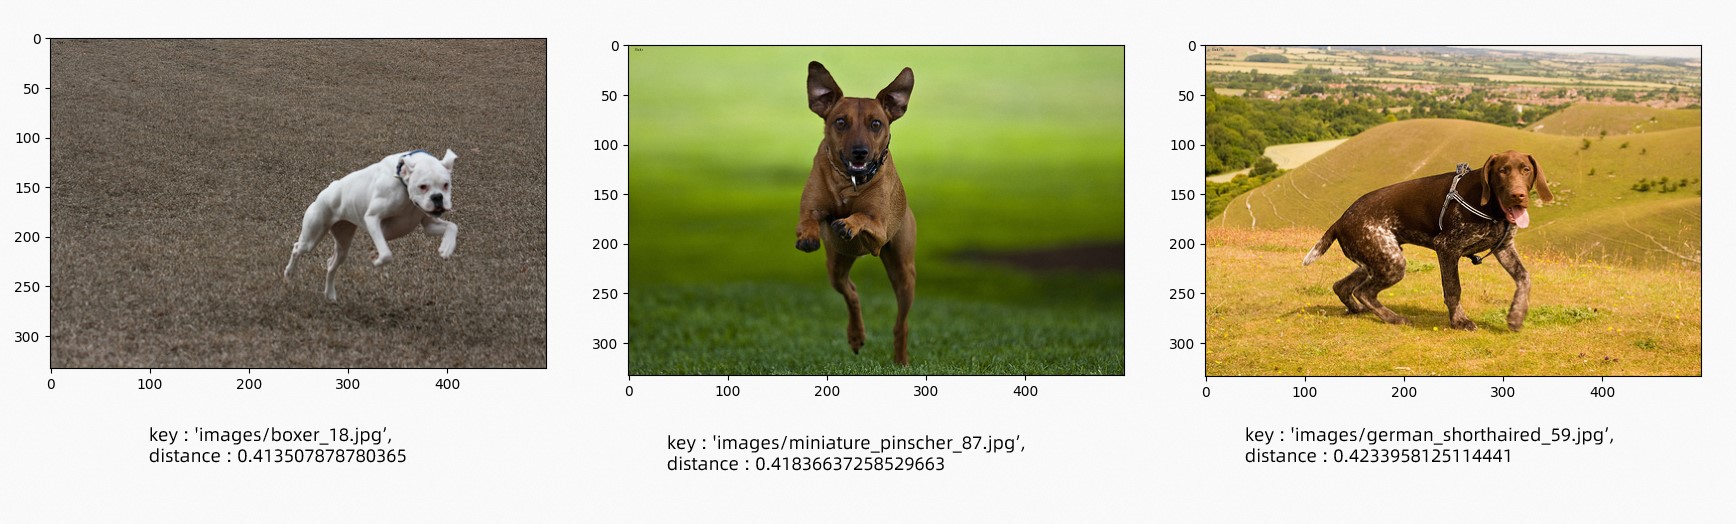
Recherche texte vers image — requête « a running dog », 3 premiers résultats :
Recherche image vers texte — image saisie :
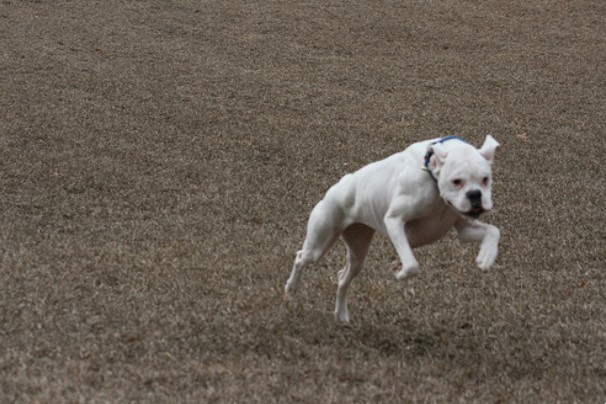
Résultats classés par similarité (distance la plus faible = similarité la plus élevée) :
{
  "results": [
    {
      "text": "a running white dog",
      "distance": "0.4052203893661499"
    },
    {
      "text": "a white dog",
      "distance": "0.44666868448257446"
    },
    {
      "text": "a dog",
      "distance": "0.4553511142730713"
    }
  ]
}
Étapes suivantes
Tair est une base de données en mémoire dotée d'une indexation HNSW intégrée, ce qui la rend particulièrement adaptée à la récupération de données en temps réel. Appliquez ce schéma à des cas d'utilisation tels que :
Recommandation de produits : acceptez une description textuelle et renvoyez les images de produits correspondantes
Légendage d'images : acceptez une image de produit et renvoyez des descriptions candidates
Modalités étendues : remplacez Chinese-CLIP par un autre modèle d'embedding pour prendre en charge la recherche vidéo-texte ou audio-texte