TairVector est un moteur de vecteurs en mémoire qui prend en charge les mises à jour d'index en temps réel et la recherche des k plus proches voisins (KNN) en quelques millisecondes. Ce tutoriel explique comment mettre en place un système de recherche de similarité de structures moléculaires sur TairVector en utilisant Python et RDKit, un flux de travail courant dans la découverte de médicaments assistée par IA et le criblage de composés.
Contexte
Le criblage de vastes bibliothèques de composés pour identifier des molécules structurellement similaires constitue une tâche fondamentale dans la découverte de médicaments. L'approche classique convertit chaque structure moléculaire, représentée au format SMILES, en un vecteur d'empreinte numérique de longueur fixe. Ces empreintes sont stockées dans un index vectoriel, permettant ensuite de récupérer les k structures les plus similaires pour une molécule donnée.
TairVector conserve toutes les données en mémoire et permet des mises à jour d'index en temps réel, ce qui lui confère une latence en lecture et en écriture inférieure à celle des solutions reposant sur le disque. Voici ses caractéristiques clés pour ce cas d'utilisation :
| Caractéristique | Description |
|---|---|
| Stockage en mémoire | Maintient l'intégralité de l'index d'empreintes moléculaires en RAM pour un accès à faible latence |
| Mises à jour d'index en temps réel | Les nouveaux composés peuvent être indexés sans reconstruire l'index depuis zéro |
Recherche KNN via TVS.KNNSEARCH |
Récupère les k structures les plus similaires en quelques millisecondes |
| k configurable | Ajustez le nombre de résultats renvoyés pour correspondre à votre pipeline de criblage |
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Une instance Tair. Notez son endpoint et son mot de passe.
Python 3.8 ou version ultérieure
-
Les dépendances Python suivantes installées :
pip install numpy rdkit tair matplotlib
Fonctionnement
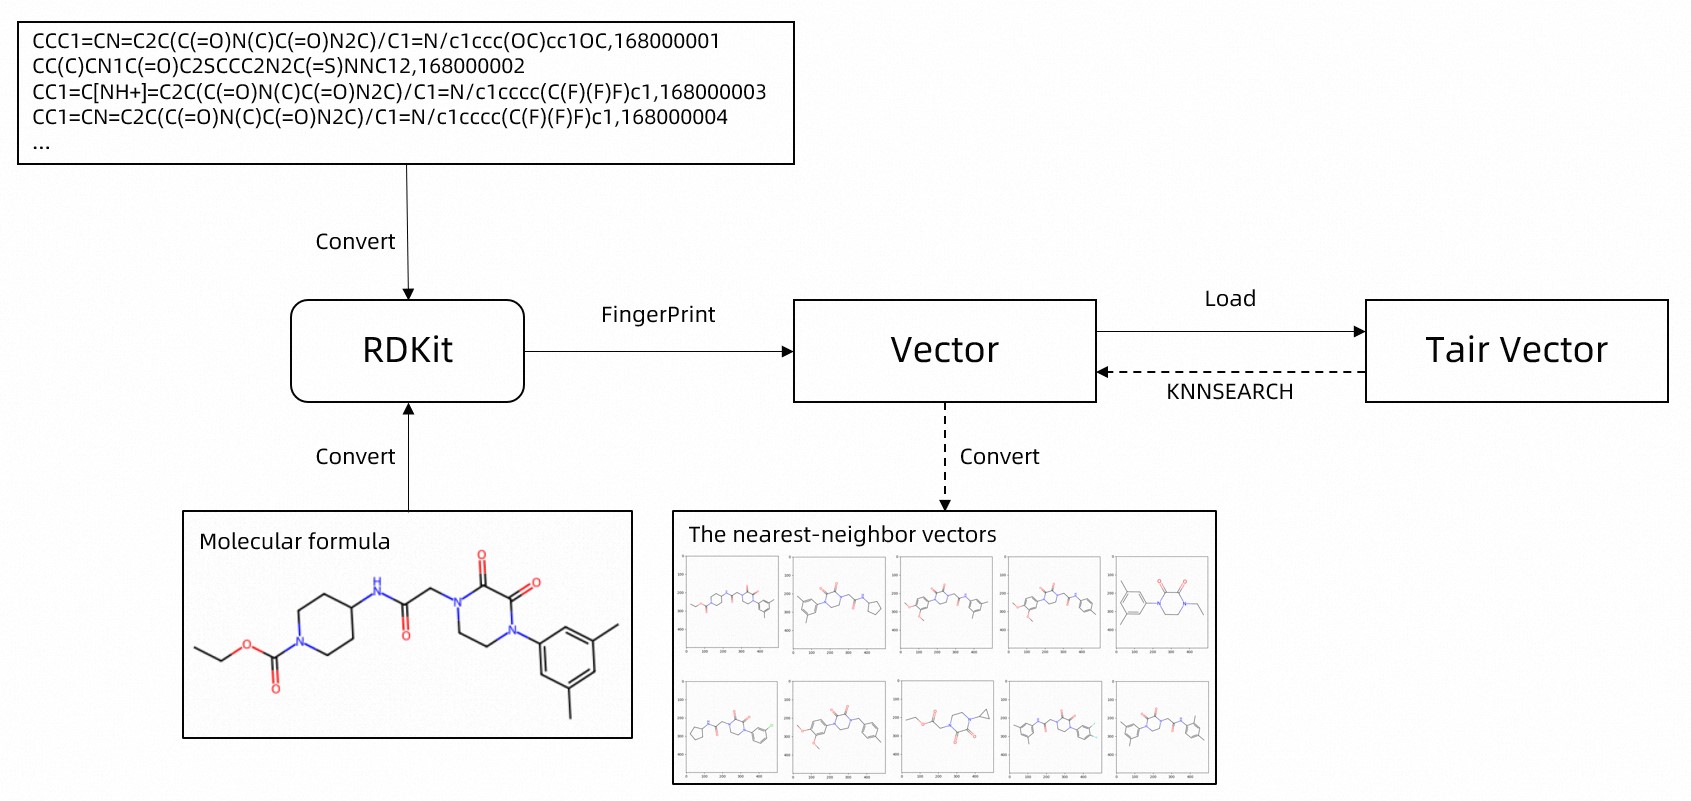
Le pipeline de bout en bout se compose de cinq étapes :
Téléchargez le jeu de données de structures moléculaires au format SMILES.jeu de données de structures moléculaires
Connectez-vous à une instance Tair.
Créez un index vectoriel pour stocker les empreintes moléculaires.
Convertissez chaque chaîne SMILES en un vecteur d'empreinte Morgan de 512 dimensions et écrivez-le dans l'index.
Interrogez l'index pour trouver les k structures les plus similaires à une molécule cible.
Les cinq étapes sont implémentées dans l'exemple de code ci-dessous. Chaque section détaille la fonction correspondante.
Étape 1 : Préparer le jeu de données
Téléchargez le jeu de données exemple depuis PubChem. Il contient 11 012 composés au format Simplified Molecular Input Line Entry System (SMILES), avec deux colonnes : la formule chimique et l'ID unique.
CCC1=CN=C2C(C(=O)N(C)C(=O)N2C)/C1=N/c1ccc(OC)cc1OC,168000001
CC(C)CN1C(=O)C2SCCC2N2C(=S)NNC12,168000002
CC1=C[NH+]=C2C(C(=O)N(C)C(=O)N2C)/C1=N/c1cccc(C(F)(F)F)c1,168000003
CC1=CN=C2C(C(=O)N(C)C(=O)N2C)/C1=N/c1cccc(C(F)(F)F)c1,168000004
Dans un environnement de production, chargez un jeu de données plus volumineux afin de tester les performances de récupération en quelques millisecondes de TairVector à grande échelle.
Si vos données sont au format Structure-Data File (SDF) provenant du serveur FTP PubChem, convertissez-les d'abord au format SMILES à l'aide de RDKit :
import sys
from rdkit import Chem

def converter(file_name):
    mols = [mol for mol in Chem.SDMolSupplier(file_name)]
    outname = file_name.split(".sdf")[0] + ".smi"
    out_file = open(outname, "w")
    for mol in mols:
        smi = Chem.MolToSmiles(mol)
        name = mol.GetProp("_Name")
        out_file.write("{},{}\n".format(smi, name))
    out_file.close()

if __name__ == "__main__":
    converter(sys.argv[1])
Étape 2 : Se connecter à une instance Tair
La fonction get_tair() établit une connexion à votre instance Tair. Remplacez les valeurs d'espace réservé par votre endpoint et votre mot de passe réels.
Évitez de coder en dur les identifiants dans votre code. Stockez l'endpoint et le mot de passe dans des variables d'environnement et lisez-les au moment de l'exécution à l'aide de os.environ.get() .
from tair import Tair

def get_tair() -> Tair:
    """
    Connect to the Tair instance.
    host: The endpoint of the Tair instance.
    port: The port number. Default is 6379.
    password: The password of the default account. To connect with a custom account, use 'username:password'.
    """
    tair: Tair = Tair(
        host="r-bp1mlxv3xzv6kf****pd.redis.rds.aliyuncs.com",
        port=6379,
        db=0,
        password="Da******3",
    )
    return tair
Étape 3 : Créer un index vectoriel
La fonction create_index() crée un index vectoriel nommé MOLSEARCH_TEST. Si l'index existe déjà, la création est ignorée.
def create_index():
    """
    Create a vector index named MOLSEARCH_TEST with the following parameters:
    - Dimensions: 512 (matches the Morgan fingerprint bit length)
    - Distance metric: L2 (Euclidean distance)
    - Index algorithm: HNSW (Hierarchical Navigable Small World)
    """
    ret = tair.tvs_get_index(INDEX_NAME)
    if ret is None:
        tair.tvs_create_index(INDEX_NAME, 512, distance_type=DistanceMetric.L2, index_type="HNSW")
    print("create index done")
La dimension du vecteur est définie sur 512 pour correspondre à la sortie desmiles_to_vector(), qui utiliseAllChem.GetMorganFingerprintAsBitVect(mol, radius=2, nBits=512*8). La métrique de distance L2 mesure la distance euclidienne entre les vecteurs d'empreintes ; un score plus faible indique une plus grande similarité structurelle.
Étape 4 : Écrire les données de structure moléculaire
La fonction do_load() lit le jeu de données SMILES, convertit chaque entrée en un vecteur de 512 dimensions à l'aide de la fonction smiles_to_vector() et écrit le résultat dans TairVector avec TVS.HSET via insert_data(). Les écritures sont regroupées par lots de 10 et soumises simultanément à l'aide de ThreadPoolExecutor.
Chaque entrée est stockée dans l'index comme suit :
| Champ | Valeur | Exemple |
|---|---|---|
| Clé | ID unique du composé | 168000001 |
| Vecteur | Empreinte Morgan de 512 dimensions | — |
Attribut : smiles |
Chaîne de formule chimique d'origine | CCC1=CN=C2... |
from concurrent.futures import ThreadPoolExecutor
from rdkit.Chem import AllChem
from rdkit import DataStructs, Chem
from rdkit import RDLogger
RDLogger.DisableLog('rdApp.*')

def do_load(file_path):
    num = 0
    lines = []
    with open(file_path, 'r') as f:
        for line in f:
            if line.find("smiles") >= 0:
                continue
            lines.append(line)
            if len(lines) >= 10:
                parallel_submit_lines(lines)
                num += len(lines)
                lines.clear()
                if num % 10000 == 0:
                    print("load num", num)
    if len(lines) > 0:
        parallel_submit_lines(lines)
    print("load done")

def parallel_submit_lines(lines):
    with ThreadPoolExecutor(len(lines)) as t:
        for line in lines:
            t.submit(handle_line, line=line)

def handle_line(line):
    if line.find("smiles") >= 0:
        return
    parts = line.strip().split(',')
    try:
        ids = parts[1]
        smiles = parts[0]
        vec = smiles_to_vector(smiles)
        insert_data(ids, smiles, vec)
    except Exception as result:
        print(result)

def smiles_to_vector(smiles):
    """Convert a SMILES string to a 512-dimensional Morgan fingerprint vector."""
    mols = Chem.MolFromSmiles(smiles)
    fp = AllChem.GetMorganFingerprintAsBitVect(mols, 2, 512 * 8)
    hex_fp = DataStructs.BitVectToFPSText(fp)
    vec = list(bytearray.fromhex(hex_fp))
    return vec

def insert_data(id, smiles, vector):
    """Write the vector and chemical formula to TairVector using TVS.HSET."""
    attr = {'smiles': smiles}
    tair.tvs_hset(INDEX_NAME, id, vector, **attr)
Étape 5 : Rechercher des structures moléculaires similaires
La fonction do_search() prend une molécule de requête au format SMILES et un entier k, convertit la requête en un vecteur d'empreinte et exécute TVS.KNNSEARCH sur l'index MOLSEARCH_TEST. Elle récupère ensuite la formule chimique de chaque résultat à l'aide de TVS.HMGET.
def do_search(search_smiles, k):
    """
    Query the index for the k most similar molecular structures.
    Returns unique IDs, L2 distance scores, and chemical formulas.
    """
    vector = smiles_to_vector(search_smiles)
    result = tair.tvs_knnsearch(INDEX_NAME, k, vector)
    print("The 10 molecular structures most similar to the query target are as follows:")
    for key, value in result:
        similar_smiles = tair.tvs_hmget(INDEX_NAME, key, "smiles")
        print(key, value, similar_smiles)
Exemple de code complet
RemplacezD:\Test\Compound_168000001_168500000.smidans l'appel àdo_load()par le chemin réel vers votre fichier de jeu de données téléchargé.
import os
import sys
from tair import Tair
from tair.tairvector import DistanceMetric
from rdkit.Chem import Draw, AllChem
from rdkit import DataStructs, Chem
from rdkit import RDLogger
from concurrent.futures import ThreadPoolExecutor
RDLogger.DisableLog('rdApp.*')

def get_tair() -> Tair:
    """
    Connect to the Tair instance.
    host: The endpoint of the Tair instance.
    port: The port number. Default is 6379.
    password: The password of the default account. To connect with a custom account, use 'username:password'.
    """
    tair: Tair = Tair(
        host="r-bp1mlxv3xzv6kf****pd.redis.rds.aliyuncs.com",
        port=6379,
        db=0,
        password="Da******3",
    )
    return tair

def create_index():
    """
    Create a vector index named MOLSEARCH_TEST:
    - Dimensions: 512
    - Distance metric: L2
    - Index algorithm: HNSW
    """
    ret = tair.tvs_get_index(INDEX_NAME)
    if ret is None:
        tair.tvs_create_index(INDEX_NAME, 512, distance_type=DistanceMetric.L2, index_type="HNSW")
    print("create index done")

def do_load(file_path):
    """
    Read the SMILES dataset, extract vector features, and write data to TairVector.
    Data is stored as: key=compound ID, vector=512-dim fingerprint, attribute smiles=chemical formula.
    """
    num = 0
    lines = []
    with open(file_path, 'r') as f:
        for line in f:
            if line.find("smiles") >= 0:
                continue
            lines.append(line)
            if len(lines) >= 10:
                parallel_submit_lines(lines)
                num += len(lines)
                lines.clear()
                if num % 10000 == 0:
                    print("load num", num)
    if len(lines) > 0:
        parallel_submit_lines(lines)
    print("load done")

def parallel_submit_lines(lines):
    with ThreadPoolExecutor(len(lines)) as t:
        for line in lines:
            t.submit(handle_line, line=line)

def handle_line(line):
    if line.find("smiles") >= 0:
        return
    parts = line.strip().split(',')
    try:
        ids = parts[1]
        smiles = parts[0]
        vec = smiles_to_vector(smiles)
        insert_data(ids, smiles, vec)
    except Exception as result:
        print(result)

def smiles_to_vector(smiles):
    """Convert a SMILES string to a 512-dimensional Morgan fingerprint vector."""
    mols = Chem.MolFromSmiles(smiles)
    fp = AllChem.GetMorganFingerprintAsBitVect(mols, 2, 512 * 8)
    hex_fp = DataStructs.BitVectToFPSText(fp)
    vec = list(bytearray.fromhex(hex_fp))
    return vec

def insert_data(id, smiles, vector):
    """Write the vector and chemical formula to TairVector using TVS.HSET."""
    attr = {'smiles': smiles}
    tair.tvs_hset(INDEX_NAME, id, vector, **attr)

def do_search(search_smiles, k):
    """
    Query the index for the k most similar molecular structures.
    Uses TVS.KNNSEARCH to find the nearest neighbors, then TVS.HMGET to retrieve their formulas.
    """
    vector = smiles_to_vector(search_smiles)
    result = tair.tvs_knnsearch(INDEX_NAME, k, vector)
    print("The 10 molecular structures most similar to the query target are as follows:")
    for key, value in result:
        similar_smiles = tair.tvs_hmget(INDEX_NAME, key, "smiles")
        print(key, value, similar_smiles)

if __name__ == "__main__":
    # Connect to Tair and create the molecular structure index.
    tair = get_tair()
    INDEX_NAME = "MOLSEARCH_TEST"
    create_index()
    # Load the sample dataset.
    do_load("D:\Test\Compound_168000001_168500000.smi")
    # Query the 10 structures most similar to the target compound.
    do_search("CCOC(=O)N1CCC(NC(=O)CN2CCN(c3cc(C)cc(C)c3)C(=O)C2=O)CC1", 10)
Résultats
Une exécution réussie produit une sortie similaire à la suivante :
create index done
load num 10000
load done
The 10 molecular structures most similar to the query target are as follows:
b'168000009' 0.0 ['CCOC(=O)N1CCC(NC(=O)CN2CCN(c3cc(C)cc(C)c3)C(=O)C2=O)CC1']
b'168003114' 29534.0 ['Cc1cc(C)cc(N2CCN(CC(=O)NC3CCCC3)C(=O)C2=O)c1']
b'168000210' 60222.0 ['COc1ccc(N2CCN(CC(=O)Nc3cc(C)cc(C)c3)C(=O)C2=O)cc1OC']
b'168001000' 61123.0 ['COc1ccc(N2CCN(CC(=O)Nc3ccc(C)cc3)C(=O)C2=O)cc1OC']
b'168003038' 64524.0 ['CCN1CCN(c2cc(C)cc(C)c2)C(=O)C1=O']
b'168003095' 67591.0 ['O=C(CN1CCN(c2cccc(Cl)c2)C(=O)C1=O)NC1CCCC1']
b'168000396' 70376.0 ['COc1ccc(N2CCN(Cc3ccc(C)cc3)C(=O)C2=O)cc1OC']
b'168002227' 71121.0 ['CCOC(=O)CN1CCN(C2CC2)C(=O)C1=O']
b'168000441' 73197.0 ['Cc1cc(C)cc(NC(=O)CN2CCN(c3ccc(F)c(F)c3)C(=O)C2=O)c1']
b'168000561' 73269.0 ['Cc1cc(C)cc(N2CCN(CC(=O)Nc3ccc(C)cc3C)C(=O)C2=O)c1']
Chaque ligne contient :
| Colonne | Description |
|---|---|
| Colonne 1 | ID du composé |
| Colonne 2 | Score de distance L2 (plus il est faible, plus la similarité est grande) |
| Colonne 3 | Formule chimique |
Le résultat avec un score de 0.0 correspond exactement à la molécule de requête.
Pour visualiser les structures récupérées sous forme d'images moléculaires, utilisez le code suivant :
import numpy
from rdkit.Chem import Draw
from rdkit import Chem
import matplotlib.pyplot as plt

def to_images(data):
    imgs = []
    for smiles in data:
        mol = Chem.MolFromSmiles(smiles)
        img = Chem.Draw.MolToImage(mol, size=(500, 500))
        imgs.append(img)
        plt.imshow(img)
        plt.show()
    return imgs

if __name__ == "__main__":
    images = to_images(["CCOC(=O)N1CCC(NC(=O)CN2CCN(c3cc(C)cc(C)c3)C(=O)C2=O)CC1"])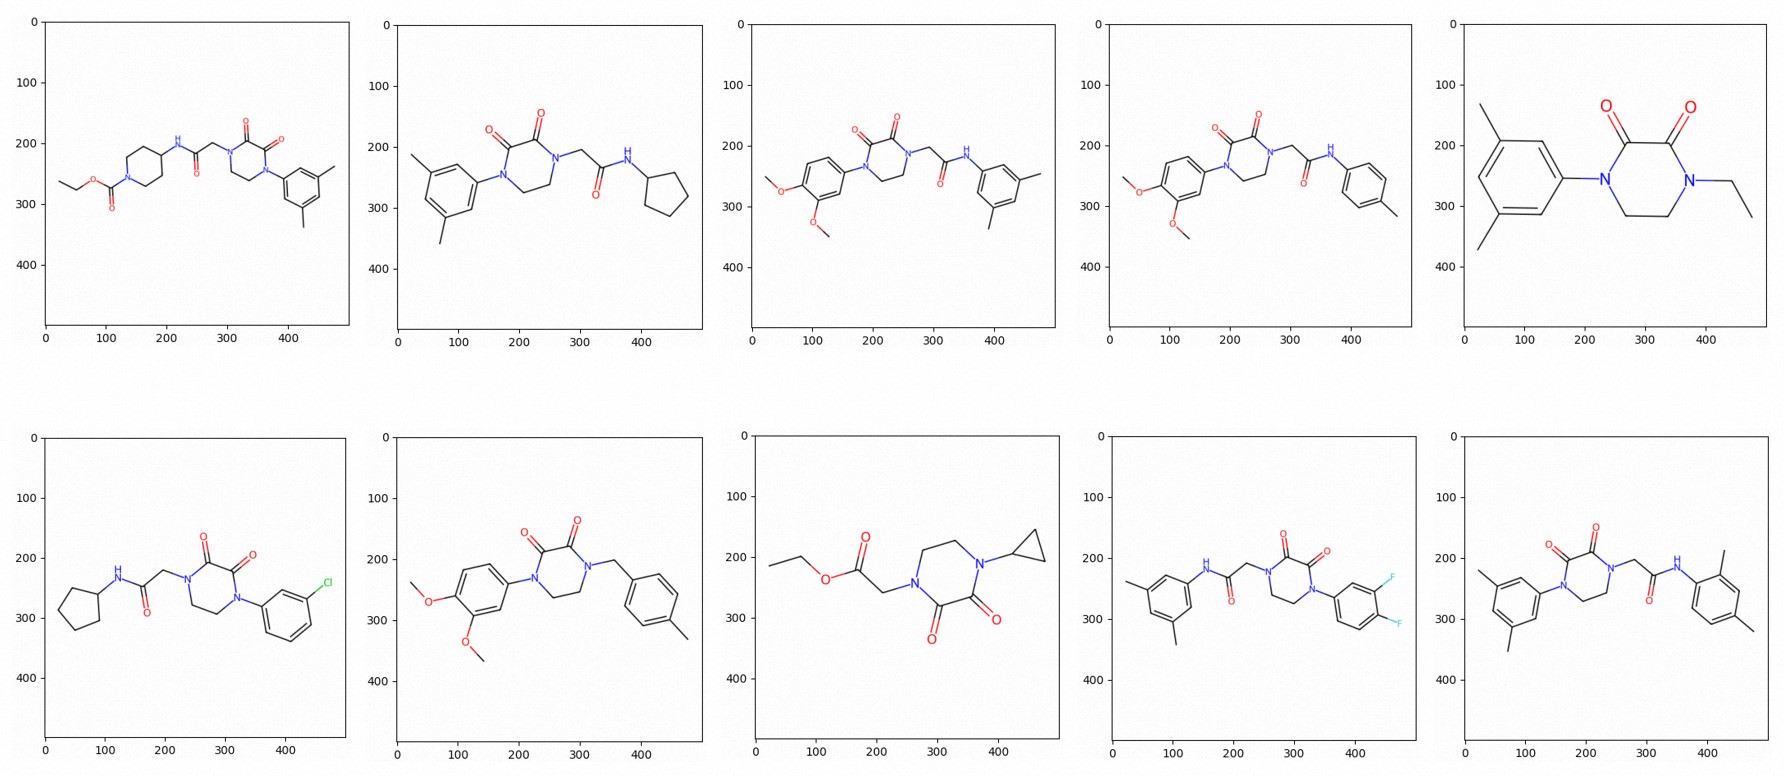
Étapes suivantes
Chargez votre bibliothèque complète de composés et testez les performances de récupération à grande échelle.
Ajustez le paramètre
kdansdo_search()pour contrôler le nombre de candidats renvoyés par le pipeline de criblage.