RDS for MySQL optimise la réplication parallèle afin d'éliminer le décalage de réplication lors du traitement des données par lots. Cette fonctionnalité s'avère particulièrement utile pour les opérations de suppression, d'organisation ou d'importation par lots effectuées pendant les heures creuses.
Applicabilité
Votre instance de base de données doit répondre à l'une des exigences de version suivantes :
RDS for MySQL 8.4
RDS for MySQL 8.0 avec une version mineure du moteur 20251130 ou ultérieure
Activation
Pour activer cette fonctionnalité, définissez le paramètre global suivant sur l'instance principale ou sur une instance en lecture seule.
Nom du paramètre :
loose_optimize_replica_parallelismValeur :
ONEffet : Le paramètre prend effet immédiatement. Aucun redémarrage de l'instance n'est nécessaire.
Contexte
De nombreuses applications exécutent des opérations de données, telles que la suppression, l'organisation et l'importation, par petits lots à forte concurrence pendant les heures creuses. Cette approche rapide vous permet d'ajuster la taille des lots et le niveau de concurrence afin de maîtriser l'impact sur la base de données.
Lors du traitement des données par lots, deux types principaux de transactions coexistent sur l'instance : des transactions de taille moyenne issues des travaux par lots, qui traitent généralement des milliers de lignes par transaction, et de petites transactions provenant des opérations métier courantes. Même pendant les heures creuses, un certain trafic métier régulier persiste. Ces deux types de transactions s'entrelacent dans le fichier binlog. Si plusieurs petites transactions modifiant la même ligne sont intercalées entre deux transactions de taille moyenne, ces dernières ne peuvent pas s'exécuter simultanément.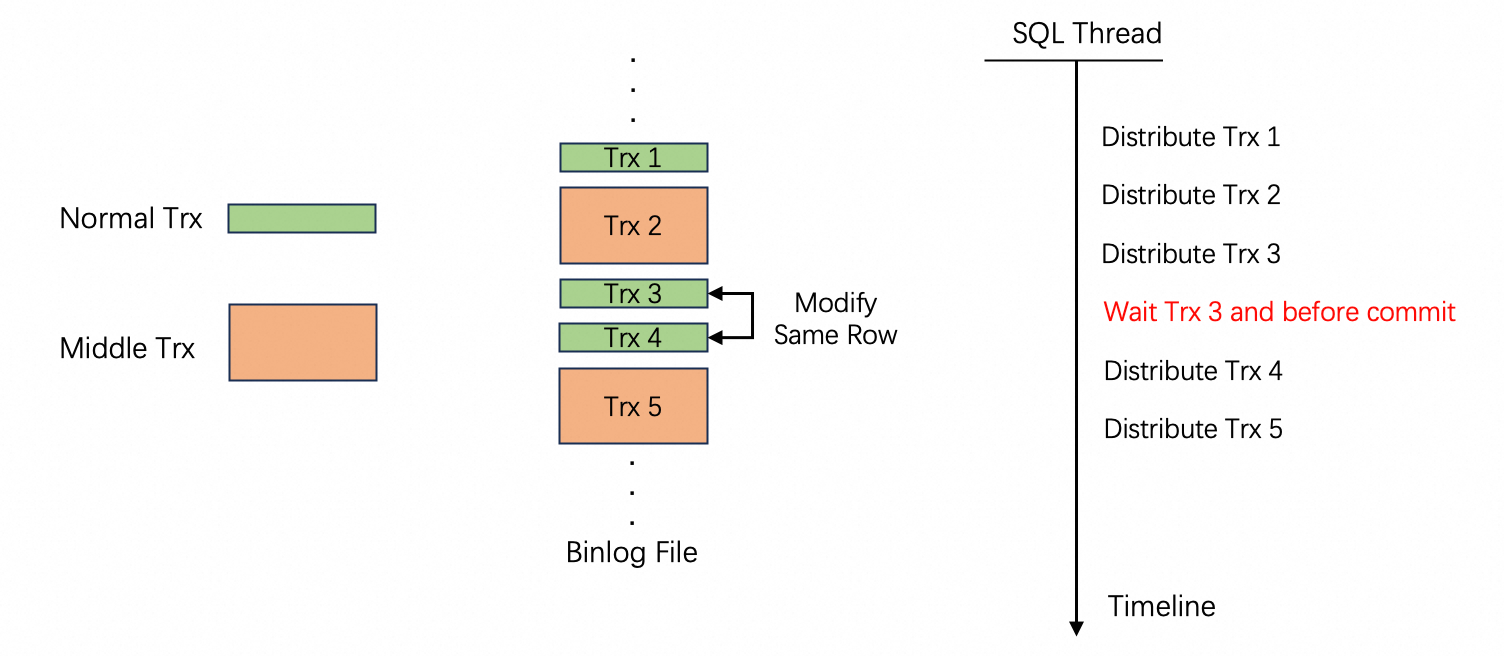
Comme illustré ci-dessus, Trx2 et Trx5 sont des transactions de taille moyenne issues d'un processus par lots. Trx3 et Trx4 sont de petites transactions provenant des opérations métier courantes qui modifient la même ligne. Lorsque le thread SQL distribue ces transactions, Trx2 et Trx3 le sont normalement. Toutefois, Trx4 doit attendre la validation de Trx3 et de toutes les transactions précédentes avant que le thread SQL ne puisse la distribuer. Cela retarde la distribution de Trx5 jusqu'à la validation de Trx2, empêchant ainsi l'application parallèle de Trx2 et Trx5.
Par conséquent, la concurrence des réplicas est très faible lors du traitement des données par lots. Parfois, un seul thread de travail est actif, ce qui réduit la réplication à des performances monofilaires et entraîne un décalage important.
Résultats
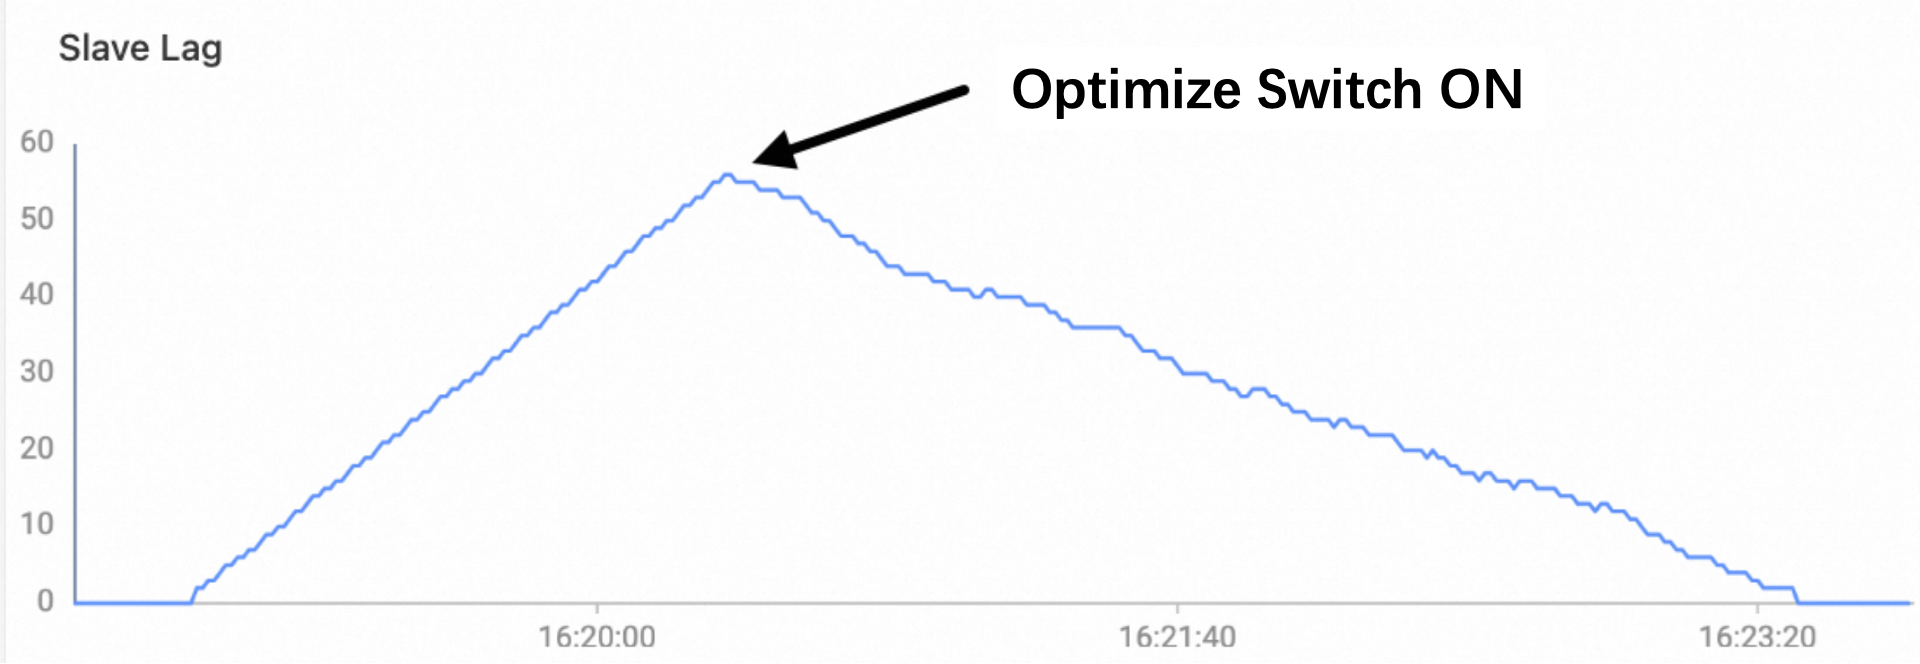
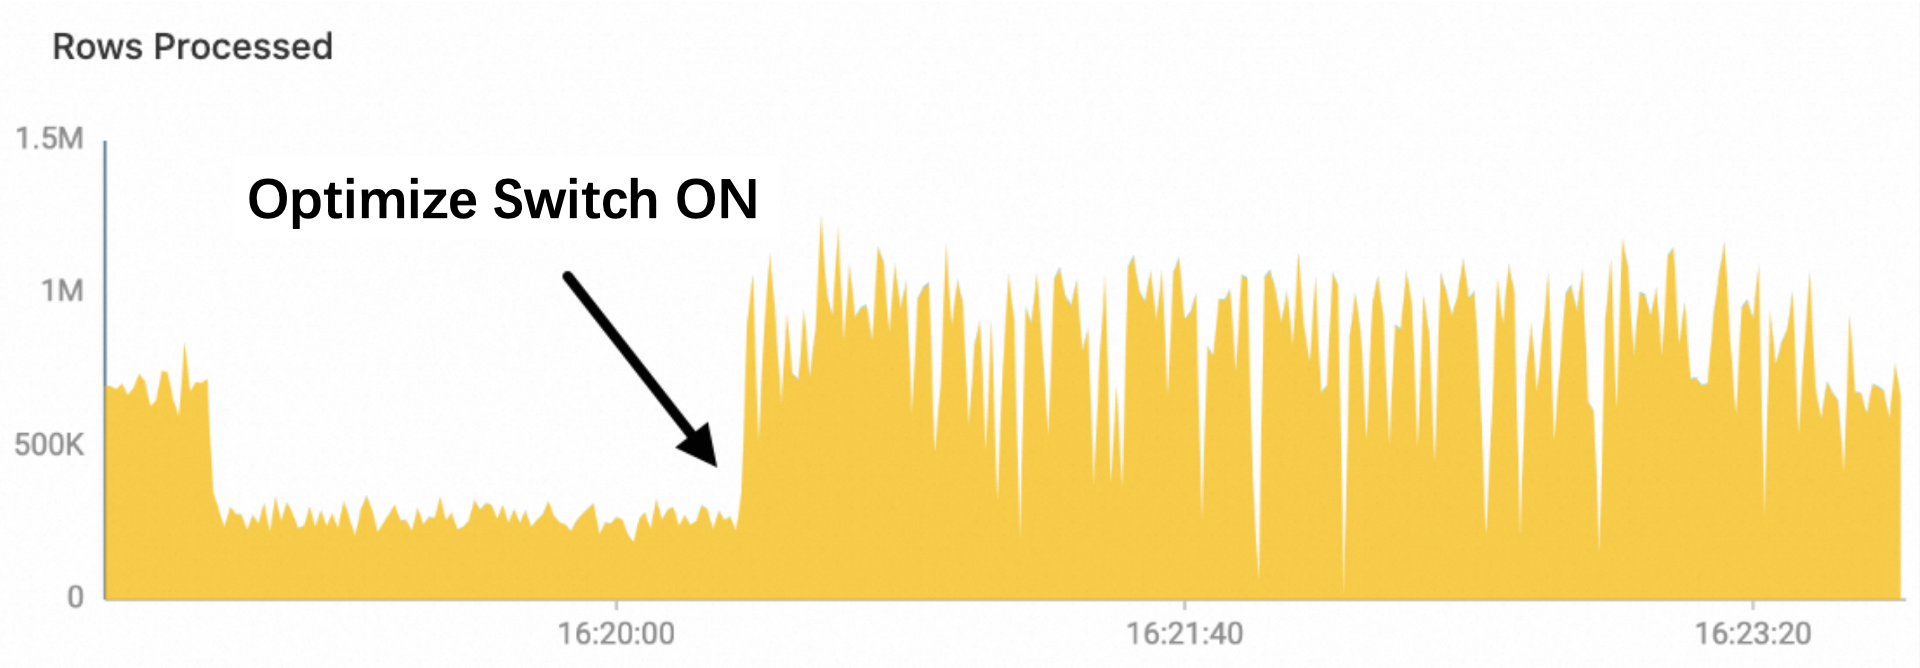
Le test suivant utilise la suppression de données par lots pour démontrer l'amélioration apportée. Un script sysbench en écriture seule monofil simulait de petites transactions en arrière-plan, tandis que huit threads concurrents supprimaient des données par lots de 5 000 lignes. Les graphiques ci-dessus montrent le décalage de réplication sur une instance en lecture seule. Avant l'activation de la fonctionnalité, le débit des réplicas était faible et le décalage de réplication augmentait régulièrement. Après l'activation, le débit a considérablement augmenté et le décalage de réplication a diminué jusqu'à la synchronisation du réplica.
Fonctionnement
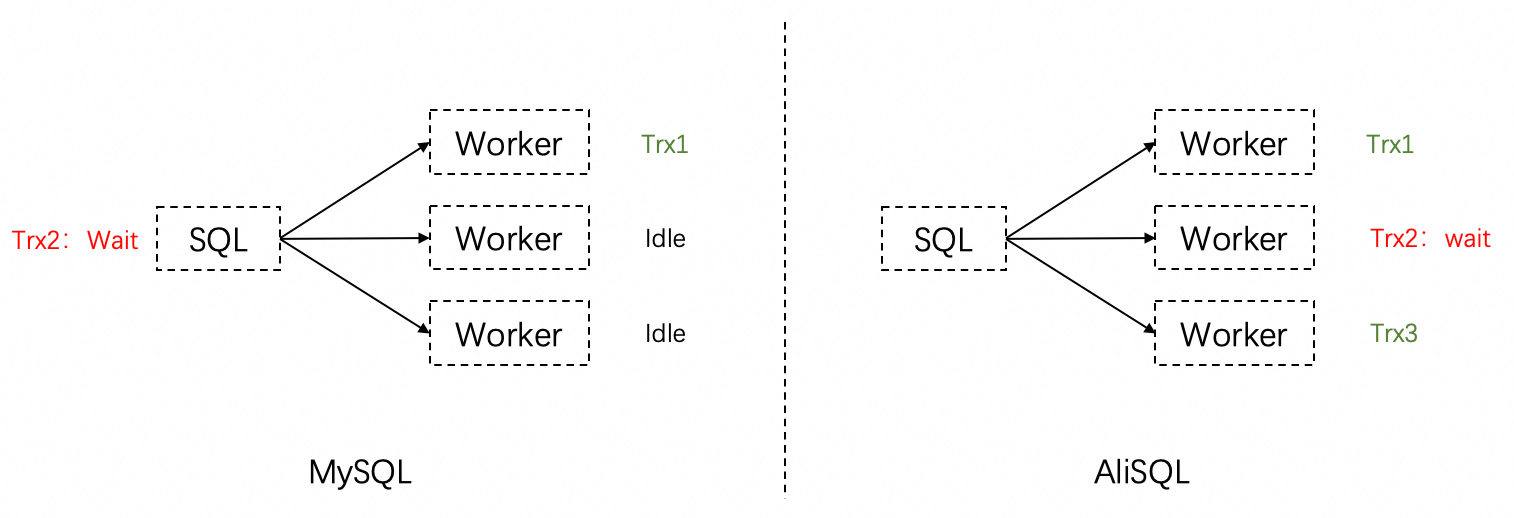
Grâce à cette optimisation, les petites transactions conflictuelles situées entre des transactions de taille moyenne attendent dans leurs threads de travail la validation des dépendances, au lieu d'attendre dans le thread SQL. Le thread SQL ne bloque plus la distribution des autres transactions, ce qui permet aux transactions de taille moyenne non conflictuelles de s'exécuter en parallèle.