Qu'est-ce qu'un modèle relationnel ?
Présentation du modèle relationnel
Le modèle relationnel de Quick BI est un framework de modélisation des données conçu pour les jointures multi-tables et l'analyse. Il résout les principaux problèmes liés à la modélisation physique traditionnelle — inefficacité, inexactitude et flexibilité analytique limitée — ce qui en fait une solution idéale pour l'analyse multidimensionnelle dans des scénarios métier complexes.
Avec un modèle relationnel, il vous suffit de placer les tables associées sur le canevas et de configurer les clés de jointure. Aucune gestion des données bas niveau ni spécification explicite du type de jointure n'est requise.
Ce modèle améliore l'efficacité de la modélisation tout en garantissant l'exactitude des données. Quick BI ajuste dynamiquement le SQL de la requête en fonction des champs et des configurations de relations au moment de l'exécution, assurant ainsi des résultats précis. Pour plus d'informations, consultez la rubrique Fonctionnement du modèle relationnel.
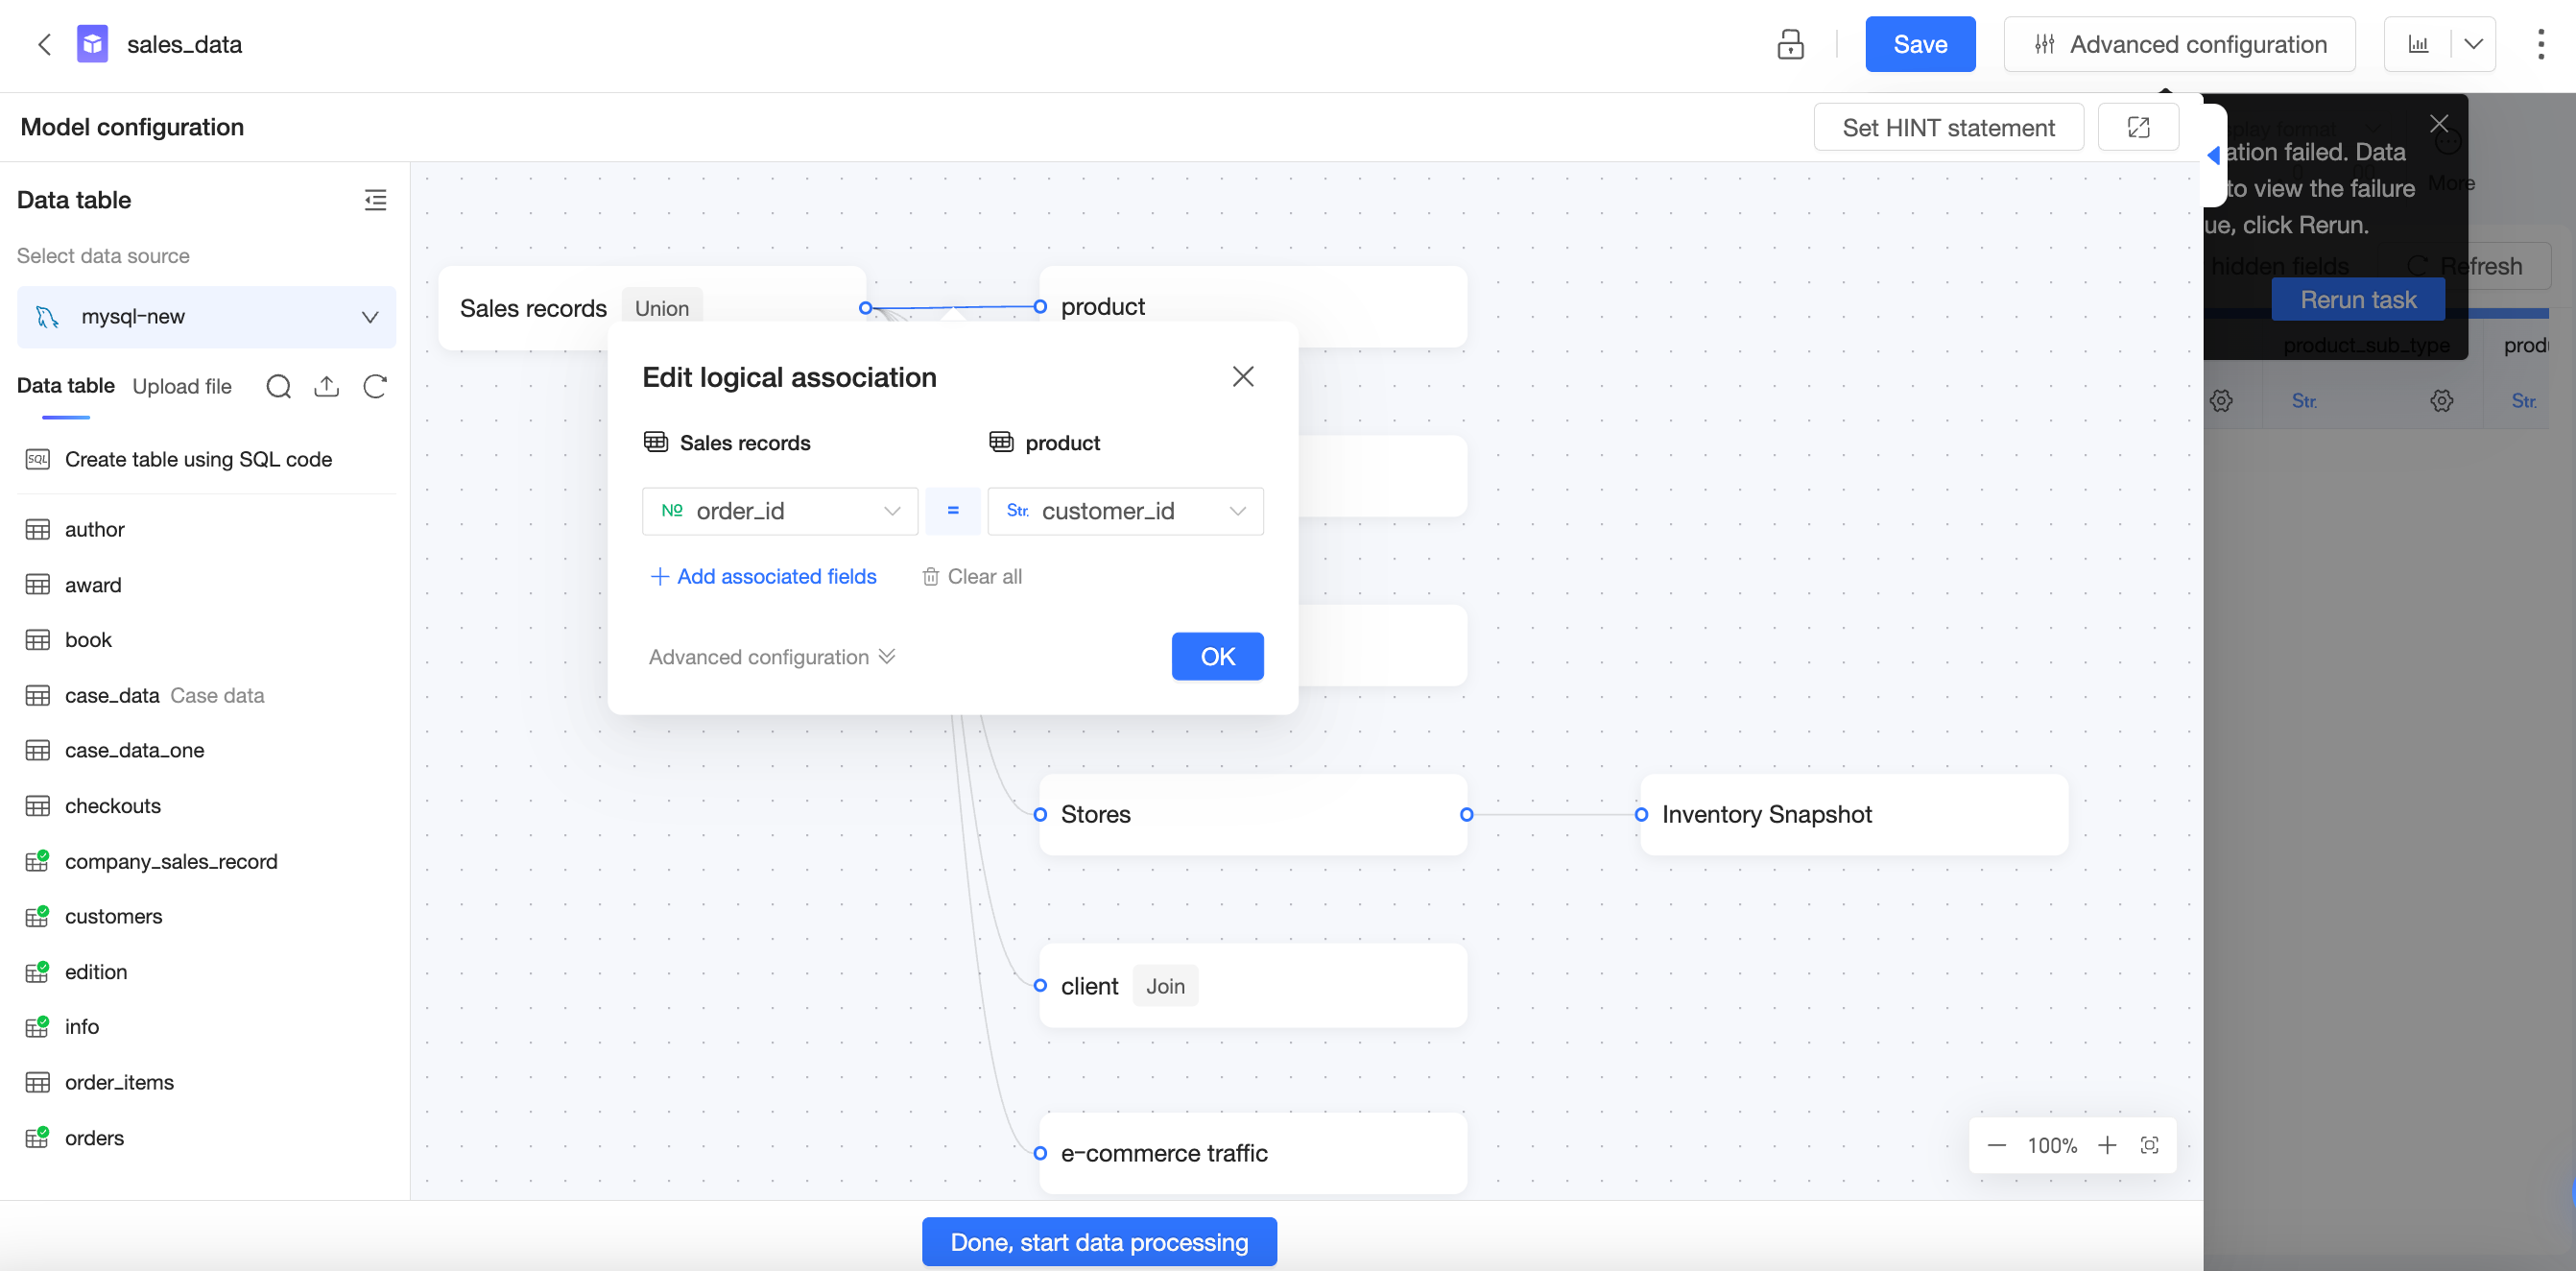
Valeur principale du modèle relationnel
Contexte et défis
Dans les versions précédentes de Quick BI, les tables étaient connectées à l'aide de jointures physiques (left join, full join, etc.) afin de générer une seule table large. Étant donné que les jointures physiques peuvent dupliquer les données, les utilisateurs devaient connaître à l'avance l'exhaustivité et l'unicité de leurs données. Les tables sources nécessitaient parfois un prétraitement, tel qu'une pré-agrégation. Cette approche rendait la modélisation physique complexe, coûteuse et sujette aux erreurs.
Pour relever ces défis, Quick BI introduit le modèle relationnel, qui ajoute des capacités de modélisation des relations par-dessus la modélisation physique existante. Cela améliore l'efficacité et la flexibilité des modèles de données complexes.
Avantages
Modélisation des données simplifiée : Définissez les clés de jointure sans spécifier les types de jointure. Le modèle relationnel gère automatiquement les connexions et garantit l'intégrité des données.
Prévention de la duplication des données : Aucun prétraitement des données n'est nécessaire lorsque les granularités diffèrent. Le modèle relationnel résout automatiquement les duplications pour garantir l'exactitude des calculs.
Prise en charge de davantage de cas d'usage analytiques avec moins de modèles : Un modèle relationnel complet peut remplacer plusieurs modèles spécifiques à certains scénarios, réduisant ainsi le nombre d'ensembles de données et simplifiant la maintenance.
Pour plus d'informations, consultez la rubrique Avantages du modèle relationnel.
Comparaison entre les modèles physiques et relationnels
|
Modèle physique |
Modèle relationnel |
|
|
|
|
Problèmes :
|
Solutions :
|
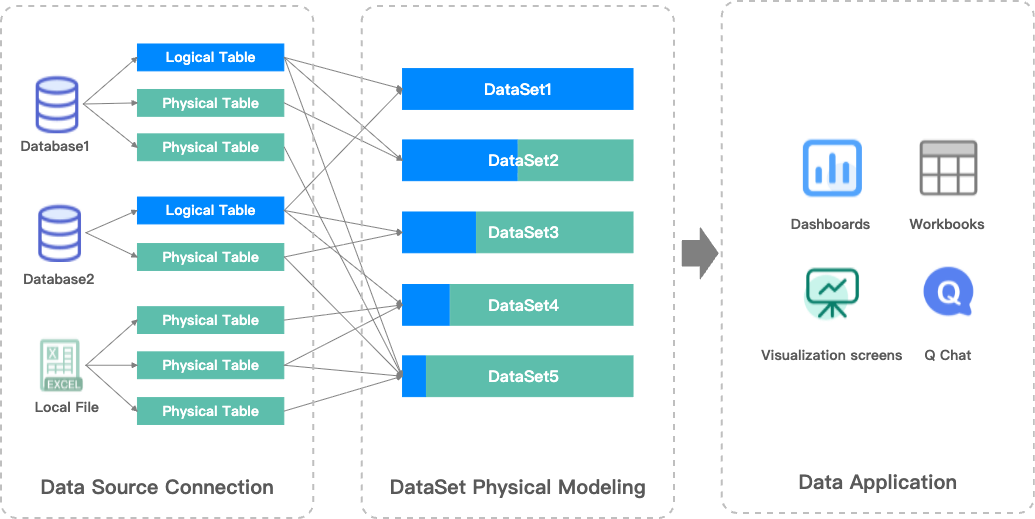
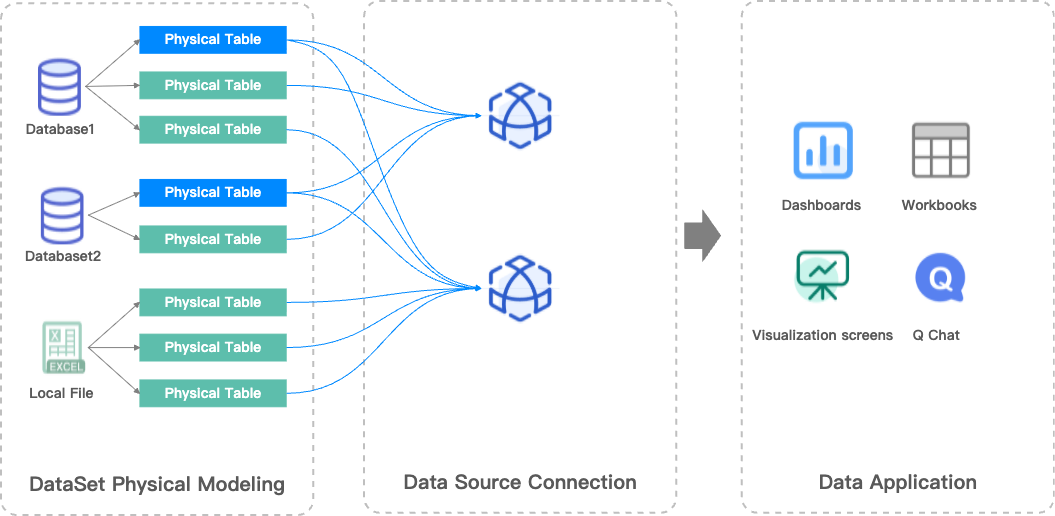
Concepts clés
Tables de faits et tables de dimensions
Les tables de faits et les tables de dimensions sont deux types courants de tables dans la modélisation des données.
Table de faits : Stocke des mesures métier quantifiables et contient des données liées aux événements métier (faits). Par exemple, sur une plateforme d'éducation en ligne, une table de faits peut inclure le nombre d'étudiants ayant terminé un cours, les notes moyennes aux tests et le temps total d'étude.
Table de dimensions : Stocke des attributs descriptifs et contient des données liées au contexte métier (dimensions). Par exemple, une table de dimensions peut inclure le type de cours, le niveau scolaire de l'étudiant, le nom de l'instructeur et la date d'étude.
Les tables de faits et les tables de dimensions sont liées par des champs communs. Cela permet de connecter les dimensions et les mesures lors des requêtes pour effectuer une analyse multidimensionnelle.
Exemple
Tables de faits
Commandes
|
ID de commande |
Date |
ID de produit |
Quantité |
Montant |
|
1 |
2025-12-01 |
A |
1 |
50 |
|
2 |
2025-12-01 |
A |
2 |
100 |
|
3 |
2025-12-01 |
B |
3 |
60 |
|
4 |
2025-12-02 |
C |
1 |
10 |
Enregistrements d'inventaire
|
Date |
ID de produit |
Inventaire |
|
2025-12-01 |
A |
10 |
|
2025-12-01 |
B |
20 |
|
2025-12-01 |
C |
5 |
|
2025-12-02 |
C |
4 |
Table de dimensions
|
ID de produit |
Nom du produit |
Catégorie |
Marque |
|
A |
Mouchoirs Breeze (Carton) |
Fournitures ménagères |
Breeze |
|
B |
Chemises M&G (Ensemble) |
Papeterie |
M&G |
|
C |
Crevettes Oishi (Grand sachet) |
Alimentation |
Oishi |
Couches de la modélisation des données
Un modèle de données définit les relations entre les tables, indiquant à Quick BI comment interroger vos tables de base de données.
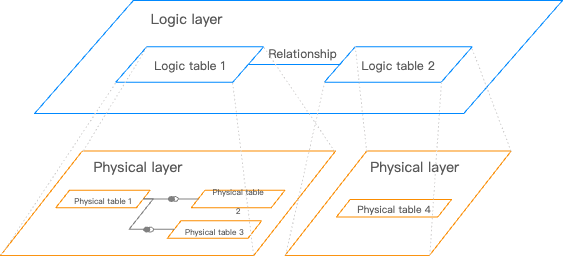
Couche logique et couche physique
Le modèle de données Quick BI comporte deux couches :
-
Couche logique :
Lorsque vous ouvrez le canevas de modélisation des données, vous voyez d'abord la couche logique. Dans la plupart des cas, vous n'avez besoin de travailler que dans cette couche.
Les relations (lignes reliant les tables) définissent la manière dont les nœuds sont liés. Chaque nœud est une table logique, qu'il s'agisse d'une table unique, d'une requête SQL personnalisée ou d'une table large créée par des jointures physiques ou des unions sur plusieurs tables ou requêtes SQL personnalisées.
La modélisation dans la couche logique construit le modèle de données complet.
-
Couche physique :
À partir de n'importe quelle table logique, vous pouvez accéder à son canevas physique (la couche physique).
La couche physique utilise des jointures et des unions physiques traditionnelles pour définir les relations entre plusieurs tables physiques. Chaque nœud correspond à une table de base de données ou à une requête SQL personnalisée.
La modélisation dans la couche physique crée une table large fixe, qui devient ensuite un nœud logique unique dans la couche logique.
|
Couche logique |
Couche physique |
|
Lignes de relation |
Diagrammes de Venn |
|
|
|
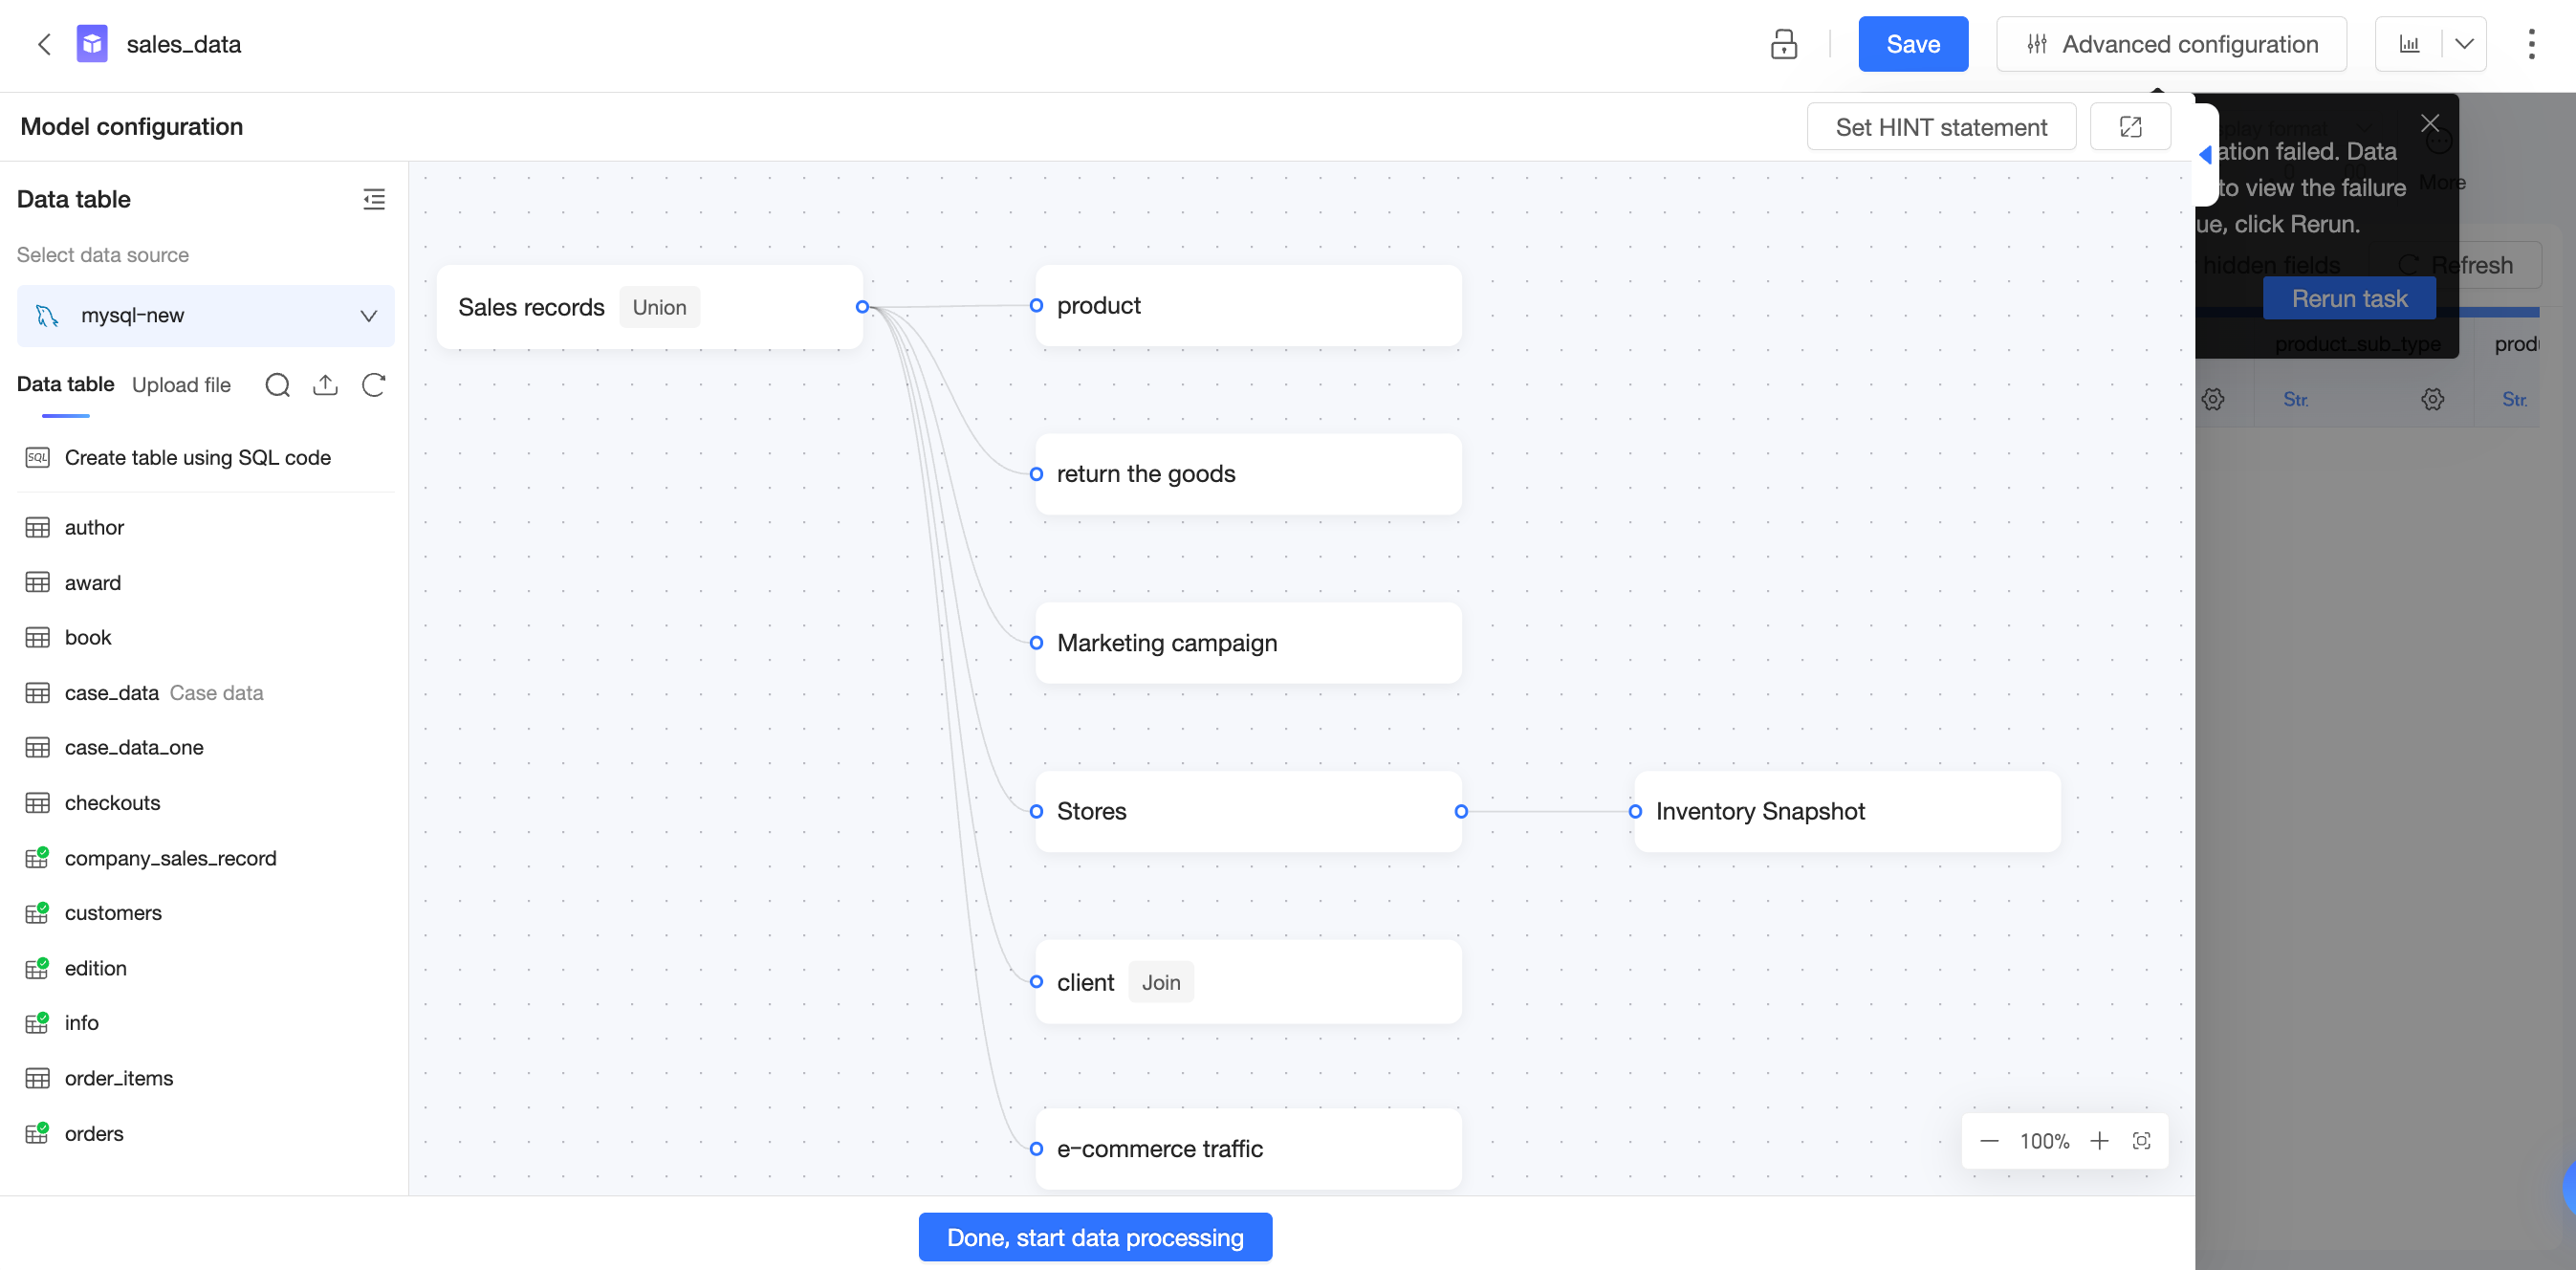
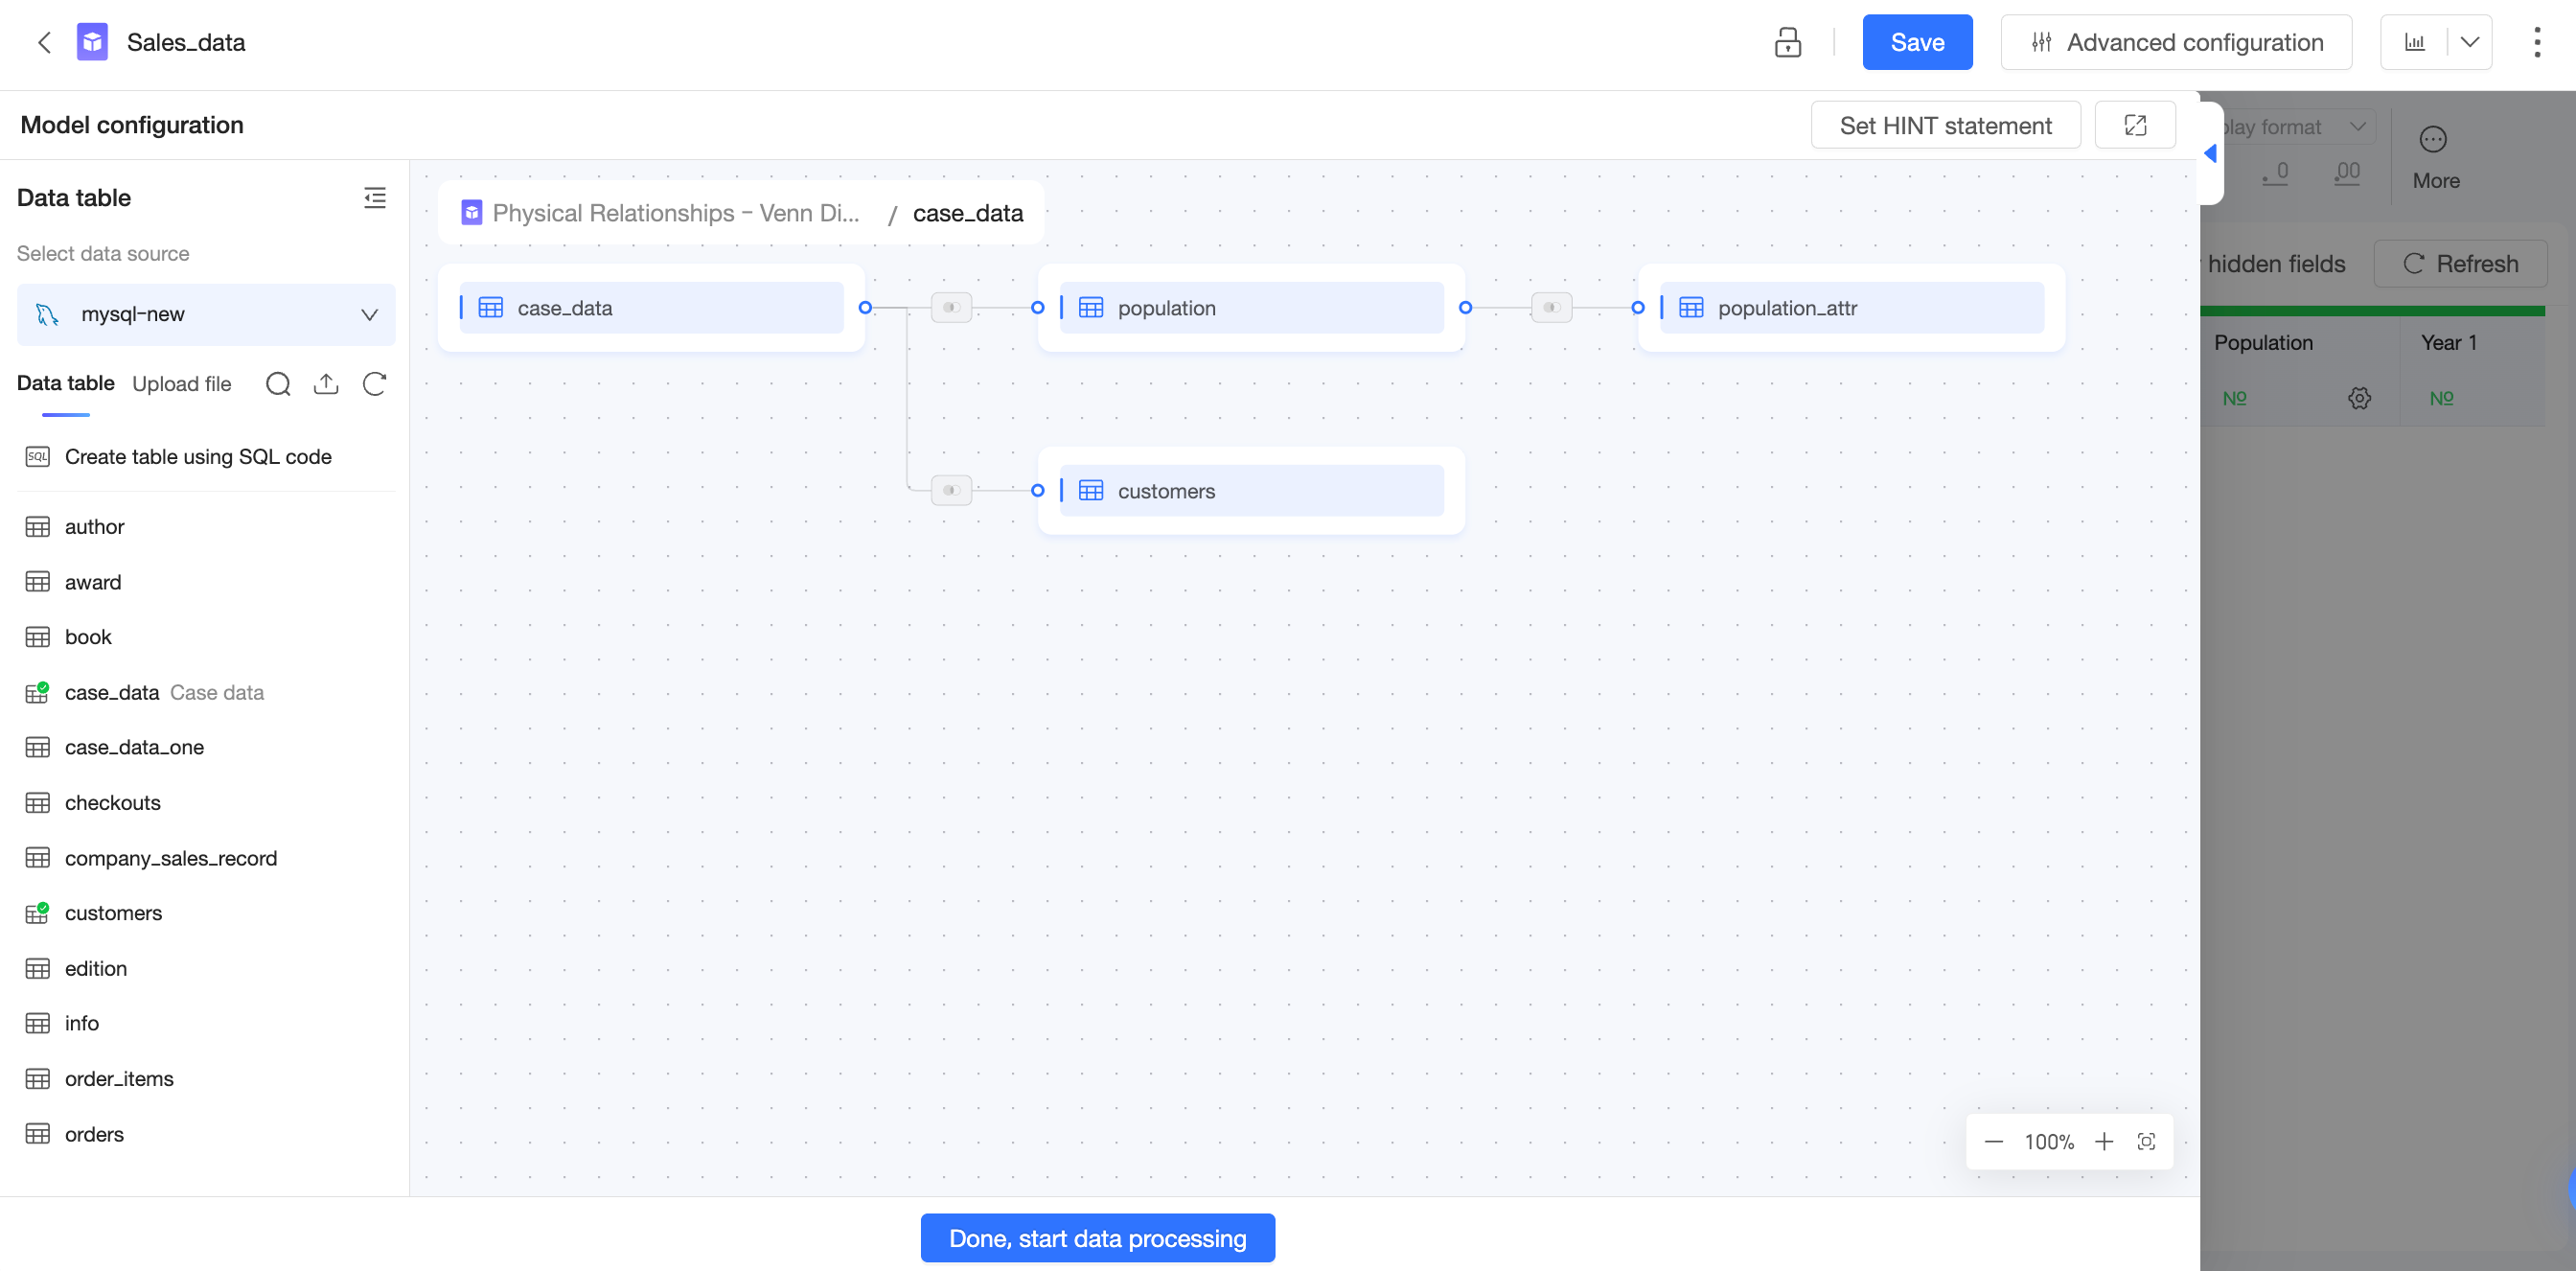
Relation entre les couches logique et physique
Dans la couche logique, les tables logiques sont connectées par des relations qui forment le modèle relationnel. Vous ne spécifiez pas les types de jointure et le résultat n'est pas une table large fixe.
Chaque table logique possède son propre modèle physique. Accédez à la couche physique en double-cliquant sur une table logique ou en cliquant sur l'icône  , puis en sélectionnez Go to Physical Canvas. Dans la couche physique, les tables sont connectées à l'aide de jointures ou d'unions avec des types de jointure explicites, produisant ainsi une table large complète.
Chaque table logique de la couche logique possède un modèle physique correspondant (soit un modèle mono-table, soit un modèle multi-table) dans la couche physique.
Dans les versions précédentes de Quick BI, le modèle de données ne comportait qu'une couche physique. La version 6.1 et les versions ultérieures ajoutent une couche logique, permettant ainsi l'utilisation du modèle relationnel.
Cardinalité et intégrité référentielle
Lorsque vous configurez une relation, cliquez sur More Options pour définir la cardinality et l'referential integrity. Quick BI utilise ces paramètres pour sélectionner le type de jointure le plus approprié. Une configuration précise améliore les performances des requêtes.
Si vous ne maîtrisez pas la distribution de vos données ou les concepts de cardinality et d'referential integrity, ne modifiez pas les paramètres par défaut. Des configurations incorrectes peuvent entraîner des erreurs telles que la duplication ou la perte de données.
Ajustez les paramètres de cardinality et d'referential integrity pour optimiser les performances des requêtes uniquement si vous comprenez clairement la distribution de vos données et êtes certain qu'elle ne changera pas à l'avenir.
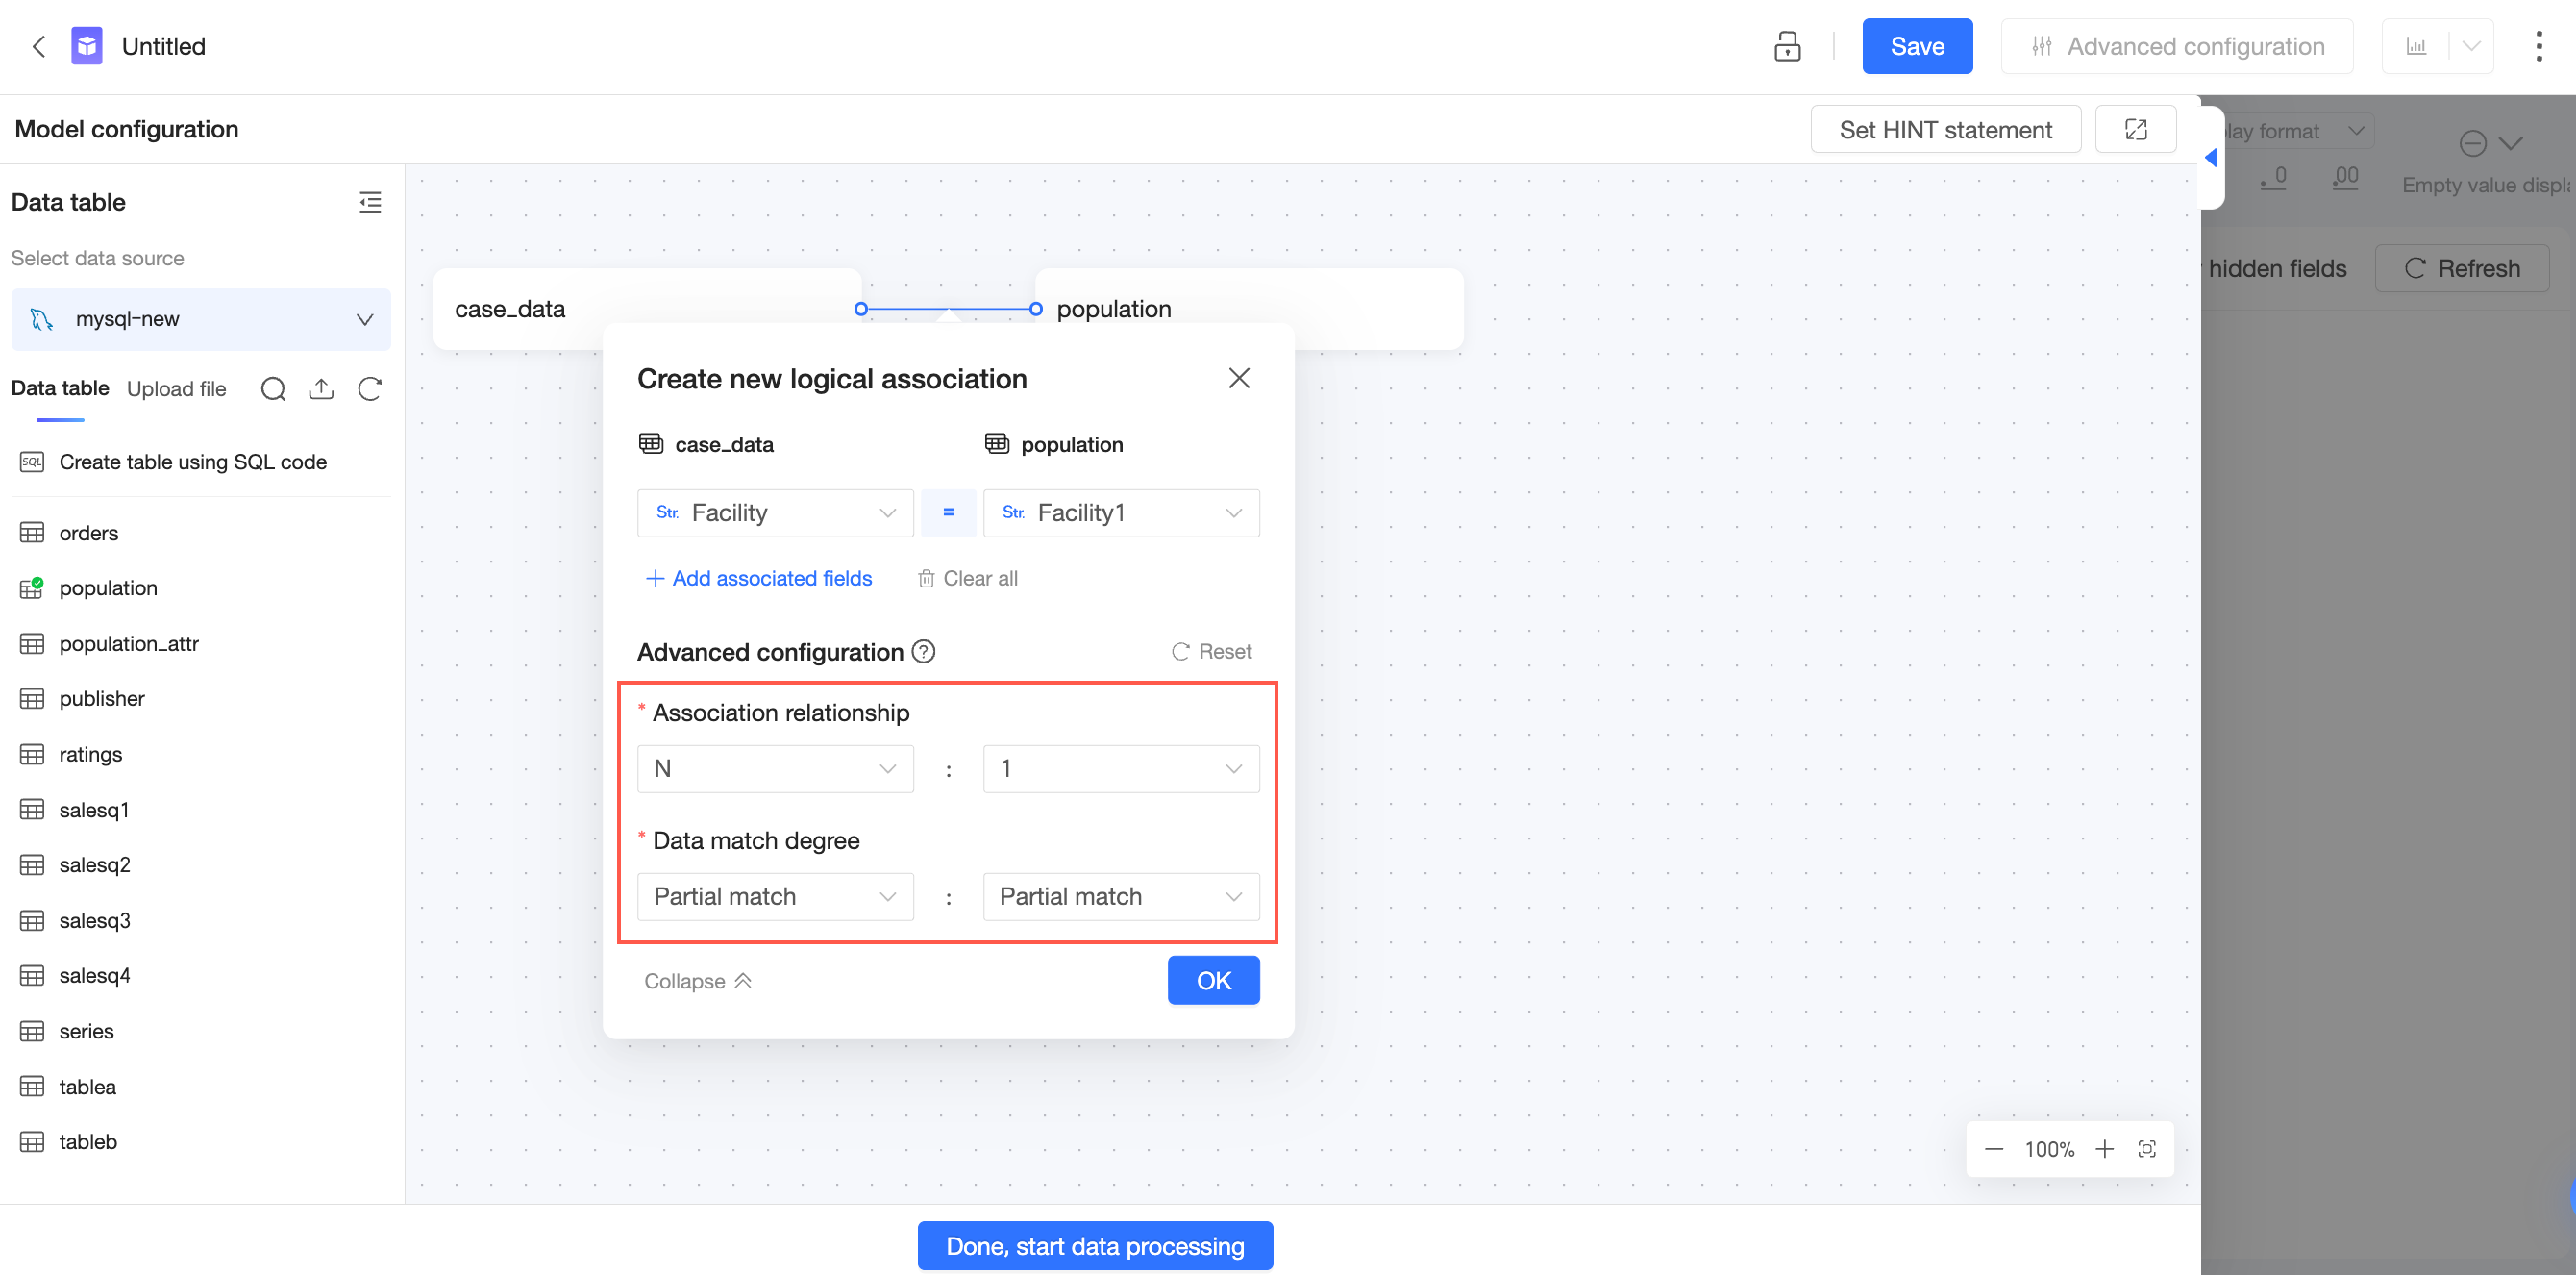
Cardinalité
La cardinalité décrit si les valeurs de clé de jointure dans une table sont uniques et comment les valeurs de clé de jointure de deux tables correspondent entre elles.
1 : Le champ contient des valeurs uniques.
N : Le champ contient des valeurs non uniques (plusieurs).
|
Cardinalité |
Exemple |
Diagramme |
|
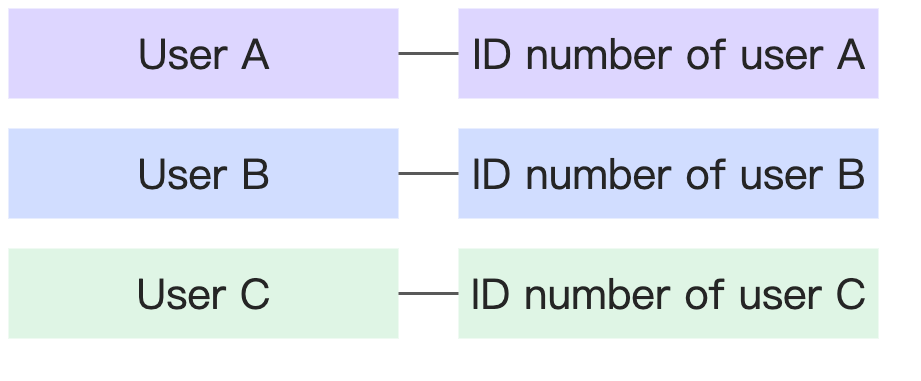
1:1 |
Chaque personne possède un numéro d'identification national unique, et chaque numéro d'identification national correspond à une seule personne. |
|
|
1:N |
Chaque État correspond à de nombreuses villes, mais chaque ville correspond à un seul État. |
|
|
N:1 |
|
|
|
N:N |
Un livre peut avoir plusieurs auteurs, et un auteur peut écrire plusieurs livres. |
|
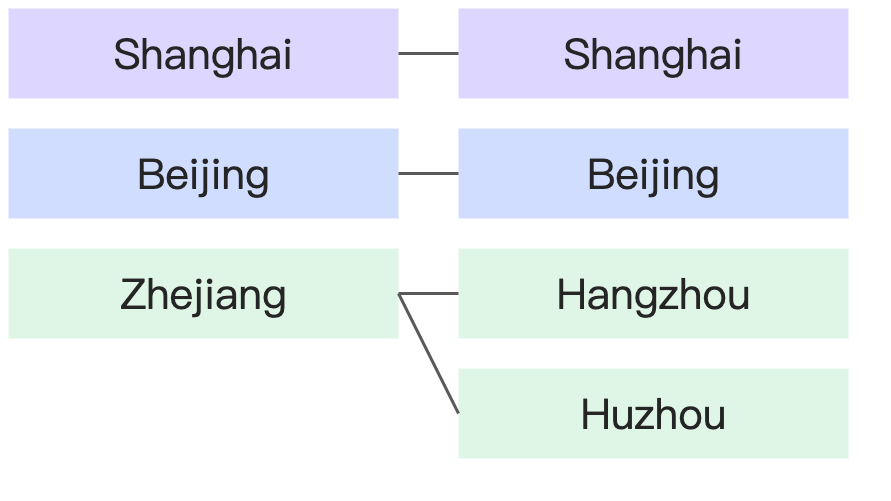
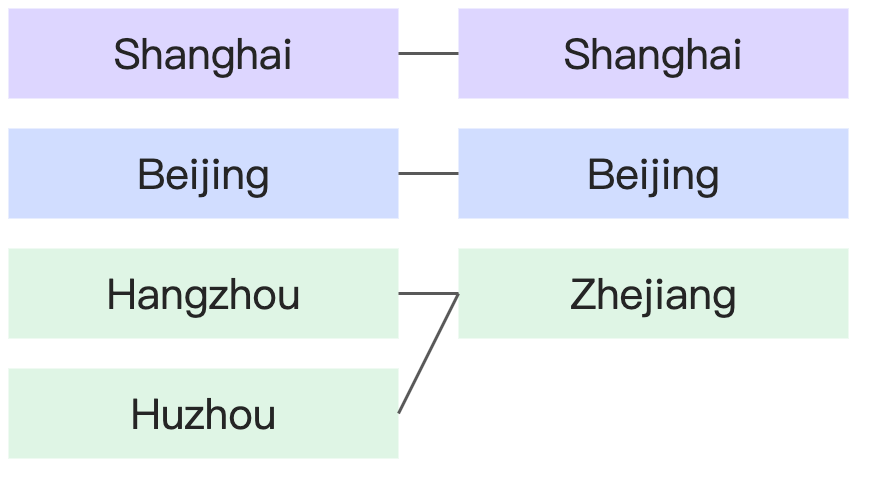
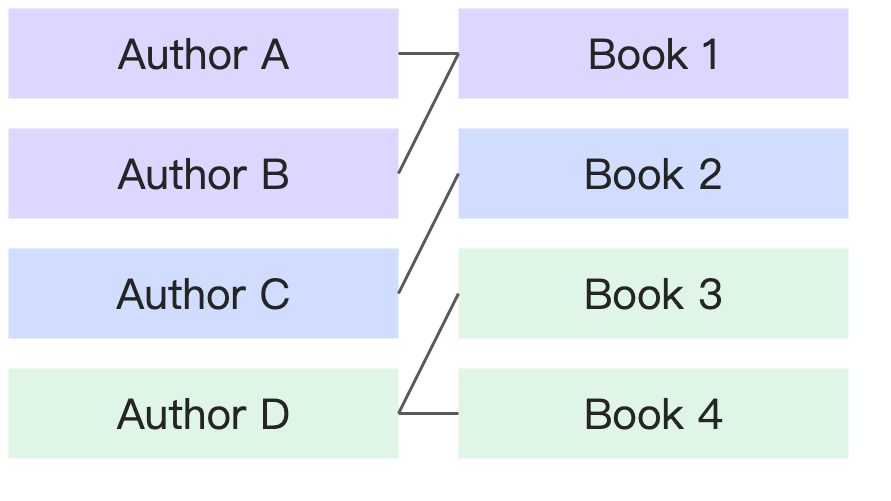
Intégrité référentielle
L'intégrité référentielle décrit si les valeurs de clé de jointure d'une table peuvent être entièrement mises en correspondance avec les valeurs d'une autre table. En d'autres termes, elle décrit l'exhaustivité des données.
Certaines correspondances existent : Certaines valeurs de champ d'une table n'ont pas de correspondance dans l'autre table.
Toutes les correspondances existent : Toutes les valeurs de champ d'une table ont une correspondance dans l'autre table.
|
Intégrité référentielle |
Exemple |
Diagramme |
|
Toutes les correspondances existent : Toutes les correspondances existent |
Chaque pays possède des États correspondants, et chaque État a un pays correspondant. |
|
|
Certaines correspondances existent : Toutes les correspondances existent |
Chaque livre possède un auteur correspondant, mais certains auteurs peuvent ne pas avoir de livre correspondant (par exemple, ils n'ont pas encore publié). |
|
|
Toutes les correspondances existent : Certaines correspondances existent |
||
|
Certaines correspondances existent : Certaines correspondances existent |
Certains étudiants n'ont pas de cours correspondant (ils ne se sont pas encore inscrits), et certains cours n'ont pas d'étudiants correspondants (personne ne s'est inscrit). |
|
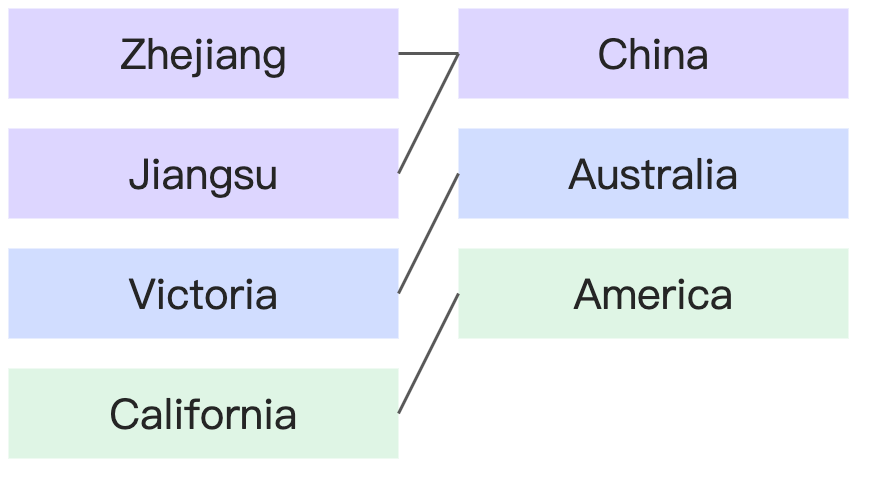
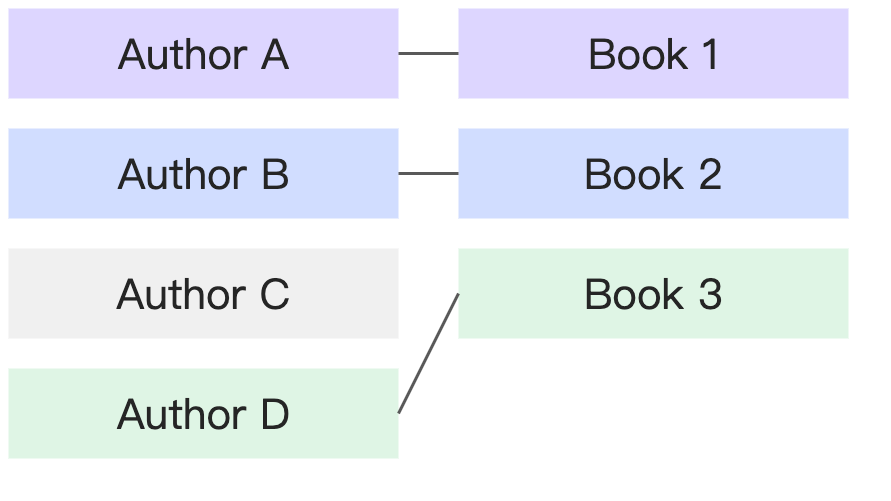
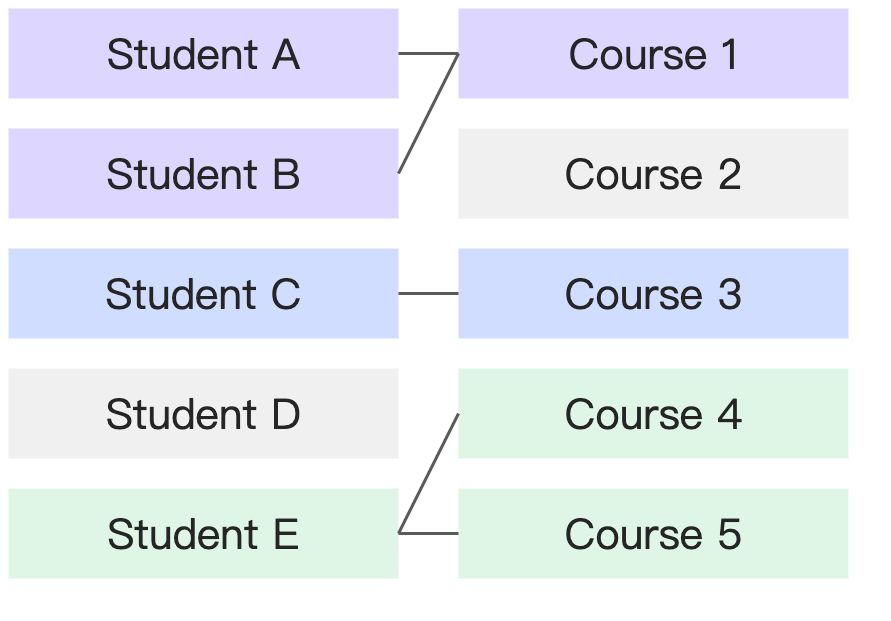
Cas d'usage du modèle relationnel
Cas d'usage du modèle relationnel
Cas d'usage 1 : Modélisation simple pour les utilisateurs métier
Si vous possédez des connaissances limitées en SQL ou en bases de données, utilisez le modèle relationnel pour la modélisation des données.
La configuration d'un modèle relationnel est plus simple que celle d'une modélisation physique : spécifiez la clé de jointure entre deux tables et conservez les valeurs par défaut pour les paramètres avancés. Le modèle relationnel empêche la duplication des données sans que vous ayez besoin de comprendre l'exhaustivité ou l'unicité des données, abaissant ainsi la barrière à l'entrée de la modélisation et améliorant la précision.
Exemple
Un service RH met en place un système de points pour encourager les employés à participer aux activités de formation. Les employés gagnent des points en assistant aux événements et peuvent les échanger contre des cadeaux. La base de données contient deux tables :
Table des points gagnés : Date, ID employé, Département, Nom de l'activité, Points gagnés
Table des points dépensés : Date, ID employé, Département, Nom du cadeau, Points dépensés
La relation entre la table des points gagnés et la table des points dépensés est la suivante :
|
Table des points gagnés - Table des points dépensés |
||
|
Cardinalité |
N:N |
Un employé peut participer à plusieurs activités pour gagner des points et peut également dépenser ses points à plusieurs reprises. Par conséquent, le champ « ID employé » n'est pas unique dans aucune des deux tables. |
|
Intégrité référentielle |
Certaines correspondances existent : Toutes les correspondances existent |
Un employé peut gagner des points sans jamais les dépenser. Dans ce cas, l'enregistrement de l'employé existe dans la « Table des points gagnés », mais pas dans la « Table des points dépensés ». Si un employé n'a jamais gagné de points, il ne peut pas les dépenser. Par conséquent, un enregistrement ne peut pas exister dans la « Table des points dépensés » s'il n'existe pas également dans la « Table des points gagnés ». |
L'analyste RH doit vérifier les points restants par employé. Une jointure physique sur « ID employé » dupliquerait les données car le champ n'est unique dans aucune des deux tables. L'approche correcte de modélisation physique — agréger les deux tables par « ID employé » avant la jointure — nécessite des compétences en prétraitement des données.
Avec le modèle relationnel, l'analyste crée une relation sur « ID employé » et Quick BI agrège automatiquement les données lors du calcul pour garantir l'exactitude.
La logique de calcul est décrite dans la rubrique Fonctionnement du modèle relationnel.
Cas d'usage 2 : Améliorer la réutilisabilité des ensembles de données
Un utilisateur informatique peut faire glisser toutes les tables associées vers le canevas logique pour construire un seul modèle relationnel complet. Les utilisateurs métier sélectionnent ensuite les champs dont ils ont besoin. Cela élimine la nécessité de créer de nombreuses tables larges pour différents scénarios analytiques, empêchant ainsi la prolifération des ensembles de données.
Dans ce cas d'usage, les utilisateurs informatiques doivent configurer les paramètres de cardinalité et d'intégrité référentielle en fonction des caractéristiques des données afin d'optimiser les performances des requêtes.
Exemple
Reprenons l'exemple du système de points du service RH :
Table des points gagnés : Date, ID employé, Département, Nom de l'activité, Points gagnés
Table des points dépensés : Date, ID employé, Département, Nom du cadeau, Points dépensés
Contrairement à l'exemple précédent, cette entreprise dispose d'une équipe informatique centralisée qui prépare les ensembles de données pour tous les analystes. Le service RH soumet des demandes de données pour trois scénarios. Avec la modélisation physique, l'équipe informatique doit créer trois ensembles de données distincts.
|
Scénario |
Description |
Approche de modélisation |
|
Scénario 1 |
Analyser le nombre de participants et les points gagnés pour chaque activité. |
Table des points gagnés (modèle mono-table) |
|
Scénario 2 |
Analyser le nombre de personnes et de rachats pour chaque cadeau. |
Table des points dépensés (modèle mono-table) |
|
Scénario 3 |
Analyser les points restants pour chaque employé et créer un classement. |
Joindre les tables des points gagnés et des points dépensés après les avoir agrégées chacune par « ID employé ». |
Étant donné que les deux tables ont des granularités différentes, une jointure physique directe duplique les données. La pré-agrégation par « ID employé » entraîne la perte de champs détaillés tels que « Nom de l'activité » et « Nom du cadeau », rendant impossible l'analyse des scénarios 1 et 2. La modélisation physique nécessite donc trois ensembles de données distincts.
Avec un modèle relationnel, un seul ensemble de données suffit. Quick BI sélectionne automatiquement la méthode de calcul appropriée en fonction des champs utilisés dans chaque analyse.
|
Scénario |
Description |
Approche de modélisation |
Champs utilisés |
Traitement par le modèle |
|
Scénario 1 |
Analyser le nombre de participants et les points gagnés pour chaque activité. |
Clé de jointure : ID employé N:N Certaines : Toutes |
Dimension : Nom de l'activité Mesures : ID employé (nombre distinct), Points gagnés (somme) |
Requête mono-table |
|
Scénario 2 |
Analyser le nombre de personnes et de rachats pour chaque cadeau. |
Dimension : Nom du cadeau Mesures : ID employé (nombre distinct), Points dépensés (somme) |
Requête mono-table |
|
|
Scénario 3 |
Analyser les points restants pour chaque employé et créer un classement. |
Dimension : ID employé Mesure : SOMME(Points gagnés) - SOMME(Points dépensés) |
Jointure après agrégation |
La logique de calcul est décrite dans la rubrique Fonctionnement du modèle relationnel.
Limitations
Limitations de performance
Pour éviter la duplication des données, le modèle relationnel génère un SQL plus complexe avec des sous-requêtes supplémentaires et une imbrication plus profonde, ce qui peut dégrader les performances des requêtes. L'impact augmente avec le volume de données et la complexité du modèle.
Si vous connaissez bien la distribution de vos données, ajustez les paramètres de cardinalité et d'intégrité référentielle pour optimiser les performances. Classement des performances :
Cardinalité : 1:1 > 1:N = N:1 > N:N
Intégrité référentielle : Toutes les correspondances existent : Toutes les correspondances existent > Toutes les correspondances existent : Certaines correspondances existent = Certaines correspondances existent : Toutes les correspondances existent > Certaines correspondances existent : Certaines correspondances existent
Si vous ne maîtrisez pas la distribution de vos données ou les concepts de « cardinalité » et d'« intégrité référentielle », ne modifiez pas les paramètres par défaut. Des configurations incorrectes peuvent entraîner des erreurs telles que la duplication ou la perte de données.
Ajustez les paramètres de « cardinalité » et d'« intégrité référentielle » pour optimiser les performances des requêtes uniquement si vous comprenez clairement la distribution de vos données et êtes certain qu'elle ne changera pas à l'avenir.
Si vous avez besoin de performances de requête maximales et possédez de solides compétences en traitement des données, utilisez la modélisation physique traditionnelle pour éviter la surcharge de calcul du modèle relationnel.
Limitations de volume de données
Lorsque les mesures proviennent de plusieurs tables logiques, Quick BI interroge chaque table séparément et joint les résultats. Pour garantir l'efficacité des requêtes et la stabilité du service, chaque requête est limitée à un volume de données de 10 000 lignes. Pour plus d'informations, consultez la rubrique Fonctionnement du modèle relationnel.
Cette limite de 10 000 lignes s'applique aux données agrégées. Par exemple, si la clé de jointure est « Région » et que la dimension de la requête est « Type de produit », la requête de la table logique agrège par ces deux champs et renvoie les 10 000 premières lignes.
La pagination ne permet pas de récupérer les données au-delà de la limite de 10 000 lignes. Si votre requête nécessite une granularité plus fine ou si votre dimension possède trop de valeurs uniques, le modèle relationnel peut renvoyer des données incomplètes. Dans ces cas, utilisez plutôt des jointures physiques traditionnelles.
Limitations fonctionnelles
Le modèle relationnel a introduit des modifications importantes dans le traitement sous-jacent des données. Les fonctionnalités suivantes ne sont pas compatibles avec les anciennes versions :
L'importation d'un ensemble de données depuis une version plus récente vers un environnement plus ancien provoque une erreur. Mettez à niveau l'environnement cible vers la version 6.1 ou ultérieure avant l'importation.
-
L'API
QueryDatasetDetailInfon'est plus compatible avec les ensembles de données du modèle relationnel. Utilisez plutôtQueryDatasetInfo.Ancienne API (non maintenue) : https://next.api.alibabacloud.com/document/quickbi-public/2022-01-01/QueryDatasetDetailInfo
Nouvelle API : https://next.api.alibabacloud.com/document/quickbi-public/2022-01-01/QueryDatasetInfo
Quick BI v6.1 a introduit la version initiale du modèle relationnel. Les fonctionnalités suivantes ne prennent actuellement en charge que les ensembles de données à table logique unique (la prise en charge multi-table est prévue pour les versions futures) :
Préparation des données
Les conditions de filtre complexes ne peuvent pas référencer des champs provenant de plusieurs tables logiques. Fonctionnalités concernées :
Sécurité au niveau des lignes : y compris l'autorisation par combinaison conditionnelle et l'autorisation basée sur les tags utilisateur
dashboard - Contrôle de requête composite
Surveillance et alarme - règle d'alarme
Limitation de l'accélération par extraction : Si une requête implique plus de trois tables logiques, le système contourne le moteur d'accélération et utilise une connexion directe.