Cette rubrique décrit la fonctionnalité d'index columnaire en cluster (CCI).
Les solutions de traitement transactionnel en ligne (OLTP) et de traitement analytique en ligne (OLAP) reposent généralement sur le modèle de séparation lecture/écriture ou sur le modèle ETL (Extract, Transform, Load). Elles extraient les données des bases de données opérationnelles pour les charger dans un entrepôt de données à des fins d'analyse, avec un décalage temporel de type T+1. Toutefois, ces approches présentent plusieurs inconvénients : coûts de stockage élevés, capacités temps réel limitées, ainsi que frais de maintenance et de connectivité importants.
Pour faire face à la croissance exponentielle des données, PolarDB-X propose la fonctionnalité CCI, basée sur Object Storage Service (OSS). Cette fonctionnalité synchronise en temps réel les données orientées ligne vers un format orienté colonne et offre les capacités suivantes :
La fonctionnalité CCI intègre l'OLTP et l'analyse de données en temps réel, répondant ainsi aux exigences des scénarios combinant OLTP et OLAP.
La fonctionnalité CCI de PolarDB-X prend en charge le routage intelligent et le traitement massivement parallèle (MPP). La couche de calcul identifie précisément le trafic de traitement transactionnel (TP) et le trafic de traitement analytique (AP), puis achemine chacun vers le support de stockage approprié. Par défaut, elle active également le MPP sur les traces AP pour analyser les CCI, ce qui améliore considérablement les performances des requêtes analytiques.
La fonctionnalité CCI utilise le modèle Delta+Main pour effectuer des mises à jour en temps réel en quelques secondes. Elle s'intègre au contrôle de concurrence multiversion (MVCC) afin de garantir la lecture cohérente de snapshots à tout moment.
Notes d'utilisation
La fonctionnalité CCI est prise en charge uniquement par les instances Enterprise Edition dont la version est 5.4.19-16989811 ou ultérieure.
-
Seules les bases de données en mode AUTO prennent en charge la création de CCI.
RemarquePour plus d'informations sur le versionnement des instances, consultez les Notes de version du noyau.
Pour savoir comment consulter la version d'une instance PolarDB-X, consultez la rubrique Afficher et mettre à jour la version du moteur d'une instance PolarDB for Xscale.
Architecture
Stockage hybride ligne-colonne

Composants clés
Les nœuds de calcul (CN) constituent le point d'entrée du système. Conçus selon une architecture sans état, ils intègrent des modules tels que l'analyseur SQL, l'optimiseur et l'exécuteur. Les CN gèrent le routage distribué des données, le calcul, l'ordonnancement dynamique, la coordination des transactions distribuées via le protocole Two-Phase Commit (2PC) et la maintenance des index secondaires globaux. Ils fournissent des fonctionnalités de niveau entreprise, telles que la limitation du débit SQL et le mode à trois rôles.
Les nœuds de données (DN) assurent la persistance des données orientées ligne. Ils garantissent la durabilité des données et une forte cohérence grâce au protocole Paxos multi-majorité. Les DN utilisent le MVCC pour maintenir la visibilité des transactions distribuées. Ils satisfont également aux exigences des opérations nécessitant le push-down de tâches de calcul dans les architectures distribuées, telles que Project, Filter, Join et Aggregation.
Le Global Meta Service (GMS) maintient des métadonnées système cohérentes à l'échelle globale, notamment les métadonnées de table, de schéma et de statistiques. Il gère les informations liées à la sécurité, telles que les comptes utilisateurs et les autorisations, et fournit le service Timestamp Oracle (TSO).
Change Data Capture (CDC) offre des capacités d'abonnement incrémentiel entièrement compatibles avec les formats et protocoles des journaux binaires MySQL. CDC fournit également des capacités de réplication primaire/secondaire compatibles avec les protocoles de réplication MySQL.
Le composant Columnar assure la persistance des CCI, consomme en temps réel les journaux binaires des transactions distribuées et construit les CCI sur OSS pour répondre aux exigences de mises à jour en temps réel. Combiné aux CN, il offre des capacités de requête avec cohérence de snapshot pour les CCI.
Stockage orienté colonne

Concept d'architecture
Avec la popularité croissante des technologies cloud-native, les entrepôts de données cloud-native de nouvelle génération, tels que Snowflake, et l'architecture HTAP stimulent continuellement l'innovation. À court terme, le stockage hybride ligne-colonne doté de capacités HTAP deviendra une exigence standard pour les bases de données. Il est donc crucial de privilégier des aspects tournés vers l'avenir, tels que le rapport coût-efficacité, la facilité d'utilisation et les hautes performances, lors de la conception du stockage orienté colonne.
PolarDB-X propose la fonctionnalité CCI. Par défaut, une table orientée ligne dans PolarDB-X dispose d'index de clé primaire et d'index secondaires. Un CCI est un index secondaire construit sur une structure orientée colonne et valable pour toutes les colonnes d'une table orientée ligne. Une table peut contenir à la fois des données orientées ligne et des données orientées colonne.
Caractéristiques de l'architecture
-
Architecture cloud-native (découplage du stockage et du calcul, rapport coût-efficacité)
La fonctionnalité CCI de PolarDB-X utilise OSS comme stockage de données principal, générant des coûts équivalents à un sixième ou un dixième de ceux du stockage sur disque local. Elle réalise également un taux de compression élevé des données orientées colonne, trois à cinq fois supérieur à celui des autres types de données. Cela confère à la fonctionnalité CCI un avantage concurrentiel en matière de réduction des coûts. Dans les scénarios HTAP impliquant un stockage hybride ligne-colonne, les coûts supplémentaires liés au stockage orienté colonne peuvent être maintenus entre 5 % et 10 % des coûts de stockage orienté ligne.
La fonctionnalité CCI de PolarDB-X s'appuie sur le modèle à deux niveaux Delta+Main, similaire à la structure LSM et aux technologies de suppression par balises dans sa couche de stockage, afin de garantir des capacités de mise à jour à haute concurrence lors de l'utilisation d'OSS. Plusieurs couches de cache de données locales et un mécanisme de statistiques multiniveau sont également employés sur les traces où la fonctionnalité CCI lit les données depuis OSS, minimisant ainsi les accès distants inutiles aux données de stockage OSS.
-
Système de base de données distribuée (mise à l'échelle linéaire)
Dans les bases de données distribuées traditionnelles, les CCI sont généralement construits à l'aide de mécanismes multi-réplicas basés sur les protocoles Paxos ou Raft. Cependant, l'OLTP et l'OLAP ont des exigences de requête différentes et des dépendances aux ressources variées. Les politiques de partitionnement à forte cohérence et les mécanismes de mise à l'échelle entre les différents réplicas peuvent limiter les capacités de mise à l'échelle linéaire du TP et de l'AP, ce qui dégrade les performances de la base de données.
La fonctionnalité CCI de PolarDB-X implémente une transformation hétérogène des données orientées ligne vers les données orientées colonne (M:N) basée sur la synchronisation en temps réel des journaux binaires des transactions distribuées. Elle définit les clés de partition distribuées et les clés de tri pour les CCI. PolarDB-X exploite les techniques de traitement parallèle distribué pour offrir une évolutivité linéaire aux requêtes basées sur les CCI. Les supports de stockage orientés ligne et colonne sont isolés les uns des autres, permettant ainsi une mise à l'échelle aisée des ressources de stockage et de calcul. Dans un environnement distribué, les requêtes basées sur les CCI bénéficient d'une évolutivité linéaire extrême.
-
Séparation lecture/écriture (architecture serverless avec tarification à l'utilisation pour les lectures)
La fonctionnalité CCI de PolarDB-X adopte une architecture de séparation lecture/écriture basée sur des composants. Cette architecture comprend des nœuds de stockage en colonne et des nœuds de calcul. Les nœuds de stockage en colonne sont des nœuds sans état qui ne traitent pas directement les requêtes d'écriture provenant des clients externes. Ils exploitent plutôt la technologie Group Commit pour mettre à jour par lots les données CCI. Les nœuds de calcul sont des nœuds sans état qui récupèrent les métadonnées columnaires auprès des nœuds GMS et accèdent directement aux données CCI stockées dans OSS.
Lorsque vous créez une instance PolarDB-X, le système fournit automatiquement des nœuds de stockage en colonne. Ces nœuds s'exécutent en continu et synchronisent les CCI. Créez facilement un CCI en exécutant une instruction DDL. Une fois le CCI construit, les données CCI sont générées et mises à jour automatiquement en temps réel. Utilisez une instance principale ou achetez une instance en lecture seule supplémentaire pour accéder aux index de stockage ligne et aux CCI. Le mode serverless convient également aux CN sans état. Vous êtes facturé uniquement pour l'utilisation des CN.
-
Combinaison du stockage orienté ligne et orienté colonne (facilité d'utilisation, moteur SQL vectorisé intégré)
PolarDB-X réutilise le moteur SQL des CN pour fournir l'ensemble complet de leurs capacités. Un optimiseur de coût est conçu pour les scénarios hybrides ligne-colonne. Cet optimiseur identifie intelligemment les routes en fonction des coûts d'exécution et transfère les requêtes OLTP vers les traces de requête de stockage ligne et les requêtes OLAP vers les traces de requête basées sur les CCI. L'optimiseur de coût vous permet d'accéder à différentes données orientées ligne et orientées colonne au niveau des opérateurs SQL, mettant pleinement en œuvre les capacités hybrides ligne-colonne de l'HTAP. Il permet également un accès unifié à un ensemble de moteurs SQL.
PolarDB-X est entièrement compatible avec la vectorisation. La structure de données du chunk columnaire est utilisée par l'opérateur TableScan pour lire les données orientées colonne. Les calculs des opérateurs suivants héritent également pleinement de la structure columnaire en mémoire des chunks. Cela améliore les performances des requêtes grâce à une vectorisation de bout en bout. L'opérateur TableScan pour le stockage orienté ligne est également converti dynamiquement en chunks columnaires pour implémenter des requêtes hybrides ligne-colonne basées sur une structure de données unifiée.
-
Entrepôt tout-en-un (Zero-ETL)
Les entrepôts de données traditionnels utilisent l'ETL pour synchroniser les données et s'appuient sur des architectures de calcul parallèle, telles que MPP et Bulk Synchronous Parallel (BSP), pour gérer des requêtes OLAP complexes. Cependant, dans le cas de requêtes en ligne à haute concurrence (scénarios de service), ces entrepôts rencontrent un goulot d'étranglement au niveau de la concurrence des ressources. Dans ce cas, ils renvoient les données vers les bases de données OLTP pour fournir des requêtes en ligne.
PolarDB-X s'intègre à AnalyticDB for MySQL pour proposer un entrepôt tout-en-un. Cet entrepôt exploite des données CCI partagées selon le concept Zero-ETL. Il permet également à plusieurs parties d'effectuer des agrégations de données et des requêtes de corrélation de données, et fournit des analyses d'entrepôt traditionnel et de data lake basées sur les capacités d'entreposage d'AnalyticDB for MySQL. L'architecture hybride ligne-colonne dotée de capacités HTAP de PolarDB-X peut également être utilisée pour des requêtes concurrentes sur des données en ligne, éliminant ainsi le besoin d'ETL de données traditionnel.
Fonctionnement des CCI
Construction des CCI
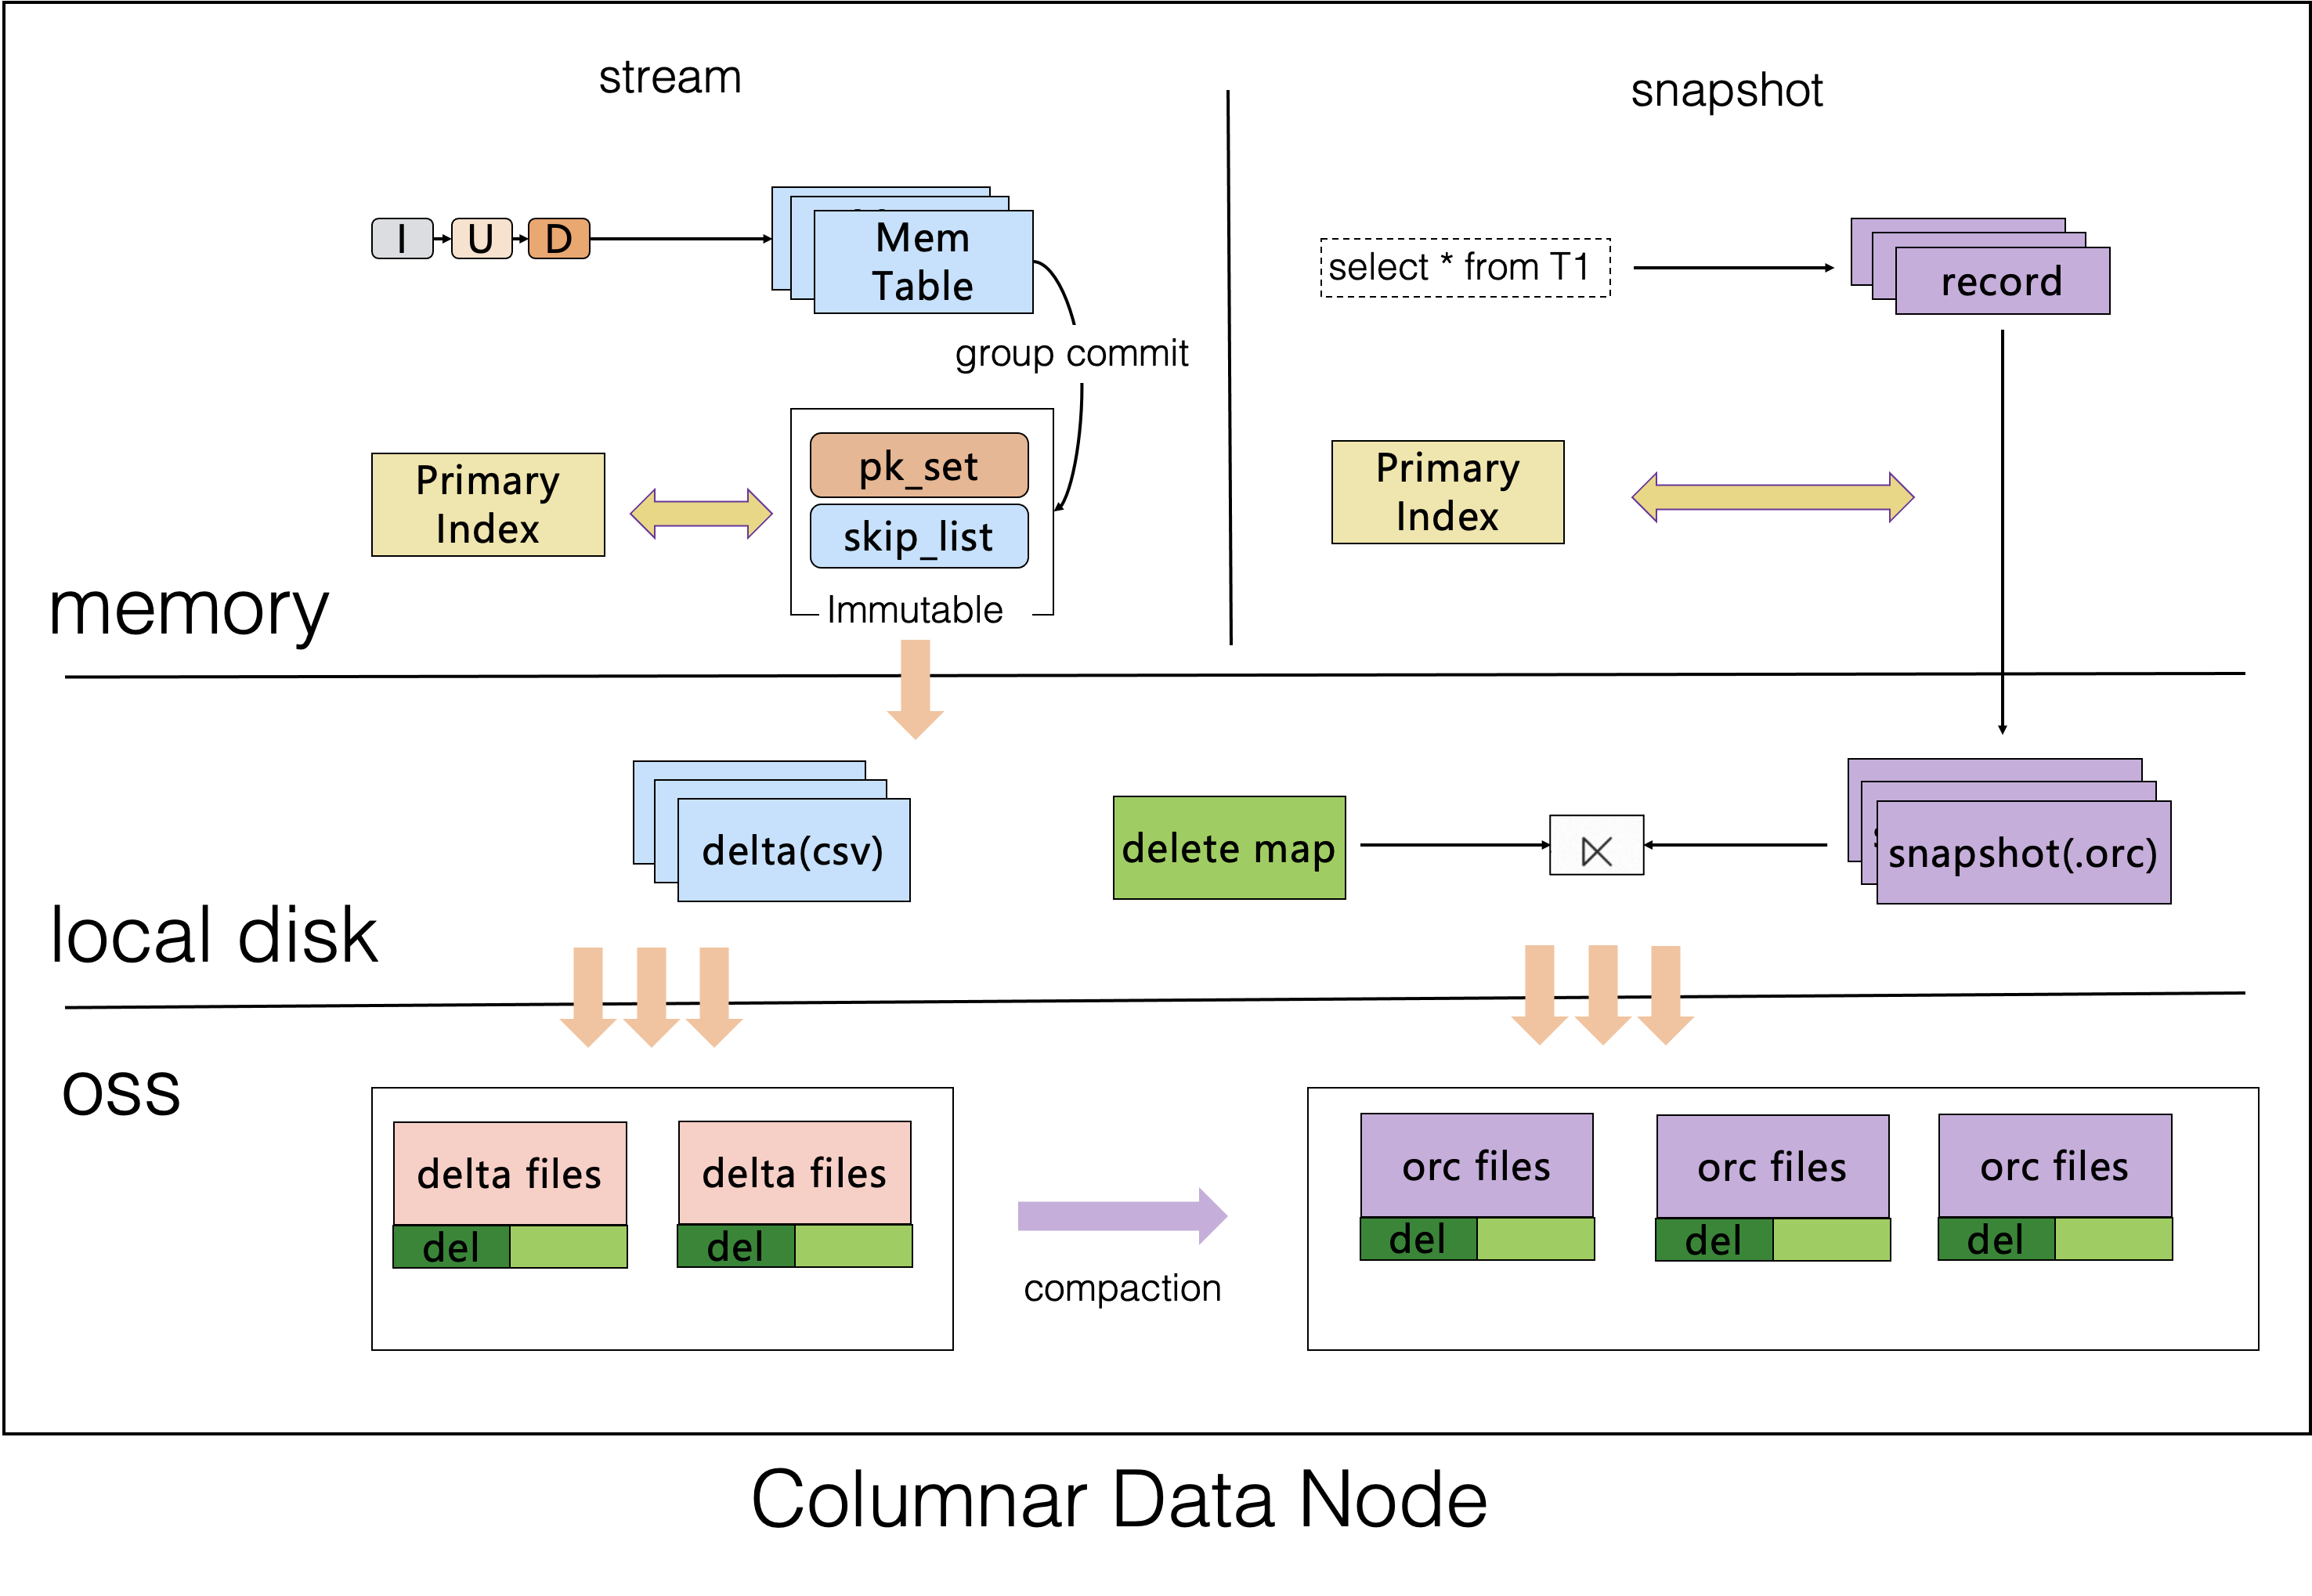
Les nœuds de stockage en colonne construisent les CCI. Les données relatives aux CCI construits sont stockées dans des objets shard aux formats CSV et ORC. Le format CSV est utilisé pour stocker les données incrémentielles en temps réel. Les données incrémentielles excessives sont compactées en temps opportun et vidées au format ORC. PolarDB-X a optimisé les formats CSV et ORC. Les formats optimisés héritent des fonctionnalités open source des formats natifs et garantissent que les deux formats peuvent exprimer pleinement les protocoles de données de MySQL.
Du point de vue de la synchronisation des données, le processus de construction des CCI implique deux traces de synchronisation parallèles : la lecture d'instantané complet et la synchronisation des données incrémentielles. Dans les scénarios où les CCI sont construits avant l'importation des données, seules les données incrémentielles sont synchronisées, et les nœuds de stockage en colonne consomment simultanément les journaux binaires pour construire les CCI. Dans les scénarios où les données sont partiellement importées, puis les CCI sont construits et les données restantes importées, les données incrémentielles sont synchronisées, et les nœuds de stockage en colonne consomment simultanément les données incrémentielles et complètes existantes pour améliorer l'efficacité de la création des CCI.
D'un point de vue hiérarchique, les nœuds de stockage en colonne utilisent le modèle à deux niveaux Delta+Main, similaire à la structure LSM et aux technologies de suppression par balises, pour garantir une synchronisation des données à faible latence entre le stockage orienté ligne et le stockage orienté colonne, ainsi que des mises à jour de données en temps réel en quelques secondes. Les données sont écrites en temps réel dans la MemTable. Elles sont stockées dans un fichier CSV local et ajoutées au fichier CSV correspondant sur OSS au sein d'un cycle de group commit. Le fichier local est nommé fichier delta. Le fichier CSV sur OSS n'est pas stocké de manière permanente, mais est converti en fichier ORC par compaction de temps en temps.
MPP

Dans PolarDB-X, les CN gèrent le trafic des requêtes et des analyses. La figure ci-dessus montre que toute la chaîne d'accélération des requêtes se compose de trois niveaux : l'optimiseur, l'exécuteur et le moteur de stockage.
PolarDB-X fournit un optimiseur de coût adapté aux scénarios hybrides ligne-colonne. L'optimiseur identifie intelligemment les routes en fonction des coûts d'exécution et transfère les requêtes TP vers les traces de requête de stockage ligne et les requêtes AP vers les traces de requête basées sur les CCI.
PolarDB-X propose un exécuteur intégré adapté aux scénarios hybrides ligne-colonne. Un ensemble d'exécuteurs est disponible dans les scénarios HTAP. La couche d'opérateurs est également vectorisée et prend en charge le MPP. Dans les scénarios de requêtes complexes, les ressources multi-nœuds peuvent être utilisées pour le calcul parallèle afin de répondre aux exigences des requêtes complexes à haut débit. Pour éliminer la latence réseau causée par l'architecture découplant les ressources de calcul et de stockage, la couche d'exécution introduit également une technologie de mise en cache locale pour charger les données fréquemment utilisées sur les disques locaux en temps réel. Cela garantit que les exigences de requête à faible latence sont satisfaites.
Au niveau du moteur de stockage, la construction des CCI permet l'atomicité des transactions validées et garantit que des données cohérentes au niveau de la transaction peuvent être interrogées.
Types de service

Avec l'introduction du composant columnar, PolarDB-X propose un type de service supplémentaire en plus des instances principales et des instances en lecture seule. Ce type de service ajouté est appelé instance de stockage en colonne en lecture seule.
Instance principale : par défaut, l'instance principale vous permet d'interroger uniquement les données orientées ligne. Cependant, lorsqu'elle est combinée avec des instances en lecture seule, le point de terminaison de l'instance principale active une séparation lecture/écriture transparente et fortement cohérente. L'instance principale conserve la capacité d'interroger directement les données orientées colonne. Le routage intelligent et les capacités de requête hybride ligne-colonne seront disponibles à l'avenir.
Instance en lecture seule : les instances en lecture seule vous permettent d'interroger les données en lecture seule orientées ligne et les données CCI. Les instances en lecture seule disposent de points de terminaison en lecture seule dédiés. Les applications peuvent établir des connexions séparées à ces points de terminaison en lecture seule pour effectuer des opérations de lecture. En se connectant à ces points de terminaison en lecture seule, les applications peuvent gérer indépendamment les opérations de lecture et d'écriture.
Instance de stockage en colonne en lecture seule : les instances de stockage en colonne en lecture seule vous permettent d'interroger uniquement les données CCI. Les instances disposent de points de terminaison en lecture seule dédiés. Les applications peuvent établir des connexions séparées à ces points de terminaison en lecture seule pour effectuer des opérations de lecture. Les instances se composent uniquement de CN et sont plus rentables.
Scénario
La fonctionnalité CCI de PolarDB-X propose une solution HTAP tout-en-un et peut être utilisée dans divers scénarios métier.
Scénarios nécessitant l'analyse en temps réel des données en ligne en quelques secondes, tels que les activités de reporting en temps réel.
Scénarios d'entreposage de données qui dépendent de la grande capacité de stockage des données de PolarDB-X pour agréger plusieurs sources de données en amont et utiliser PolarDB-X comme entrepôt de données dédié.
Scénarios de calcul orientés ETL qui dépendent des puissantes et flexibles capacités de calcul des CCI de PolarDB-X.
La fonctionnalité CCI de PolarDB-X répond aux exigences des scénarios impliquant le TP et l'AP, et propose une solution HTAP transparente et rentable basée sur OSS et la technologie de routage intelligent.
Tests de performance
Pour plus d'informations sur le test TPC Benchmark-H (TPC-H) de PolarDB-X pour les index columnaires en cluster (CCI) de PolarDB-X, consultez la rubrique Test TPC-H pour l'index columnaire en cluster (100 Go).