GanosBase, en association avec PolarDB for PostgreSQL (Compatible with Oracle), propose conjointement un stockage hiérarchisé polymorphe (données chaudes et froides) pour les données spatiales. Ce stockage utilise directement Object Storage Service (OSS) comme support de base de données plus économique, en complément du stockage par blocs. Cette solution vous permet de stocker une base de données entière, une table unique ou même un champ spécifique d'une table sur différents supports, tout en conservant une transparence totale des opérations CRUD. Un mécanisme de mise en cache multiniveau limite au minimum la dégradation des performances. Le stockage hiérarchisé polymorphe (données chaudes et froides) est une solution de gestion des données spatiales qui équilibre coût, performance et facilité d'utilisation, réduisant significativement la complexité du développement des applications et le coût des ressources cloud.
Présentation du stockage hiérarchisé polymorphe (données chaudes et froides)
Contexte métier
Avec l'accélération de la numérisation du monde physique, les services numériques de tous les secteurs doivent traiter rapidement des données à grande échelle, couvrant l'espace entier, multi-modèles et multi-états. Les implémentations traditionnelles basées sur des intergiciels rencontrent de graves défis en matière de performances de calcul spatial. Pour améliorer encore l'efficacité de la récupération des données spatiales à grande échelle et faire passer entièrement les charges de travail spatiales en ligne, GanosBase prend nativement en charge les types de stockage de données spatiales et un vaste ensemble d'opérateurs de calcul, améliorant considérablement la vitesse des requêtes et des calculs grâce à une délégation complète du calcul spatial. Si l'efficacité du calcul s'améliore, la croissance rapide des données spatiales et l'augmentation constante de la taille des objets spatiaux peuvent entraîner des coûts de plus en plus élevés. Un compromis entre coût et efficacité est souvent nécessaire : certaines charges de travail doivent revenir hors ligne ou être traitées par des jobs hors ligne, et les développeurs doivent basculer entre plusieurs supports de stockage, ce qui augmente fortement les coûts d'exploitation et de R&D. Par conséquent, trouver une solution de gestion des données spatiales équilibrant efficacité, coût et facilité d'utilisation est devenu le problème clé sur lequel l'équipe GanosBase s'est concentrée pendant plus de deux ans. Au cours de ces deux années, l'équipe GanosBase a centré sa planification et son développement des capacités sur les trois problèmes fondamentaux suivants :
Comment obtenir un support de stockage de base de données moins coûteux (plutôt que des tables externes) pour réduire les coûts.
Comment garantir que l'efficacité des requêtes et des calculs sur ce stockage à faible coût ne se dégrade pas significativement.
Comment gérer et utiliser plusieurs supports de stockage de manière plus transparente.
L'équipe GanosBase a publié le stockage hiérarchisé polymorphe (données chaudes et froides) pour les données spatiales, construit sur la base de données PolarDB for PostgreSQLOracle syntax compatibility 2,0. Cette capacité utilise directement OSS comme support de stockage de base de données moins cher, pouvant fonctionner conjointement avec le stockage par blocs. Le stockage hiérarchisé polymorphe (données chaudes et froides) permet de stocker une base de données entière, une table unique ou même des champs spécifiques d'une table sur différents supports, tout en conservant une transparence totale des opérations CRUD. Un mécanisme de mise en cache multiniveau limite au minimum la dégradation des performances. Le stockage hiérarchisé polymorphe (données chaudes et froides) est une solution bien équilibrée de gestion des données spatiales, et s'applique également aux types de champs de base de données courants (BLOB, TEXT, JSON, JSONB, ANYARRAY, et autres types).
Présentation des fonctionnalités
Le stockage hiérarchisé polymorphe (données chaudes et froides) de PolarDB for PostgreSQLOracle syntax compatibility 2,0 constitue une évolution de la fonctionnalité traditionnelle de séparation des données chaudes et froides. Il offre d'excellentes performances en lecture et en écriture tout en réduisant au maximum les coûts de stockage. Le stockage hiérarchisé polymorphe (données chaudes et froides) hiérarchise les données selon leur degré d'activité (chaudes ou froides). Il est également compatible avec plusieurs supports de stockage d'objets, tels qu'OSS, MinIO et Hadoop Distributed File System (HDFS). De plus, il propose des combinaisons de stockage flexibles et variées pour les types d'objets volumineux et les types de données spatiales, d'où son appellation de stockage hiérarchisé polymorphe (données chaudes et froides). Actuellement, le stockage polymorphe prend uniquement en charge OSS. Pour plus d'informations, consultez Présentation de la hiérarchisation des données froides.
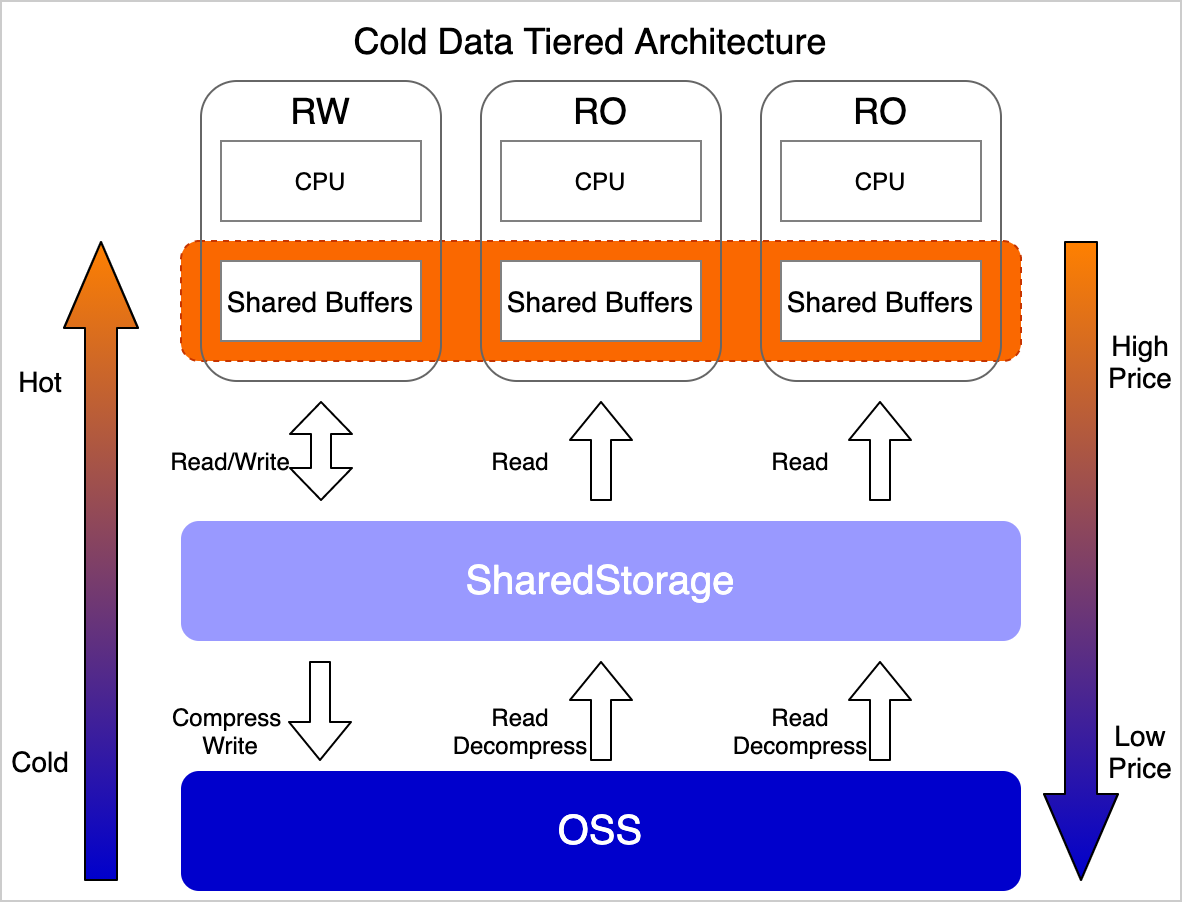
Grâce au stockage hiérarchisé polymorphe (données chaudes et froides), vous pouvez utiliser de simples instructions SQL pour déplacer les données expirées, les données d'objets volumineux et les données spatiales vers OSS, réalisant ainsi une gestion des données élastique, peu coûteuse et hautement fiable. Après le déplacement des données, vous n'avez pas besoin de modifier vos instructions SQL, et les opérations analytiques complexes telles que les insertions, suppressions, mises à jour, requêtes et jointures inter-tables restent totalement transparentes. De plus, lorsque les données sont mises à jour ou consultées plus fréquemment, vous pouvez ajuster dynamiquement le cache matérialisé pour atteindre le même niveau de performance d'accès que les disques cloud de la base de données.
Avantages techniques
Le stockage hiérarchisé polymorphe (données chaudes et froides) de PolarDB for PostgreSQLOracle syntax compatibility 2,0 présente les avantages techniques suivants :
Coût : La compression des données est prise en charge, avec un taux de compression moyen de 50 % et aussi bas que 20 % dans certains cas, réduisant les coûts à un dixième, voire moins.
Performance : La couche de cache matérialisé accélère l'accès aux données froides, maintenant la dégradation des performances entre 20 % et 80 %.
Facilité d'utilisation : Les données sont hiérarchisées du froid au chaud, et après le déplacement des données vers le stockage froid, les instructions SQL CRUD restent totalement transparentes.
Fiabilité : Grâce à la haute durabilité d'OSS, les données froides prennent en charge les snapshots sans stockage supplémentaire, et les données peuvent être restaurées et récupérées.
Flexibilité : Un modèle de stockage hiérarchisé chaud/froid flexible permet de stocker les données dans OSS par table, par champ volumineux ou par sous-partition.
Dimension coût
Les données connaissent aujourd'hui une croissance explosive, en particulier les données multidimensionnelles telles que les données temporelles et spatiales. Avec le temps, les données accumulées atteignent des niveaux de To, voire de Po, tandis que les données historiques ou auxiliaires sont consultées relativement rarement. Dans cette situation, la réduction des coûts de stockage est souvent l'exigence principale. Dans l'architecture de stockage hiérarchisé chaud/froid de PolarDB for PostgreSQL (Compatible with Oracle), les données froides sont d'abord découpées en petits blocs selon des règles, les blocs découpés sont ensuite compressés, et les blocs compressés sont enfin écrits dans OSS. Cela permet d'obtenir un taux de compression de 20 % à 40 % pour les données générales et de 60 % à 70 % pour les données spatio-temporelles, avec un taux de compression moyen de 50 %. Cela revient à déplacer les données stockées sur les disques cloud de la base de données vers OSS tout en divisant par deux le volume de données, réduisant finalement les coûts de stockage à un dixième, voire moins. Ici, le standard de facturation des disques cloud PolarDB, le coût unitaire de stockage d'OSS et le taux de compression obtenu dans OSS sont combinés pour comparer les frais de stockage mensuels pour 100 Go de données :
Disque cloud | Stockage hiérarchisé polymorphe (données chaudes et froides) (sur OSS) | |
Tarification du stockage | PSL40,238 USD/Go/mois |
|
Taux de compression | 0 | 50 % |
Coût total | 0 238 × 100 Go = 23,8 USD |
|
Le coût de stockage final est inférieur à un dixième du coût initial.
Dimension performance
En général, la latence d'accès à OSS est plus de cent fois supérieure à celle des disques cloud de base de données. L'accès direct aux données stockées dans OSS réduirait considérablement les performances en lecture et en écriture. Le stockage polymorphe de PolarDB for PostgreSQLOracle syntax compatibility 2,0 utilise les disques cloud de la base de données pour implémenter une couche de cache matérialisé pour les données OSS. Les données sont automatiquement hiérarchisées en fonction des modèles d'accès réels aux blocs de données. Les opérations de lecture et d'écriture atteignent d'abord le cache matérialisé, ce qui garantit les performances d'accès : les performances globales de mise à jour et d'insertion atteignent 90 % des niveaux des disques partagés, et les performances des requêtes ponctuelles atteignent 80 % des niveaux des disques partagés. La durée de vie des données dans le cache matérialisé est déterminée par la fréquence d'accès, ce qui réduit les coûts de stockage tout en offrant d'excellentes performances d'accès.
Dimension facilité d'utilisation
Le stockage hiérarchisé polymorphe (données chaudes et froides) de PolarDB for PostgreSQL (Compatible with Oracle) est une solution de stockage hiérarchisé chaud/froid totalement transparente et simple à utiliser. Premièrement, après le déplacement des données vers OSS, les opérations d'insertion, de suppression, de mise à jour et de requête sont prises en charge, tout comme les opérations complexes telles que les analyses d'index et les requêtes de jointure. Le SQL est totalement transparent et ne nécessite aucune modification. Deuxièmement, le déplacement des données est également simple et facile à utiliser. Par exemple, les tables partitionnées peuvent être déplacées vers OSS automatiquement selon des règles personnalisées, et les tables de base et les index peuvent être déplacés vers OSS en un clic. Pour les instructions, consultez Bonnes pratiques.
Dimension fiabilité
La durabilité d'OSS atteint 99,9999999999 %, et sa disponibilité atteint 99 995 %. OSS propose également un stockage localement redondant et un stockage redondant inter-zones, ce qui garantit la fiabilité des données dans OSS. Cependant, cela ne signifie pas que les données déjà stockées dans OSS ne nécessitent aucune sauvegarde ni récupération. Bien que les données de base de données stockées dans OSS soient mises à jour et consultées moins fréquemment, elles prennent toujours en charge l'analyse des requêtes importantes et l'exploration de données dans les scénarios métier. Si des données sont modifiées ou supprimées par erreur, il doit être possible de les restaurer et de les récupérer rapidement. Le stockage hiérarchisé polymorphe (données chaudes et froides) de PolarDB for PostgreSQL (Compatible with Oracle) prend en charge la sauvegarde et la récupération des données froides. Il fournit une gestion des données multiversion basée sur le mécanisme Copy-On-Write et des snapshots au niveau de la seconde. Après la prise d'un snapshot, seuls les blocs de données mis à jour génèrent des copies ; les blocs de données non mis à jour n'en génèrent pas. Cela offre des données véritablement fiables à un coût minimal.
Dimension flexibilité
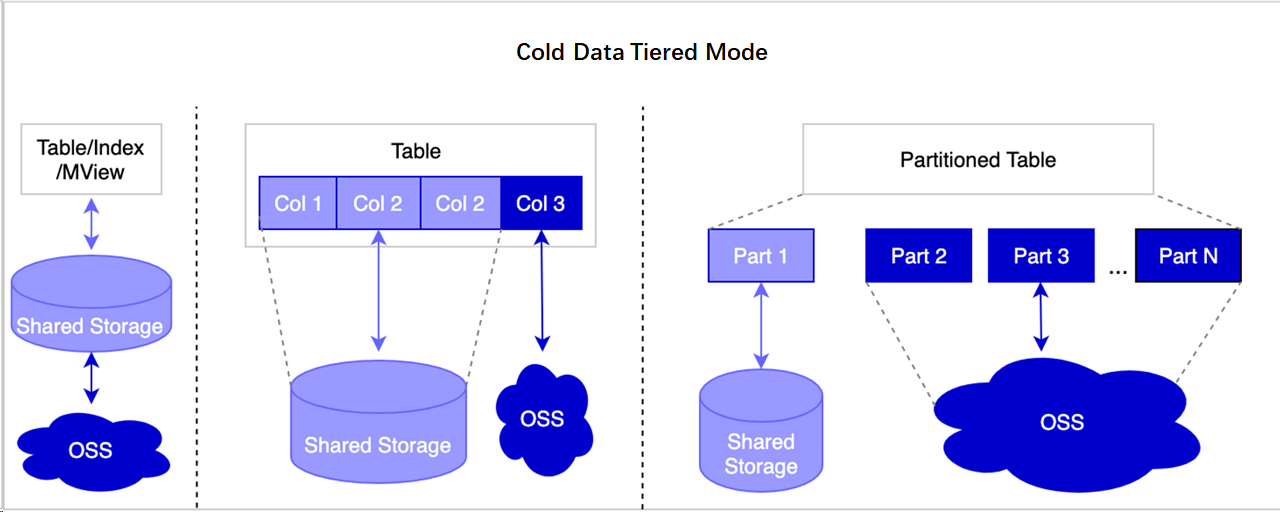
Le stockage hiérarchisé polymorphe (données chaudes et froides) de PolarDB for PostgreSQL (Compatible with Oracle) prend en charge des combinaisons flexibles de stockage chaud et froid. Les modes de combinaison suivants sont pris en charge :
Stocker toutes les données de la table dans OSS et conserver les index sur les disques cloud, ce qui réduit les coûts tout en garantissant de bonnes performances d'accès.
Stocker indépendamment les champs volumineux et les champs auxiliaires d'une table dans OSS, et conserver les champs restants sur les disques cloud.
Stocker uniquement les sous-partitions expirées d'une table partitionnée dans OSS et conserver les partitions chaudes sur les disques cloud. Il s'agit du mode de séparation chaud/froid le plus classique. Plusieurs combinaisons peuvent en découler. Par exemple, les données et les index des partitions froides sont stockés dans OSS ; les données des partitions tièdes sont stockées dans OSS mais les index sont conservés sur les disques cloud ; et les partitions chaudes restent entièrement sur les disques cloud, de sorte que les performances des requêtes ne sont pratiquement pas dégradées.
Bonnes pratiques
Cas 1 : Déplacement automatique des sous-partitions expirées d'une table partitionnée vers le stockage à froid
Contexte
Les données de trajectoire sont stockées dans une table partitionnée par mois. Avec le temps, la fréquence d'accès aux données de trajectoire âgées de plus de trois mois chute considérablement et ces données deviennent obsolètes. Afin de réduire les coûts de stockage, la base de données doit déplacer automatiquement vers le stockage à froid les partitions datant de plus de trois mois.
Procédure
-
Créez une base de données de test. Pour obtenir des instructions, consultez les rubriques et Database management, puis exécutez les instructions suivantes pour préparer les données de test.
-- Create a partitioned table CREATE TABLE traj( tr_id serial, tr_lon float, tr_lat float, tr_time timestamp(6) )PARTITION BY RANGE (tr_time); CREATE TABLE traj_202301 PARTITION OF traj FOR VALUES FROM ('2023-01-01') TO ('2023-02-01'); CREATE TABLE traj_202302 PARTITION OF traj FOR VALUES FROM ('2023-02-01') TO ('2023-03-01'); CREATE TABLE traj_202303 PARTITION OF traj FOR VALUES FROM ('2023-03-01') TO ('2023-04-01'); CREATE TABLE traj_202304 PARTITION OF traj FOR VALUES FROM ('2023-04-01') TO ('2023-05-01'); -- Insert test data into the partitioned table INSERT INTO traj(tr_lon,tr_lat,tr_time) values(112.35, 37.12, '2023-01-01'); INSERT INTO traj(tr_lon,tr_lat,tr_time) values(112.35, 37.12, '2023-02-01'); INSERT INTO traj(tr_lon,tr_lat,tr_time) values(112.35, 37.12, '2023-03-01'); INSERT INTO traj(tr_lon,tr_lat,tr_time) values(112.35, 37.12, '2023-04-01'); -- Create an index on the partitioned table CREATE INDEX traj_idx on traj(tr_id); -
Dans la base de données de test, créez l'extension
polar_osfs_toolkitpour activer les fonctions utilitaires, notamment la migration en un clic des tables principales et des index vers OSS, ainsi que la migration en un clic des tables partitionnées vers OSS.CREATE extension polar_osfs_toolkit; -
Utilisez un compte à privilèges élevés pour vous connecter à la base de données
postgreset installez l'extension pg_cron. Pour plus d'informations sur les considérations associées, consultez les rubriques et pg_cron.--- Only a high-privilege account connected to the postgres database can run this statement to create the pg_cron extension CREATE EXTENSION pg_cron; -
Configurez une tâche planifiée. Utilisez un compte à privilèges élevés pour vous connecter à la base de données
postgreset créez une tâche nommée task1 pour la base de données de test. Cette tâche appelle une procédure stockée afin de déplacer automatiquement vers OSS les partitions historiques antérieures à la partition 3. La fonction renvoie un ID de tâche :-- Run every minute SELECT cron.schedule_in_database('task1', '* * * * *', 'select polar_alter_subpartition_to_oss(''traj'', 3);', 'db01');Le résultat est le suivant :
schedule_in_database ---------------------- 1 -
Consultez le résultat d'exécution et l'historique des exécutions.
-
Utilisez l'outil psql dans la base de données de test pour afficher l'emplacement de stockage de la table partitionnée :
\d+ traj_202301Le résultat est le suivant :
Table "public.traj_202301" Column | Type | Collation | Nullable | Default | Storage | Compression | Stats target | Description ---------+--------------------------------+-----------+----------+-------------------------------------+---------+-------------+--------------+------------- tr_id | integer | | not null | nextval('traj_tr_id_seq'::regclass) | plain | | | tr_lon | double precision | | | | plain | | | tr_lat | double precision | | | | plain | | | tr_time | timestamp(6) without time zone | | | | plain | | | Partition of: traj FOR VALUES FROM ('2023-01-01 00:00:00') TO ('2023-02-01 00:00:00') Partition constraint: ((tr_time IS NOT NULL) AND (tr_time >= '2023-01-01 00:00:00'::timestamp(6) without time zone) AND (tr_time < '2023-02-01 00:00:00'::timestamp(6) without time zone)) Replica Identity: FULL Tablespace: "oss" -- Already stored in OSS Access method: heap -
Dans la base de données
postgres, vous pouvez consulter l'historique d'exécution des tâches planifiées.SELECT * FROM cron.job_run_details;
-
Cette pratique permet de déplacer automatiquement les partitions expirées d'une table partitionnée vers le stockage à froid selon des règles personnalisées. Une fois déplacées vers le stockage à froid, ces partitions n'occupent plus d'espace sur le disque cloud, ce qui réduit considérablement les coûts de stockage, tandis que les opérations CRUD restent totalement transparentes.
Cas 2 : Stockage hiérarchisé des champs volumineux dans une table unique
Contexte
Les champs volumineux incluent les types BLOB, TEXT, JSON, JSONB, ANYARRAY ainsi que les champs de et spatiotemporal engine types. Ce cas d'utilisation explique comment séparer les champs volumineux d'une table et les stocker indépendamment dans OSS tout en conservant un accès transparent, afin de réduire les coûts en séparant les données chaudes et froides au niveau des champs.
Procédure
-
Créez une table contenant des champs volumineux. Cet exemple utilise le type
TEXT. Les champs volumineux d'autres types s'utilisent de manière similaire.CREATE TABLE blob_table(id serial, val text); -
Définissez l'emplacement de stockage du champ volumineux.
ALTER TABLE blob_table ALTER COLUMN val SET (storage_type='oss'); -
Insérez des données et vérifiez le stockage.
-
Insérez des données. À ce stade, le champ val est entièrement stocké dans OSS.
INSERT INTO blob_table(val) VALUES((SELECT string_agg(random()::text, ':') FROM generate_series(1, 100000))); -
Vérifiez l'emplacement de stockage du champ val.
WITH tmp AS (SELECT 'pg_toast_'||b.oid||'_'||c.attnum AS tblname FROM pg_class b, pg_attribute c WHERE b.relname='blob_table' AND c.attrelid=b.oid AND c.attname='val') SELECT t.spcname AS storage_engine FROM pg_tablespace t, pg_class r, tmp m WHERE r.relname = m.tblname AND t.oid=r.reltablespace;Le résultat est le suivant :
 storage_engine
----------------
 oss
(1 row)
-
Seules les données écrites après l'exécution de l'instruction SQL
ALTER COLUMNdéfinissant l'emplacement de stockage d'un champ volumineux sont effectivement stockées dans OSS.Pour une table existante, si vous souhaitez déplacer un champ volumineux vers OSS, commencez par exécuter l'instruction SQL
ALTER COLUMNpour définir l'emplacement de stockage du champ volumineux, puis exécutezVACUUM FULLafin de réécrire les données. Si vous n'exécutez pasVACUUM FULL, les données historiques restent sur les disques cloud, tandis que les nouvelles données écrites sont stockées dans OSS. L'exécution ou non de cette instruction n'affecte pas les opérations CRUD sur les données de la table. Notez que si le volume de données est important, l'exécution peut prendre beaucoup de temps et la table ne pourra fournir ni services de lecture ni services d'écriture pendant l'exécution.
Cas 3 : Réduction des coûts et amélioration de l'efficacité dans les scénarios d'analyse spatio-temporelle (cas avancé)
L'analyse spatio-temporelle consiste à utiliser les capacités de la base de données pour effectuer l'exploration de données et l'analyse statistique de données dans des scénarios couvrant l'espace intégral, le domaine spatio-temporel et les séries chronologiques. Cette section prend pour exemple l'analyse statistique d'images de télédétection afin d'illustrer comment les scénarios d'analyse spatio-temporelle peuvent réduire les coûts de stockage grâce au stockage hiérarchisé polymorphe (données chaudes et froides) tout en maintenant une bonne efficacité analytique.
Ce cas d'utilisation constitue une pratique avancée. Vous pouvez choisir d'ignorer les étapes de traitement intermédiaires et vous concentrer directement sur les résultats de comparaison finaux.
Contexte
Les données d'images de télédétection (raster) sont de plus en plus largement utilisées dans les charges de travail spatiales. Étant donné que les données de télédétection sont volumineuses et impliquent généralement plusieurs charges de travail telles que la navigation dans les images et l'analyse statistique, la réduction des coûts de stockage et l'amélioration de la facilité d'utilisation sont souvent plus attractives pour les charges de travail analytiques non temps réel. Ce cas d'utilisation décrit comment utiliser le stockage OSS rentable pour prendre en charge l'ingestion et la gestion des images de télédétection tout en offrant une efficacité équivalente pour l'analyse statistique.
Procédure
-
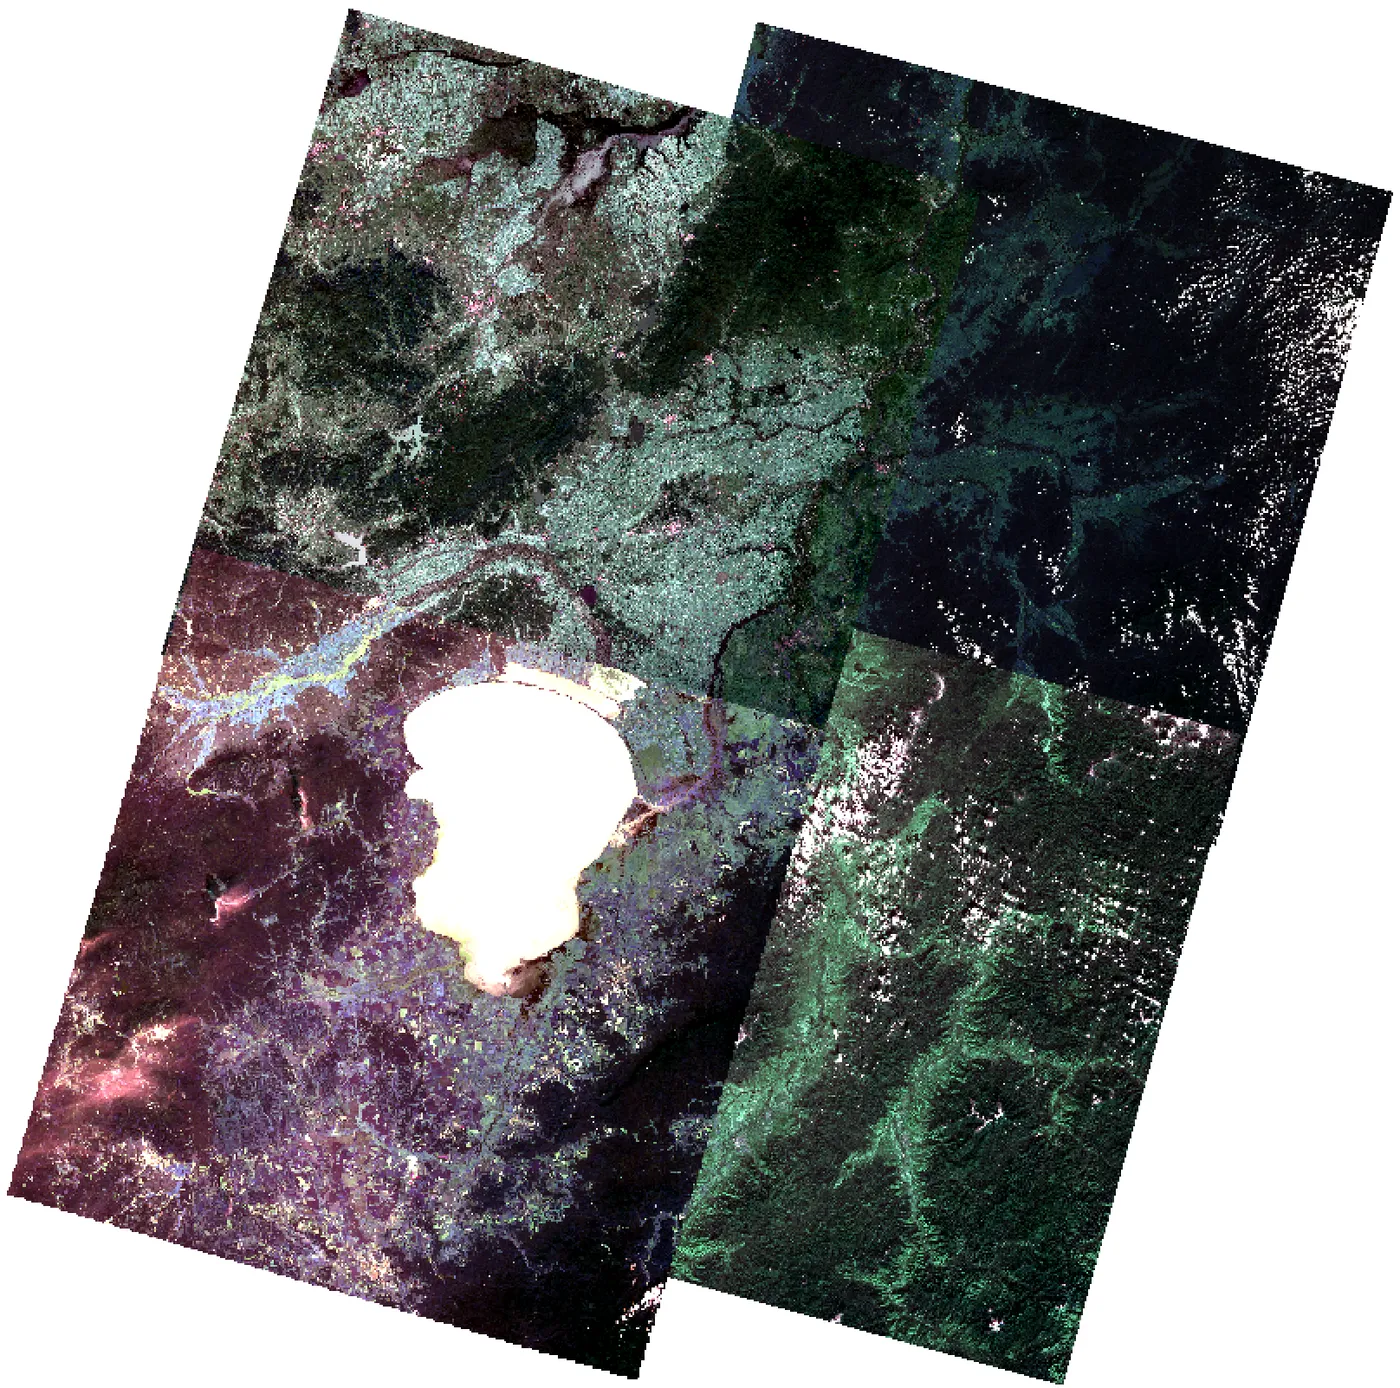
Préparez les données. Préparez quatre images Landsat de télédétection. Vous pouvez préparer ces données vous-même.
-
Ingérez les données d'images de télédétection.
Créez une base de données de test nommée rastdb.
-
Installez l'extension ganos_raster dans la base de données de test. Pour plus d'informations, consultez les rubriques et GanosBase Raster.
CREATE EXTENSION ganos_raster CASCADE; -
Importez les données d'image.
CREATE TABLE raster_table (id integer, rast raster);
INSERT INTO raster_table VALUES (1, ST_ImportFrom('rbt','/home/postgres/LC08_L1TP_113028_20190912_20190917_01_T1.TIF'));
INSERT INTO raster_table VALUES (2, ST_ImportFrom('rbt','/home/postgres/LC08_L1TP_113029_20191030_20191114_01_T1.TIF'));
INSERT INTO raster_table VALUES (3, ST_ImportFrom('rbt','/home/postgres/LC08_L1TP_114028_20191005_20191018_01_T1.TIF'));
INSERT INTO raster_table VALUES (4, ST_ImportFrom('rbt','/home/postgres/LC08_L1TP_114029_20200905_20200917_01_T1.TIF'));
-
Mesurez l'espace de stockage occupé par les données. Dans GanosBase, le type raster est un mode dans lequel les métadonnées et les données de blocs sont stockées séparément mais gérées conjointement. La table de base stocke les métadonnées de l'image et les tables de chunks stockent les données de blocs de l'image. Pour faciliter la mesure de la taille des données dans les tables de chunks, créez manuellement une procédure stockée :
CREATE OR REPLACE FUNCTION raster_data_internal_total_size( rast_table_name text, rast_column_name text)
  RETURNS int8 AS $$
DECLARE
    sql                 text;
    sql2                text;
    rec                 record;
    size                int8;
    totalsize           int8;
    tbloid              Oid;
BEGIN
    size := 0;
    totalsize := 0;

    -- Query the chunk tables of raster objects
    sql = format('select distinct(st_datalocation(%s)) as tblname from %s where st_rastermode(%s) = ''INTERNAL'';', rast_column_name, rast_table_name, rast_column_name);
    for rec in
        execute sql
    loop
        sql2 = format('select a.oid from pg_class a, pg_tablespace b where a.reltablespace = b.oid and b.spcname=''oss'' and a.relname=''%s'';', rec.tblname);
        execute sql2 into tbloid;

        if (tbloid > 0) then
            size := 0;
        else
            -- Measure the size of each table
            sql2 = format('select pg_total_relation_size(''%s'');',rec.tblname);
            execute sql2 into size;
        end if;
        totalsize := (totalsize + size);
    end loop;
    return totalsize;
END;
$$ LANGUAGE plpgsql;
Une fois la procédure stockée créée, effectuez la mesure. Le résultat indique que les données d'image occupent actuellement environ 1,2 Go d'espace de stockage de la base de données.
SELECT pg_size_pretty(raster_data_internal_total_size('raster_table','rast'));Le résultat est le suivant :
pg_size_pretty ---------------- 1319 MB (1 row) -
Calculez l'NDVI. Les données sont stockées sur des disques cloud. Effectuez d'abord un calcul NDVI. Pendant le calcul, plusieurs images doivent être imbriquées et assemblées, et l'NDVI est calculé à partir de l'image complète obtenue par assemblage. Enregistrez le temps nécessaire. Pour plus d'informations, consultez les rubriques et ST_MosaicFrom.
CREATE TABLE rast_mapalgebra_result(id integer, rast raster);

INSERT INTO rast_mapalgebra_result SELECT 1, ST_MapAlgebra(ARRAY(SELECT st_mosaicfrom(ARRAY(SELECT rast FROM raster_table ORDER BY id), 'rbt_mosaic','','{"srid":4326,"cell_size":[0.005,0.005]')),    '[{"expr":"([0,3] - [0,2])/([0,3] + [0,2])","nodata": true, "nodataValue":0}]',    '{"chunktable":"rbt_algebra","celltype":"32bf"}');
Le résultat est le suivant :
INSERT 0 1 Time: 39874.189 ms (00:39.874) -
Déplacez les données de blocs d'image vers le stockage à froid. Déplacez les données de blocs des images de télédétection vers le stockage à froid dans OSS, tandis que les métadonnées des images de télédétection restent sur les disques cloud. Pour faciliter cette opération, créez une procédure stockée :
CREATE OR REPLACE FUNCTION raster_data_alter_to_oss( rast_table_name text, rast_column_name text)
  RETURNS VOID AS $$
DECLARE
    sql                 text;
    sql2                text;
    rec                 record;
BEGIN
    -- Query the data tables of raster objects
    sql = format('select distinct(st_datalocation(%s)) as tblname from %s where st_rastermode(%s) = ''INTERNAL'';', rast_column_name, rast_table_name, rast_column_name);
    for rec in
        execute sql
    loop
        sql2 = format('alter table %s set tablespace oss;',rec.tblname);
        execute sql2;
    end loop;
END;
$$ LANGUAGE plpgsql;
Une fois la procédure stockée créée, exécutez le processus de stockage à froid. Mesurez ensuite à nouveau l'espace disque cloud occupé par les tables de chunks :
SELECT raster_data_alter_to_oss('raster_table', 'rast');

-- Measure the cloud disk space occupied by block data after cold storage
SELECT pg_size_pretty(raster_data_internal_total_size('raster_table','rast'));
Le résultat indique que l'espace de stockage sur disque partagé mesuré est de 0, ce qui signifie que toutes les données de blocs sont désormais stockées dans OSS.
pg_size_pretty ---------------- 0 bytes (1 row) -
Recalculez l'NDVI. Une fois les blocs de données stockés dans OSS, effectuez à nouveau le calcul NDVI :
INSERT INTO rast_mapalgebra_result select 2, ST_MapAlgebra(ARRAY(select st_mosaicfrom(ARRAY(SELECT rast FROM raster_table ORDER BY id), 'rbt_mosaic','','{"srid":4326,"cell_size":[0.005,0.005]')), '[{"expr":"([0,3] - [0,2])/([0,3] + [0,2])","nodata": true, "nodataValue":0}]', '{"chunktable":"rbt_algebra","celltype":"32bf"}');Le résultat est le suivant :
INSERT 0 1
Time: 69414.201 ms (01:09.414)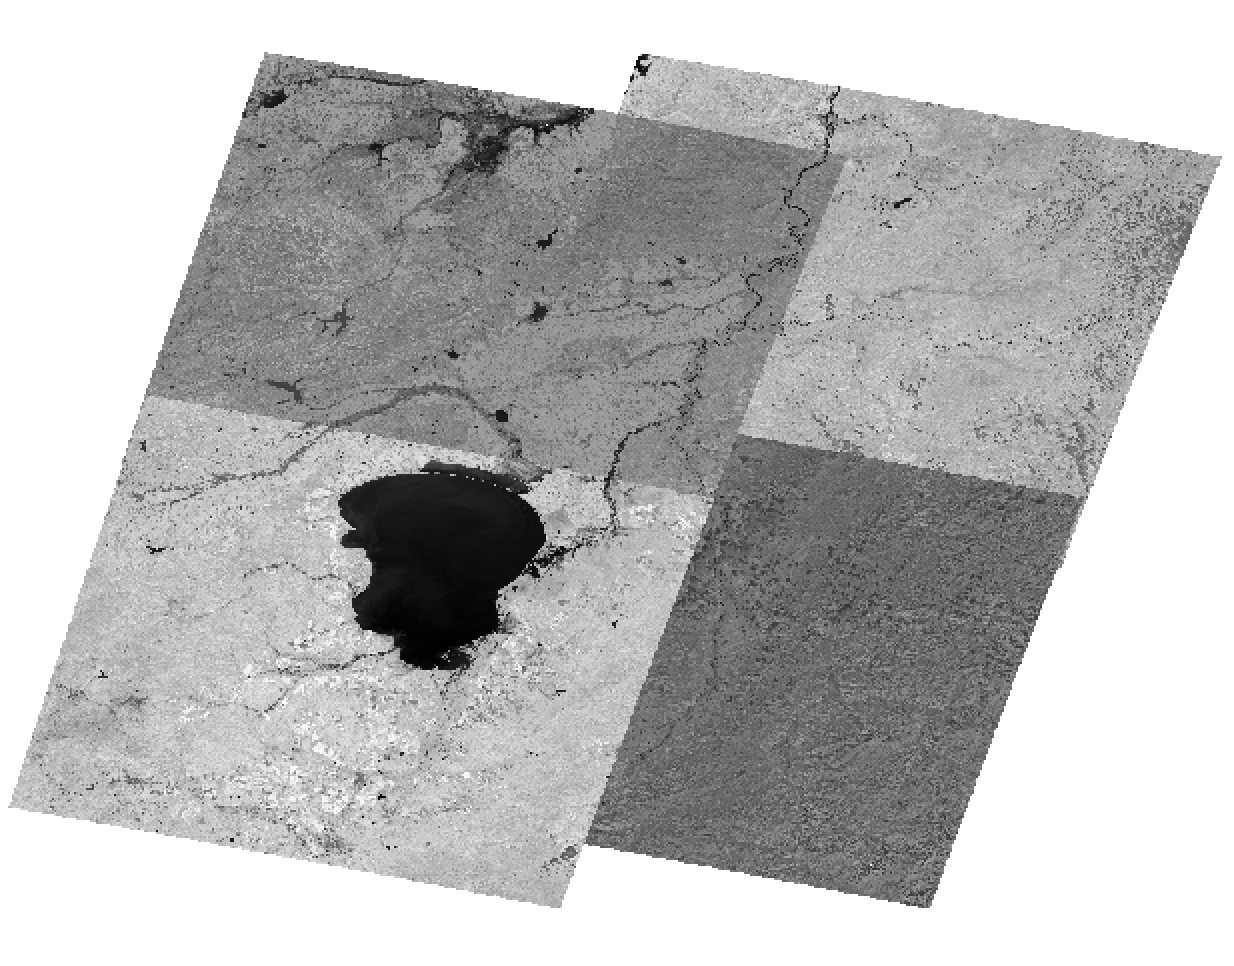
-
Comparez les coûts de stockage et les performances.
Métrique
Stockage sur disque cloud
Stockage à froid OSS
Rapport
Coût de stockage
1319 Mo à 0 238 USD/Go/mois coûtent 0,31 USD.
1011,834 Mo à 0,0232 USD/Go/mois coûtent 0 023 USD.
10:1
Temps de calcul NDVI
39 s
69 s
1:1,76
La comparaison montre que le coût d'utilisation du stockage à froid OSS est inférieur à un dixième de celui des disques partagés, et la dégradation des performances de calcul reste inférieure à 1×. Ce rapport qualité-prix est très précieux dans les scénarios d'analyse statistique qui ne nécessitent pas de réponse en temps réel (RT).
Résumé
À ce jour, GanosBase a pris en charge avec succès des milliers de scénarios d'application dans des dizaines de secteurs. La stabilité, la rentabilité, les performances et la facilité d'utilisation ont toujours été les objectifs poursuivis à long terme par GanosBase. Le stockage polymorphe couvrant l'espace intégral constitue une compétence centrale au niveau du noyau que GanosBase a développée sur la base de données et PolarDB for PostgreSQL (Compatible with Oracle). Il offre une solution de gestion des données couvrant l'espace intégral qui équilibre véritablement le coût, les performances et la facilité d'utilisation. Nous vous invitons à l'activer et à l'essayer.