Découvrez comment activer, configurer et contrôler l'ePQ pour PolarDB for MySQL, notamment les seuils d'exécution parallèle, la syntaxe des hints et les limites connues.
Prérequis
-
Vérifiez que votre cluster prend en charge la requête parallèle élastique.
-
Requête parallèle élastique sur nœud unique :
Moteur de base de données : version 8.0.1 dont la révision est 8.0.1.0.5 ou ultérieure.
Édition de la base de données : Enterprise Edition .
-
Requête parallèle élastique sur nœud unique :
Moteur de base de données : version 8.0.2 dont la révision est 8.0.2.1.4.1 ou ultérieure.
Édition de la base de données : Enterprise Edition.
-
Requête parallèle élastique multi-nœuds :
Moteur de base de données : version 8.0.2 dont la révision est 8.0.2.2.6 ou ultérieure.
Édition de la base de données : Enterprise Edition.
-
Consultez la section Limites et problèmes de compatibilité avant d'activer la requête parallèle.
Les nœuds en lecture seule et les nœuds RW prennent tous deux en charge la requête parallèle, mais celle-ci est désactivée par défaut sur les nœuds RW. Pour l'activer sur ces derniers, reportez-vous à la section Ajuster automatiquement le degré de parallélisme.
Connectez-vous à la console PolarDB. Dans le volet de navigation de gauche, cliquez sur Clusters. Sélectionnez la région où se trouve le cluster, puis cliquez sur l'ID du cluster pour accéder à sa page de détails.
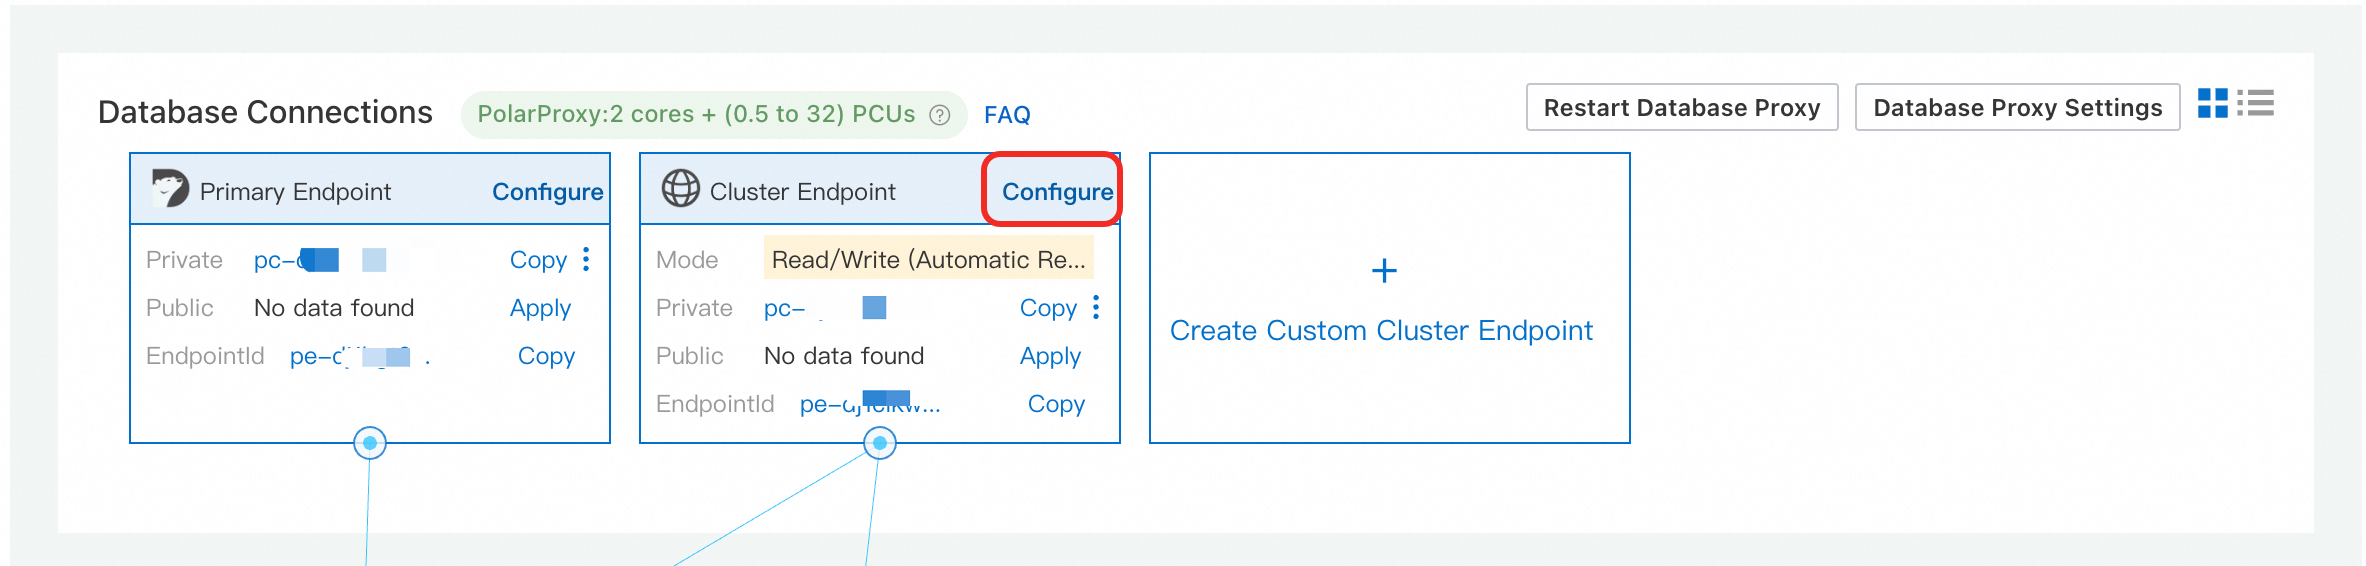
Sur la page Basic Information du cluster, localisez la section Database Connection. Sélectionnez l'endpoint cible et cliquez sur Configure.
Dans la boîte de dialogue Edit Endpoint Configuration, enable la requête parallèle et configurez le Degree of Parallelism. Les autres paramètres de l'endpoint sont décrits dans la rubrique Configurer un proxy de base de données.
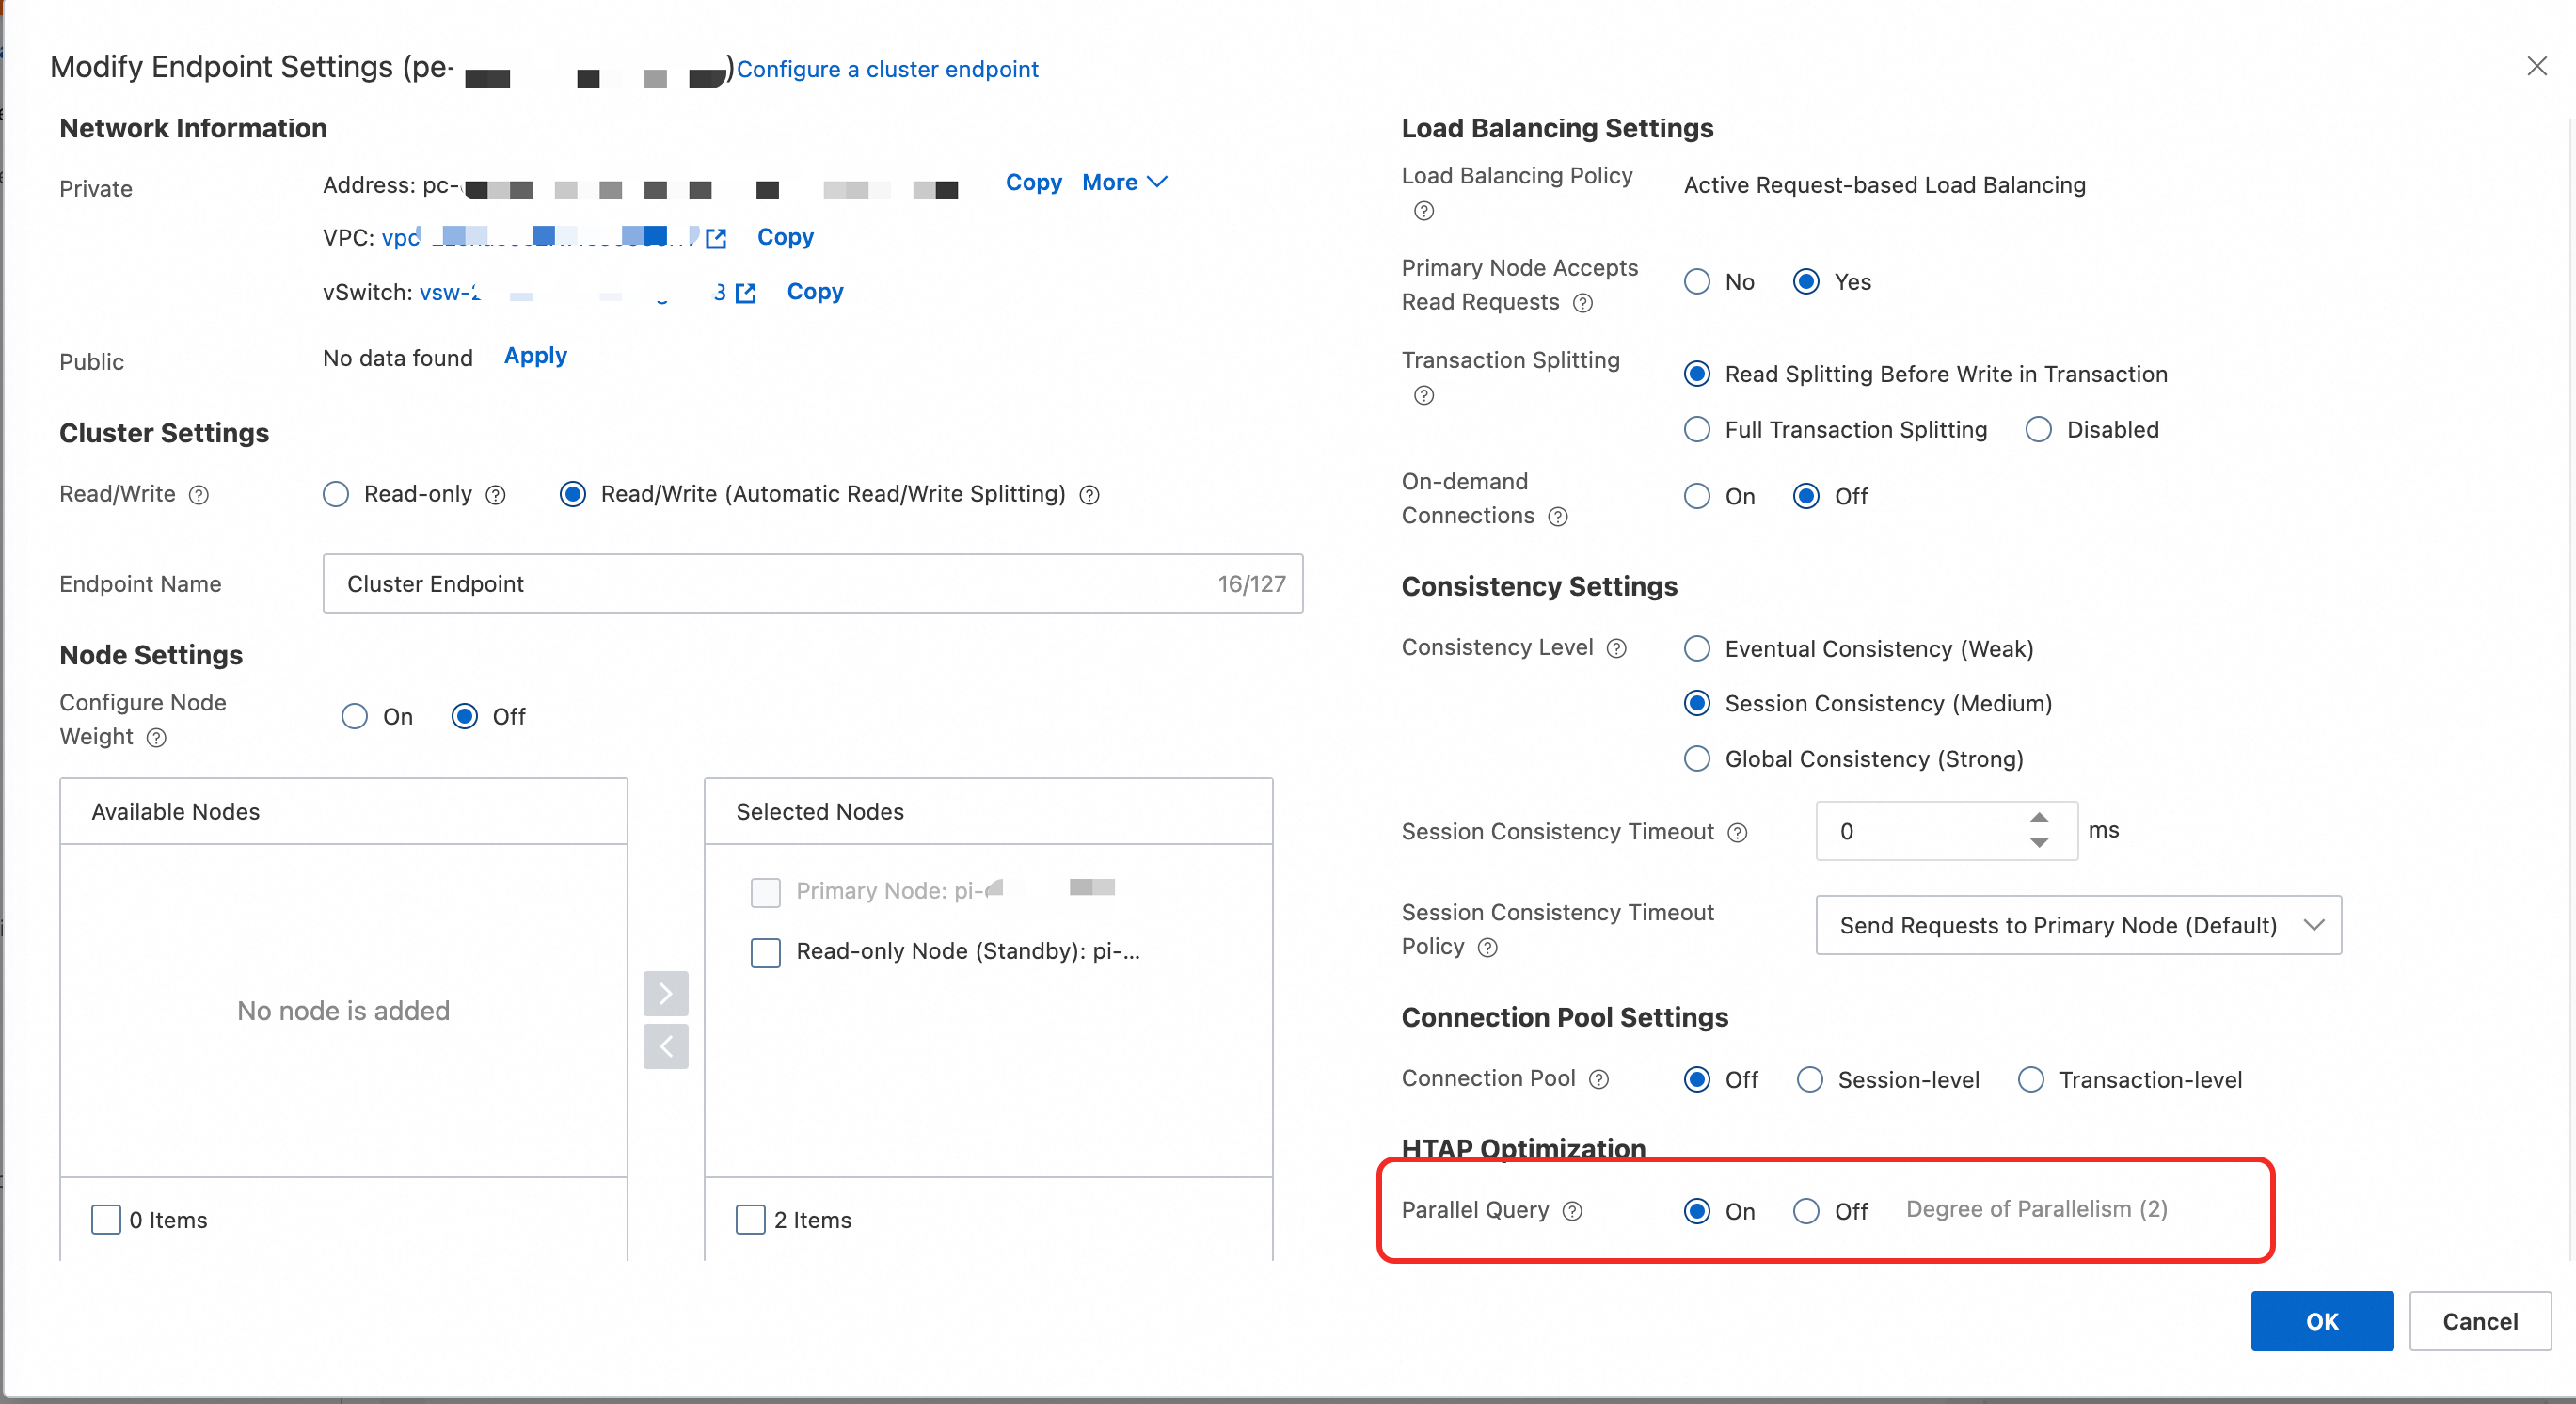
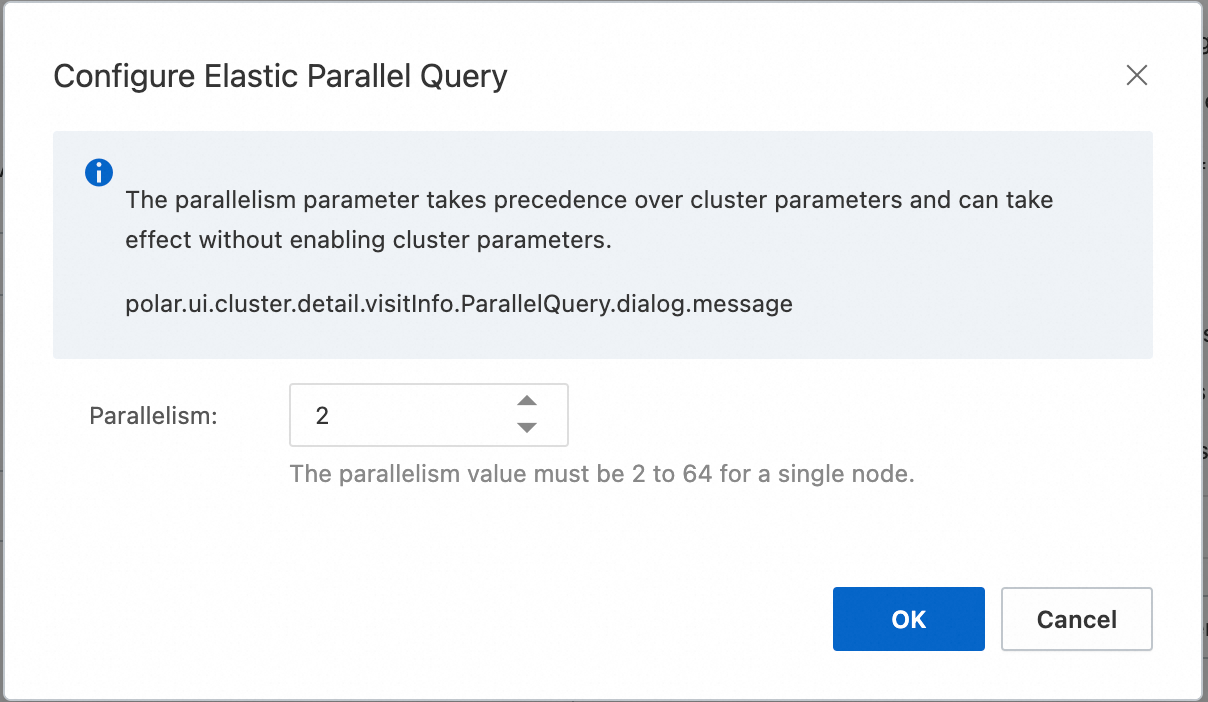
Le paramètre Degree of Parallelism définit le nombre maximal de threads de travail qu'une seule requête peut utiliser sur un nœud de calcul. Le nombre total de threads par requête correspond au Degree of Parallelism multiplié par le nombre de nœuds.
Augmentez progressivement le degré de parallélisme sans dépasser le quart du nombre de cœurs CPU. Commencez avec une valeur de 2. Après une journée, augmentez cette valeur si la charge CPU reste faible ; arrêtez l'augmentation si elle s'élève.
L'activation de la requête parallèle ne s'applique qu'aux nouvelles connexions.
-
Les paramètres de la console et ceux du cluster interagissent comme suit :
Le paramètre
loose_max_parallel_degrees'applique à tous les nœuds et connexions du cluster, tandis que les ajustements effectués dans la console ne concernent que l'endpoint configuré.Si le paramètre de la console et
loose_max_parallel_degreesont tous deux configurés, le paramètre de la console est prioritaire. Utilisez la console pour activer la parallel query.Si la parallel query n'est pas activée dans la console mais que
loose_max_parallel_degreeest supérieur à 0, la requête parallèle sur nœud unique est activée par défaut.
RemarqueLe paramètre
loose_max_parallel_degreedéfinit le nombre maximal de threads de travail pour l'exécution parallèle d'une requête unique. Consultez la Description des paramètres. Connectez-vous à la console PolarDB. Dans le volet de navigation de gauche, cliquez sur Clusters. Sélectionnez la région où se trouve le cluster, puis cliquez sur l'ID du cluster pour accéder à sa page de détails.
Sur la page Basic Information du cluster, localisez la section Database Connection. Sélectionnez l'endpoint cible et cliquez sur Configure.
Dans la boîte de dialogue Edit Endpoint Configuration, disable la requête parallèle.
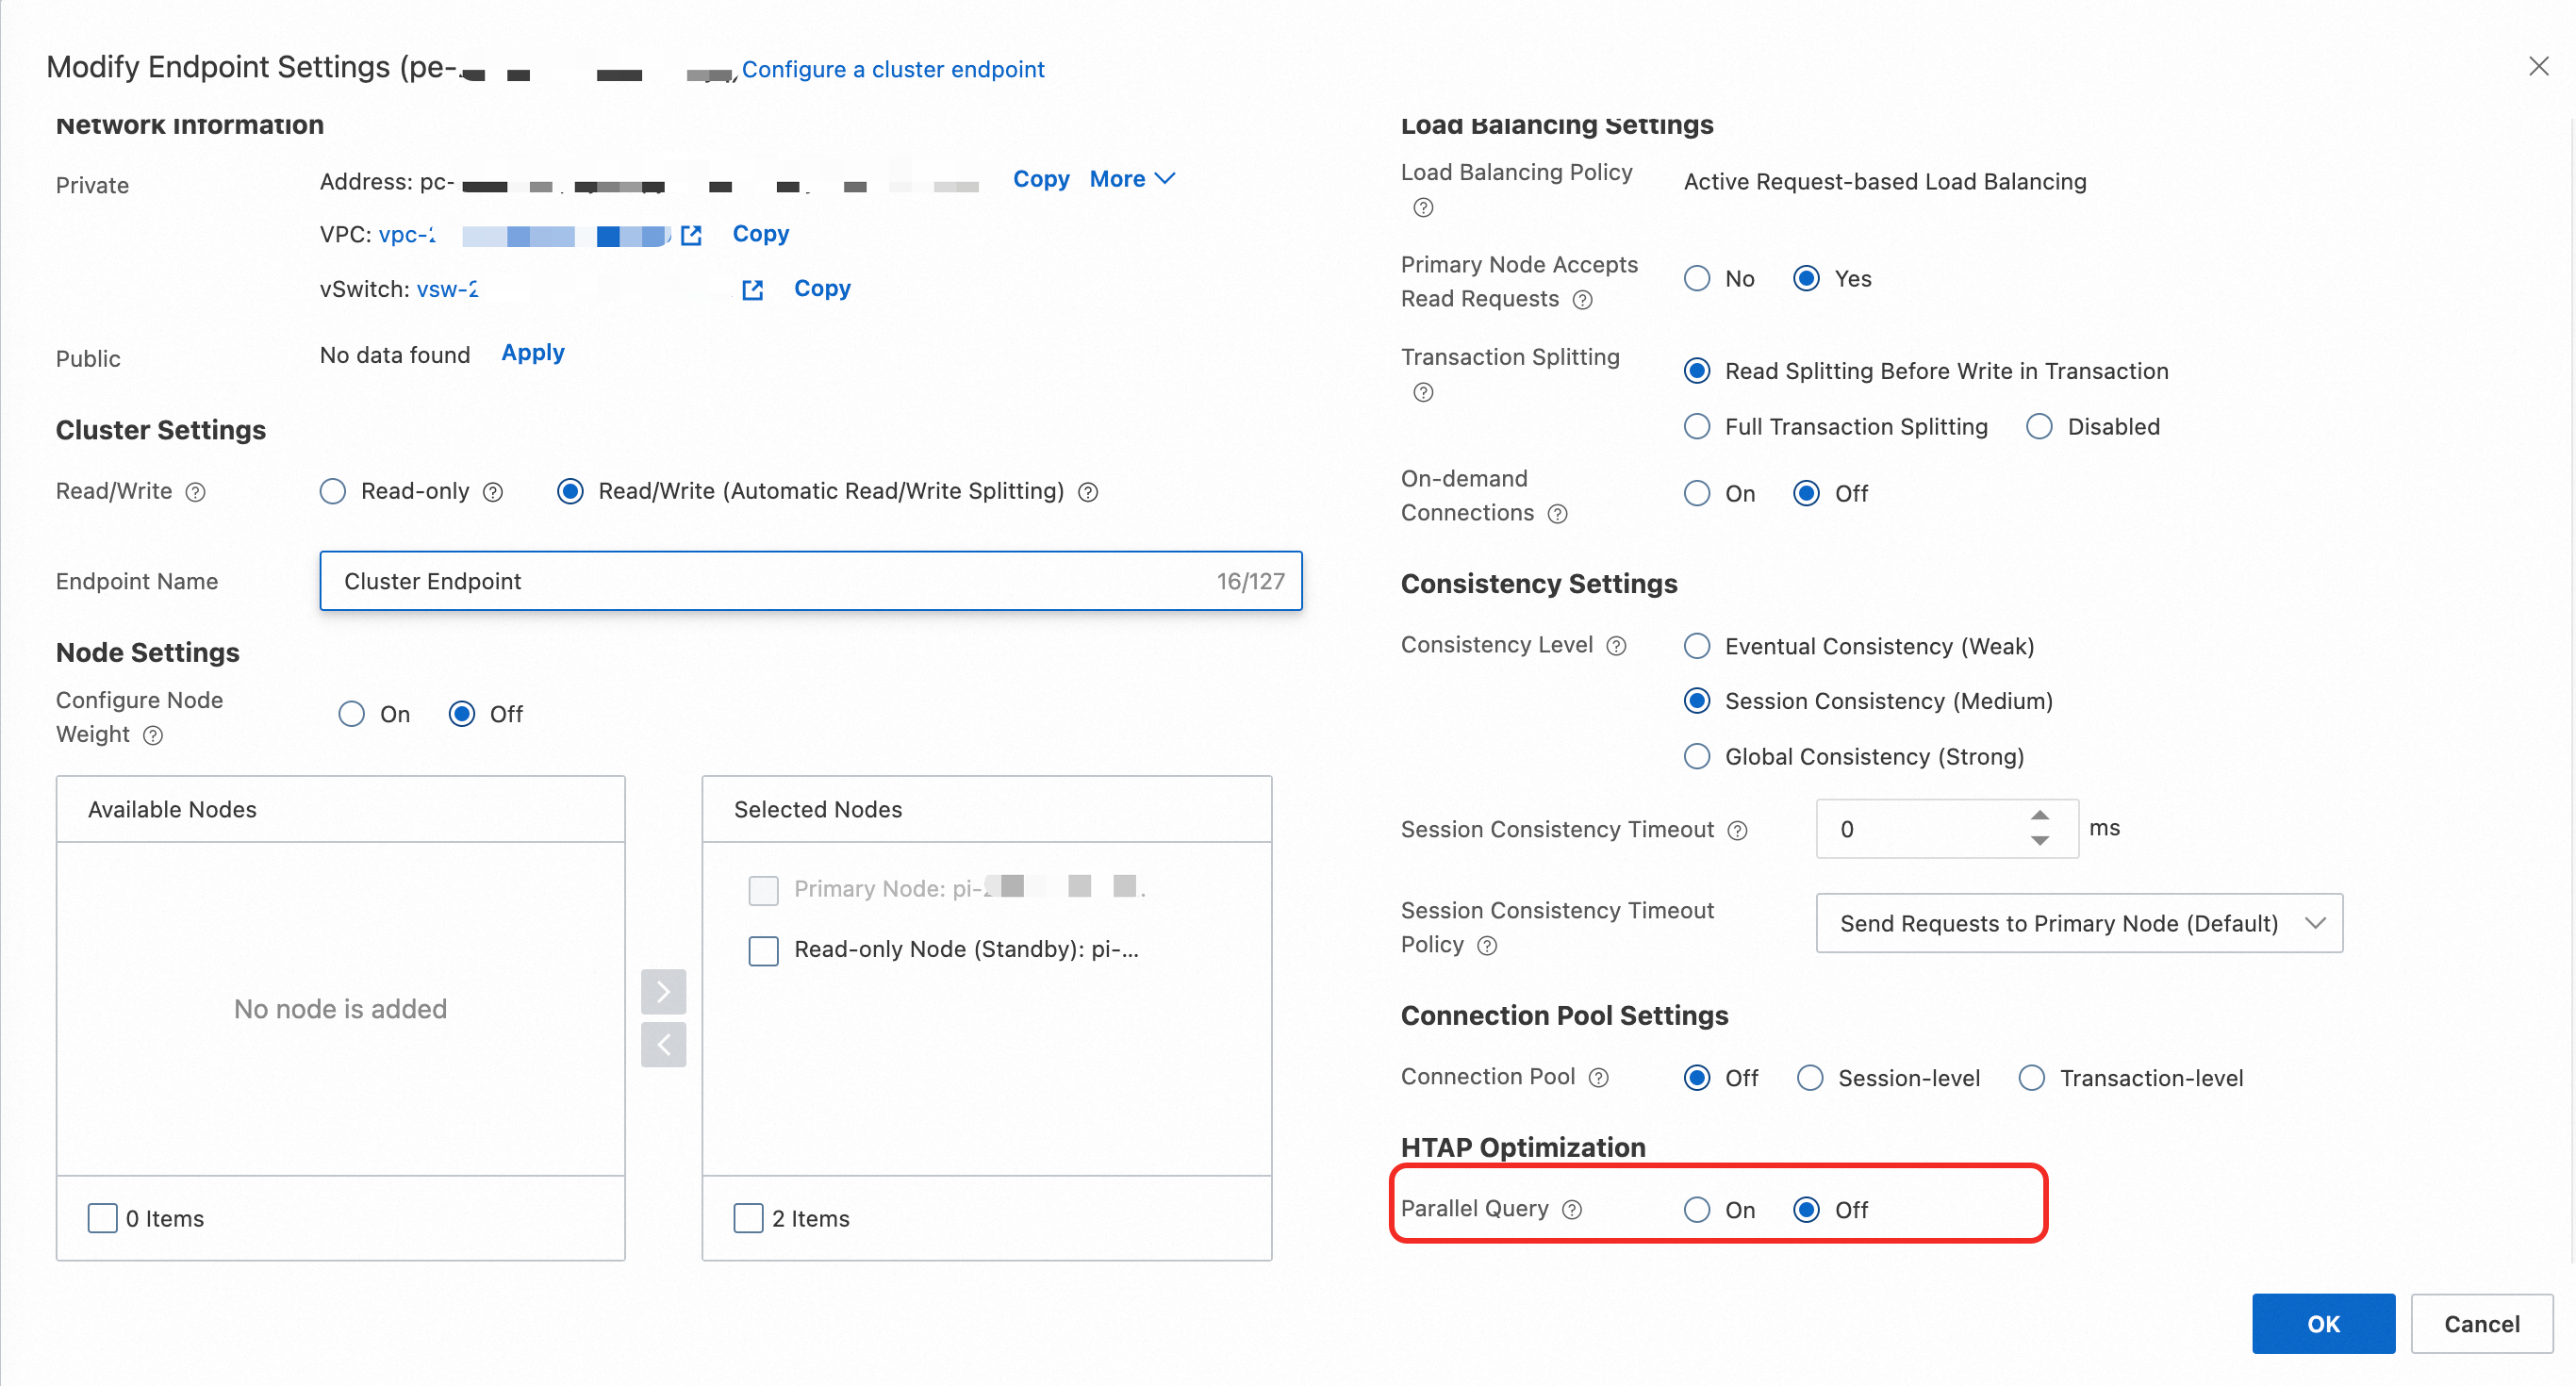
La désactivation de la requête parallèle ne s'applique qu'aux nouvelles connexions.
-
Après avoir désactivé la requête parallèle dans la console, vérifiez que
loose_max_parallel_degreeest également défini sur 0.RemarqueLe paramètre
loose_max_parallel_degreedéfinit le nombre maximal de threads de travail pour l'exécution parallèle d'une requête unique. Consultez la Description des paramètres. -
loose_records_threshold_for_parallelismLorsque le nombre estimé de lignes analysées dans une table dépasse ce seuil, l'optimiseur envisage un plan parallèle. Valeur par défaut : 10 000. Pour les petits jeux de données ou une faible concurrence de requêtes, définissez une valeur égale ou supérieure à 2000.
RemarqueLe nombre de lignes analysées est une estimation basée sur les statistiques de la table et peut ne pas être exact.
-
loose_cost_threshold_for_parallelismLorsque le coût estimé d'exécution séquentielle dépasse ce seuil, l'optimiseur envisage un plan parallèle. Valeur par défaut : 50000.
-
loose_records_threshold_for_mppSi le nombre estimé de lignes analysées d'une table excède ce seuil, l'optimiseur passe d'un mode parallèle sur nœud unique à un mode multi-nœuds. By default, this value is N times the value of loose_records_threshold_for_parallelism, where N is the number of nodes within the current cluster endpoint.
-
loose_cost_threshold_for_mppSi le coût d'exécution séquentielle d'une requête dépasse ce seuil, l'optimiseur bascule vers le parallélisme multi-nœuds. By default, this value is N times the value of loose_cost_threshold_for_parallelism, where N is the number of nodes within the current cluster endpoint.
Les requêtes portant sur des tables autres que
InnoDBne peuvent pas être exécutées en parallèle.L'exécution parallèle n'est pas prise en charge pour les requêtes utilisant un index plein texte.
Les expressions contenant des
Proceduresstockées doivent être exécutées sur le nœud leader.Si une table est analysée via
Index Merge, l'analyse de cette table ne peut pas être parallélisée.Les instructions de requête au sein de transactions avec un niveau d'isolation sérialisable ne peuvent pas être exécutées en parallèle.
Avec un niveau d'isolation
Repeatable-read, la partie requête des instructionsINSERT ... SELECT/REPLACE ... SELECTau sein d'une transaction ne peut pas bénéficier de l'exécution parallèle.-
Variation du nombre de messages d'erreur
Pour une requête qui génère une erreur lors d'une exécution séquentielle, le nombre total de messages d'erreur peut différer lors d'une exécution parallèle.
-
Problèmes de précision
L'exécution parallèle peut stocker davantage de résultats intermédiaires en virgule flottante, ce qui peut entraîner de légères différences de précision dans le résultat final.
-
Dépassement de max_allowed_packet par un paquet réseau ou un résultat intermédiaire
L'exécution parallèle peut générer des résultats intermédiaires plus volumineux. Si la taille d'un paquet réseau ou d'un résultat intermédiaire dépasse
max_allowed_packet, une erreur risque de se produire. Augmentez la valeur du paramètremax_allowed_packetpour résoudre ce problème. Reportez-vous à la rubrique Définir les paramètres du cluster et les paramètres du nœud. -
Différences dans l'ordre du jeu de résultats
Une instruction
SELECT ... LIMIT nsans clauseORDER BYpeut retourner les lignes dans un ordre différent lors d'une exécution parallèle, car plusieurs workers terminent leur traitement à des vitesses variables. -
Augmentation possible du nombre de verrous de ligne
Lors de l'exécution parallèle de
SELECT ... FROM ... FOR SHARE, InnoDB verrouille chaque ligne accédée. Le nombre de verrous de ligne peut alors être supérieur à celui observé lors d'une exécution séquentielle.
Activer ou désactiver la requête parallèle
Activer
Accédez à la . Sur la page Basic Information du cluster, localisez la section Database Connection. Sélectionnez l'endpoint cible et cliquez sur Configure. Dans la boîte de dialogue Edit Endpoint Configuration, enable la requête parallèle et configurez le Degree of Parallelism.
Paramètres recommandés et remarques :
Désactiver
Accédez à la . Sur la page Basic Information du cluster, localisez la section Database Connection. Sélectionnez l'endpoint cible et cliquez sur Configure. Dans la boîte de dialogue Edit Endpoint Configuration, disable la requête parallèle.
Remarque :
Configurer la requête parallèle
PolarDB propose plusieurs politiques de contrôle pour la requête parallèle, résumées ci-dessous. La liste complète est disponible dans la rubrique Configurer les politiques de contrôle des ressources parallèles.
|
Type |
Description |
|
Seuils d'exécution parallèle de l'optimiseur |
PolarDB fournit deux seuils. L'optimiseur envisage un plan parallèle lorsqu'une requête dépasse l'un ou l'autre de ces seuils. |
|
Seuils de mise à l'échelle parallèle multi-nœuds |
PolarDB définit deux seuils pour la mise à l'échelle parallèle multi-nœuds. Le système effectue une montée en charge dès que l'un de ces seuils est franchi. |
Contrôler la requête parallèle avec des hints
Les hints permettent de contrôler l'exécution parallèle au niveau de l'instruction. Ils offrent la possibilité de remplacer le comportement par défaut, de définir le degré de parallélisme et de spécifier les tables à paralléliser. Utilisez par exemple un hint pour accélérer une requête lente spécifique. La syntaxe complète est documentée dans la rubrique Syntaxe des hints de requête parallèle.
Limites et problèmes de compatibilité
Limites
L'exécution parallèle dans PolarDB présente les limitations suivantes :