PolarDB propose une fonctionnalité d'optimisation de la réplication physique pour les instructions Data Definition Language (DDL). Cette fonctionnalité optimise entièrement le chemin critique d'écriture des journaux physiques sur le nœud principal et leur application sur les nœuds en lecture seule. Elle réduit considérablement le temps d'exécution des opérations DDL sur le nœud principal ainsi que le délai de réplication des journaux physiques lié à l'analyse des instructions DDL sur les nœuds en lecture seule. Cette rubrique explique comment utiliser cette fonctionnalité.
Prérequis
Les clusters PolarDB doivent exécuter l'une des versions suivantes. Pour vérifier la version de votre cluster, interrogez la version du moteur :
PolarDB for MySQL 8.0.1 avec une version de révision 8.0.1.1.10 ou ultérieure.
PolarDB for MySQL 5.7 avec une version de révision 5.7.1.0.10 ou ultérieure.
Limites
La fonctionnalité d'optimisation de la réplication physique parallèle pour les opérations DDL prend uniquement en charge les opérations DDL qui créent des clés primaires ou des index secondaires. Les index full-text et les index spatiaux ne sont pas pris en charge.
Pour les opérations DDL qui modifient uniquement les métadonnées, telles que le renommage, cette optimisation est inutile car ces opérations s'exécutent déjà rapidement.
Cette fonctionnalité d'optimisation n'est pas prise en charge dans PolarDB for MySQL 8.0.2 ou 5.6.
Contexte
PolarDB utilise une architecture découplée entre le stockage et le calcul, permettant au nœud principal et aux nœuds en lecture seule de partager les mêmes données stockées. Cette approche réduit les coûts de stockage et améliore la disponibilité et la fiabilité du cluster. Pour mettre en œuvre cette architecture, PolarDB s'appuie sur la technologie de réplication physique. Cela garantit la cohérence des données entre le nœud principal et les nœuds en lecture seule dans l'architecture de stockage partagé, tout en réduisant la surcharge d'E/S provoquée par les opérations fsync des journaux binaires (Binlog).
InnoDB utilise des arbres B pour gérer les index. Toutefois, la plupart des opérations DDL lentes, comme l'ajout d'une clé primaire, l'ajout d'un index secondaire ou l'exécution de l'instruction optimize table, nécessitent souvent la reconstruction ou la création d'index en arbre B. Cela génère un volume important de journaux physiques. Les opérations sur ces journaux se situent souvent sur le chemin critique de l'exécution des instructions DDL, ce qui augmente leur durée. De plus, la réplication physique impose aux nœuds en lecture seule d'analyser et d'appliquer ces nouveaux journaux physiques. Le volume élevé de journaux générés par les opérations DDL peut affecter gravement la synchronisation des journaux sur les nœuds en lecture seule, voire rendre ces nœuds indisponibles.
Pour résoudre ces problèmes, PolarDB fournit la fonctionnalité d'optimisation de la réplication physique pour les opérations DDL. Celle-ci optimise entièrement le chemin critique d'écriture des journaux physiques sur le nœud principal et leur application sur les nœuds en lecture seule. Elle permet de réduire jusqu'à 20,6 % le temps d'exécution d'une opération DDL créant une clé primaire sur le nœud principal. Elle réduit également le délai de réplication lié à l'analyse des instructions DDL sur les nœuds en lecture seule à environ 0,4 % du temps initial.
Utilisation
Définissez le paramètre suivant pour activer la fonctionnalité d'optimisation de la réplication physique pour les opérations DDL.
Paramètre | Niveau | Description |
innodb_bulk_load_page_grained_redo_enable | Global | Interrupteur de la fonctionnalité d'optimisation de la réplication physique pour les opérations DDL. Valeurs possibles :
|
Test de performance
-
Préparation du test
-
Environnement de test
Cluster PolarDB for MySQL 8,0 composé d'un nœud principal et d'un nœud en lecture seule. Le cluster utilise la spécification 16 cœurs, 128 Go de RAM.
Le cluster dispose de 50 To d'espace de stockage.
-
Schéma de la table de test
Exécutez l'instruction suivante pour créer une table nommée
t0:CREATE TABLE t0(a INT PRIMARY KEY, b INT) ENGINE=InnoDB; -
Données de la table de test
Exécutez l'instruction suivante pour générer des données de test aléatoires :
DELIMITER // CREATE PROCEDURE populate_t0() BEGIN DECLARE i int DEFAULT 1; WHILE (i <= $table_size) DO INSERT INTO t0 VALUES (i, 1000000 * RAND()); SET i = i + 1; END WHILE; END // DELIMITER ; CALL populate_t0();RemarqueLors de l'exécution du test, remplacez
$table_sizepar le nombre réel d'enregistrements dans la table, par exemple1000000.Ce test utilise des tables contenant 1 000 000, 10 000 000, 100 000 000 et 1 000 000 000 d'enregistrements.
-
Opérations DDL utilisées dans le test
add primary keyadd secondary Indexoptimize table
-
-
Méthodes de test
Test 1 : Mesurez le temps nécessaire à l'exécution de différentes opérations DDL sur des tables de volumes de données variés, avec la fonctionnalité d'optimisation de la réplication physique pour les opérations DDL activée ou désactivée.
Test 2 : Lorsque la fonctionnalité d'optimisation de la réplication physique pour les opérations DDL est utilisée conjointement avec la fonctionnalité Parallel DDL, mesurez le temps requis pour exécuter l'opération
add secondary Indexsur une table contenant 1 milliard d'enregistrements.Test 3 : Évaluez les performances des nœuds en lecture seule (statut du nœud, utilisation maximale du CPU, délai de réplication) avec la fonctionnalité d'optimisation activée ou désactivée. Le test utilise un cluster contenant une table de 1 milliard d'enregistrements et fait varier le nombre d'opérations DDL concurrentes sur le nœud principal (1, 2, 4, 6 et 8).
-
Résultats des tests
-
Test 1
La figure suivante illustre, en secondes, le temps d'exécution de l'opération
add primary key(a)sur des tables de différents volumes de données (1 million, 10 millions, 100 millions et 1 milliard), selon que le paramètre innodb_bulk_load_page_grained_redo_enable est activé ou désactivé.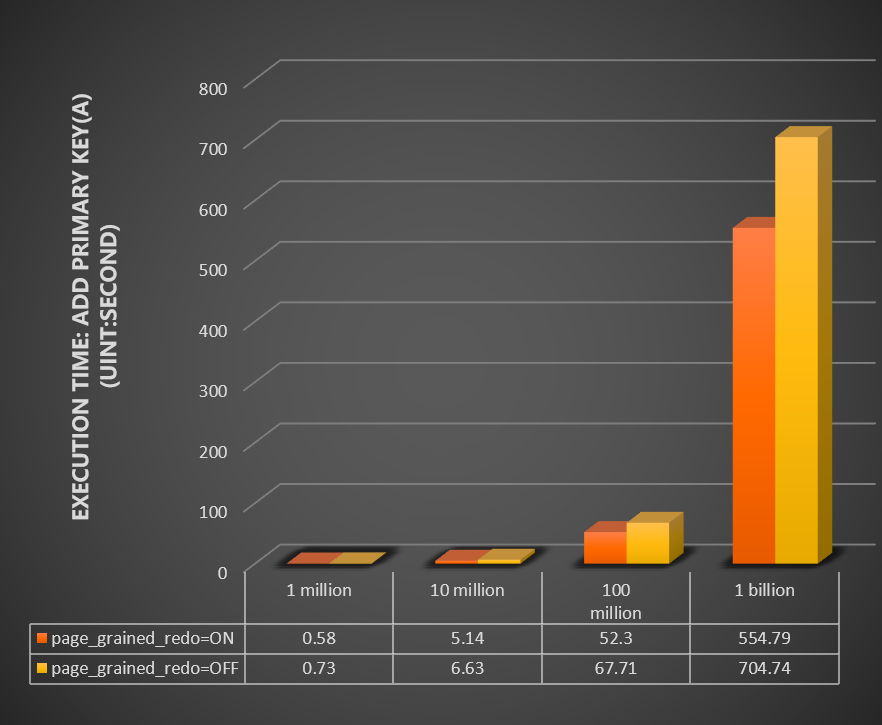
La figure suivante présente, en secondes, la durée de l'opération
optimize tablesur des tables de différents volumes de données (1 million, 10 millions, 100 millions et 1 milliard), selon que le paramètre innodb_bulk_load_page_grained_redo_enable est activé ou désactivé.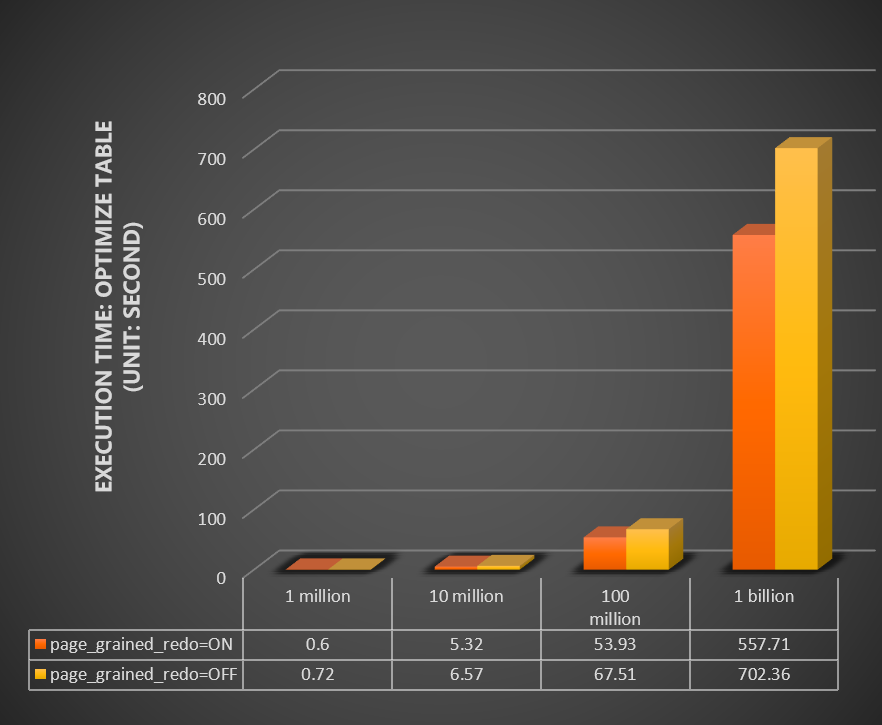
-
Test 2
Les paramètres Parallel DDL innodb_polar_use_sample_sort et innodb_polar_use_parallel_bulk_load de la fonctionnalité [Parallel DDL] sont activés pour ce test. Celui-ci utilise une table de 1 milliard d'enregistrements et varie l'état du paramètre innodb_bulk_load_page_grained_redo_enable (activé ou désactivé). Différents nombres de threads parallèles sont également testés (paramètre innodb_polar_parallel_ddl_threads défini sur 1, 2, 4, 8, 16 et 32). La figure ci-dessous montre le temps, en secondes, nécessaire à l'exécution de l'opération
add secondary Index.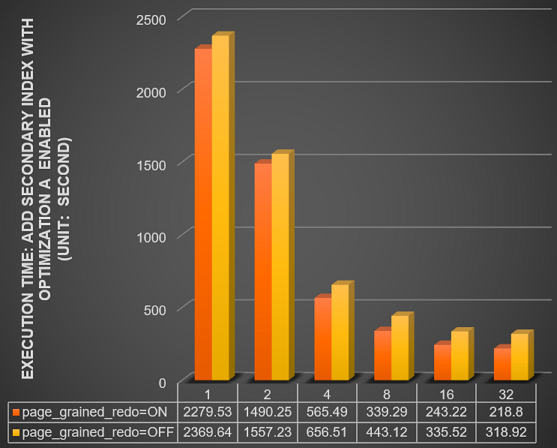
Les paramètres Parallel DDL innodb_polar_use_sample_sort et innodb_polar_use_parallel_bulk_load de la fonctionnalité [Parallel DDL] sont désactivés pour ce test. Celui-ci utilise une table de 1 milliard d'enregistrements et varie l'état du paramètre innodb_bulk_load_page_grained_redo_enable (activé ou désactivé). Différents nombres de threads parallèles sont également testés (1, 2, 4, 8, 16 et 32). La figure ci-dessous montre le temps, en secondes, nécessaire à l'exécution de l'opération
add secondary Index.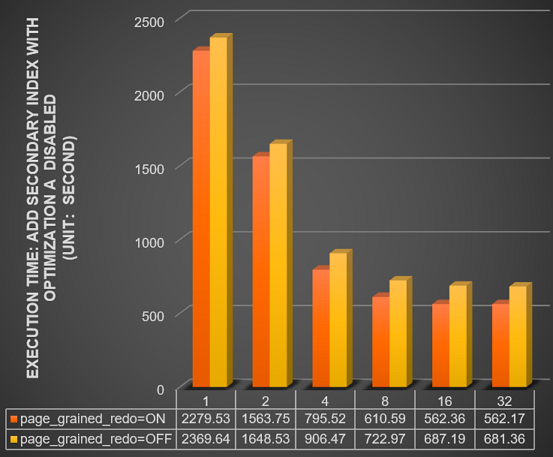
-
Test 3
-
Le paramètre innodb_bulk_load_page_grained_redo_enable est activé pour ce test. Le cluster contient une table de 1 milliard d'enregistrements. Le tableau suivant présente les performances des nœuds en lecture seule pour différents nombres d'opérations DDL concurrentes sur le nœud principal (1, 2, 4, 6 et 8).
Nombre d'opérations DDL concurrentes
1
2
4
6
8
Statut du nœud en lecture seule
Normal
Normal
Normal
Normal
Normal
Utilisation maximale du CPU (%)
1,86
1,71
1,76
2,25
2,36
Utilisation maximale de la mémoire (%)
10,37
10,80
10,88
11
11,1
IOPS de lecture maximales (opérations/seconde)
10965
10762
10305
10611
10751
Délai de réplication maximal (secondes)
0
0,73
0,87
0,93
0,03
-
Le paramètre innodb_bulk_load_page_grained_redo_enable est désactivé pour ce test. Le cluster contient une table de 1 milliard d'enregistrements. Le tableau suivant présente les performances des nœuds en lecture seule pour différents nombres d'opérations DDL concurrentes sur le nœud principal (1, 2, 4, 6 et 8).
RemarqueLes données relatives à quatre opérations DDL concurrentes ont été collectées avant que le nœud en lecture seule ne devienne indisponible.
Le symbole
-dans le tableau indique que les opérations DDL correspondantes n'ont pas pu s'exécuter pour le nombre donné d'opérations concurrentes. Par conséquent, aucune donnée de test n'est disponible.
Nombre d'opérations DDL concurrentes
1
2
4
6
8
Statut du nœud en lecture seule
Normal
Normal
Indisponible
Indisponible
Indisponible
Utilisation maximale du CPU (%)
4,2
9,5
10,3
-
-
Utilisation maximale de la mémoire (%)
22,15
23,55
68,61
-
-
IOPS de lecture maximales (opérations/seconde)
9243
7578
7669
-
-
Délai de réplication maximal (secondes)
0,8
14,67
211
-
-
-
-
Nous contacter
Si vous avez des questions concernant les opérations DDL, Contactez-nous.