ChatBI utilise la technologie NL2SQL (Natural Language to SQL) pour aider les entreprises à générer des rapports en interrogeant les données via le langage naturel. Cette rubrique s'appuie sur l'exemple du système de gestion de restauration « Alixiang » pour vous présenter les fonctionnalités clés de ChatBI, afin de vous permettre une prise en main rapide et une utilisation efficace du service.
Activer la fonctionnalité PolarDB for AI
-
Ajoutez un nœud IA et configurez le compte de base de données pour qu'il se connecte au nœud IA. Pour plus d'informations, consultez la section Activer la fonctionnalité PolarDB for AI.
RemarqueSi vous avez déjà ajouté un nœud IA lors de l'achat du cluster, configurez directement le compte de base de données pour le nœud IA. Pour plus d'informations, consultez la section Créer un compte standard.
Ce compte doit disposer des autorisations de lecture et d'écriture sur les tables de données cibles. Cela garantit l'exécution de toutes les opérations de base de données durant le processus de conversion ChatBI.
-
Utilisez le Cluster Endpoint pour vous connecter au cluster PolarDB. Pour plus d'informations, consultez la section Se connecter à PolarDB for AI.
RemarqueLorsque vous vous connectez au cluster depuis la ligne de commande, ajoutez l'option
-c.Par défaut, DMS se connecte au cluster en utilisant l'adresse Primary address. Modifiez-la manuellement pour utiliser le Cluster Endpoint. Après cette modification, fermez la fenêtre SQL initiale et ouvrez-en une nouvelle pour exécuter les instructions SQL.
Préparation des données
« Alixiang » est une entreprise de restauration fictive. Son système de gestion des factures contient les trois tables suivantes. Cliquez pour les télécharger.
Vous pouvez saisir des commentaires pour vos tables et colonnes en fonction de votre schéma de table. Cela aide le modèle de langage large (LLM) à mieux reconnaître et comprendre les données, ce qui améliore la précision et l'efficacité du modèle lors du traitement et de l'analyse des données.
CREATE TABLE restaurant_info (
  id INT COMMENT 'Outlet ID',
  position VARCHAR(128) COMMENT 'Outlet location',
  PRIMARY KEY (id)
) COMMENT='Outlet table';

CREATE TABLE menu_info (
  id INT COMMENT 'Menu item ID',
  name VARCHAR(64) COMMENT 'Menu item name',
  type INT COMMENT 'Menu item type',
  unit_price INT COMMENT 'Unit price',
  PRIMARY KEY (id)
) COMMENT='Menu table';

CREATE TABLE bill_info (
  id INT COMMENT 'Bill ID',
  items VARCHAR(512) COMMENT 'Ordered items',
  actural_amount INT COMMENT 'Actual amount paid',
  restaurant_id INT COMMENT 'Outlet ID',
  waiter VARCHAR(16) COMMENT 'Waiter',
  diner_count INT COMMENT 'Number of diners',
  pay_time DATE COMMENT 'Order time',
  PRIMARY KEY (id)
) COMMENT='Bill table';
Utiliser ChatBI
Ensuite, utilisez le modèle NL2SQL de PolarDB for AI pour générer des instructions SQL correspondant aux questions des utilisateurs.
Créer un index de schéma de table
Utilisez l'instruction SQL suivante pour créer un index de schéma de table nommé schema_index afin de fournir les informations de schéma de table au modèle de langage large (LLM).
/*polar4ai*/CREATE TABLE schema_index(id integer, table_name varchar, table_comment text_ik_max_word, table_ddl text_ik_max_word, column_names text_ik_max_word, column_comments text_ik_max_word, sample_values text_ik_max_word, vecs vector_768,ext text_ik_max_word, PRIMARY key (id));Cette table n'est pas directement visible dans la base de données. Exécutez l'instruction SQL suivante pour afficher les informations.
/*polar4ai*/SHOW TABLES;Ensuite, importez le schéma de la table de données dans la table d'index schema_index à l'aide de l'instruction SQL suivante.
/*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_text2vec, SELECT '') WITH (mode='async', resource='schema') INTO schema_index;Lors de l'exécution de l'instruction, PolarDB for AI vectorise par défaut toutes les tables de la base de données actuelle et échantillonne les valeurs des colonnes.
Après l'exécution de l'instruction, le système renvoie l'identifiant task_id de la tâche en arrière-plan, par exemple bce632ea-97e9-11ee-bdd2-492f4dfe0918. Interrogez l'état de la tâche actuelle avec le code SQL suivant. Lorsque la valeur taskStatus renvoyée est finish, la création de l'index est terminée.
/*polar4ai*/SHOW TASK `bce632ea-97e9-11ee-bdd2-492f4dfe0918`;Utiliser le modèle NL2SQL pour répondre aux questions
Exécutez l'instruction SQL suivante pour utiliser le modèle NL2SQL basé sur un LLM en ligne. Dans l'exemple ci-dessous, la requête de l'utilisateur est Quel est le chiffre d'affaires total de cette semaine ? et l'index de schéma de table utilisé est schema_index.
/*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_nl2sql, select 'What is the total revenue for this week') WITH (basic_index_name='schema_index');La base de données doit attendre un certain temps pour recevoir une réponse du LLM. Le résultat attendu est le suivant :
Le résultat renvoyé est SELECT SUM(actural_amount) AS total_income FROM bill_info WHERE pay_time >= '2024-10-14' AND pay_time <= '2024-10-20';
Sur la base de l'exemple ci-dessus, vous pouvez également poser des questions types. Ces questions couvrent divers scénarios, tels que GROUP BY, les jointures multi-tables JOIN, ORDER BY et les formules.
|
N° |
Question de l'utilisateur |
Valeur de retour NL2SQL |
|
1 |
Trier les points de vente par chiffre d'affaires |
|
|
2 |
Quel point de vente à Shanghai a le chiffre d'affaires le plus élevé ? |
|
|
3 |
Quelle est la dépense moyenne par personne à Shanghai ? |
|
|
4 |
Quels sont les 10 plats les plus commandés ce mois-ci ? |
|
|
5 |
Quel est le taux de croissance mensuel du chiffre d'affaires ce mois-ci par rapport au mois dernier ? |
|
|
6 |
Quel point de vente à Shanghai a le trafic client le plus élevé ? |
|
Comme vous pouvez le constater, le modèle NL2SQL basé sur un LLM répond efficacement aux questions des utilisateurs, mais certaines réponses ne sont pas conformes aux attentes. Par exemple, pour la deuxième question, l'utilisateur souhaite obtenir le nom du point de vente. Si la question est reformulée ainsi : Quel point de vente à Shanghai a le chiffre d'affaires le plus élevé ? Veuillez renvoyer le nom du point de vente, le modèle renvoie l'instruction SQL suivante : SELECT r.name FROM bill_info b JOIN restaurant_info r ON b.restaurant_id = r.id WHERE r.position = 'Shanghai' ORDER BY b.actural_amount DESC LIMIT 1;. Vous pouvez également améliorer la précision en affinant le modèle. Les sections suivantes traitent de ces problèmes.
Affiner le modèle
Configurer des modèles de questions
Utilisez des modèles de questions généraux pour guider le modèle en introduisant des connaissances spécifiques. Cela permet au modèle de générer des instructions SQL basées sur ces connaissances.
-
Exécutez le code SQL suivant pour créer la table de modèles de questions
polar4ai_nl2sql_pattern.CREATE TABLE `polar4ai_nl2sql_pattern` ( `id` int(11) NOT NULL AUTO_INCREMENT COMMENT 'Primary key', `pattern_question` text COMMENT 'Template question', `pattern_description` text COMMENT 'Template description', `pattern_sql` text COMMENT 'Template SQL', `pattern_params` text COMMENT 'Template parameters', PRIMARY KEY (`id`) ) ENGINE=InnoDB AUTO_INCREMENT=2 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;Le nom de la table doit commencer par
polar4ai_nl2sql_patternet le schéma de la table doit inclure les cinq colonnes présentes dans l'instructionCREATE TABLEci-dessus. -
Ensuite, créez la table d'index
pattern_indexpour le modèle de question./*polar4ai*/CREATE TABLE pattern_index(id integer, pattern_question text_ik_max_word, pattern_description text_ik_max_word, pattern_sql text_ik_max_word, pattern_params text_ik_max_word, pattern_tables text_ik_max_word, vecs vector_768, PRIMARY key (id));Nous configurons un modèle pour la deuxième question, utilisé pour l'affinement afin de renvoyer l'adresse du point de vente.
Exécutez l'instruction SQL suivante pour ajouter un nouveau modèle :
INSERT INTO polar4ai_nl2sql_pattern (id, pattern_question, pattern_description, pattern_sql, pattern_params) VALUES (
  1,
  "Which outlet in #{position} has the highest revenue?",
  "Which outlet in [location] has the highest revenue?",
  "SELECT r.position FROM bill_info b JOIN restaurant_info r ON b.restaurant_id = r.id WHERE r.position LIKE '%#{position}%' GROUP BY r.position ORDER BY SUM(b.actural_amount) DESC LIMIT 1;",
  '[{"table_name":"bill_info","param_info":[{"param_name":"#{position}","value":["Shanghai"]}], "explanation": "Location of consumption"}]'
);
Le modèle utilise des emplacements (slots) pour correspondre à plusieurs lieux. Saisissez l'instruction SQL correcte dans la colonne
pattern_sqlet marquez l'emplacement avec#{}. La colonnepattern_paramssert au post-traitement supplémentaire des informations de table, mais peut être ignorée ici. -
Ensuite, importez les informations du modèle de question dans la table d'index.
/*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_text2vec, SELECT '') WITH (mode='async', resource='pattern') INTO pattern_index;Comme pour le processus de création d'index pour
schema_index, un ID de tâche est également renvoyé. Exécutez/*polar4ai*/show task 'xxx-xxx-xxx'pour afficher l'état de la tâche actuelle.RemarqueSi les données de la table
polar4ai_nl2sql_patternsont mises à jour, recréez l'indexpattern_indexet réimportez les données. Utilisez l'instruction SQL suivante pour supprimer l'ancien index :/*polar4ai*/DROP TABLE pattern_index;Réexécutez l'instruction SQL ayant causé le problème et ajoutez l'indicateur
pattern_index./*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_nl2sql, select 'Which outlet in Shanghai has the highest revenue?') WITH (basic_index_name='schema_index',pattern_index_name='pattern_index');Le résultat de l'exécution renvoie une ligne de données. La valeur de la colonne result est
SELECT r.position FROM bill_info b JOIN restaurant_info r ON b.restaurant_id = r.id WHERE r.position LIKE '%Shanghai%' ORDER BY SUM(b.actural_amount) DESC LIMIT 1;
Créer une table de configuration
Si vous souhaitez prétraiter les questions ou post-traiter le SQL final généré, utilisez une table de configuration.
Indications sur le sens du vocabulaire
Pour la sixième question, comme le modèle de langage large (LLM) ne comprend pas précisément le terme « foot traffic » (trafic piéton), effectuez un prétraitement en configurant la table polar4ai_nl2sql_llm_config.
CREATE TABLE `polar4ai_nl2sql_llm_config` (
  `id` int(11) NOT NULL AUTO_INCREMENT COMMENT 'Primary key',
  `is_functional` int(11) NOT NULL DEFAULT '1' COMMENT 'Is active',
  `text_condition` text COMMENT 'Text condition',
  `query_function` text COMMENT 'Query processing',
  `formula_function` text COMMENT 'Formula information',
  `sql_condition` text COMMENT 'SQL condition',
  `sql_function` text COMMENT 'SQL processing',
  PRIMARY KEY (`id`)
);
Insérez l'élément de configuration pertinent pour configurer le LLM afin qu'il compte le « customer traffic » ou « customer flow » comme le « nombre de convives ».
INSERT INTO polar4ai_nl2sql_llm_config (id, is_functional, text_condition, query_function, formula_function, sql_condition, sql_function) VALUES (
  1,
  1,
  "customer traffic||customer flow",
  "",
  "Customer traffic or customer flow is calculated as the sum of the number of diners",
  "",
  ""
);
Dans ce cas, une valeur de 1 pour is_functional indique que l'élément de configuration est valide. La valeur du champ text_condition est « people traffic||customer traffic », ce qui correspond aux questions contenant « people traffic » ou « customer traffic ». Le champ formula_function explique les termes spécialisés au modèle de langage large (LLM) à l'aide de texte ou de formules.
Dans ce cas, vous pouvez exécuter directement la génération SQL sans créer de table d'index ni effectuer de vectorisation. Le résultat est le suivant.
Exécutez la commande de prédiction NL2SQL : /*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_nl2sql, select 'Which outlet in Shanghai has the highest customer traffic') WITH (basic_index_name='schema_index',pattern_index_name='pattern_index');. Le SQL généré est : SELECT r.position, SUM(b.diner_count) AS total_customer_flow FROM restaurant_info r JOIN bill_info b ON r.id = b.restaurant_id WHERE r.position LIKE '%Shanghai%' GROUP BY r.id ORDER BY total_customer_flow DESC LIMIT 1;. Le modèle a correctement interprété « customer traffic » comme le nombre de convives (diner_count) pour les statistiques.
Indications de correspondance floue
Dans la question 3, l'utilisation de l'opérateur = pour récupérer les noms de lieux échouera si le nom ne correspond pas exactement. Par conséquent, utilisez une recherche floue pour la correspondance des noms de lieux. Ajoutez l'élément de configuration suivant.
INSERT INTO polar4ai_nl2sql_llm_config (id, is_functional, text_condition, query_function, formula_function, sql_condition, sql_function) VALUES (
  2,
  1,
  "",
  "",
  "Matching for the outlet location 'position' requires a fuzzy search",
  "",
  ""
);
Si text_condition est vide, l'élément de configuration s'applique globalement. (À utiliser avec prudence.)
Le résultat est le suivant. Comme vous pouvez le voir, la correspondance de lieu utilise avec succès une recherche floue.
Le SQL généré est SELECT AVG(bi.actural_amount / bi.diner_count) AS avg_per_person FROM bill_info bi JOIN restaurant_info ri ON bi.restaurant_id = ri.id WHERE ri.position LIKE '%Shanghai%';. La condition de correspondance de lieu utilise LIKE '%Shanghai%' pour la recherche floue.
De même, pour la question 5, ajoutez les formules de calcul de la croissance mensuelle et annuelle à la table de configuration polar4ai_nl2sql_llm_config afin d'améliorer la précision du SQL généré. Vous pouvez essayer par vous-même.
Sortie graphique
Après avoir généré une instruction SQL avec NL2SQL, récupérez le résultat de la requête et affichez-le visuellement sous forme de graphiques, tels que des diagrammes en barres, des courbes et des camemberts. La solution NL2Chart de PolarDB peut exécuter votre instruction SQL en fonction de votre question et renvoyer un rapport correspondant. Elle prend en charge les diagrammes en barres, les camemberts et les courbes.
-
Supposons que votre instruction dans NL2SQL soit la suivante :
/*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_nl2sql, select 'Merchant type statistics') WITH (basic_index_name='schema_index',pattern_index_name='pattern_index');Une fois l'instruction SQL correspondante générée, vérifiez qu'elle s'exécute et renvoie un résultat significatif et non vide.
SELECT merchtype AS merchant_type, COUNT(*) AS product_count FROM hkrt_merchant_info GROUP BY merchtype; -
Utilisez NL2Chart :
Syntaxe
/*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_nl2chart, <SQL_statement>) WITH (usr_query = <usr_query>, result_type = <result_type>);Paramètres
Nom du paramètre
Description
Valeur d'exemple
usr_query
La question saisie par l'utilisateur, utilisée pour clarifier les exigences de génération du graphique.
« Statistiques des ventes pour chaque trimestre de 2023 »
result_type
Spécifie le type du résultat renvoyé. Actuellement, seule la valeur
'IMAGE'est prise en charge.'IMAGE'Instruction SQL
L'instruction de requête SQL générée par le module NL2SQL, utilisée pour récupérer les données.
SELECT quarter, sales FROM sales_data WHERE year = 2023Exemple : Convertir le résultat de la requête de l'instruction SQL générée en graphique
/*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_nl2chart, SELECT merchtype AS merchant_type, COUNT(*) AS number_of_merchants FROM hkrt_merchant_info GROUP BY merchtype) WITH (usr_query = 'Merchant type statistics', result_type='IMAGE');Le résultat est le suivant :
RemarqueLe lien renvoyé est une URL d'image valide pendant 90 minutes.
http://db4ai-xxx-xx-xxxx-xxx-xxxx.aliyuncs.com/pc-bpze47ma2c515087l6/OSSAccessKeyId=xxxxxxx&Expires=1716130199&Signature=KvPFzfMebIEmqxPIXURurwwbsXM%3D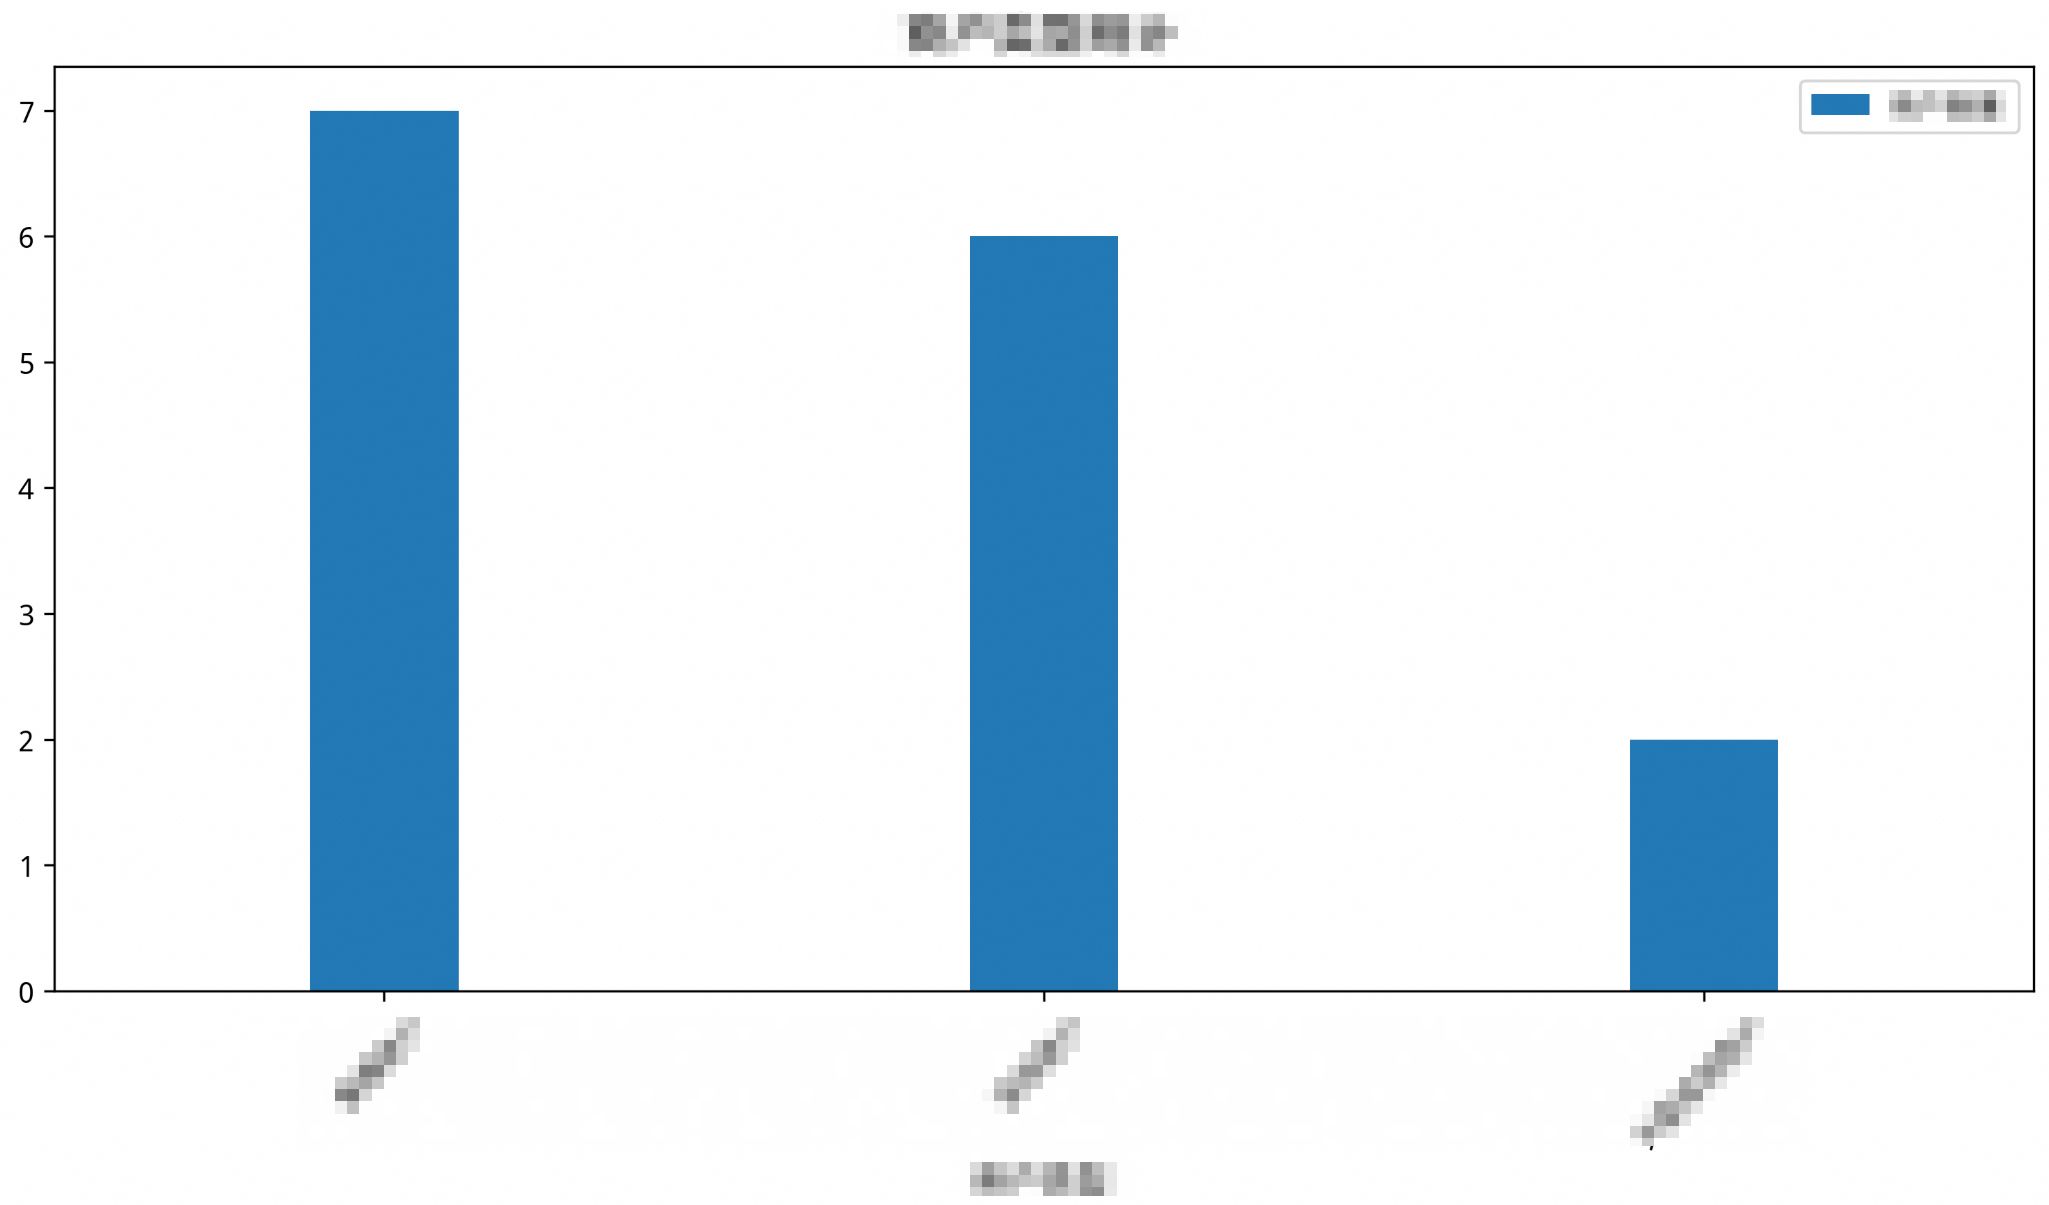
-
(Facultatif) Sélection du type de graphique et sélection forcée
Le modèle sélectionne un graphique approprié en fonction de sa compréhension de la question de l'utilisateur et des données. Nous recommandons d'utiliser la question de l'utilisateur pour guider le modèle dans la génération du graphique.
Le tableau suivant montre la correspondance entre les types de questions et les types de graphiques :
Type de question
Type de graphique
Exemple de question utilisateur
Description
Statistiques de quantité
Diagramme en barres
« Veuillez fournir des statistiques sur les ventes par ville »
Affiche les comparaisons numériques entre différentes catégories, telles que la quantité, le montant total ou la fréquence.
Évolution des tendances
Courbe
« Veuillez montrer la tendance de croissance des utilisateurs au cours de l'année dernière »
Affiche l'évolution des données dans le temps ou selon des catégories ordonnées, en mettant l'accent sur la continuité.
Répartition proportionnelle
Camembert
« Veuillez montrer la proportion des ventes de chaque gamme de produits »
Convient pour montrer la relation proportionnelle des parties par rapport à un tout. Les données doivent être catégorielles et avoir un total clair.
Forcez un type de graphique spécifique en modifiant le paramètre
usr_query. Ajoutez une commande complémentaire à la fin du paramètreusr_query:-- Enter the output SQL into nl2chart to draw a line chart /*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_nl2chart, SELECT merchtype AS merchant_type, COUNT(*) AS number_of_merchants FROM hkrt_merchant_info GROUP BY merchtype ) WITH (usr_query = 'Merchant type statistics, draw a line chart', result_type='IMAGE');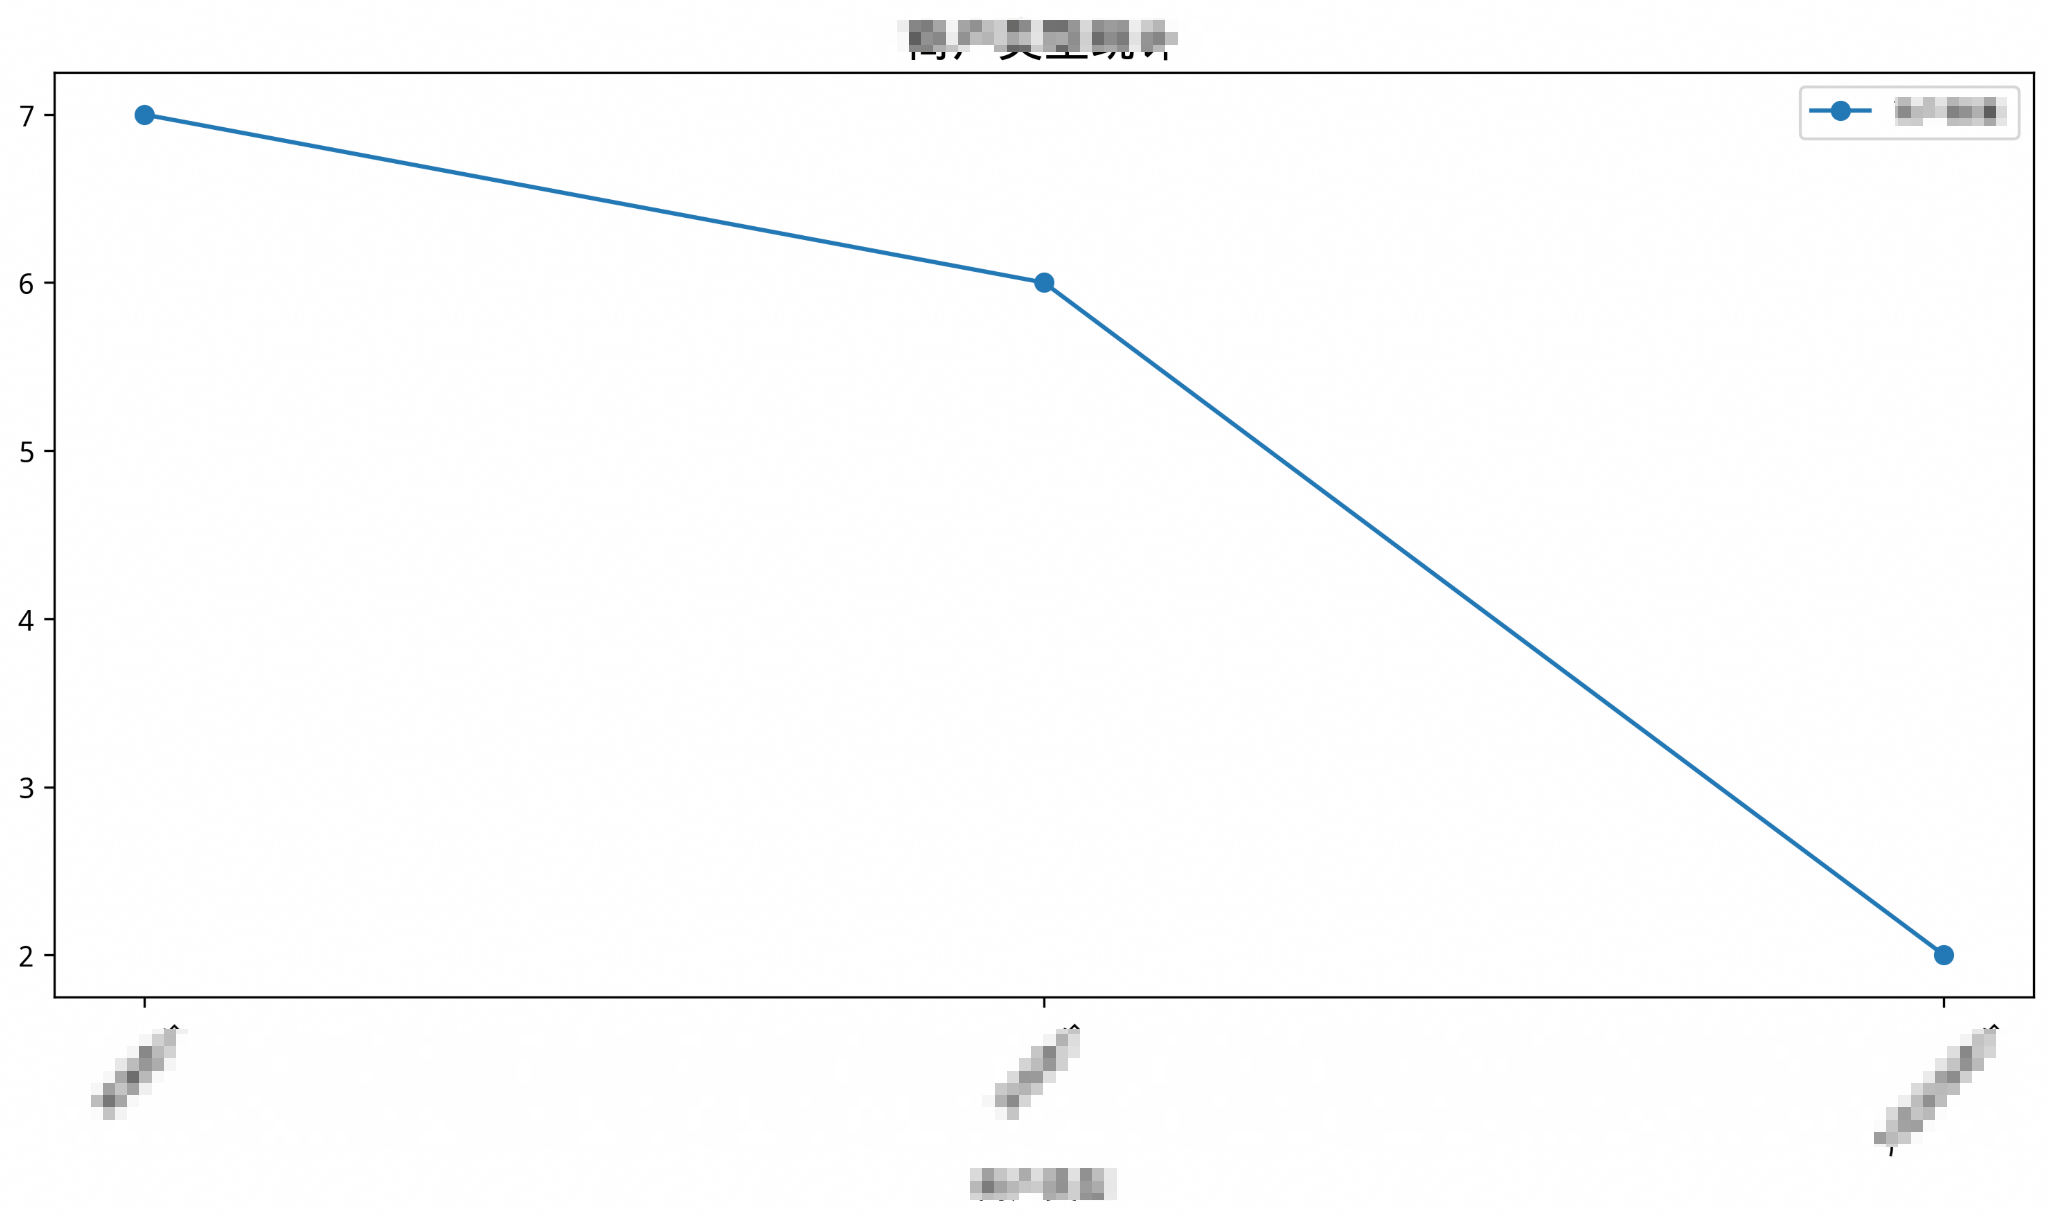
-- Enter the output SQL into nl2chart to draw a pie chart
/*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_nl2chart,
SELECT merchtype AS merchant_type, COUNT(*) AS number_of_merchants FROM hkrt_merchant_info GROUP BY merchtype
) WITH (usr_query = 'Merchant type statistics, draw a pie chart', result_type='IMAGE');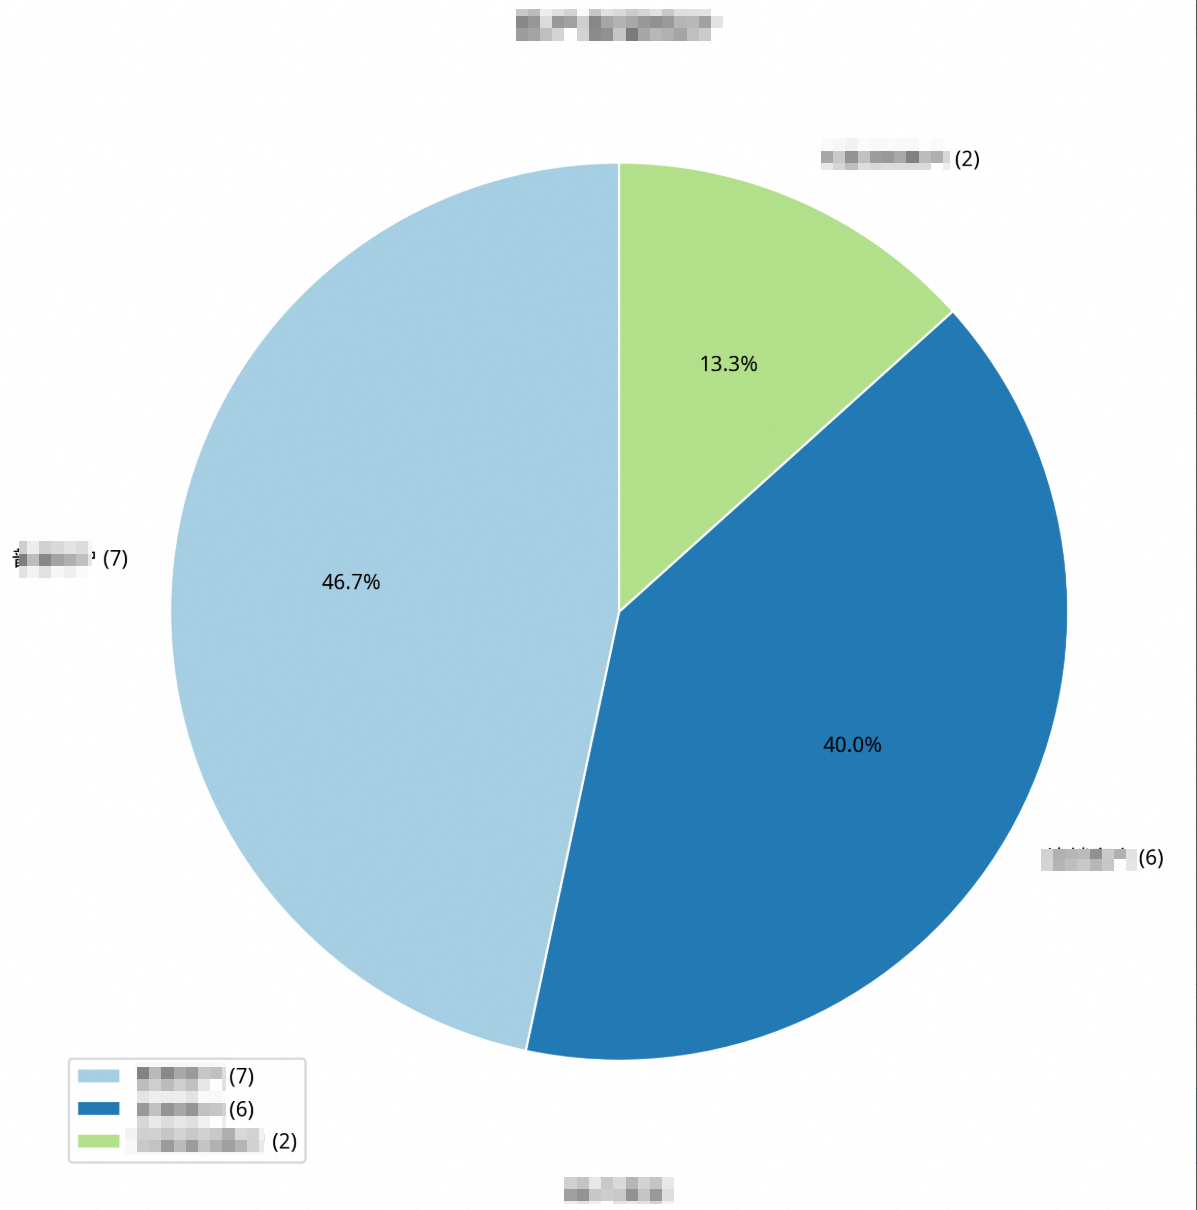
Pour plus d'informations, consultez la section NL2Chart : Générer des graphiques intelligents à partir du langage naturel.
Réentraîner et affiner le modèle
Si le modèle ne répond pas à vos besoins métier, réentraînez-le et affinez ses paramètres internes pour obtenir de meilleurs résultats.
Conditions préalables
Cette fonctionnalité est disponible uniquement pour les clusters dotés de nœuds IA de spécification polar.mysql.x8,2xlarge.gpu (16 cœurs, 125 Go et un GU100).
Un seul modèle peut être entraîné à la fois.
Un seul modèle peut être déployé à la fois.
Instructions
Entraîner le modèle
/*polar4ai*/CREATE MODEL udf_qwen14b WITH (model_class='qwen-turbo', model_parameter=(basic_index_name='schema_index', pattern_index_name='pattern_index',training_type='efficient_sft')) as (SELECT '')Paramètres
|
Nom du paramètre |
Description |
Valeur par défaut |
Valeurs valides/Plage |
|
model_class |
Le type de modèle. Prend actuellement en charge {'qwen-14b-chat', 'qwen-turbo'}. |
Aucune |
{'qwen-14b-chat', 'qwen-turbo'} |
|
model_parameter |
Paramètres du modèle, incluant les paramètres obligatoires et optionnels. |
Aucune |
Aucune |
|
basic_index_name |
Le nom de la table d'index à partir de laquelle les informations de base de données des données d'entraînement sont issues. Il doit s'agir d'une table d'index de base de données. |
Aucune |
Aucune |
|
pattern_index_name |
Le nom de la table d'index à partir de laquelle les informations de modèle de question des données d'entraînement sont issues. Il doit s'agir d'une table d'index de modèle de question. |
Aucune |
Aucune |
|
training_type |
Le type d'entraînement. Les valeurs valides sont {'efficient_sft', 'sft'}. 'efficient_sft' indique un entraînement efficace, utilisant généralement la méthode LoRa. 'sft' indique un entraînement complet des paramètres. |
Aucune |
{'efficient_sft', 'sft'} |
|
n_epochs |
Le nombre d'époques. Le nombre de fois où le modèle apprend à partir du jeu de données pendant l'entraînement. La plage recommandée est de 1 à 3, ajustable selon les besoins. |
3 |
[1, 200] |
|
learning_rate |
Le taux d'apprentissage. Il représente le poids incrémental des paramètres pour chaque mise à jour des données. Un taux d'apprentissage plus élevé entraîne des changements de paramètres plus importants et a un impact plus grand sur le modèle. |
'3e-4' |
Aucune |
|
batch_size |
La taille du lot. Elle représente la taille des étapes de données pour les mises à jour des paramètres du modèle. La taille de lot recommandée est 16 ou 32. |
16 |
{8, 16, 32} |
|
lr_scheduler_type |
La politique de taux d'apprentissage. Elle modifie dynamiquement le taux d'apprentissage utilisé lors de la mise à jour des poids pendant l'entraînement. |
'linear' |
{'linear', 'cosine', 'cosine_with_restarts', 'polynomial', 'constant', 'constant_with_warmup', 'inverse_sqrt', 'reduce_lr_on_plateau'} |
|
eval_steps |
La taille des étapes d'intervalle pour la validation du modèle, utilisée pour l'évaluation périodique de la précision et de la perte d'entraînement. |
50 |
[1, 2147483647] |
|
sequence_length |
La longueur de séquence des données d'entraînement. La longueur maximale d'un seul échantillon. Les données dépassant cette longueur seront automatiquement tronquées. |
2048 |
[500, 2048] |
|
lr_warmup_ratio |
La proportion du nombre total d'étapes d'entraînement utilisée pour le warmup. |
0,05 |
(0, 1) |
|
weight_decay |
Régularisation L2, qui aide à réduire le surapprentissage. |
0,01 |
(0, 0,2) |
|
gradient_checkpointing |
Active ou désactive le gradient checkpointing pour économiser la mémoire GPU. |
'True' |
{'True', 'False'} |
|
use_flash_attn |
Spécifie s'il faut utiliser Flash Attention. |
'True' |
{'True', 'False'} |
|
lora_rank |
La taille du rang dans l'entraînement LoRa, qui affecte le degré d'influence des données d'entraînement sur le modèle. |
8 |
{2, 4, 8, 16, 32, 64} |
|
lora_alpha |
Le coefficient de mise à l'échelle dans l'entraînement LoRa, utilisé pour ajuster les poids d'entraînement initiaux. |
32 |
{8, 16, 32, 64} |
|
lora_dropout |
Le ratio de neurones abandonnés aléatoirement pendant l'entraînement. Cela empêche le surapprentissage et améliore la capacité de généralisation du modèle. |
0,1 |
(0, 0,2) |
|
lora_target_modules |
Sélectionne des modules spécifiques du modèle pour l'affinement et l'optimisation. |
'ALL' |
{'ALL', 'AUTO'} |
Afficher un modèle
/*polar4ai*/SHOW model udf_qwen14bSupprimer un modèle
/*polar4ai*/DROP model udf_qwen14bAfficher tous les modèles
/*polar4ai*/SHOW modelsDéployer un modèle
Un modèle entraîné ne peut être utilisé dans NL2SQL qu'après avoir été déployé.
/*polar4ai*/deploy model udf_qwen14bAfficher un déploiement
/*polar4ai*/SHOW deployment udf_qwen14bSupprimer un déploiement
/*polar4ai*/DROP deployment udf_qwen14bAfficher tous les déploiements
/*polar4ai*/SHOW deploymentsUtiliser un modèle déployé pour la conversion du langage naturel en SQL
/*polar4ai*/SELECT * FROM PREDICT (MODEL _polar4ai_nl2sql, SELECT 'What is the content for id=1?') WITH (basic_index_name='schema_index', llm_model='udf_qwen14b')Paramètres
|
Paramètre |
Description |
|
basic_index_name |
Ne peut pas être vide. Vous devez spécifier la table d'index pour les informations de base de données liées à la question actuelle. |
|
llm_model |
Optionnel. Si vous laissez ce champ vide, le modèle non affiné sera utilisé pour la conversion du langage naturel en SQL. Si vous spécifiez une valeur, assurez-vous qu'il s'agit du nom d'un déploiement dont l'état est « serving ». Les modèles non entièrement déployés ne peuvent pas être utilisés ici. |