Les fraudeurs agissent rarement seuls. Ils opèrent au sein de réseaux en partageant des comptes, des adresses, des appareils et des contacts. Les systèmes traditionnels basés sur des règles évaluent chaque individu de manière isolée et passent à côté de ces connexions cachées. Les algorithmes de graphes détectent la fraude en analysant les relations entre les personnes, et non pas uniquement leurs attributs individuels.
Ce tutoriel explique comment utiliser le modèle de pipeline Financial Risk Management dans PAI Designer pour calculer un score de probabilité de fraude pour chaque personne au sein d'un réseau relationnel.
Fonctionnement de la détection de fraude par le pipeline
Le pipeline représente les personnes sous forme de sommets et leurs relations sous forme d'arêtes. Chaque arête possède une valeur count qui mesure la proximité : plus la valeur est élevée, plus la relation est forte.
Trois composants d'algorithme de graphe s'exécutent séquentiellement :
Maximum Connected Subgraph — classe les personnes du graphe relationnel en deux groupes et attribue un identifiant à chacun. Ensuite, conjointement avec les composants SQL Script et JOIN, il supprime les personnes non pertinentes en identifiant l'ensemble contenant le plus grand nombre de personnes interconnectées.
Single-Source Shortest Path — mesure le nombre de personnes qu'Enoch doit contacter pour atteindre les individus cibles. Le champ
distanceen sortie enregistre ce nombre de sauts.Label Propagation Classification — propage les étiquettes de fraude à partir de cas connus (Evan, un fraudeur) à travers le réseau. Les étiquettes se diffusent des sommets étiquetés vers leurs sommets adjacents. Le champ
weighten sortie enregistre la probabilité que chaque personne soit un fraudeur.
Jeu de données
Le pipeline utilise un jeu de données relationnelles comportant les champs suivants.
| Champ | Type | Description |
|---|---|---|
start_point |
STRING | Sommet de départ d'une arête. Nom d'une personne. |
end_point |
STRING | Sommet d'arrivée d'une arête. Nom d'une personne. |
count |
DOUBLE | Proximité entre deux personnes. Une valeur plus élevée indique une relation plus proche. |
La figure suivante présente les exemples de données utilisés dans le pipeline. 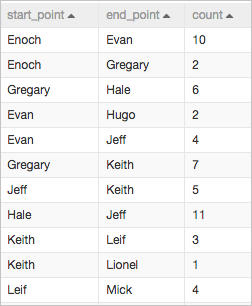
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Un espace de travail PAI. Pour les instructions de configuration, consultez la documentation PAI.
Un accès à la console PAI avec les autorisations nécessaires pour utiliser Designer.
Créer et exécuter le pipeline
Étape 1 : Ouvrir Designer
Connectez-vous à la console PAI.
Dans le volet de navigation de gauche, cliquez sur Workspaces. Sur la page Workspaces, cliquez sur le nom de votre espace de travail.
Dans le volet de navigation de gauche, choisissez Model Training > Visualized Modeling (Designer).
Étape 2 : Créer le pipeline à partir d'un modèle
Sur la page Visualized Modeling (Designer), cliquez sur l'onglet Preset Templates.
Repérez le modèle Financial Risk Management et cliquez sur Create.
Dans la boîte de dialogue Create Pipeline, vérifiez les paramètres. Le paramètre Data Storage définit le chemin du bucket Object Storage Service (OSS) où le pipeline stocke les données temporaires et les modèles lors de l'exécution. Les valeurs par défaut conviennent pour ce tutoriel.
Cliquez sur OK. La création du pipeline prend environ 10 secondes.
Sous l'onglet Pipelines, double-cliquez sur le pipeline Financial Risk Management pour l'ouvrir dans le canevas.
Le canevas affiche le pipeline divisé en trois sections. 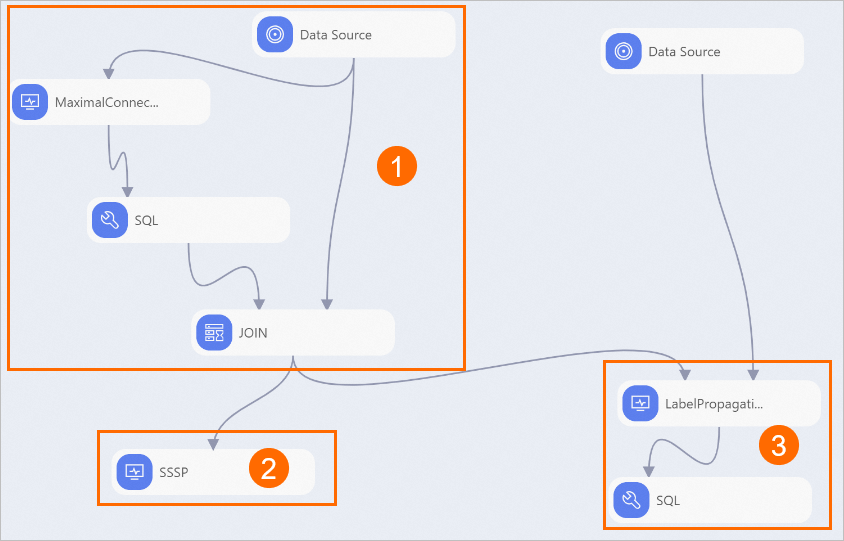
| Section | Composants | Objectif |
|---|---|---|
| ① | Maximum Connected Subgraph → SQL Script → JOIN | Classe les personnes en deux groupes et attribue un identifiant à chacun. Supprime ensuite les personnes non pertinentes en identifiant l'ensemble contenant le plus grand nombre de personnes interconnectées. 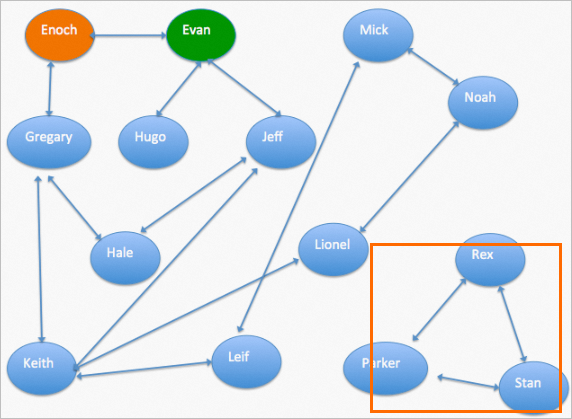 |
| ② | Single-Source Shortest Path | Calcule le nombre de personnes qu'Enoch doit contacter pour atteindre les individus cibles. Le champ distance en sortie enregistre cette valeur. La sortie du composant Single-Source Shortest Path contient quatre colonnes :
|
| ③ | Data Source → Label Propagation Classification → SQL Script | Importe les données étiquetées (où weight = probabilité de fraude), propage les étiquettes de fraude des fraudeurs connus à travers le réseau vers les sommets adjacents et filtre les résultats pour afficher la probabilité de fraude de chaque personne. 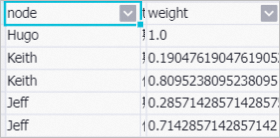 |
Étape 3 : Exécuter le pipeline et consulter les résultats
Dans le coin supérieur gauche du canevas, cliquez sur
 pour exécuter le pipeline.
Une fois l'exécution terminée, faites un clic droit sur SQL dans le canevas et sélectionnez View Data.
Le tableau de sortie répertorie les huit personnes identifiées comme fraudeurs — Leif, Evan, Mick, Noah, Hugo, Keith, Jeff et Lionel — ainsi que la valeur weight indiquant la probabilité que chaque personne soit un fraudeur.
Pourquoi les algorithmes de graphes détectent les fraudes ignorées par les systèmes basés sur des règles
La figure suivante illustre un exemple de graphe relationnel. Les flèches représentent des relations telles que celles entre collègues ou membres d'une même famille. Dans ce graphe, Enoch est un client de confiance et Evan est un fraudeur. 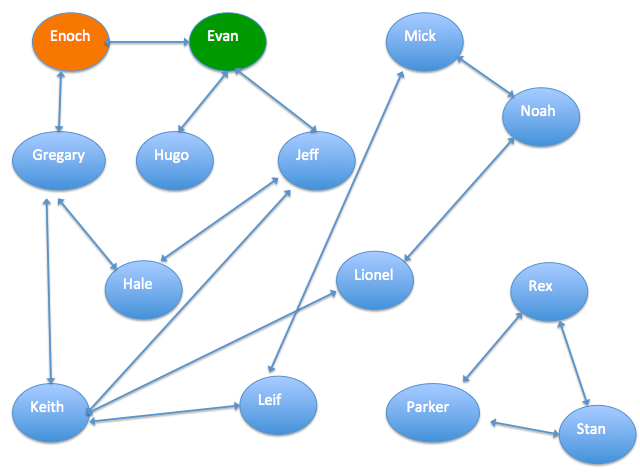
Machine Learning Platform for AI (PAI) propose plusieurs composants d'algorithme de graphe pour l'analyse des relations, notamment K-Core, Maximum Connected Subgraph et Label Propagation Classification. Ces composants analysent les structures relationnelles pour mettre en évidence des signaux de risque que les modèles individuels ne détectent pas.
Fonctionnement de la propagation d'étiquettes : Label Propagation Classification est un algorithme de classification semi-supervisé. Il utilise un graphe relationnel et des données étiquetées en entrée, et prédit les étiquettes des sommets non étiquetés en se basant sur celles des sommets étiquetés. La propagation d'étiquettes diffuse l'étiquette de chaque sommet vers les sommets qui lui sont adjacents.