L'analyse de l'équité identifie les biais dans les modèles d'IA et prévient les résultats injustes fondés sur des attributs tels que le sexe ou l'origine ethnique. En intégrant responsible-ai-toolbox à PAI DSW, vous pouvez évaluer comment les performances du modèle varient selon les caractéristiques sensibles.
Fonctionnement
L'analyse de l'équité identifie et corrige les biais dans les systèmes d'IA afin que les décisions ne soient pas influencées par des facteurs non pertinents. Les principes fondamentaux sont les suivants :
Éviter les biais : Identifiez et réduisez les biais dans les données et les algorithmes afin que les systèmes d'IA ne produisent pas de décisions injustes fondées sur des attributs personnels tels que le sexe, l'origine ethnique ou l'âge.
Données représentatives : Entraînez les modèles d'IA sur des ensembles de données représentatifs qui reflètent fidèlement tous les groupes d'utilisateurs et empêchent la marginalisation des minorités.
Transparence et explicabilité : Améliorez la transparence des systèmes d'IA grâce à des techniques d'IA explicable qui aident les utilisateurs et les décideurs à comprendre pourquoi un modèle effectue des prédictions spécifiques.
Surveillance et évaluation continues : Surveillez et évaluez régulièrement les systèmes d'IA pour détecter et corriger les biais qui émergent au fil du temps.
Diversité et inclusion : Intégrez des perspectives diverses dans la conception et le développement des systèmes d'IA afin de garantir que les problèmes soient examinés sous plusieurs angles et points de vue.
Conformité et éthique : Respectez les réglementations et les normes éthiques pour garantir que les applications d'IA ne causent ni préjudice ni injustice.
L'exemple suivant évalue l'équité d'un modèle de prédiction de revenu en fonction du sexe et de l'origine ethnique. Le modèle prédit si le revenu annuel dépasse 50 000 $. Cet exemple montre comment utiliser responsible-ai-toolbox pour l'analyse de l'équité dans PAI DSW.
Prérequis
-
Une instance DSW. Si vous n'en possédez pas, consultez Créer une instance DSW. Configuration recommandée :
Type d'instance : ecs.gn6v-c8g1,2xlarge
Image : Python 3.9 ou version ultérieure. Cette rubrique utilise l'image officielle suivante : tensorflow-pytorch-develop:2.14-pytorch2.1-gpu-py311-cu118-ubuntu22,04
Framework de modèle : responsible-ai-toolbox prend en charge les modèles de régression et de classification binaire construits avec scikit-learn, PyTorch et TensorFlow.
Jeu de données d'entraînement : Utilisez votre propre jeu de données. Pour utiliser plutôt le jeu de données d'exemple, suivez l'étape Étape 3 : Préparer le jeu de données.
Modèle entraîné : Utilisez votre propre modèle. Pour utiliser plutôt le modèle d'exemple, suivez l'étape Étape 5 : Entraîner le modèle.
Étape 1 : Ouvrir DSW Gallery
Connectez-vous à la console PAI.
Dans le coin supérieur gauche, sélectionnez une région.
Dans le volet de navigation de gauche, choisissez QuickStart > Notebook Gallery. Recherchez Responsible AI - Fairness Analysis et cliquez sur Open in DSW sur la carte correspondante.
Sélectionnez une instance DSW et cliquez sur Open Notebook. Le notebook Responsible AI - Fairness Analysis s'ouvre.
Étape 2 : Installer les dépendances
Installez le package responsible-ai-toolbox (raiwidgets) pour l'évaluation de l'équité.
!pip install raiwidgets==0.34.1Étape 3 : Préparer le jeu de données
Exécutez le script suivant pour charger le jeu de données OpenML 1590 pour l'exemple de cette rubrique.
from raiutils.common.retries import retry_function
from sklearn.datasets import fetch_openml

class FetchOpenml(object):
    def __init__(self):
        pass
    # Fetch the OpenML dataset with data_id = 1590
    def fetch(self):
        return fetch_openml(data_id=1590, as_frame=True)

fetcher = FetchOpenml()
action_name = "Dataset download"
err_msg = "Failed to download openml dataset"
max_retries = 5
retry_delay = 60
data = retry_function(fetcher.fetch, action_name, err_msg,
                      max_retries=max_retries,
                      retry_delay=retry_delay)
Vous pouvez également charger votre propre jeu de données. Le code suivant charge un fichier CSV :
import pandas as pd

# Load your own dataset in CSV format
# Use pandas to read the CSV file
data = pd.read_csv(filename)
Étape 4 : Prétraiter les données
Obtenir les variables de caractéristique et la variable cible
La variable cible est le résultat réel que le modèle prédit. Les variables de caractéristique sont toutes les autres variables de chaque instance de données. Dans cet exemple :
class : Indique si le revenu annuel dépasse 50 000 $
sex : Sexe
race : Origine ethnique
age : Âge
Exécutez le script suivant pour charger les variables de caractéristique dans X_raw et afficher un aperçu des cinq premières lignes :
# Get the feature variables, excluding the target variable.
X_raw = data.data
# Display the first 5 rows of feature variables, excluding the target variable.
X_raw.head(5)
Exécutez le script suivant pour encoder la variable cible et afficher sa distribution. Une valeur de 1 indique un revenu supérieur à 50 000 $, et 0 indique un revenu inférieur ou égal à 50 000 $.
from sklearn.preprocessing import LabelEncoder

# Convert the target variable to a binary classification target
# data.target is the target variable "class"
y_true = (data.target == '>50K') * 1
y_true = LabelEncoder().fit_transform(y_true)

import matplotlib.pyplot as plt
import numpy as np

# View the distribution of the target variable
counts = np.bincount(y_true)
classes = ['<=50K', '>50K']
plt.bar(classes, counts)
Identifier les caractéristiques sensibles
Exécutez le script suivant pour définir le sexe et l'origine ethnique comme caractéristiques sensibles et afficher un aperçu des données. responsible-ai-toolbox évalue si les prédictions du modèle sont biaisées par rapport à ces caractéristiques sensibles. En pratique, définissez les caractéristiques sensibles en fonction de vos besoins métier.
# Define "sex" and "race" as sensitive attributes
# First, select the columns related to sensitive attributes from the dataset to form a new DataFrame `sensitive_features`
sensitive_features = X_raw[['sex','race']]
sensitive_features.head(5)
Exécutez le script suivant pour supprimer les caractéristiques sensibles de X_raw et afficher un aperçu du résultat :
# Remove the sensitive features from the feature variables
X = X_raw.drop(labels=['sex', 'race'],axis = 1)
X.head(5)
Encoder et mettre à l'échelle les caractéristiques
Exécutez le script suivant pour appliquer l'encodage one-hot et la mise à l'échelle des caractéristiques, en convertissant les données dans un format adapté à responsible-ai-toolbox.
import pandas as pd
from sklearn.preprocessing import StandardScaler

# One-hot encoding
X = pd.get_dummies(X)

# Perform feature scaling on the dataset X
sc = StandardScaler()
X_scaled = sc.fit_transform(X)
X_scaled = pd.DataFrame(X_scaled, columns=X.columns)

X_scaled.head(5)
Diviser les données d'entraînement et de test
Exécutez le script suivant pour allouer 20 % des données à l'ensemble de test et les 80 % restants à l'ensemble d'entraînement.
from sklearn.model_selection import train_test_split

# Split the feature variables X and target variable y into training and test sets according to the `test_size` ratio
X_train, X_test, y_train, y_test = \
    train_test_split(X_scaled, y_true, test_size=0.2, random_state=0, stratify=y_true)

# Use the same random seed to split the sensitive features into training and test sets, ensuring consistency with the above split
sensitive_features_train, sensitive_features_test = \
    train_test_split(sensitive_features, test_size=0.2, random_state=0, stratify=y_true)
Vérifiez la taille de chaque ensemble de données :
print("Training set size:", len(X_train))
print("Test set size:", len(X_test))
Réinitialisez les index des deux ensembles de données :
# Reset the DataFrame index to avoid index errors
X_train = X_train.reset_index(drop=True)
sensitive_features_train = sensitive_features_train.reset_index(drop=True)
X_test = X_test.reset_index(drop=True)
sensitive_features_test = sensitive_features_test.reset_index(drop=True)
Étape 5 : Entraîner le modèle
L'exemple suivant utilise scikit-learn pour entraîner un modèle de régression logistique sur les données d'entraînement.
scikit-learn
from sklearn.linear_model import LogisticRegression

# Create a logistic regression model
sk_model = LogisticRegression(solver='liblinear', fit_intercept=True)
# Train the model
sk_model.fit(X_train, y_train)
PyTorch
import torch
import torch.nn as nn
import torch.optim as optim

# Define logistic regression model
class LogisticRegression(nn.Module):
    def __init__(self, input_size):
        super(LogisticRegression, self).__init__()
        self.linear = nn.Linear(input_size, 1)

    def forward(self, x):
        outputs = torch.sigmoid(self.linear(x))
        return outputs

# Instantiate the model
input_size = X_train.shape[1]
pt_model = LogisticRegression(input_size)

# Loss function and optimizer
criterion = nn.BCELoss()
optimizer = optim.SGD(pt_model.parameters(), lr=5e-5)

# Train the model
num_epochs = 1
X_train_pt = X_train
y_train_pt = y_train
for epoch in range(num_epochs):
    # Forward pass
    # Convert DataFrame to Tensor
    if isinstance(X_train_pt, pd.DataFrame):
        X_train_pt = torch.tensor(X_train_pt.values)
        X_train_pt = X_train_pt.float()
    outputs = pt_model(X_train_pt)
    outputs = outputs.squeeze()
    # Convert ndarray to Tensor
    if isinstance(y_train_pt, np.ndarray):
        y_train_pt = torch.from_numpy(y_train_pt)
        y_train_pt = y_train_pt.float()
    loss = criterion(outputs, y_train_pt)

    # Backward pass and optimization
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
TensorFlow
import tensorflow as tf
from tensorflow.keras import layers

# Define the logistic regression model
tf_model = tf.keras.Sequential([
    layers.Dense(units=1, input_shape=(X_train.shape[-1],), activation='sigmoid')
])

# Compile the model using binary cross-entropy loss and stochastic gradient descent optimizer
tf_model.compile(optimizer='sgd', loss='binary_crossentropy', metrics=['accuracy'])

# Train the model
tf_model.fit(X_train, y_train, epochs=1, batch_size=32, verbose=0)
Étape 6 : Évaluer le modèle
Utilisez le tableau de bord Fairness Dashboard de responsible-ai-toolbox pour générer des prédictions sur l'ensemble de test et produire un rapport d'évaluation de l'équité.
Le tableau de bord Fairness Dashboard regroupe les prédictions et les résultats réels par valeurs de caractéristiques sensibles. Il compare les résultats prédits et réels entre les groupes pour révéler comment les performances du modèle varient.
Par exemple, avec la caractéristique sensible « sexe », le tableau de bord Fairness Dashboard classe les prédictions (y_pred) et les résultats réels (y_test) par sexe, puis calcule et compare le taux de sélection, la précision et d'autres métriques pour « Male » et « Female ».
L'exemple suivant évalue le modèle scikit-learn :
scikit-learn
from raiwidgets import FairnessDashboard
import os
from urllib.parse import urlparse
# Generate prediction results on the test dataset
y_pred_sk = sk_model.predict(X_test)

# Use responsible-ai-toolbox to compute data information for each sensitive group
metric_frame_sk = FairnessDashboard(sensitive_features=sensitive_features_test,
                  y_true=y_test,
                  y_pred=y_pred_sk, locale = 'zh-Hans')

# Set the URL redirect link
metric_frame_sk.config['baseUrl'] =  'https://{}-proxy-{}.dsw-gateway-{}.data.aliyuncs.com'.format(
    os.environ.get('JUPYTER_NAME').replace("dsw-",""),
    urlparse(metric_frame_sk.config['baseUrl']).port,
    os.environ.get('dsw_region') )
print(metric_frame_sk.config['baseUrl'])
PyTorch
from raiwidgets import FairnessDashboard
import torch
import os
from urllib.parse import urlparse
# Test the model and evaluate fairness
pt_model.eval()  # Set model to evaluation mode
X_test_pt = X_test
with torch.no_grad():
    X_test_pt = torch.tensor(X_test_pt.values)
    X_test_pt = X_test_pt.float()
    y_pred_pt = pt_model(X_test_pt).numpy()

# Use responsible-ai-toolbox to compute metrics for each sensitive group
metric_frame_pt = FairnessDashboard(sensitive_features=sensitive_features_test,
                           y_true=y_test,
                           y_pred=y_pred_pt.flatten().round(),locale='zh-Hans')

# Set the URL redirect link
metric_frame_pt.config['baseUrl'] =  'https://{}-proxy-{}.dsw-gateway-{}.data.aliyuncs.com'.format(
    os.environ.get('JUPYTER_NAME').replace("dsw-",""),
    urlparse(metric_frame_pt.config['baseUrl']).port,
    os.environ.get('dsw_region') )
print(metric_frame_pt.config['baseUrl'])
TensorFlow
from raiwidgets import FairnessDashboard
import os
from urllib.parse import urlparse
# Test the model and evaluate fairness
y_pred_tf = tf_model.predict(X_test).flatten()

# Use responsible-ai-toolbox to compute data information for each sensitive group
metric_frame_tf = FairnessDashboard(
                           sensitive_features=sensitive_features_test,
                           y_true=y_test,
                           y_pred=y_pred_tf.round(),locale='zh-Hans')

# Set the URL redirect link
metric_frame_tf.config['baseUrl'] =  'https://{}-proxy-{}.dsw-gateway-{}.data.aliyuncs.com'.format(
    os.environ.get('JUPYTER_NAME').replace("dsw-",""),
    urlparse(metric_frame_tf.config['baseUrl']).port,
    os.environ.get('dsw_region') )
print(metric_frame_tf.config['baseUrl'])
Paramètres clés :
sensitive_features : Les attributs sensibles.
y_true : Les résultats réels de l'ensemble de test.
y_pred : Les prédictions du modèle.
locale (facultatif) : La langue d'affichage du tableau de bord d'évaluation. Prend en charge le chinois simplifié (« zh-Hans ») et le chinois traditionnel (« zh-Hant »). La valeur par défaut est l'anglais (« en »).
Étape 7 : Afficher le rapport d'évaluation
Une fois l'évaluation terminée, cliquez sur l'URL pour afficher le rapport d'évaluation complet.
Si la page d'évaluation reste bloquée sur « Calculating », consultez la section FAQ pour obtenir une solution.
Sur la page Fairness dashboard, cliquez sur Get Started. Configurez la caractéristique sensible, la métrique de performance et la métrique d'équité comme décrit ci-dessous pour comparer les métriques du modèle entre les groupes de caractéristiques sensibles.
Caractéristique sensible : sexe
Caractéristique sensible : sexe
Métrique de performance : Précision
Métrique d'équité : Différence de parité démographique
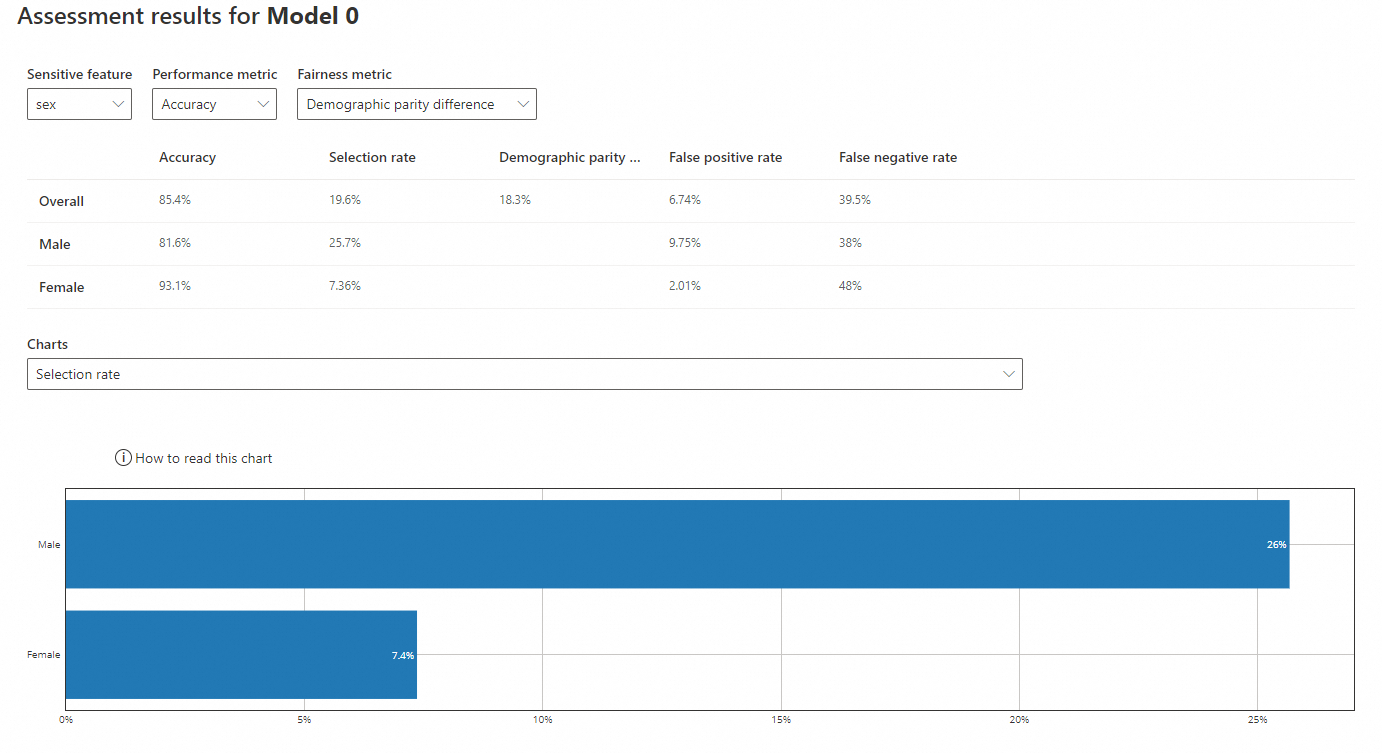
Précision : Proportion d'échantillons correctement prédits par rapport au total. Le modèle prédit le revenu des hommes avec une précision de 81,6 % et celui des femmes avec une précision de 93,1 %. Ces deux valeurs sont proches de la précision globale de 85,4 %.
Taux de sélection : Probabilité que le modèle prédise le résultat favorable (revenu supérieur à 50 000 $). Le modèle prédit un taux de sélection de 25,7 % pour les hommes et de 7,36 % pour les femmes. Le taux de sélection des femmes est bien inférieur au taux global de 19,6 %.
Différence de parité démographique : Différence de probabilité de recevoir une prédiction positive entre les groupes protégés. Une valeur proche de 0 indique moins de biais entre les groupes. La différence globale de parité démographique est de 18,3 %.
Caractéristique sensible : origine ethnique
Caractéristique sensible : origine ethnique
Métrique de performance : Précision
Métrique d'équité : Différence de parité démographique
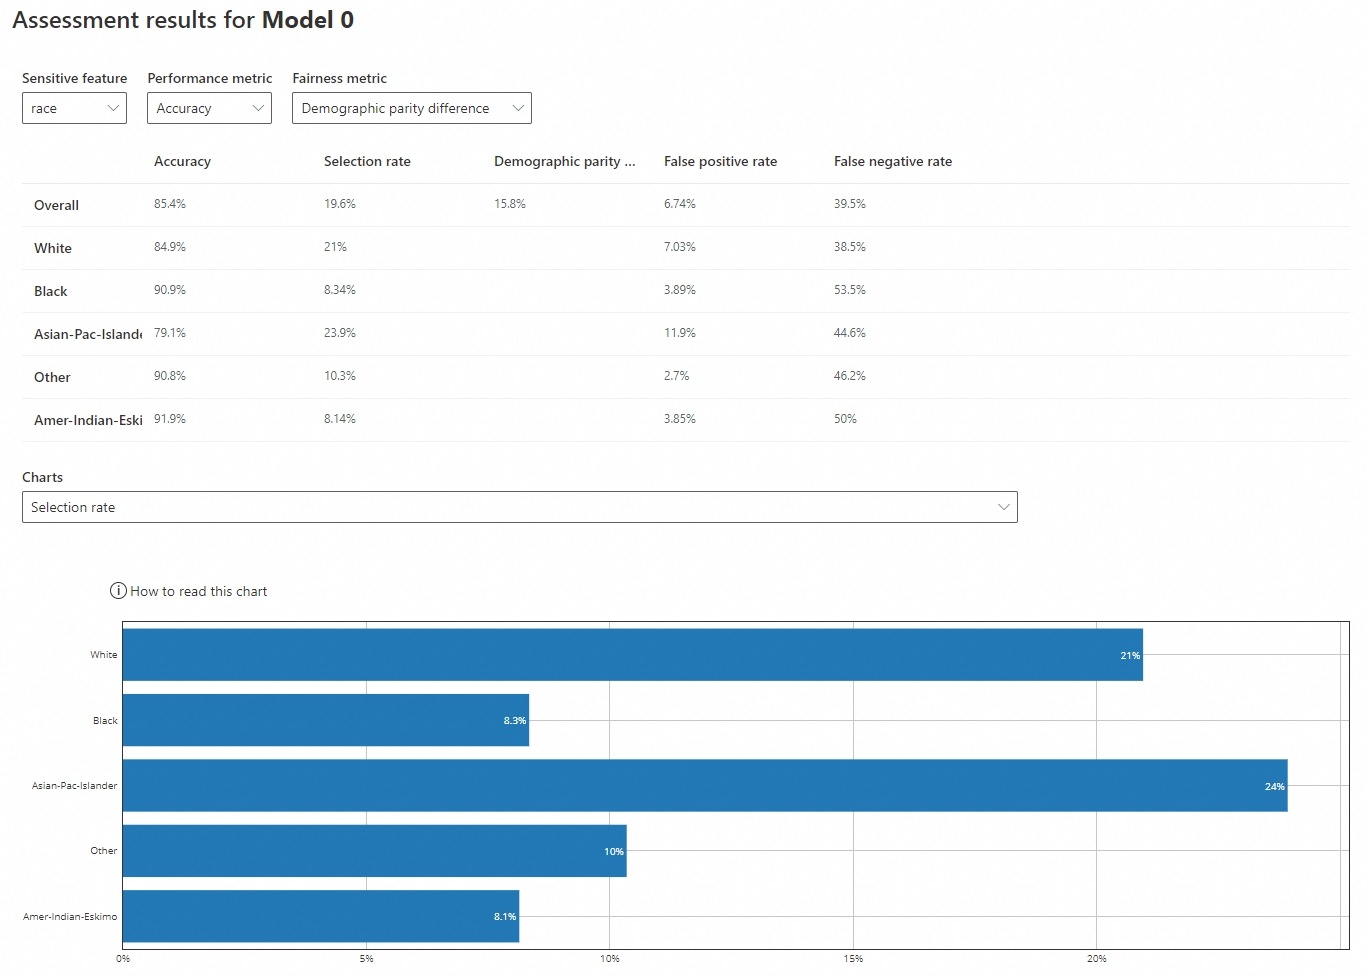
Précision : Proportion d'échantillons correctement prédits par rapport au total. Le modèle prédit le revenu pour « White » et « Asian-Pac-Islander » avec une précision de 84,9 % et 79,1 %, contre 90,9 %, 90,8 % et 91,9 % pour « Black », « Other » et « Amer-Indian-Eskimo ». Toutes les précisions par groupe sont proches de la précision globale de 85,4 %.
Taux de sélection : Probabilité que le modèle prédise le résultat favorable (revenu supérieur à 50 000 $). Les taux de sélection pour « White » (21 %) et « Asian-Pac-Islander » (23,9 %) sont supérieurs à ceux de « Black » (8,34 %), « Other » (10,3 %) et « Amer-Indian-Eskimo » (8,14 %). Ces taux plus faibles sont bien inférieurs au taux de sélection global de 19,6 %.
Différence de parité démographique : Différence de probabilité de recevoir une prédiction positive entre les groupes protégés. Une valeur proche de 0 indique moins de biais entre les groupes. La différence globale de parité démographique est de 15,8 %.
FAQ
Q : Que faire si le tableau de bord Fairness Dashboard reste bloqué sur « Calculating » ?
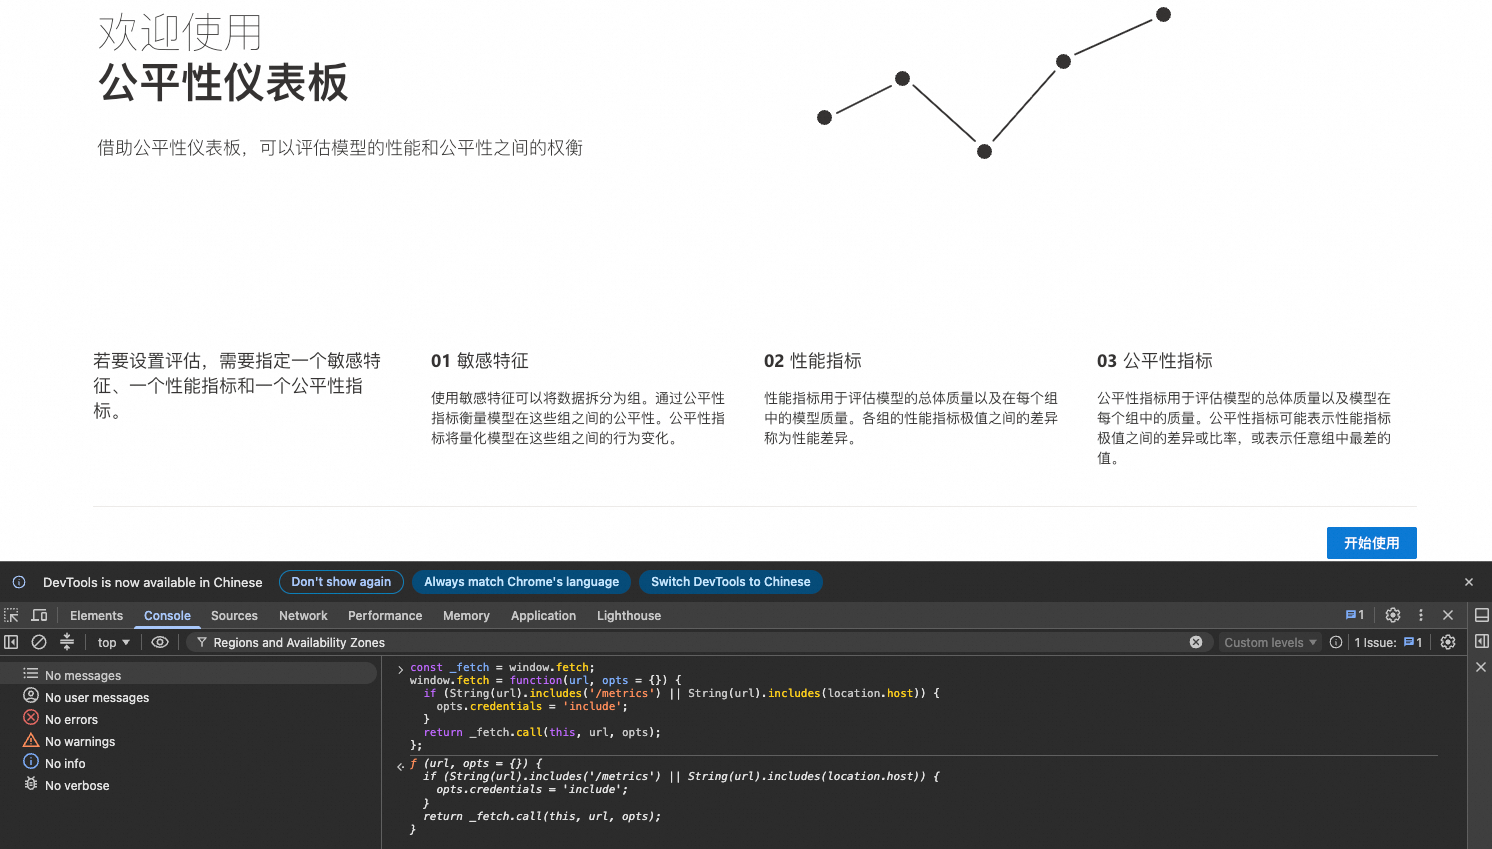
Dans l'environnement DSW, le tableau de bord Fairness Dashboard peut rester bloqué sur « Calculating » car les requêtes inter-origines ne transmettent pas les informations d'authentification. Pour résoudre ce problème, ouvrez la console du navigateur (appuyez sur F12 et accédez à l'onglet Console) sur la page d'accueil et exécutez le code suivant :
const _fetch = window.fetch;
window.fetch = function(url, opts = {}) {
  if (String(url).includes('/metrics') || String(url).includes(location.host)) {
    opts.credentials = 'include';
  }
  return _fetch.call(this, url, opts);
};