Ce tutoriel explique comment créer un pipeline de classification des sentiments dans Machine Learning Platform for AI (PAI) pour catégoriser automatiquement les avis clients comme positifs ou négatifs. À l'issue de ce tutoriel, vous disposerez d'un modèle de classification binaire entraîné affichant une précision d'environ 75 %, capable de classer correctement environ trois avis sur quatre. Vous pourrez ensuite appliquer ce modèle pour classifier par lots de grands volumes de nouveaux avis.
Contexte
Les plateformes en ligne reçoivent des milliers d'avis chaque jour. Le suivi manuel du sentiment à cette échelle est lent et sujet aux erreurs. PAI propose un modèle de pipeline prédéfini qui combine la vectorisation de texte et la régression logistique pour automatiser ce processus. Ce modèle s'appuie sur 11 987 avis étiquetés provenant d'une plateforme de livraison et peut être déployé en un à deux jours. Le même pipeline s'applique également à la classification des spams et à l'analyse des sentiments des commentaires d'actualités.
Jeu de données
Le pipeline utilise des données réelles anonymisées collectées auprès d'une plateforme de livraison. Le jeu de données contient deux champs :
| Champ | Type de données | Description |
|---|---|---|
| label | DOUBLE | Étiquette de sentiment : 1 = avis positif, 0 = avis négatif |
| review | STRING | Texte de l'avis |
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Un espace de travail PAI
Un bucket Object Storage Service (OSS) pour stocker les données temporaires et les modèles
Créer le pipeline
Étape 1 : Ouvrir Machine Learning Designer
Connectez-vous à la console PAI.
Dans le volet de navigation de gauche, cliquez sur Workspaces. Sur la page Workspaces, cliquez sur le nom de l'espace de travail que vous souhaitez gérer.
Dans le volet de navigation de gauche, choisissez Model Training > Visualized Modeling (Designer).
Étape 2 : Créer un pipeline à partir du modèle prédéfini
Sur la page Visualized Modeling (Designer), cliquez sur l'onglet Preset Templates.
Repérez le modèle Public Opinion Risk Control Based on Takeaway Reviews et cliquez sur Create.
Dans la boîte de dialogue Create Pipeline, examinez les paramètres. Le paramètre Data Storage définit le chemin du bucket OSS où le pipeline enregistre les données temporaires et les modèles lors de l'exécution. Conservez les valeurs par défaut, sauf si vous devez spécifier un autre chemin de bucket.
Cliquez sur OK.
Le pipeline est prêt en environ 10 secondes.
Sur l'onglet Pipelines, double-cliquez sur le pipeline Public Opinion Risk Control Based on Takeaway Reviews pour l'ouvrir.
Le canevas affiche cinq groupes de composants :
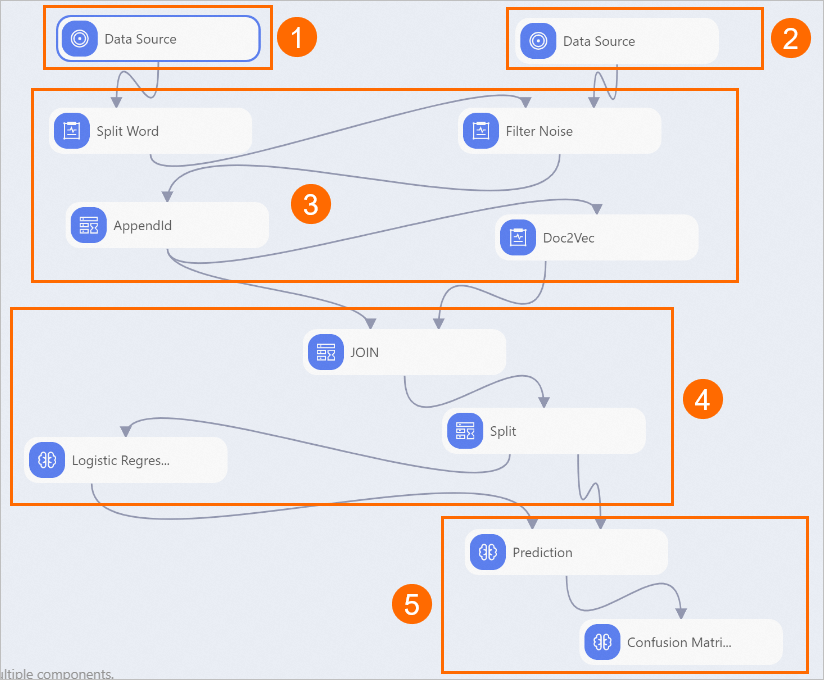
| Section | Fonction |
|---|---|
| ① | Importe le jeu de données des avis |
| ② | Importe les mots vides (verbes auxiliaires et signes de ponctuation). Téléchargez votre table de mots vides comme illustré ci-dessous : 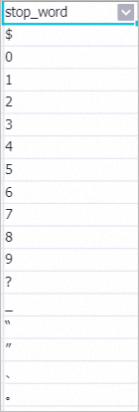 |
| ③ | Vectorise le texte à l'aide de Doc2Vec. Le composant Doc2Vec-1 convertit chaque avis en vecteur sémantique, chaque ligne représentant la signification d'un avis. Pour inspecter la sortie, faites un clic droit sur Doc2Vec sur le canevas et choisissez View Data > View Document Vector Table. |
| ④ | Entraîne le modèle. Le composant Split-1 divise les données vectorisées en un jeu de données d'entraînement et un jeu de données de prédiction. Le composant Logistic Regression for Binary Classification-1 entraîne ensuite un modèle de classification binaire sur le jeu de données d'entraînement. |
| ⑤ | Évalue la qualité du modèle à l'aide d'une matrice de confusion |
Étape 3 : Exécuter le pipeline et examiner les résultats
Dans le coin supérieur gauche du canevas, cliquez sur
 pour exécuter le pipeline.
Une fois l'exécution terminée, faites un clic droit sur Confusion Matrix sur le canevas et cliquez sur Visual Analysis.
Dans la section Confusion Matrix, cliquez sur l'onglet Statistics pour afficher les métriques de performance du modèle.
Le modèle atteint une précision d'environ 75 % sur le jeu de données étiqueté de 11 987 avis, ce qui signifie qu'il classe correctement environ trois avis sur quatre. La précision s'améliore à mesure que vous fournissez davantage d'avis étiquetés pour l'entraînement.
Étapes suivantes
Remplacez l'exemple de jeu de données par vos propres avis étiquetés pour entraîner un modèle adapté à votre activité.
Appliquez le modèle entraîné pour classifier les nouveaux avis par lots.
Étendez l'approche du pipeline à des tâches connexes de classification de texte, telles que le filtrage des spams ou l'analyse des sentiments des actualités.