Cette rubrique décrit les codes d'état et les erreurs courantes renvoyés lors de l'appel d'un service.
Descriptions des codes d'état
|
Code d'état |
Description |
|
200 |
Le service a traité la demande avec succès. |
|
400 |
Le format du corps de la demande est incorrect ou une exception s'est produite dans le code du processeur personnalisé. Remarque
Si le code de votre processeur personnalisé génère une exception, le serveur renvoie un code d'état 400. Pour différencier cette erreur des autres, configurez votre processeur personnalisé afin qu'il renvoie un code d'état spécifique en cas d'exception. |
|
401 |
L'authentification du service a échoué. Pour plus d'informations, consultez 401 Authorization Failed. |
|
404 |
Service introuvable. Pour plus d'informations, consultez 404 Not Found. |
|
405 |
Méthode non autorisée. Par exemple, le serveur renvoie une erreur 405 si vous envoyez une requête POST à un serveur qui ne prend en charge que les requêtes GET. Essayez d'utiliser une autre méthode HTTP. |
|
408 |
La demande a expiré. Le serveur applique un délai d'expiration par défaut de 5 secondes pour chaque demande. Vous pouvez configurer ce paramètre en définissant le champ Remarque
Le temps de traitement total d'une seule demande inclut le temps de calcul du processeur, le temps de réception des paquets de données réseau et tout temps passé en attente dans une file d'attente. |
|
429 |
La demande a déclenché une limitation de débit.
|
|
450 |
|
|
499 |
Le client a fermé la connexion. Lorsqu'un client ferme activement une connexion, il ne reçoit pas le code d'état 499. En revanche, le serveur enregistre toutes les demandes non traitées provenant de cette connexion avec un code d'état 499. Par exemple, si un client dispose d'un délai d'expiration HTTP de 30 ms et que la latence de traitement côté serveur est de 50 ms, le client abandonne la demande après 30 ms et ferme la connexion. Un code d'état 499 apparaît alors dans la surveillance côté serveur. |
|
500 |
Erreur interne du serveur. Le serveur a rencontré une condition inattendue qui l'a empêché de satisfaire la demande. |
|
501 |
Non implémenté. Le serveur ne prend pas en charge la fonctionnalité requise pour satisfaire la demande. |
|
502 |
Mauvaise passerelle. Le serveur, agissant en tant que passerelle ou proxy, a reçu une réponse invalide d'un serveur amont. |
|
503 |
Service indisponible. Lorsque vous accédez à un service via une passerelle, si aucune instance de service backend n'est dans un état prêt, la passerelle renvoie un code d'état 503. Pour plus d'informations, consultez 503 no healthy upstream. |
|
504 |
Délai d'expiration de la passerelle. Pour plus d'informations, consultez 504 timeout. |
|
505 |
Version HTTP non prise en charge. Le serveur ne prend pas en charge la version du protocole HTTP utilisée dans la demande. |
Codes d'erreur d'appel SDK
Lors de l'utilisation du SDK EAS officiel pour appeler un service, le SDK peut générer ses propres codes d'erreur, qui peuvent différer de ceux renvoyés par le serveur. Reportez-vous toujours aux codes d'erreur présents dans les journaux de la passerelle et du service comme source de vérité.
|
Code d'état |
Description |
|
512 |
Lors de l'utilisation du SDK EAS Golang, si le client se déconnecte activement, le SDK renvoie un code d'erreur 512. Ce délai d'expiration côté client correspond à un code d'état 499 côté serveur. |
Erreurs courantes
404 Not Found
Une erreur 404 indique généralement un chemin de demande invalide, un corps de demande incorrect ou une API non prise en charge par le service. Utilisez les scénarios suivants pour résoudre les problèmes en fonction du message d'erreur spécifique que vous recevez.
Type d'erreur 1 : {"object":"error","message":"The model `` does not exist.","type":"NotFoundError","param":null,"code":404}
Cause : Le paramètre model dans le corps de la demande est vide ou invalide lors de l'appel au point de terminaison /v1/chat/completions d'un service déployé avec vLLM.

Solution : La valeur du paramètre model doit être un nom de modèle valide. Interrogez les noms de modèles valides en utilisant le point de terminaison v1/models.
Type d'erreur 2 : {"detail":"Not Found"}
Cause : Le chemin de la demande est incomplet ou incorrect. Par exemple, lors de l'appel au point de terminaison de chat d'un service LLM, vous n'avez pas ajouté le chemin v1/chat/completions à l'URL de base.

Solution : Assurez-vous que le chemin de la demande API est complet et correct. Pour les services LLM, consultez Appel de service LLM.
Type d'erreur 3 : L'appel au point de terminaison /v1/models de BladeLLM renvoie 404: Not Found.
Cause : Le service déployé avec BladeLLM ne prend pas en charge le point de terminaison v1/models.

Solution : Pour obtenir la liste des API prises en charge, consultez Configurations des paramètres d'appel de service BladeLLM.
Type d'erreur 4 : La page de débogage en ligne renvoie une erreur 404 sans autre information.
Cause : Le chemin de la demande est incorrect. Lorsque vous utilisez le débogage en ligne, l'URL de base est généralement http://123***.cn-hangzhou.pai-eas.aliyuncs.com/predict/service_name. La modification ou la suppression incorrecte de la partie nom du service de l'URL entraîne une erreur 404.

Solution : Lorsque vous utilisez le débogage en ligne, vous n'avez généralement pas besoin de modifier ou de supprimer l'URL par défaut. Ajoutez le chemin d'API spécifique que vous devez appeler.
Type d'erreur 5 : Un appel API à ComfyUI renvoie « 404 not found page ».
400 Bad Request
Le format du corps de la demande est incorrect. Vérifiez attentivement le format du corps de la demande, tel que la structure JSON, les noms des champs et les types de données.
401 Authorization Failed
Le jeton d'authentification est manquant, incorrect ou utilisé de manière inappropriée. Vérifiez les points suivants :
-
Vérifiez si le jeton est correct. Sur la page Overview du service, cliquez sur View Invocation Information dans la section Basic Information.
RemarquePar défaut, le service génère automatiquement le jeton d'authentification. Vous pouvez également spécifier un jeton personnalisé et le mettre à jour lors des mises à jour du service.
-
Vérifiez si le jeton est correctement défini.
Si vous utilisez la commande
curl, ajoutez le jeton au champAuthorizationdans l'en-tête HTTP. Par exemple :curl -H 'Authorization: NWMyN2UzNjBiZmI2YT***' http:// xxx.cn-shanghai.aliyuncs.com/api/predict/echo.Si vous utilisez un SDK pour accéder au service, appelez la fonction
SetToken()correspondante. Pour plus d'informations, consultez Instructions pour l'utilisation du SDK Java.
504 timeout
Le serveur, agissant en tant que passerelle ou proxy, n'a pas reçu de réponse dans les délais impartis d'un serveur amont. Cela signifie généralement que l'inférence du modèle prend trop de temps. Pour résoudre ce problème :
Dans votre code client, augmentez le délai d'expiration de la demande HTTP.
Pour les tâches de longue durée, utilisez le mode Service de file d'attente EAS (appel asynchrone), conçu pour gérer les tâches d'inférence par lots ou de longue durée.
450 : Demande rejetée car la file d'attente est pleine
Lorsqu'une instance de calcul côté serveur reçoit une demande, elle place d'abord la demande dans une file d'attente. Lorsqu'un worker de l'instance devient disponible, il récupère les données de la file d'attente pour traitement. Le nombre par défaut de workers est de 5, que vous pouvez ajuster en utilisant le champ metadata.rpc.worker_threads dans le fichier JSON de création d'un service. Si le temps de traitement des workers est trop long, les demandes peuvent s'accumuler dans la file d'attente. Lorsque la file d'attente est pleine, l'instance rejette immédiatement les nouvelles demandes avec un code d'état 450 pour éviter qu'une mise en file d'attente excessive n'augmente la latence et ne rende le service indisponible. La longueur par défaut de la file d'attente est de 64, que vous pouvez ajuster en utilisant le champ metadata.rpc.max_queue_size dans le fichier JSON de création d'un service.
La limitation de la longueur de la file d'attente agit également comme une forme de limitation de débit pour empêcher les pics de trafic de provoquer une défaillance en cascade du service.
Solutions :
Si vous recevez un petit nombre de codes d'état 450, vous pouvez réessayer la demande. Étant donné que les instances côté serveur sont indépendantes, une nouvelle tentative pourrait être routée vers une instance moins occupée, rendant le problème transparent pour le client. Cependant, n'effectuez pas de nouvelles tentatives indéfiniment, car cela irait à l'encontre de l'objectif de la protection par limitation de débit.
Si toutes les demandes renvoient un code d'état 450, cela peut indiquer que le code à l'intérieur du processeur est bloqué. Si tous les workers sont en interblocage lors du traitement des demandes et ne récupèrent plus les données de la file d'attente, vous devez déboguer le code du processeur pour trouver le bug.
503 no healthy upstream
Vous recevez une erreur 503 avec le message « no healthy upstream » lors du débogage en ligne :
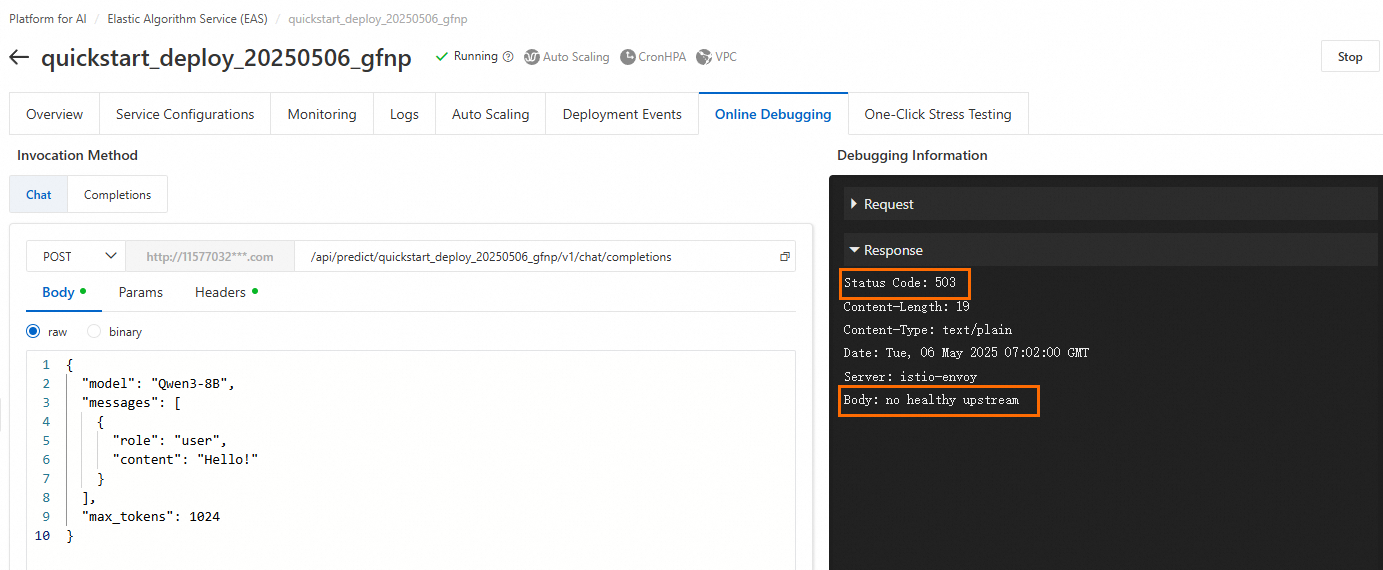
Résolvez le problème comme suit :
Vérifiez l'état de l'instance. Si l'instance s'est arrêtée, redémarrez le service.
-
Si l'état du service est Running, l'instance peut manquer de ressources, telles que CPU, mémoire ou mémoire GPU, ce qui entraîne un manque d'espace tampon.
Si vous utilisez des ressources publiques, essayez d'effectuer l'appel à nouveau pendant les heures creuses, ou passez à une spécification de ressource ou à une région différente.
Si vous utilisez une ressource dédiée (Groupe de ressources EAS), assurez-vous que le groupe de ressources a réservé suffisamment de CPU, de mémoire et de mémoire GPU pour l'instance. Nous recommandons de laisser au moins 20 % des ressources libres comme tampon.
Un autre scénario courant est que l'état du service est Running et que toutes les instances sont Ready après le déploiement. Cependant, une demande déclenche un bug dans le code, ce qui provoque le plantage de l'instance de service backend et la rend injoignable. Dans cette situation, la passerelle renvoie un code d'état 503 au client. Pour identifier et corriger le bug, utilisez les journaux.
Erreur : Unexpected token 12606 while expecting start token 200006
Lorsque vous utilisez vllm pour déployer gpt-oss, les appels de service peuvent renvoyer l'erreur suivante :

Solution : Essayez de déployer avec l'accélération SGLang.
Erreur d'appel curl : no URL specified
Vous recevez une erreur no URL specified après avoir envoyé une demande avec la commande suivante :
curl -X http://17****.cn-hangzhou.pai-eas.aliyuncs.com/api/predict/service_name/**path** \
-H "Content-Type: application/json" \
-H "Authorization: **********==" \
-d '{"***":"****"}'
Cause : La commande curl utilise l'indicateur -X mais omet la méthode, telle que POST.
L'appel renvoie un encodage ASCII
Modifiez votre code comme suit :
from flask import Flask, Response

@app.route('/hello', methods=['POST'])
def get_advice():
    result = "result"
    return Response(result, mimetype='text/plain', charset='utf-8')
Comment résoudre « [WARN] connection is closed: End of file » ou « Write a Invalid stream: End of file » dans les journaux de service ?
Ce journal d'avertissement indique que le client ou le serveur a fermé la connexion et que le serveur tentait d'écrire une réponse vers cette connexion fermée. Une connexion peut être fermée de deux manières :
Délai d'expiration côté serveur : En mode Processeur, le délai d'expiration par défaut côté serveur est de 5 secondes. Vous pouvez le modifier en utilisant le paramètre
metadata.rpc.keepalivedu service. Lorsque le délai d'expiration est atteint, le serveur ferme la connexion et enregistre un code d'état 408 dans sa surveillance.Délai d'expiration côté client : Les paramètres de votre code d'appel déterminent le délai d'expiration côté client. Si le client ne reçoit pas de réponse HTTP dans le délai d'expiration configuré, il ferme activement la connexion. Le serveur enregistre alors un code d'état 499 dans sa surveillance.
upstream connect error or disconnect/reset before headers. reset reason: connection termination
Des problèmes tels qu'un délai d'expiration de connexion persistant ou des charges d'instance déséquilibrées provoquent généralement cette erreur. Si le temps de traitement côté serveur dépasse le délai d'expiration HTTP configuré sur le client, le client abandonne la demande et ferme activement la connexion. Un code d'état 499 apparaît alors dans la surveillance côté serveur. Vous pouvez vérifier les métriques de surveillance pour une confirmation supplémentaire. Pour les tâches d'inférence chronophages, déployez un service d'inférence asynchrone.
Comment résoudre les échecs de débogage en ligne pour les services déployés avec un processeur Tensorflow/Pytorch ?
Pour des raisons de performances, les processeurs TensorFlow/PyTorch utilisent un format protobuf non textuel pour le corps de la demande. Le débogage en ligne prend actuellement en charge uniquement l'entrée de texte brut. Par conséquent, vous ne pouvez pas déboguer directement les services déployés avec ces processeurs dans la console. Utilisez les SDK EAS fournis pour appeler le service. Pour obtenir des informations sur les SDK dans différents langages, consultez SDK d'appel de service.