Le one-hot encoding convertit une variable catégorielle comportant m valeurs possibles en m variables binaires mutuellement exclusives, dont une seule est active par ligne. Le résultat est stocké dans une structure clé-valeur (KV) clairsemée.
Fonctionnement
Pour chaque colonne spécifiée, le composant associe chaque valeur distincte à un index unique et génère un indicateur binaire pour chaque correspondance. Une colonne contenant trois valeurs distinctes produit trois colonnes binaires, avec exactement une valeur définie sur 1,0 par ligne.
Le composant prend en charge deux modes :
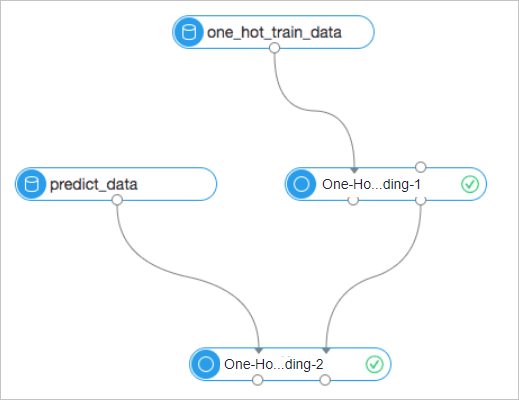
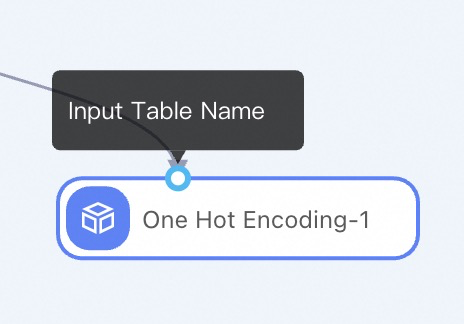
Training : Lit les données d'entrée, construit une table de mappage et écrit à la fois le résultat encodé et la table de modèle. Seul le nœud d'entrée de gauche (Input Table Name) est requis.
Prediction : Lit une table de modèle précédemment construite à partir du nœud d'entrée de droite (Input Model Table) et applique l'encodage existant aux nouvelles données. Les valeurs absentes de la table de mappage sont ignorées et non encodées.
Configuration du composant
Méthode 1 : Configuration sur la page du pipeline
| Onglet | Paramètre | Description |
|---|---|---|
| Fields setting | Select binary column | Obligatoire. Colonnes à encoder. Accepte tout type de données. |
| Other reserved features | Colonnes transmises à la sortie au format KV. Doivent être de type DOUBLE. Ces colonnes ne sont pas encodées ; elles sont indexées à partir de 0. | |
| Appended columns | Colonnes copiées dans la table de sortie sans aucune transformation. | |
| Parameters setting | Output table type | KV (clairsemé, recommandé pour les variables à cardinalité élevée) ou Table (dense, maximum 1 024 colonnes). |
| Delete encoding of last enumeration | Lorsque cette option est activée, l'indépendance linéaire des données encodées est garantie. | |
| Ignore empty elements | Lorsque cette option est activée, les valeurs NULL ne sont pas encodées. Lorsqu'elle est désactivée (par défaut), NULL est traité comme une catégorie distincte et reçoit son propre index. | |
| Lifecycle | Durée de conservation de la table de sortie en jours. Par défaut : 7. | |
| Cores | Nombre de cœurs pour la tâche. Déterminé par le système si ce champ est laissé vide. | |
| Memory size per node | Mémoire allouée à chaque cœur, en Mo. Plage valide : 2 048–65 536 Mo. Déterminé par le système si ce champ est laissé vide. |
Méthode 2 : Utilisation des commandes PAI
Appelez le composant depuis le composant SQL Script en utilisant la syntaxe suivante :
PAI -name one_hot
    -project algo_public
    -DinputTable=one_hot_test
    -DbinaryCols=f0,f1,f2
    -DmodelTable=one_hot_model
    -DoutputTable=one_hot_output
    -Dlifecycle=28;
Pour plus d'informations sur l'appel des commandes PAI, consultez Script SQL.
Référence des paramètres
| Paramètre | Obligatoire | Valeur par défaut | Description |
|---|---|---|---|
inputTable |
Oui | — | Nom de la table d'entrée. |
inputTablePartitions |
Non | Toutes les partitions | Partitions à utiliser à partir de la table d'entrée lors de l'entraînement. |
binaryCols |
Oui | — | Liste séparée par des virgules des colonnes à encoder. Accepte les variables d'énumération de tout type de données. |
reserveCols |
Non | Vide | Colonnes transmises au format KV. Doivent être de type DOUBLE. Ces colonnes ne sont pas encodées et sont indexées à partir de 0. |
appendCols |
Non | — | Colonnes copiées dans la table de sortie sans transformation. |
outputTable |
Oui | — | Nom de la table de sortie. Les résultats sont stockés au format KV par défaut. |
inputModelTable |
Non | Vide | Table de modèle existante à utiliser pour la prédiction. Soit inputModelTable, soit outputModelTable doit être une chaîne non vide. Lorsque ce paramètre est spécifié, la table doit être une table de modèle valide et non vide. |
outputModelTable |
Non | Vide | Nom de la table de modèle à écrire lors de l'entraînement. Soit inputModelTable, soit outputModelTable doit être une chaîne non vide. |
lifecycle |
Non | 7 | Durée de conservation de la table de sortie en jours. |
dropLast |
Oui | false | Lorsque cette option est activée, supprime la dernière colonne binaire pour chaque variable afin de garantir l'indépendance linéaire des données encodées. |
outputTableType |
Oui | kv | Format de sortie. kv produit une table clairsemée adaptée aux variables à cardinalité élevée. table produit une table dense avec un maximum de 1 024 colonnes — une erreur est générée si le nombre de colonnes dépasse cette limite. |
ignoreNull |
Oui | false | Lorsque cette option est activée, les valeurs NULL sont ignorées lors de l'encodage. Lorsqu'elle est désactivée, NULL est traité comme une catégorie distincte avec son propre index. |
coreNum |
Non | Déterminé par le système | Nombre de cœurs pour la tâche. |
memSizePerCore |
Non | Déterminé par le système | Mémoire par cœur en Mo. Plage valide : 2 048–65 536 Mo. |
Remarque : Lors de l'utilisation d'un modèle entraîné pour des encodages ultérieurs, les paramètresdropLast,ignoreNulletreserveColssont verrouillés sur les valeurs définies lors de l'entraînement et ne peuvent pas être modifiés. Pour utiliser des valeurs différentes pour ces paramètres, réentraînez le modèle.
Exemple
L'exemple suivant encode trois colonnes — f0 (BIGINT), f2 (DATETIME) et f4 (BOOLEAN) — tout en transmettant f3 (DOUBLE) en tant que variable réservée et en ajoutant les colonnes originales f0, f2 et f4 à la sortie.
Étape 1 : Données d'entrée d'exemple
| f0 (BIGINT) | f1 (STRING) | f2 (DATETIME) | f3 (DOUBLE) | f4 (BOOLEAN) |
|---|---|---|---|---|
| 12 | prefix1 | 1970-09-15 12:50:22 | 0,1 | true |
| 12 | prefix3 | 1971-01-22 03:15:33 | 0,4 | false |
| NULL | prefix3 | 1970-01-01 08:00:00 | 0,2 | NULL |
| 3 | NULL | 1970-01-01 08:00:00 | 0,3 | false |
| 34 | NULL | 1970-09-15 12:50:22 | 0,4 | NULL |
| 3 | prefix1 | 1970-09-15 12:50:22 | 0,2 | true |
| 3 | prefix1 | 1970-09-15 12:50:22 | 0,3 | false |
| 3 | prefix3 | 1970-01-01 08:00:00 | 0,2 | true |
| 3 | prefix3 | 1971-01-22 03:15:33 | 0,1 | false |
| NULL | prefix3 | 1970-01-01 08:00:00 | 0,3 | false |
Étape 2 : Commande PAI
PAI -project algo_public -name one_hot
    -DinputTable=one_hot
    -DbinaryCols=f0,f2,f4
    -DoutputModelTable=one_hot_model_8
    -DoutputTable=one_hot_in_table_1_output_8
    -DdropLast=false
    -DappendCols=f0,f2,f4
    -DignoreNull=false
    -DoutputTableType=table
    -DreserveCols=f3
    -DcoreNum=4
    -DmemSizePerCore=2048;
Étape 3 : Sortie
La table de modèle associe chaque valeur distincte à un index. La première ligne (avec col_name fixé sur _reserve_) stocke le mappage des colonnes réservées. Toutes les autres lignes correspondent aux mappages d'encodage.
| col_name | col_value | mapping |
|---|---|---|
| _reserve_ | f3 | 0 |
| f0 | 12 | 1 |
| f0 | 3 | 2 |
| f0 | 34 | 3 |
| f0 | null | 4 |
| f2 | 0 | 5 |
| f2 | 22222222000 | 6 |
| f2 | 33333333000 | 7 |
| f4 | 0 | 8 |
| f4 | 1 | 9 |
| f4 | null | 10 |
Table
La table de résultats encodés (format Table) utilise le modèle de nommage de colonne {field}_{value}_{index} :
| f0 | f2 | f4 | _reserve__f3_0 | f0_12_1 | f0_3_2 | f0_34_3 | f0_null_4 | f2_0_5 | f2_22222222_6 | f2_33333333_7 | f4_0_8 | f4_1_9 | f4_null_10 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 12 | 1970-09-15 12:50:22 | true | 0,1 | 1,0 | 0,0 | 0,0 | 0,0 | 0,0 | 1,0 | 0,0 | 0,0 | 1,0 | 0,0 |
| 12 | 1971-01-22 03:15:33 | false | 0,4 | 1,0 | 0,0 | 0,0 | 0,0 | 0,0 | 0,0 | 1,0 | 1,0 | 0,0 | 0,0 |
| NULL | 1970-01-01 08:00:00 | NULL | 0,2 | 0,0 | 0,0 | 0,0 | 1,0 | 1,0 | 0,0 | 0,0 | 0,0 | 0,0 | 1,0 |
| 3 | 1970-01-01 08:00:00 | false | 0,3 | 0,0 | 1,0 | 0,0 | 0,0 | 1,0 | 0,0 | 0,0 | 1,0 | 0,0 | 0,0 |
| 34 | 1970-09-15 12:50:22 | NULL | 0,4 | 0,0 | 0,0 | 1,0 | 0,0 | 0,0 | 1,0 | 0,0 | 0,0 | 0,0 | 1,0 |
| 3 | 1970-09-15 12:50:22 | true | 0,2 | 0,0 | 1,0 | 0,0 | 0,0 | 0,0 | 1,0 | 0,0 | 0,0 | 1,0 | 0,0 |
| 3 | 1970-09-15 12:50:22 | false | 0,3 | 0,0 | 1,0 | 0,0 | 0,0 | 0,0 | 1,0 | 0,0 | 1,0 | 0,0 | 0,0 |
| 3 | 1970-01-01 08:00:00 | true | 0,2 | 0,0 | 1,0 | 0,0 | 0,0 | 1,0 | 0,0 | 0,0 | 0,0 | 1,0 | 0,0 |
| 3 | 1971-01-22 03:15:33 | false | 0,1 | 0,0 | 1,0 | 0,0 | 0,0 | 0,0 | 0,0 | 1,0 | 1,0 | 0,0 | 0,0 |
| NULL | 1970-01-01 08:00:00 | false | 0,3 | 0,0 | 0,0 | 0,0 | 1,0 | 1,0 | 0,0 | 0,0 | 1,0 | 0,0 | 0,0 |
KV
Les mêmes données au format KV :
| f0 | f2 | f4 | kv |
|---|---|---|---|
| 12 | 1970-09-15 12:50:22 | true | 0:0,1,1:1,6:1,9:1 |
| 12 | 1971-01-22 03:15:33 | false | 0:0,4,1:1,7:1,8:1 |
| NULL | 1970-01-01 08:00:00 | NULL | 0:0,2,4:1,5:1,10:1 |
| 3 | 1970-01-01 08:00:00 | false | 0:0,3,2:1,5:1,8:1 |
| 34 | 1970-09-15 12:50:22 | NULL | 0:0,4,3:1,6:1,10:1 |
| 3 | 1970-09-15 12:50:22 | true | 0:0,2,2:1,6:1,9:1 |
| 3 | 1970-09-15 12:50:22 | false | 0:0,3,2:1,6:1,8:1 |
| 3 | 1970-01-01 08:00:00 | true | 0:0,2,2:1,5:1,9:1 |
| 3 | 1971-01-22 03:15:33 | false | 0:0,1,2:1,7:1,8:1 |
| NULL | 1970-01-01 08:00:00 | false | 0:0,3,4:1,5:1,8:1 |
Test de scalabilité
Données de test : 200 millions d'échantillons, 100 000 valeurs d'énumération distinctes.
| Nombre de cœurs | Temps d'entraînement | Temps de prédiction | Ratio d'accélération |
|---|---|---|---|
| 5 | 84 s | 181 s | 1/1 |
| 10 | 60 s | 93 s | 1,4/1,95 |
| 20 | 46 s | 56 s | 1,8/3,23 |
Notes d'utilisation
Une seule colonne d'encodage peut contenir jusqu'à des dizaines de millions de valeurs distinctes.
La sortie KV utilise une indexation à partir de zéro.
Lors de la prédiction avec un modèle entraîné,
dropLast,ignoreNulletreserveColssont figés aux valeurs de l'entraînement et ne peuvent pas être remplacés. Réentraînez le modèle si vous avez besoin de valeurs différentes.Lors de l'encodage de nouvelles données à l'aide du modèle, si les données contiennent des valeurs discrètes absentes de la table de mappage du modèle, ces valeurs sont ignorées et non encodées. Pour encoder ces valeurs, la table de mappage du modèle doit être réentraînée.
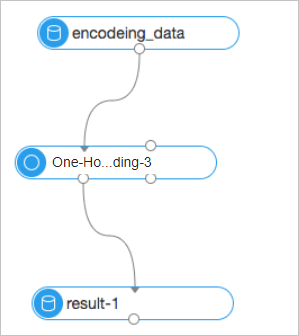
Exemples de flux de travail dans la console :
Utilisez directement le composant pour l'encodage.
Entraînez un modèle avec le composant, puis utilisez le modèle pour encoder de nouvelles données.