Une machine à vecteurs de support (SVM) est une méthode d'apprentissage automatique fondée sur la théorie de l'apprentissage statistique. Elle améliore la capacité de généralisation d'un modèle grâce à la minimisation du risque structurel, qui équilibre le risque empirique et l'intervalle de confiance. Cette rubrique explique comment configurer le composant SVM linéaire et inclut un exemple d'utilisation.
Contexte
Cet algorithme SVM linéaire est implémenté sans utiliser de fonction noyau. Pour plus de détails sur l'implémentation, consultez la section « trust region method for L2-SVM » dans les principes de l'algorithme.
Limites
Le composant SVM linéaire prend uniquement en charge la classification binaire.
Configuration du composant
Vous pouvez configurer les paramètres du composant SVM linéaire à l'aide de l'une des méthodes suivantes.
Méthode 1 : Configuration visuelle
-
Port d'entrée
Le composant SVM linéaire dispose d'un port d'entrée obligatoire qui doit être connecté à un composant Read Table.
-
Configurez les paramètres du composant sur la page du workflow.
Type de paramètre
Paramètre
Obligatoire
Description
Paramètres des champs
Colonnes de caractéristiques
Oui
Les colonnes de caractéristiques pour l'entraînement du modèle. Types de données pris en charge : BIGINT et DOUBLE.
Colonne d'étiquette
Oui
La colonne d'étiquette pour l'entraînement du modèle. Types de données pris en charge : BIGINT, DOUBLE et STRING.
Paramètres
Valeur d'étiquette de l'échantillon positif
Non
La valeur qui représente un échantillon positif. Si ce paramètre n'est pas spécifié, une valeur est sélectionnée au hasard dans la colonne d'étiquette. Il est recommandé de spécifier ce paramètre pour les jeux de données déséquilibrés.
Facteur de pénalité positif
Non
Le poids des échantillons positifs. La valeur par défaut est 1,0 et la plage de valeurs est (0, +∞).
Facteur de pénalité négatif
Non
Le poids des échantillons négatifs a une valeur par défaut de 1,0 et une plage de valeurs de (0, +∞).
Coefficient de convergence
Non
Erreur de convergence. La valeur par défaut est 0,001. La plage de valeurs est (0, 1).
Optimisation de l'exécution
Nombre de cœurs
Non
Si non spécifié, le système alloue automatiquement les ressources.
Mémoire par cœur
Non
La taille de la mémoire pour chaque cœur, en Mo. Si non spécifié, le système alloue automatiquement les ressources.
-
Port de sortie
Produit un modèle de classification binaire au format OfflineModel. La sortie de ce composant se connecte à un composant Prediction.
Méthode 2 : Commande PAI
Vous pouvez configurer les paramètres du composant en exécutant une commande PAI dans un composant SQL Script. Pour plus d'informations, consultez SQL Script.
PAI -name LinearSVM -project algo_public
    -DinputTableName="bank_data"
    -DmodelName="xlab_m_LinearSVM_6143"
    -DfeatureColNames="pdays,emp_var_rate,cons_conf_idx"
    -DlabelColName="y"
    -DpositiveLabel="0"
    -DpositiveCost="1.0"
    -DnegativeCost="1.0"
    -Depsilon="0.001";
Le tableau suivant décrit les paramètres de la commande PAI.
|
Paramètre |
Obligatoire |
Valeur par défaut |
Description |
|
inputTableName |
Oui |
S/O |
Le nom de la table d'entrée. |
|
inputTablePartitions |
Non |
Toutes les partitions de la table d'entrée. |
Les partitions de la table d'entrée pour l'entraînement. Les formats suivants sont pris en charge :
Remarque
Pour spécifier plusieurs partitions, séparez-les par des virgules (,). |
|
modelName |
Oui |
S/O |
Le nom du modèle de sortie. |
|
featureColNames |
Oui |
S/O |
Les noms des colonnes de caractéristiques dans la table d'entrée. |
|
labelColName |
Oui |
S/O |
Le nom de la colonne d'étiquette dans la table d'entrée. |
|
positiveLabel |
Non |
Une valeur est sélectionnée au hasard dans la colonne label. |
La valeur qui représente un échantillon positif. |
|
positiveCost |
Non |
1,0 |
Le poids de la classe positive, également appelé facteur de pénalité positif. La valeur doit être comprise dans la plage (0, +∞). |
|
negativeCost |
Non |
1,0 |
Le poids de la classe négative, également appelé facteur de pénalité négatif. La valeur doit être comprise dans la plage (0, +∞). |
|
epsilon |
Non |
0,001 |
Le coefficient de convergence. La valeur doit être comprise dans la plage (0,1). |
|
enableSparse |
Non |
false |
Indique si les données d'entrée sont au format sparse. Valeurs valides : true et false. |
|
itemDelimiter |
Non |
, (virgule) |
Le délimiteur entre les paires KV lorsque les données de la table d'entrée sont au format sparse. |
|
kvDelimiter |
Non |
: (deux-points) |
Le délimiteur entre la key et la value lorsque les données de la table d'entrée sont au format sparse. |
|
coreNum |
Non |
Alloué par le système |
Le nombre de cœurs de calcul. La valeur doit être un entier positif. |
|
memSizePerCore |
Non |
Alloué par le système |
La taille de la mémoire pour chaque cœur, en Mo. La valeur doit être un entier compris dans la plage [1, 65536]. |
Exemple
-
Importez les données d'entraînement suivantes.
id
y
f0
f1
f2
f3
f4
f5
f6
f7
1
-1
-0.294118
0.487437
0.180328
-0.292929
-1
0.00149028
-0.53117
-0.0333333
2
+1
-0.882353
-0.145729
0.0819672
-0.414141
-1
-0.207153
-0.766866
-0.666667
3
-1
-0.0588235
0.839196
0.0491803
-1
-1
-0.305514
-0.492741
-0.633333
4
+1
-0.882353
-0.105528
0.0819672
-0.535354
-0.777778
-0.162444
-0.923997
-1
5
-1
-1
0.376884
-0.344262
-0.292929
-0.602837
0.28465
0.887276
-0.6
6
+1
-0.411765
0.165829
0.213115
-1
-1
-0.23696
-0.894962
-0.7
7
-1
-0.647059
-0.21608
-0.180328
-0.353535
-0.791962
-0.0760059
-0.854825
-0.833333
8
+1
0.176471
0.155779
-1
-1
-1
0.052161
-0.952178
-0.733333
9
-1
-0.764706
0.979899
0.147541
-0.0909091
0.283688
-0.0909091
-0.931682
0.0666667
10
-1
-0.0588235
0.256281
0.57377
-1
-1
-1
-0.868488
0.1
-
Importez les données de test suivantes.
id
y
f0
f1
f2
f3
f4
f5
f6
f7
1
+1
-0.882353
0.0854271
0.442623
-0.616162
-1
-0.19225
-0.725021
-0.9
2
+1
-0.294118
-0.0351759
-1
-1
-1
-0.293592
-0.904355
-0.766667
3
+1
-0.882353
0.246231
0.213115
-0.272727
-1
-0.171386
-0.981213
-0.7
4
-1
-0.176471
0.507538
0.278689
-0.414141
-0.702128
0.0491804
-0.475662
0.1
5
-1
-0.529412
0.839196
-1
-1
-1
-0.153502
-0.885568
-0.5
6
+1
-0.882353
0.246231
-0.0163934
-0.353535
-1
0.0670641
-0.627669
-1
7
-1
-0.882353
0.819095
0.278689
-0.151515
-0.307329
0.19225
0.00768574
-0.966667
8
+1
-0.882353
-0.0753769
0.0163934
-0.494949
-0.903073
-0.418778
-0.654996
-0.866667
9
+1
-1
0.527638
0.344262
-0.212121
-0.356974
0.23696
-0.836038
-0.8
10
+1
-0.882353
0.115578
0.0163934
-0.737374
-0.56974
-0.28465
-0.948762
-0.933333
-
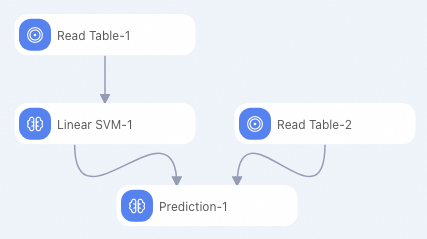
Créez un pipeline comme indiqué dans la figure suivante. Pour plus d'informations, consultez modélisation d'algorithme.
-
Configurez les paramètres du composant SVM linéaire comme indiqué dans le tableau suivant. Conservez les valeurs par défaut pour tous les autres paramètres.
Type de paramètre
Paramètre
Description
Paramètres des champs
Colonnes de caractéristiques
Sélectionnez les colonnes f0, f1, f2, f3, f4, f5, f6 et f7.
Colonne d'étiquette
Sélectionnez la colonne y.
Exécutez le pipeline et consultez les résultats de prédiction. Une fois la prédiction terminée, la sortie affiche les résultats de prédiction de classification binaire pour les 10 lignes de données de test dans cinq colonnes : id, y (étiquette réelle), prediction_result (étiquette prédite : +1 ou -1), prediction_score et prediction_detail (détails des scores pour les classes +1 et -1, au format JSON).