Le clustering K-means est un algorithme d'apprentissage non supervisé qui partitionne un jeu de données en K clusters en minimisant la somme des erreurs quadratiques (SSE) au sein de chaque cluster. Il attribue itérativement les points de données au centroïde le plus proche, puis recalcule la position des centroïdes jusqu'à la stabilisation des attributions ou l'atteinte du nombre maximal d'itérations.
Fonctionnement
Sélectionnez les centroïdes initiaux. Échantillonnez aléatoirement K points de données comme centroïdes initiaux, ou utilisez l'une des méthodes d'initialisation prises en charge (aléatoire, topk, k-means++, uniforme ou une table de centroïdes externe).
Attribuez les points de données aux clusters. Calculez la distance entre chaque point de données et chaque centroïde, puis attribuez chaque point à son centroïde le plus proche.
Mettez à jour les centroïdes. Recalculez la position de chaque centroïde en faisant la moyenne de tous les points attribués à ce cluster.
Répétez jusqu'à convergence. Répétez les étapes 2 et 3 jusqu'à ce que la valeur de la fonction objectif varie de moins que le seuil de convergence entre deux itérations, ou jusqu'à l'atteinte du nombre maximal d'itérations.
Le clustering K-means traite les points de données comme des vecteurs spatiaux. Les colonnes de type INT ou DOUBLE sont prises en charge. Lorsque l'entrée est au format creux (sparse), les colonnes de type STRING sont également prises en charge.
Configuration du composant
Méthode 1 : Configurer dans Machine Learning Designer
Sur la page des détails du pipeline dans Machine Learning Designer, ajoutez le composant K-means Clustering au pipeline, puis configurez les paramètres suivants.
| Onglet | Paramètre | Description |
|---|---|---|
| Fields Setting | Feature Columns | Colonnes de la table d'entrée utilisées pour l'entraînement. Séparez les noms de colonnes par des virgules (,). Les types INT et DOUBLE sont pris en charge. Pour les entrées creuses, le type STRING est également pris en charge. |
| Appended Columns | Colonnes d'entrée à ajouter à la table de résultats du clustering. Séparez les noms de colonnes par des virgules (,). | |
| Input Sparse Matrix | Indique si les données d'entrée sont au format creux. Les données creuses sont représentées sous forme de paires clé-valeur. | |
| KV Pair Delimiter | Délimiteur entre les paires clé-valeur. Par défaut : virgule (,). | |
| KV Delimiter | Délimiteur entre les clés et les valeurs au sein d'une paire. Par défaut : deux-points (:). | |
| Parameters Setting | Clusters | Nombre de centroïdes de cluster. Valeurs valides : 1–1000. |
| Distance Measurement Method | Métrique de distance. Valeurs valides : Euclidean, Cosine, Cityblock. | |
| Centroid Initialization Method | Méthode d'initialisation des centroïdes. Valeurs valides : Random, First K, Uniform, K-means++, Use Initial Centroid Table. | |
| Maximum Iterations | Nombre maximal d'itérations. Valeurs valides : 1–1000. | |
| Convergence Criteria | Seuil d'arrêt des itérations. L'algorithme s'arrête lorsque la différence de la fonction objectif entre deux itérations consécutives est inférieure à cette valeur. | |
| Initial Random Seed | Graine pour l'initialisation aléatoire. Par défaut : heure actuelle. Définissez une valeur fixe pour obtenir des résultats stables et reproductibles. | |
| Tuning | Cores | Nombre de cœurs de calcul. Par défaut : déterminé par le système. |
| Memory Size per Core | Mémoire par cœur. Unité : Mo. |
Méthode 2 : Utiliser les commandes PAI
Transmettez les paramètres à l'aide des commandes PAI. Utilisez le composant SQL Script pour exécuter les commandes PAI. Pour plus d'informations, consultez la rubrique Scénario 4 : Exécuter des commandes PAI dans le composant SQL script.
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_input
    -DselectedColNames=f0,f1
    -DappendColNames=f0,f1
    -DcenterCount=3
    -Dloop=10
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=random
    -Dseed=1
    -DmodelName=pai_kmeans_test_output_model_
    -DidxTableName=pai_kmeans_test_output_idx
    -DclusterCountTableName=pai_kmeans_test_output_couter
-DcenterTableName=pai_kmeans_test_output_center;| **Paramètre** | **Obligatoire** | **Valeur par défaut** | **Description** | ||
|---|---|---|---|---|---|
inputTableName |
Oui | — | Nom de la table d'entrée. | ||
selectedColNames |
Non | Toutes les colonnes | Colonnes de la table d'entrée utilisées pour l'entraînement. Séparez les noms de colonnes par des virgules (,). Les types INT et DOUBLE sont pris en charge. Pour les entrées creuses, le type STRING est également pris en charge. | ||
inputTablePartitions |
Non | Toutes les partitions | Partitions de la table d'entrée utilisées pour l'entraînement. Formats pris en charge : partition_name=value ou name1=value1/name2=value2 pour les partitions multiniveaux. Séparez plusieurs partitions par des virgules (,). |
||
appendColNames |
Non | — | Colonnes d'entrée à ajouter à la table de résultats du clustering. Séparez les noms de colonnes par des virgules (,). | ||
enableSparse |
Non | false |
Indique si les données d'entrée sont au format creux. Valeurs valides : true, false. |
||
itemDelimiter |
Non | , |
Délimiteur entre les paires clé-valeur. | ||
kvDelimiter |
Non | : |
Délimiteur entre les clés et les valeurs au sein d'une paire. | ||
centerCount |
Oui | 10 | Nombre de centroïdes de cluster. Valeurs valides : 1–1000. | ||
distanceType |
Non | euclidean |
Métrique de distance. Valeurs valides : euclidean, cosine, cityblock. Formules :- Euclidean : d(x - c) = (x - c)(x - c)'- Cosine : 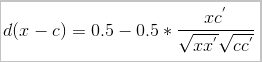 - Cityblock (distance de Manhattan) : |
x - c |
` |
initCenterMethod |
Non | random |
Méthode d'initialisation des centroïdes. Valeurs valides :- random : Échantillonne aléatoirement K centroïdes à partir des données d'entrée. Le paramètre seed contrôle la graine aléatoire.- topk : Utilise les K premières lignes des données d'entrée comme centroïdes initiaux.- uniform : Répartit uniformément K centroïdes initiaux entre les valeurs minimales et maximales.- kmpp : Utilise l'algorithme k-means++ pour sélectionner les centroïdes initiaux.- external : Charge les centroïdes initiaux depuis une table externe (nécessite initCenterTableName). |
||
initCenterTableName |
Non | — | Nom de la table contenant les centroïdes initiaux. Prend effet uniquement lorsque initCenterMethod=external. |
||
loop |
Non | 100 | Nombre maximal d'itérations. Valeurs valides : 1–1000. | ||
accuracy |
Non | 0,1 | Seuil de convergence. L'algorithme s'arrête lorsque la différence de la fonction objectif entre deux itérations consécutives est inférieure à cette valeur. | ||
seed |
Non | Heure actuelle | Graine aléatoire initiale. Définissez une valeur fixe pour obtenir des résultats stables et reproductibles. | ||
modelName |
Non | — | Nom du modèle hors ligne de sortie. | ||
idxTableName |
Oui | — | Nom de la table de résultats du clustering, qui contient l'affectation de cluster pour chaque enregistrement. | ||
idxTablePartition |
Non | — | Partition dans la table de résultats du clustering. | ||
clusterCountTableName |
Non | — | Nom de la table de statistiques de clustering, qui contient le nombre de points de données dans chaque cluster. | ||
centerTableName |
Non | — | Nom de la table des centroïdes de clustering. | ||
coreNum |
Non | Valeur par défaut du système | Nombre de cœurs de calcul. Valeurs valides : 1–9999. Doit être spécifié conjointement avec memSizePerCore. |
||
memSizePerCore |
Non | Valeur par défaut du système | Mémoire par cœur. Valeurs valides : 1024–65536. Unité : Mo. | ||
lifecycle |
Non | — | Cycle de vie de la table de sortie. Unité : jours. |
Sortie
Le composant génère trois tables de sortie.
Table de résultats du clustering (idxTableName)
| Colonne | Description |
|---|---|
appendColNames |
Colonnes ajoutées depuis la table d'entrée. |
cluster_index |
ID du cluster attribué à chaque point de données. |
distance |
Distance entre chaque point de données et son centroïde de cluster attribué. |
Table de statistiques de clustering (clusterCountTableName)
| Colonne | Description |
|---|---|
cluster_index |
ID du cluster. |
cluster_count |
Nombre de points de données dans le cluster. |
Table des centroïdes de clustering (centerTableName)
| Colonne | Description |
|---|---|
cluster_index |
ID du cluster. |
selectedColNames |
Coordonnées du centroïde pour chaque colonne de caractéristique sélectionnée lors de l'entraînement. |
Exemples
Entrée dense
Étape 1 : Créez les données de test.
Créez une table de centroïdes initiaux facultative :
create table pai_kmeans_test_init_center as
select * from
(
  select 1 as f0, 2 as f1
  union all
  select 1 as f0, 3 as f1
  union all
  select 1 as f0, 4 as f1
) tmp;
Créez la table d'entrée :
create table pai_kmeans_test_input as
select * from
(
  select 'id1' as id, 1 as f0, 2 as f1
  union all
  select 'id2' as id, 1 as f0, 3 as f1
  union all
  select 'id3' as id, 1 as f0, 4 as f1
  union all
  select 'id4' as id, 0 as f0, 3 as f1
  union all
  select 'id5' as id, 0 as f0, 4 as f1
) tmp;
Étape 2 : Soumettez la tâche de clustering.
Utilisation d'une table de centroïdes externe :
drop table if exists pai_kmeans_test_output_idx;
yes
drop table if exists pai_kmeans_test_output_couter;
yes
drop table if exists pai_kmeans_test_output_center;
yes
drop offlinemodel if exists pai_kmeans_test_output_model_;
yes
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_input
    -DinitCenterTableName=pai_kmeans_test_init_center
    -DselectedColNames=f0,f1
    -DappendColNames=f0,f1
    -DcenterCount=3
    -Dloop=10
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=external
    -Dseed=1
    -DmodelName=pai_kmeans_test_output_model_
    -DidxTableName=pai_kmeans_test_output_idx
    -DclusterCountTableName=pai_kmeans_test_output_couter
    -DcenterTableName=pai_kmeans_test_output_center;
Utilisation de centroïdes initiaux sélectionnés aléatoirement :
drop table if exists pai_kmeans_test_output_idx;
yes
drop table if exists pai_kmeans_test_output_couter;
yes
drop table if exists pai_kmeans_test_output_center;
yes
drop offlinemodel if exists pai_kmeans_test_output_model_;
yes
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_input
    -DselectedColNames=f0,f1
    -DappendColNames=f0,f1
    -DcenterCount=3
    -Dloop=10
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=random
    -Dseed=1
    -DmodelName=pai_kmeans_test_output_model_
    -DidxTableName=pai_kmeans_test_output_idx
    -DclusterCountTableName=pai_kmeans_test_output_couter
    -DcenterTableName=pai_kmeans_test_output_center;
Étape 3 : Consultez les résultats.
Table de résultats du clustering (idxTableName) :
+------------+------------+---------------+------------+
| f0         | f1         | cluster_index | distance   |
+------------+------------+---------------+------------+
| 1          | 2          | 0             | 0.0        |
| 1          | 3          | 1             | 0.5        |
| 1          | 4          | 2             | 0.5        |
| 0          | 3          | 1             | 0.5        |
| 0          | 4          | 2             | 0.5        |
+------------+------------+---------------+------------+
Table de statistiques de clustering (clusterCountTableName) :
+---------------+---------------+
| cluster_index | cluster_count |
+---------------+---------------+
| 0             | 1             |
| 1             | 2             |
| 2             | 2             |
+---------------+---------------+
Table des centroïdes de clustering (centerTableName) :
+---------------+------------+------------+
| cluster_index | f0         | f1         |
+---------------+------------+------------+
| 0             | 1.0        | 2.0        |
| 1             | 0.5        | 3.0        |
| 2             | 0.5        | 4.0        |
+---------------+------------+------------+
Entrée creuse
Étape 1 : Créez les données de test.
create table pai_kmeans_test_sparse_input as
select * from
(
  select 1 as id, "s1" as id_s, "0:0.1,1:0.2" as kvs0, "2:0.3,3:0.4" as kvs1
  union all
  select 2 as id, "s2" as id_s, "0:1.1,2:1.2" as kvs0, "4:1.3,5:1.4" as kvs1
  union all
  select 3 as id, "s3" as id_s, "0:2.1,3:2.2" as kvs0, "6:2.3,7:2.4" as kvs1
  union all
  select 4 as id, "s4" as id_s, "0:3.1,4:3.2" as kvs0, "8:3.3,9:3.4" as kvs1
  union all
  select 5 as id, "s5" as id_s, "0:5.1,5:5.2" as kvs0, "10:5.3,6:5.4" as kvs1
) tmp;
Lorsque plusieurs colonnes creuses sont utilisées en entrée, elles sont fusionnées. Par exemple, lorsque kvs0 et kvs1 sont toutes deux sélectionnées, la première ligne est développée comme suit :
0:0.1,1:0.2,2:0.3,3:0.4,4:0,5:0,6:0,7:0,8:0,9:0,10:0Les valeurs manquantes sont remplacées par 0. La matrice creuse résultante comporte 5 lignes et 11 colonnes (indexées de 0 à 10). Si un ID de colonne est élevé (par exemple, 123456789:0.1), les dimensions de la matrice augmentent proportionnellement, consommant ainsi beaucoup de CPU et de mémoire. Renumérotez les colonnes séquentiellement à partir de 0 ou 1 pour réduire la taille de la matrice.
Étape 2 : Soumettez la tâche de clustering.
pai -name kmeans
    -project algo_public
    -DinputTableName=pai_kmeans_test_sparse_input
    -DenableSparse=true
    -DselectedColNames=kvs0,kvs1
    -DappendColNames=id,id_s
    -DitemDelimiter=,
    -DkvDelimiter=:
    -DcenterCount=3
    -Dloop=100
    -Daccuracy=0.01
    -DdistanceType=euclidean
    -DinitCenterMethod=topk
    -Dseed=1
    -DmodelName=pai_kmeans_test_input_sparse_output_model
    -DidxTableName=pai_kmeans_test_sparse_output_idx
    -DclusterCountTableName=pai_kmeans_test_sparse_output_couter
    -DcenterTableName=pai_kmeans_test_sparse_output_center;
Étape 3 : Consultez les résultats.
Table de résultats du clustering (idxTableName) :
+------------+------------+---------------+---------------------------+
| id         | id_s       | cluster_index | distance                  |
+------------+------------+---------------+---------------------------+
| 4          | s4         | 0             | 2.90215437218629          |
| 5          | s5         | 1             | 0.0                       |
| 1          | s1         | 2             | 0.7088723439378913        |
| 2          | s2         | 2             | 1.1683321445547923        |
| 3          | s3         | 0             | 2.0548722588034516        |
+------------+------------+---------------+---------------------------+
Table de statistiques de clustering (clusterCountTableName) :
+---------------+---------------+
| cluster_index | cluster_count |
+---------------+---------------+
| 0             | 2             |
| 1             | 1             |
| 2             | 2             |
+---------------+---------------+
Table des centroïdes de clustering (centerTableName) :
+---------------+----------------------------------------+----------------------------------+
| cluster_index | kvs0                                   | kvs1                             |
+---------------+----------------------------------------+----------------------------------+
| 0             | 0:2.6,1:0,2:0,3:1.1,4:1.6,5:0         | 6:1.15,7:1.2,8:1.65,9:1.7,10:0  |
| 1             | 0:5.1,1:0,2:0,3:0,4:0,5:5.2           | 6:5.4,7:0,8:0,9:0,10:5.3        |
| 2             | 0:0.6,1:0.1,2:0.75,3:0.2,4:0.65,5:0.7 | 6:0,7:0,8:0,9:0,10:0            |
+---------------+----------------------------------------+----------------------------------+
Dépannage
Algo Job Failed-System Error-Null feature value found
La table d'entrée contient des valeurs NULL ou vides. Remplissez les valeurs manquantes à l'aide des valeurs d'imputation par défaut avant d'exécuter la tâche.
Algo Job Failed-System Error-Feature count can't be more than 2000000
L'entrée creuse possède un ID de colonne supérieur à 2 000 000. Renumérotez les colonnes séquentiellement à partir de 0 ou 1.
Algo Job Failed-System Error-kIOError:Write failed for message: comparison_measure
Le modèle de centroïde est trop volumineux pour être écrit. Renumérotez les colonnes creuses à partir de 0 ou 1 pour réduire la taille du modèle. Si la valeur de col * centerCount dépasse 270 000 000, supprimez le paramètre modelName de la commande et exécutez à nouveau la tâche.
FAILED: Failed Task createCenterTable:kOtherError:ODPS-0130161:[1,558] Parse exception - invalid token ',', expect ")"
Un nom de colonne dans la table d'entrée est un mot clé réservé SQL. Renommez la colonne pour éviter les conflits avec les mots clés SQL.
La distance cosinus produit moins de K clusters
Lors de l'utilisation de la distance cosinus, certains clusters peuvent être vides car les K centroïdes initiaux peuvent inclure des vecteurs parallèles. Les vecteurs parallèles sont traités comme le même centroïde, de sorte que certains points de données ne leur sont jamais attribués. Pour éviter cela, fournissez des centroïdes initiaux explicites à l'aide d'une table de centroïdes externe (initCenterMethod=external) afin de garantir K points de départ distincts.