Le composant de classification d'images (Torch) dans Platform for AI (PAI) vous permet d'entraîner des modèles de classification d'images à l'aide de PyTorch au sein d'un pipeline visuel sans code dans Machine Learning Designer. Ce composant prend en charge les architectures de backbone populaires et s'intègre à Object Storage Service (OSS) pour le stockage des données et des modèles.
Prérequis
Avant de commencer, assurez-vous de disposer des éléments suivants :
Un bucket OSS activé dans la même région que votre espace de travail Designer
Les autorisations nécessaires accordées à Machine Learning Designer pour accéder à OSS. Consultez Activer OSS et Accorder des autorisations
Limitations
Ce composant est disponible uniquement dans Machine Learning Designer.
Le seul moteur de calcul pris en charge est Deep Learning Container (DLC).
Fonctionnement
Le composant prend en charge deux approches d'entraînement :
Apprentissage par transfert (recommandé) : Le composant démarre avec le modèle ImageNet pré-entraîné par défaut et l'affine à l'aide de vos données étiquetées. Cette approche nécessite moins de données d'entraînement et converge plus rapidement. Pour utiliser un modèle pré-entraîné personnalisé, spécifiez son chemin OSS dans le paramètre oss path for pretrained model.
Utilisation du modèle pré-entraîné par défaut de PAI : Si vous laissez le chemin du modèle pré-entraîné vide, le composant utilise le modèle pré-entraîné par défaut fourni par PAI.
L'ensemble de l'entraînement s'exécute sur DLC. Une fois l'entraînement terminé, l'artefact du modèle est enregistré dans le répertoire OSS que vous avez spécifié et peut être transmis directement au composant Prédiction d'image générale pour l'inférence par lots.
Préparation des données
Le composant accepte les données d'entraînement et d'évaluation étiquetées selon deux formats :
| Format | Description |
|---|---|
ClsSourceImageList |
Un fichier d'annotation TXT où chaque ligne suit le format <absolute-path/image-name.jpg> <label_id>, séparé par un espace |
ClsSourceItag |
Données étiquetées avec iTAG, l'outil d'annotation de données intégré à PAI |
Exemple de fichier d'annotation (ClsSourceImageList) :
oss://examplebucket/data/images/cat001.jpg 0
oss://examplebucket/data/images/dog001.jpg 1
oss://examplebucket/data/images/bird001.jpg 2Séparez le chemin de l'image et le label_id par un seul espace. N'utilisez pas de tabulations ni d'autres délimiteurs. Le label_id est un index entier basé sur zéro correspondant à la position de la classe dans votre class list file.
Pour préparer des données étiquetées avec iTAG, consultez la présentation d'iTAG.
Configuration du composant
Localisez le composant de classification d'images (Torch) dans la bibliothèque de composants sous Video Algorithm > Offline Training. Après l'avoir ajouté à votre pipeline, configurez les onglets suivants.
Ports d'entrée
Connectez les composants en amont Lire les données OSS aux ports d'entrée pour transmettre directement les données étiquetées au pipeline.
| Port d'entrée | Type de données | Obligatoire |
|---|---|---|
| Data annotation path for training | OSS | Non |
| Data annotation path for evaluation | OSS | Non |
Si vous connectez des données via un port d'entrée et définissez également le paramètre de chemin d'annotation correspondant, la valeur du port d'entrée est prioritaire.
Onglet Fields Setting
| Paramètre | Obligatoire | Description | Valeur par défaut |
|---|---|---|---|
| model type | Oui | Le type de tâche de classification. Seule la valeur classification est prise en charge. |
Classification |
| oss dir to save model | Oui | Le répertoire OSS dans lequel le modèle entraîné est enregistré. Exemple : oss://examplebucket/yunji.cjy/designer_test |
— |
| oss annotation path for training data | Non | Chemin OSS du fichier d'annotation d'entraînement étiqueté. Requis si aucun port d'entrée d'entraînement n'est connecté. Exemple : oss://examplebucket/yunji.cjy/data/imagenet/meta/train_labeled.txt |
— |
| oss annotation path for evaluation data | Non | Chemin OSS du fichier d'annotation d'évaluation étiqueté. Requis si aucun port d'entrée d'évaluation n'est connecté. Exemple : oss://examplebucket/yunji.cjy/data/imagenet/meta/val_labeled.txt |
— |
| class list file | Oui | Spécifie les noms des catégories d'images. Accepte trois formats : une liste délimitée par des crochets (par exemple, [person, dog, cat]), un chemin OSS vers un fichier TXT contenant les noms de catégorie séparés par des virgules ou des sauts de ligne, ou laissez vide pour utiliser des étiquettes numériques de 0 à num_classes-1. |
— |
| Data Source Type | Oui | Le format d'annotation de vos données d'entrée. Valeurs valides : ClsSourceImageList, ClsSourceItag. |
ClsSourceItag |
| oss path for pretrained model | Non | Chemin OSS d'un modèle pré-entraîné personnalisé. Si ce champ est laissé vide, le modèle pré-entraîné par défaut fourni par PAI est utilisé. | — |
Onglet Parameters Setting
Les trois paramètres ayant le plus grand impact sur la qualité de l'entraînement sont backbone, initial learning rate et optimizer. Définissez-les avec soin ; les autres paramètres peuvent rester à leurs valeurs par défaut pour les exécutions initiales.
| Paramètre | Obligatoire | Description | Valeur par défaut |
|---|---|---|---|
| backbone | Oui | L'architecture de backbone pour l'extraction de caractéristiques. Valeurs valides : resnet, resnext, hrnet, vit, swint, mobilenetv2, inceptionv4. |
resnet |
| num classes | Oui | Le nombre de catégories d'images dans votre jeu de données. | — |
| image size after resizing | Oui | La dimension en pixels à laquelle les images sont redimensionnées (carré). | 224 |
| optimizer | Oui | L'algorithme d'optimisation. Valeurs valides : SGD, Adam. |
SGD |
| initial learning rate | Oui | Le taux d'apprentissage initial. | 0.05 |
| learning rate policy | Oui | La stratégie d'ajustement du taux d'apprentissage pendant l'entraînement. Seule la valeur step est prise en charge. |
step |
| lr step | Oui | Les numéros d'époque auxquels le taux d'apprentissage diminue de 90 %. Séparez plusieurs valeurs par des virgules. Exemple : 5,10 entraîne une multiplication du taux d'apprentissage par 0,1 au début de l'époque 6 et à nouveau au début de l'époque 11. |
[30,60,90] |
| train batch size | Oui | Nombre d'échantillons par itération d'entraînement. | 2 |
| eval batch size | Oui | Nombre d'échantillons par itération d'évaluation. | 2 |
| total train epochs | Oui | Nombre total de passages d'entraînement sur l'ensemble complet des données. | 1 |
| save checkpoint epoch | Non | Intervalle (en époques) auquel un point de contrôle est enregistré. Définissez sur 1 pour enregistrer un point de contrôle après chaque époque. |
1 |
| Exported model type | Oui | Format du modèle exporté. Valeurs valides : raw, ONNX. |
raw |
Choix d'un backbone :
Effectuez votre choix en fonction de la taille de votre jeu de données, de vos exigences en matière de précision et des ressources de calcul disponibles. Les backbones plus grands et plus puissants nécessitent davantage de mémoire GPU et un temps d'entraînement plus long.
| Backbone | Idéal pour |
|---|---|
| ResNet | Usage général ; base solide pour la plupart des jeux de données |
| ResNeXt | Précision supérieure à ResNet, avec un coût supplémentaire modéré |
| HRNet | Tâches nécessitant des détails spatiaux fins |
| ViT (Vision Transformer) | Grands jeux de données ; excellente précision mais gourmand en calcul |
| Swin Transformer (SwinT) | Caractéristiques hiérarchiques ; bon compromis précision-efficacité |
| MobileNetV2 | Environnements aux ressources limitées ; inférence rapide |
| InceptionV4 | Haute précision sur diverses tâches de classification |
Onglet Tuning
| Paramètre | Obligatoire | Description | Valeur par défaut |
|---|---|---|---|
| number process of reading data per gpu | Non | Nombre de threads de chargement des données par GPU. | 4 |
| use fp 16 | Non | Active l'entraînement FP16 (demi-précision) pour réduire l'utilisation de la mémoire GPU. | — |
| single worker or distributed on DLC | Oui | Mode de calcul. Utilisez single_on_dlc pour l'entraînement sur un seul nœud ou distribute_on_dlc pour l'entraînement distribué multi-nœuds. |
single_on_dlc |
| number of worker | Non | Nombre de nœuds de travail. Requis lors de l'utilisation de distribute_on_dlc. |
1 |
| cpu machine type | Non | Type d'instance CPU. Requis lors de l'utilisation de distribute_on_dlc. |
16vCPU+64GB Mem-ecs.g6.4xlarge |
| gpu machine type | Oui | Type d'instance GPU. | 8vCPU+60GB Mem+1xp100-ecs.gn5-c8g1.2xlarge |
Port de sortie
| Port de sortie | Type de données | Composant en aval |
|---|---|---|
| Output model | Chemin OSS | Prédiction d'image générale |
La sortie correspond au chemin du répertoire OSS configuré dans le paramètre oss dir to save model. Connectez ce port au composant General Image Prediction pour exécuter l'inférence par lots sur votre modèle entraîné.
Exemple : pipeline de classification d'images de bout en bout
La figure suivante illustre un exemple de pipeline qui entraîne un classificateur d'images et exécute une inférence par lots.
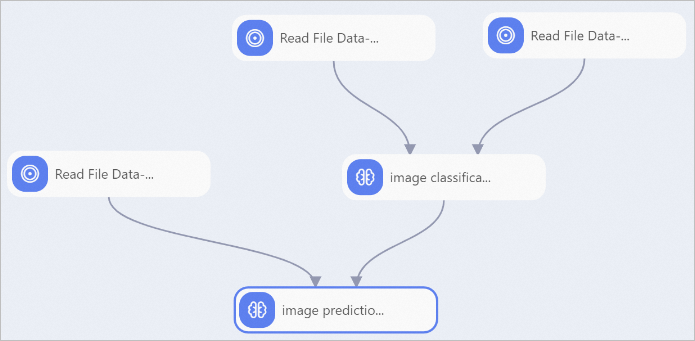
Étapes :
Préparez et étiquetez les données. Étiquetez vos images à l'aide d'iTAG. Pour plus de détails, consultez la présentation d'iTAG.
-
Lisez les données d'entraînement et d'évaluation. Ajoutez deux composants Read File Data au canevas. Définissez le paramètre OSS Data Path de chaque composant sur le chemin OSS de vos données d'entraînement étiquetées et de vos données d'évaluation, respectivement.
ImportantDéfinissez Data Source Type sur
ClsSourceItaglorsque vous utilisez des données étiquetées avec iTAG. Configurez le composant de classification d'images (Torch). Connectez les deux composants Read File Data aux ports d'entrée d'entraînement et d'évaluation du composant image classification (Torch)-1. Configurez les paramètres comme décrit dans Configurer le composant.
Lisez les données de prédiction. Ajoutez un troisième composant Read File Data et définissez son OSS Data Path sur le chemin OSS des images que vous souhaitez classifier.
-
Exécutez l'inférence par lots. Ajoutez un composant image prediction et configurez les paramètres suivants. Pour obtenir tous les détails de configuration, consultez prédiction d'image.
model type :
torch_classifieross path for model : Définissez cette valeur identique au paramètre oss dir to save model du composant image classification (Torch)-1.
Étapes suivantes
Prédiction d'image générale — Exécutez l'inférence par lots sur votre modèle entraîné
Lire les données OSS — Chargez les données dans votre pipeline Designer
Présentation d'iTAG — Étiquetez les données d'entraînement à l'aide de l'outil d'annotation de PAI