Elastic Algorithm Service (EAS) intègre un processeur EasyRec natif qui déploie les modèles de recommandation entraînés avec EasyRec ou TensorFlow en tant que services de scoring, avec une ingénierie des fonctionnalités intégrée. Ce processeur optimise conjointement l'ingénierie des fonctionnalités et l'inférence du modèle pour offrir des performances de scoring élevées.
Informations générales
Le processeur EasyRec est un service d'inférence basé sur la spécification des processeurs PAI-EAS (Développer des processeurs personnalisés en C ou C++). Il prend en charge deux scénarios :
Pour les modèles d'apprentissage profond entraînés avec la génération de fonctionnalités (FG) et EasyRec, le processeur EasyRec améliore les performances de scoring en mettant en cache les fonctionnalités des éléments en mémoire et en optimisant la transformation des fonctionnalités ainsi que l'inférence. FeatureStore gère les fonctionnalités en ligne et en temps réel. La plateforme de recommandation PAI-Rec génère du code qui simplifie l'entraînement, la transformation des fonctionnalités et l'inférence. Combiné au moteur DPI PAI-Rec, il permet un déploiement rapide des modèles et une intégration fluide des services.
Le processeur EasyRec peut également servir des modèles entraînés avec EasyRec ou TensorFlow sans le générateur de fonctionnalités (mode bypass).
Architecture d'un moteur de recommandation basé sur le processeur EasyRec :

Remarque : Le processeur prend également en charge les données hors ligne provenant de MaxCompute.
Le processeur EasyRec comprend les modules suivants :
Cache des fonctionnalités des éléments : Met en cache les fonctionnalités FeatureStore en mémoire pour réduire la surcharge réseau. Prend en charge les mises à jour incrémentielles et en temps réel des fonctionnalités.
Générateur de fonctionnalités : Module d'ingénierie des fonctionnalités (Présentation et configuration de la génération de fonctionnalités) qui utilise la même implémentation pour le traitement hors ligne et en ligne, garantissant ainsi la cohérence. Cette implémentation s'appuie sur des solutions éprouvées de Taobao. La rubrique Concepts des champs de données, des fonctionnalités de données et des fonctionnalités FG dans EasyRec couvre la terminologie FG. Vous pouvez étendre FG avec des opérateurs de fonctionnalités personnalisés.
TFModel : Charge les fichiers SavedModel exportés depuis EasyRec et utilise Blade pour optimiser l'inférence du modèle sur les CPU et les GPU.
Modules Instrumentation des fonctionnalités et Mise à jour incrémentielle du modèle : Ces modules prennent en charge les scénarios d'entraînement en temps réel. Consultez la documentation sur l'entraînement en temps réel.
Limites
L'inférence CPU est prise en charge uniquement sur les familles d'instances généralistes g6, g7 et g8 (CPU Intel uniquement).
L'inférence GPU est prise en charge sur les GPU T4, A10, GU30, L20, 3090 et 4090, mais pas sur le P100.
Versions
Utilisez la dernière version pour bénéficier des meilleures fonctionnalités et des meilleures performances.
Étape 1 : Déployer le service
Pour déployer un service de modèle EasyRec avec eascmd, définissez le Type de processeur sur easyrec-{version}. La rubrique Déploiement de service : EASCMD décrit le processus complet de déploiement. Les sections suivantes fournissent des exemples de fichiers de configuration.
Nouvelle bibliothèque FeatureGenerator (fg_mode=normal)
Cet exemple utilise le type de nœud PyOdps3 avec la nouvelle bibliothèque FeatureGenerator. Cette bibliothèque prend en charge les opérateurs de transformation intégrés et personnalisés, les types d'entrée complexes (tableaux, maps) et les dépendances de fonctionnalités basées sur un DAG.
L'exemple suivant utilise PAI-FeatureStore pour la gestion des données de fonctionnalités. Remplacez ${fs_project},${fs_model} par les valeurs réelles. La procédure complète est décrite dans l'étape Étape 2 : Créer et déployer un service de modèle EAS.
import json
import os

service_name = 'ali_rec_rnk_with_fg'

config = {
  'name': service_name,
  'metadata': {
    "cpu": 8,
    #"cuda": "11.2",
    "gateway": "default",
    "gpu": 0,
    "memory": 32000,
    "rolling_strategy": {
        "max_unavailable": 1
    },
    "rpc": {
        "enable_jemalloc": 1,
        "max_queue_size": 256
    }
  },
  "processor_envs": [
    {
      "name": "ADAPTE_FG_CONFIG",
      "value": "true"
    }
  ],
  "model_path": "",
  "processor": "easyrec-3.5",
  "storage": [
    {
      "mount_path": "/home/admin/docker_ml/workspace/model/",
      "oss": {
        "path": "oss://easyrec/ali_rec_sln_acc_rnk/20250722/export/final_with_fg"
      }
    }
  ],
  # When you change fg_mode, the invocation method must also be changed.
  # If fg_mode is 'normal' or 'tf', use the EasyRecRequest SDK.
  # If fg_mode is 'bypass', use the TFRequest SDK.
  'model_config': {
    'outputs': 'probs_ctr,probs_cvr',
    'fg_mode': 'normal',
    'steady_mode': True,
    'period': 2880,
    'access_key_id': f'{o.account.access_id}',
    'access_key_secret': f'{o.account.secret_access_key}',
    "load_feature_from_offlinestore": True,
    'region': 'cn-shanghai',
    'fs_project': '${fs_project}',
    'fs_model': '${fs_model}',
    'fs_entity': 'item',
    'featuredb_username': 'guest',
    'featuredb_password': '123456',
    'log_iterate_time_threshold': 100,
    'iterate_featuredb_interval': 5,
    'mc_thread_pool_num': 1,
  }
}

with open('echo.json', 'w') as output_file:
    json.dump(config, output_file)

os.system(f'/home/admin/usertools/tools/eascmd -i {o.account.access_id} -k {o.account.secret_access_key} -e pai-eas.cn-shanghai.aliyuncs.com create echo.json')
# os.system(f'/home/admin/usertools/tools/eascmd -i {o.account.access_id} -k {o.account.secret_access_key} -e pai-eas.cn-shanghai.aliyuncs.com modify {service_name} -s echo.json')
Remplacez les valeurs de featuredb_username et featuredb_password par des identifiants valides.
Version opérateur TF de FeatureGenerator (fg_mode=tf)
Important : La version opérateur TF de FeatureGenerator ne prend en charge qu'un ensemble limité de fonctionnalités intégrées : id_feature, raw_feature, combo_feature, lookup_feature, match_feature, and sequence_feature. Les opérateurs FeatureGenerator personnalisés ne sont pas pris en charge.
Le script de déploiement suivant inclut la paire AccessKey en clair. Il n'utilise pas PAI-FeatureStore ni ne charge de données depuis MaxCompute afin de réduire la charge sur Hologres.
Utilisez PAI-FeatureStore avec MaxCompute pour les déploiements en production. L'étape Étape 2 : Créer et déployer un service de modèle EAS illustre une méthode plus sécurisée utilisant un script Python, l'objet o de DataWorks et des jetons STS temporaires, avec load_feature_from_offlinestore défini sur True.
bizdate=$1
# Change the invocation method based on fg_mode: EasyRecRequest for 'normal'/'tf', TFRequest for 'bypass'
cat << EOF > echo.json
{
  "name":"ali_rec_rnk_with_fg",
  "metadata": {
    "instance": 2,
    "rpc": {
      "enable_jemalloc": 1,
      "max_queue_size": 100
    }
  },
  "cloud": {
    "computing": {
      "instance_type": "ecs.g7.large",
      "instances": null
    }
  },
  "model_config": {
    "remote_type": "hologres",
    "url": "postgresql://<AccessKeyID>:<AccessKeySecret>@<endpoint>:<port>/<database>",
    "tables": [{"name":"<schema>.<table_name>","key":"<index_column_name>","value": "<column_name>"}],
    "period": 2880,
    "fg_mode": "tf",
    "outputs":"probs_ctr,probs_cvr",
  },
  "model_path": "",
  "processor": "easyrec-3.5",
  "storage": [
    {
      "mount_path": "/home/admin/docker_ml/workspace/model/",
      "oss": {
        "path": "oss://easyrec/ali_rec_sln_acc_rnk/20221122/export/final_with_fg"
      }
    }
  ]
}

EOF
# Run the deployment command.
eascmd  create echo.json
# eascmd -i <AccessKeyID>  -k  <AccessKeySecret>   -e <endpoint> create echo.json
# Run the update command.
eascmd update ali_rec_rnk_with_fg -s echo.json
Contourner FeatureGenerator (fg_mode=bypass)
Sans FeatureGenerator, assemblez la requête côté client. Consultez la rubrique Utiliser EAS pour l'inférence sans entraînement avec EasyRec.
bizdate=$1
# Change the invocation method based on fg_mode: EasyRecRequest for 'normal'/'tf', TFRequest for 'bypass'
cat << EOF > echo.json
{
  "name":"ali_rec_rnk_no_fg",
  "metadata": {
    "instance": 2,
    "rpc": {
      "enable_jemalloc": 1,
      "max_queue_size": 100
    }
  },
  "cloud": {
    "computing": {
      "instance_type": "ecs.g7.large",
      "instances": null
    }
  },
  "model_config": {
    "fg_mode": "bypass"
  },
  "processor": "easyrec-3.5",
  "processor_envs": [
    {
      "name": "INPUT_TILE",
      "value": "2"
    }
  ],
  "storage": [
    {
      "mount_path": "/home/admin/docker_ml/workspace/model/",
      "oss": {
        "path": "oss://easyrec/ali_rec_sln_acc_rnk/20221122/export/final/"
      }
    }
  ],
  "warm_up_data_path": "oss://easyrec/ali_rec_sln_acc_rnk/rnk_warm_up.bin"
}

EOF
# Run the deployment command.
eascmd  create echo.json
# eascmd -i <AccessKeyID>  -k  <AccessKeySecret>   -e <endpoint> create echo.json
# Run the update command.
eascmd update ali_rec_rnk_no_fg -s echo.json
Le tableau suivant décrit les paramètres clés. La rubrique Déploiement JSON couvre d'autres paramètres.
|
Paramètre |
Obligatoire |
Description |
Exemple |
|
processor |
Oui |
Nom du processeur EasyRec. |
|
|
fg_mode |
Oui |
Mode d'ingénierie des fonctionnalités. Le mode sélectionné détermine le SDK et le format de requête pour l'appel du service.
|
|
|
outputs |
Oui |
Noms des variables de sortie du modèle TensorFlow, tels que probs_ctr. Séparez plusieurs noms par des virgules (,). Pour trouver les noms des variables de sortie, exécutez la commande TensorFlow saved_model_cli. |
"outputs":"probs_ctr,probs_cvr" |
|
save_req |
Non |
Indique si les données de requête doivent être enregistrées dans le répertoire du modèle pour l'échauffement et les tests de performance. Valeurs possibles :
|
"save_req": "false" |
|
Paramètres du cache des fonctionnalités d'élément |
|||
|
period |
Oui |
Intervalle de mise à jour du cache des fonctionnalités d'élément, en minutes. Pour les fonctionnalités mises à jour quotidiennement, définissez une valeur supérieure à 1 440 (minutes par jour), par exemple 2 880 (deux jours). Cela évite les mises à jour redondantes, car les fonctionnalités sont également actualisées lors des déploiements réguliers. |
|
|
remote_type |
Oui |
Source de données pour les fonctionnalités d'élément. Valeurs possibles :
|
|
|
tables |
Non |
Table des fonctionnalités d'élément. Ce paramètre est requis lorsque remote_type est défini sur hologres. Il comprend les sous-paramètres suivants :
Vous pouvez lire les données d'élément d'entrée à partir de plusieurs tables. La configuration doit respecter le format suivant :
Si des tables partagent des noms de colonnes, les colonnes de la table apparaissant plus tard dans la liste écrasent celles de la table apparaissant plus tôt. |
|
|
url |
Non |
Endpoint Hologres. |
|
|
Paramètres d'accès du processeur à PAI-FeatureStore |
|||
|
fs_project |
Non |
Nom du projet PAI-FeatureStore. Requis lors de l'utilisation de PAI-FeatureStore. Consultez la rubrique Configurer un projet FeatureStore. |
"fs_project": "fs_demo" |
|
fs_model |
Non |
Nom de la fonctionnalité du modèle dans PAI-FeatureStore. |
"fs_model": "fs_rank_v1" |
|
fs_entity |
Non |
Nom de l'entité dans PAI-FeatureStore. |
"fs_entity": "item" |
|
region |
Non |
Région où réside le projet PAI-FeatureStore. |
"region": "cn-beijing" |
|
access_key_id |
Non |
AccessKey ID utilisé pour accéder à PAI-FeatureStore. |
"access_key_id": "xxxxx" |
|
access_key_secret |
Non |
AccessKey Secret utilisé pour accéder à PAI-FeatureStore. |
"access_key_secret": "xxxxx" |
|
featuredb_username |
Non |
Nom d'utilisateur pour FeatureDB. |
"featuredb_username": "xxxxx" |
|
featuredb_password |
Non |
Mot de passe pour FeatureDB. |
"featuredb_password": "xxxxx" |
|
load_feature_from_offlinestore |
Non |
Indique si les fonctionnalités hors ligne doivent être chargées directement depuis PAI-FeatureStore OfflineStore. Valeurs possibles :
|
"load_feature_from_offlinestore": True |
|
iterate_featuredb_interval |
Non |
Intervalle, en secondes, de mise à jour des fonctionnalités statistiques en temps réel. Un intervalle plus court améliore l'actualité des fonctionnalités, mais augmente les coûts de lecture lorsque les fonctionnalités changent fréquemment. Équilibrez précision et coût. |
"iterate_featuredb_interval": 5 |
|
input_tile : Paramètres de diffusion automatique des fonctionnalités |
|||
|
INPUT_TILE |
Non |
Définissez la variable d'environnement INPUT_TILE sur 1 pour activer la diffusion automatique des fonctionnalités d'élément. Cela vous permet de transmettre une seule valeur pour les fonctionnalités qui restent constantes au sein d'une requête, telles que user_id. Lorsque la variable d'environnement INPUT_TILE est définie sur 2, l'opération
Remarque
|
"processor_envs": [ { "name": "INPUT_TILE", "value": "2" } ] |
|
ADAPTE_FG_CONFIG |
Non |
Active la compatibilité avec les modèles entraînés avec une version antérieure de FeatureGenerator. |
"processor_envs": [ { "name": "ADAPTE_FG_CONFIG", "value": "true" } ] |
|
DISABLE_FG_PRECISION |
Non |
Pour la compatibilité avec les modèles entraînés avec une version antérieure de FeatureGenerator. L'ancienne version limite par défaut les fonctionnalités de type float à six chiffres significatifs, tandis que la nouvelle version supprime cette limite. Pour appliquer l'ancien comportement (limite de 6 chiffres), définissez cette variable sur |
"processor_envs": [ { "name": "DISABLE_FG_PRECISION", "value": "false" } ] |
Optimisation de l'inférence du processeur EasyRec
|
Paramètre |
Obligatoire |
Description |
Exemple |
|
TF_XLA_FLAGS |
Non |
Pour l'inférence sur GPU, ce paramètre permet à XLA de compiler et d'optimiser le modèle, tout en effectuant automatiquement la fusion des opérateurs. |
"processor_envs": [ { "name": "TF_XLA_FLAGS", "value": "--tf_xla_auto_jit=2" }, { "name": "XLA_FLAGS", "value": "--xla_gpu_cuda_data_dir=/usr/local/cuda/" }, { "name": "XLA_ALIGN_SIZE", "value": "64" } ] |
|
Paramètres de planification TF |
Non |
inter_op_parallelism_threads : contrôle le nombre de threads utilisés pour exécuter différentes opérations en parallèle. intra_op_parallelism_threads : contrôle le nombre de threads utilisés au sein d'une seule opération. Pour un CPU de 32 cœurs, définir ces paramètres à 16 améliore généralement les performances. Notez que la somme des deux comptes de threads ne peut pas dépasser le nombre total de cœurs CPU. |
"model_config": { "inter_op_parallelism_threads": 16, "intra_op_parallelism_threads": 16, } |
|
rpc.worker_threads |
Non |
Un paramètre situé sous |
"metadata": { "rpc": { "worker_threads": 15 } |
Étape 2 : Appeler le service
2,1 Configuration réseau
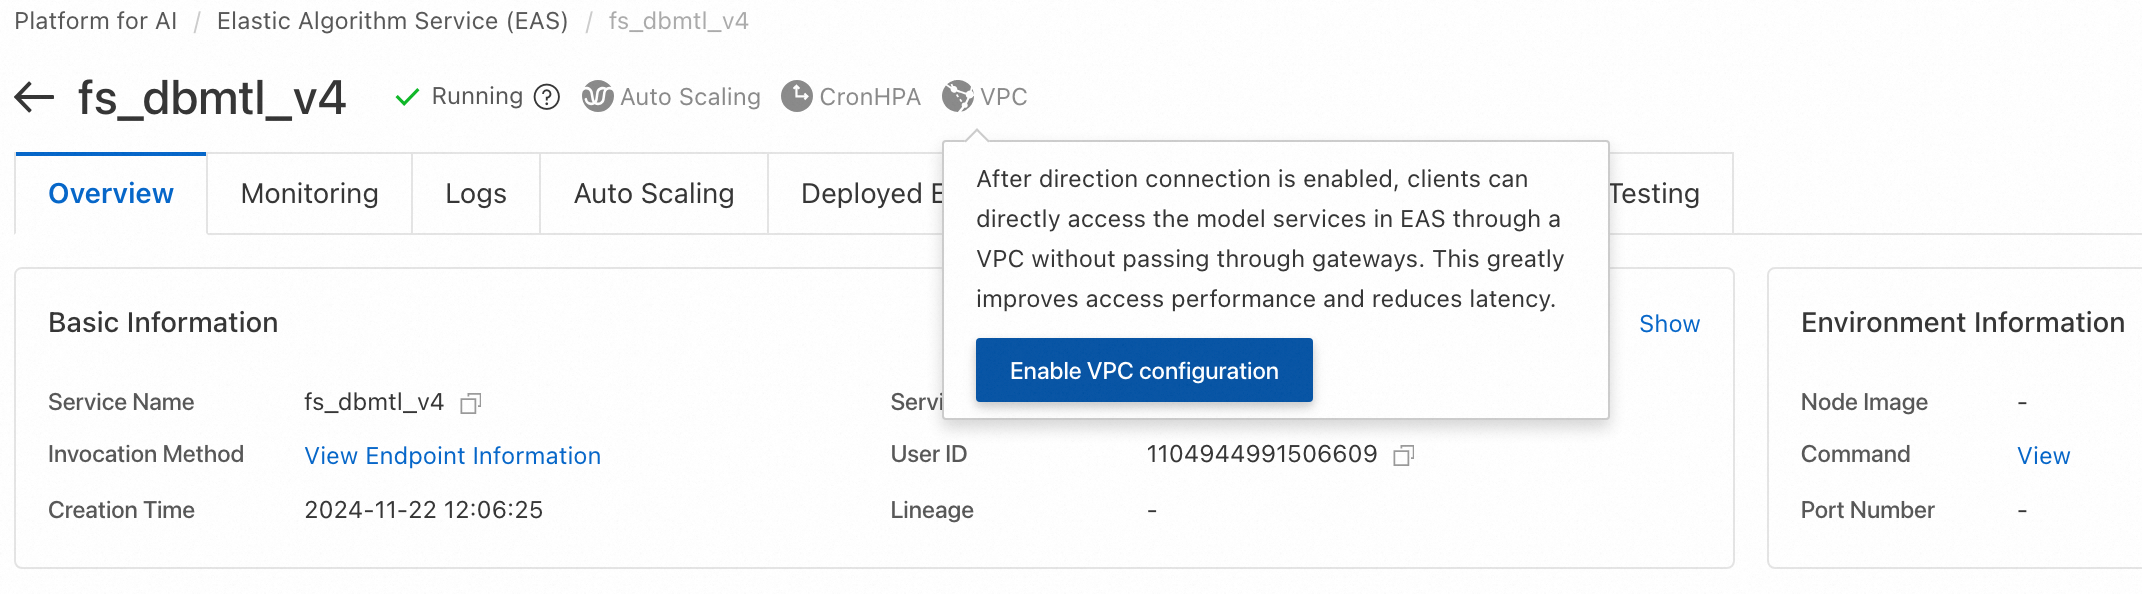
Le moteur PAI-Rec et le service de scoring s'exécutent tous deux sur PAI-EAS et nécessitent une connexion réseau directe. Sur la page des instances PAI-EAS, cliquez sur « VPC » pour configurer le même VPC, vSwitch et groupe de sécurité. Accéder aux ressources publiques ou locales depuis EAS. Si vous utilisez Hologres, configurez également le même VPC. La figure suivante illustre un exemple.
2,2 Obtenir les informations du service
Après le déploiement, accédez à la page Elastic Algorithm Service (EAS). Localisez votre service et cliquez sur Invocation Information dans la colonne Service Method pour afficher l'endpoint et le jeton.
2,3 Exemples de code SDK
Le service de modèle EasyRec utilise Protocol Buffers (Protobuf) pour les entrées et les sorties ; il n'est donc pas possible de le tester depuis la console PAI-EAS.
Avant d'appeler le service, vérifiez le fg_mode dans model_config indiqué à l'étape 1. Chaque mode requiert un SDK client différent.
|
Mode (fg_mode) |
Classe de requête |
|
normal ou tf (avec ingénierie des fonctionnalités intégrée) |
EasyRecRequest |
|
bypass (sans ingénierie des fonctionnalités intégrée) |
TFRequest |
Avec FG fg_mode=normal ou tf
Java
La configuration Maven est décrite dans le Guide du SDK Java. Le code suivant envoie une requête au service ali_rec_rnk_with_fg :
import com.aliyun.openservices.eas.predict.http.*;
import com.aliyun.openservices.eas.predict.request.EasyRecRequest;

PredictClient client = new PredictClient(new HttpConfig());
// When you access the service through a public gateway, use the endpoint that starts with your user ID (UID). You can obtain this endpoint from the invocation information of the service in the EAS console.
client.setEndpoint("xxxxxxx.vpc.cn-hangzhou.pai-eas.aliyuncs.com");
client.setModelName("ali_rec_rnk_with_fg");
// Replace this with your service token.
client.setToken("******");

EasyRecRequest easyrecRequest = new EasyRecRequest(separator);
// userFeatures: User features. Features are separated by \u0002 (CTRL_B). Feature names and values are separated by a colon (:).
//  user_fea0:user_fea0_val\u0002user_fea1:user_fea1_val
// For more information about the feature value format, see: https://easyrec.readthedocs.io/en/latest/feature/rtp_fg.html
easyrecRequest.appendUserFeatureString(userFeatures);
// You can also add one user feature at a time:
// easyrecRequest.addUserFeature(String userFeaName, T userFeaValue).
// The data type T of the feature value can be String, float, long, or int.

// contextFeatures: Context features. Features are separated by \u0002 (CTRL_B). Feature names and their values are separated by a colon (:). Multiple values for the same feature are also separated by colons.
//   ctxt_fea0:ctxt_fea0_ival0:ctxt_fea0_ival1:ctxt_fea0_ival2\u0002ctxt_fea1:ctxt_fea1_ival0:ctxt_fea1_ival1:ctxt_fea1_ival2
easyrecRequest.appendContextFeatureString(contextFeatures);
// You can also add one context feature at a time:
// easyrecRequest.addContextFeature(String ctxtFeaName, List<Object> ctxtFeaValue).
// The data type of ctxtFeaValue can be String, Float, Long, or Integer.

// itemIdStr: A list of item IDs to predict, separated by a comma (,).
easyrecRequest.appendItemStr(itemIdStr, ",");
// You can also add one item ID at a time:
// easyrecRequest.appendItemId(String itemId)

easyrecPredictProtos.PBResponse response = client.predict(easyrecRequest);

for (Map.Entry<String, easyrecPredictProtos.Results> entry : response.getResultsMap().entrySet()) {
    String key = entry.getKey();
    easyrecPredictProtos.Results value = entry.getValue();
    System.out.print("key: " + key);
    for (int i = 0; i < value.getScoresCount(); i++) {
        System.out.format("value: %.6g\n", value.getScores(i));
    }
}

// Get the features after FG processing to check for consistency with offline features.
// Set DebugLevel to 1 to return the generated features.
easyrecRequest.setDebugLevel(1);
easyrecPredictProtos.PBResponse response = client.predict(easyrecRequest);
Map<String, String> genFeas = response.getGenerateFeaturesMap();
for(String itemId: genFeas.keySet()) {
    System.out.println(itemId);
    System.out.println(genFeas.get(itemId));
}
Python
La configuration de l'environnement est décrite dans le Guide du SDK Python. Utilisez le client Java en production pour de meilleures performances. Exemple :
from eas_prediction import PredictClient

from eas_prediction.easyrec_request import EasyRecRequest
from eas_prediction.easyrec_predict_pb2 import PBFeature
from eas_prediction.easyrec_predict_pb2 import PBRequest

if __name__ == '__main__':
    endpoint = 'http://xxxxxxx.vpc.cn-hangzhou.pai-eas.aliyuncs.com'
    service_name = 'ali_rec_rnk_with_fg'
    token = '******'

    client = PredictClient(endpoint, service_name)
    client.set_token(token)
    client.init()

    req = PBRequest()
    uid = PBFeature()
    uid.string_feature = 'u0001'
    req.user_features['user_id'] = uid
    age = PBFeature()
    age.int_feature = 12
    req.user_features['age'] = age
    weight = PBFeature()
    weight.float_feature = 129.8
    req.user_features['weight'] = weight

    req.item_ids.extend(['item_0001', 'item_0002', 'item_0003'])

    easyrec_req = EasyRecRequest()
    easyrec_req.add_feed(req, debug_level=0)
    res = client.predict(easyrec_req)
    print(res)
Paramètres :
endpoint : l'endpoint du service. Pour l'obtenir, accédez à la page Elastic Algorithm Service (EAS), localisez votre service et cliquez sur Invocation Information dans la colonne Service Method.
service_name : le nom du service. Obtenez-le depuis la page Elastic Algorithm Service (EAS).
token : le jeton du service. Retrouvez-le dans la boîte de dialogue Invocation Information.
Sans FG fg_mode=bypass
Java
La configuration Maven est décrite dans le Guide du SDK Java. Le code suivant envoie une requête au service ali_rec_rnk_no_fg :
import java.util.List;

import com.aliyun.openservices.eas.predict.http.PredictClient;
import com.aliyun.openservices.eas.predict.http.HttpConfig;
import com.aliyun.openservices.eas.predict.request.TFDataType;
import com.aliyun.openservices.eas.predict.request.TFRequest;
import com.aliyun.openservices.eas.predict.response.TFResponse;

public class TestEasyRec {
    public static TFRequest buildPredictRequest() {
        TFRequest request = new TFRequest();

        request.addFeed("user_id", TFDataType.DT_STRING,
                        new long[]{3}, new String []{ "u0001", "u0001", "u0001"});
      	request.addFeed("age", TFDataType.DT_FLOAT,
                        new long[]{3}, new float []{ 18.0f, 18.0f, 18.0f});
        // Note: If you set INPUT_TILE=2, for features that have the same value, you only need to pass the value once:
        //    request.addFeed("user_id", TFDataType.DT_STRING,
        //            new long[]{1}, new String []{ "u0001" });
        //    request.addFeed("age", TFDataType.DT_FLOAT,
        //            new long[]{1}, new float []{ 18.0f});
      	request.addFeed("item_id", TFDataType.DT_STRING,
                        new long[]{3}, new String []{ "i0001", "i0002", "i0003"});
        request.addFetch("probs");
      	return request;
    }

    public static void main(String[] args) throws Exception {
        PredictClient client = new PredictClient(new HttpConfig());

        // To use a direct network connection, use the setDirectEndpoint method. Example:
        //   client.setDirectEndpoint("pai-eas-vpc.cn-shanghai.aliyuncs.com");
        // You must enable the direct network connection in the EAS console and provide the source vSwitch used to access the EAS service.
        // A direct network connection offers better stability and performance.
        client.setEndpoint("xxxxxxx.vpc.cn-hangzhou.pai-eas.aliyuncs.com");
        client.setModelName("ali_rec_rnk_no_fg");
        client.setToken("");
        long startTime = System.currentTimeMillis();
        for (int i = 0; i < 100; i++) {
            try {
                TFResponse response = client.predict(buildPredictRequest());
                // "probs" is an output field of the model. You can use the curl command to view the model's inputs and outputs:
                //   curl xxxxxxx.vpc.cn-hangzhou.pai-eas.aliyuncs.com -H "Authorization:{token}"
                List<Float> result = response.getFloatVals("probs");
                System.out.print("Predict Result: [");
                for (int j = 0; j < result.size(); j++) {
                    System.out.print(result.get(j).floatValue());
                    if (j != result.size() - 1) {
                        System.out.print(", ");
                    }
                }
                System.out.print("]\n");
            } catch (Exception e) {
                e.printStackTrace();
            }
        }
        long endTime = System.currentTimeMillis();
        System.out.println("Spend Time: " + (endTime - startTime) + "ms");
        client.shutdown();
    }
}
Python
La configuration de l'environnement est décrite dans le Guide du SDK Python. Le SDK Python est recommandé uniquement pour le débogage ; utilisez le SDK Java en production. Le code suivant envoie une requête au service ali_rec_rnk_no_fg :
#!/usr/bin/env python

from eas_prediction import PredictClient
from eas_prediction import StringRequest
from eas_prediction import TFRequest

if __name__ == '__main__':
    client = PredictClient('http://xxxxxxx.vpc.cn-hangzhou.pai-eas.aliyuncs.com', 'ali_rec_rnk_no_fg')
    client.set_token('')
    client.init()

    # Note: Replace server_default with the actual signature_name of your model. For more information, see the SDK guide mentioned above.
    req = TFRequest('server_default')
    req.add_feed('user_id', [3], TFRequest.DT_STRING, ['u0001'] * 3)
    req.add_feed('age', [3], TFRequest.DT_FLOAT, [18.0] * 3)
    # Note: After enabling the INPUT_TILE=2 optimization, you can pass a single value for the preceding features.
    #   req.add_feed('user_id', [1], TFRequest.DT_STRING, ['u0001'])
    #   req.add_feed('age', [1], TFRequest.DT_FLOAT, [18.0])
    req.add_feed('item_id', [3], TFRequest.DT_STRING,
        ['i0001', 'i0002', 'i0003'])
    for x in range(0, 100):
        resp = client.predict(req)
        print(resp)
2,4 Construire une requête de service personnalisée
Pour les langages autres que Python et Java, générez le code de requête de prédiction à partir des fichiers .proto suivants :
-
tf_predict.proto : définition de requête pour un modèle TensorFlow.
syntax = "proto3"; option cc_enable_arenas = true; option go_package = ".;tf"; option java_package = "com.aliyun.openservices.eas.predict.proto"; option java_outer_classname = "PredictProtos"; enum ArrayDataType { // Not a legal value for DataType. Used to indicate a DataType field // has not been set. DT_INVALID = 0; // Data types that all computation devices are expected to be // capable to support. DT_FLOAT = 1; DT_DOUBLE = 2; DT_INT32 = 3; DT_UINT8 = 4; DT_INT16 = 5; DT_INT8 = 6; DT_STRING = 7; DT_COMPLEX64 = 8; // Single-precision complex DT_INT64 = 9; DT_BOOL = 10; DT_QINT8 = 11; // Quantized int8 DT_QUINT8 = 12; // Quantized uint8 DT_QINT32 = 13; // Quantized int32 DT_BFLOAT16 = 14; // Float32 truncated to 16 bits. Only for cast ops. DT_QINT16 = 15; // Quantized int16 DT_QUINT16 = 16; // Quantized uint16 DT_UINT16 = 17; DT_COMPLEX128 = 18; // Double-precision complex DT_HALF = 19; DT_RESOURCE = 20; DT_VARIANT = 21; // Arbitrary C++ data types } // Dimensions of an array message ArrayShape { repeated int64 dim = 1 [packed = true]; } // Protocol buffer representing an array message ArrayProto { // Data Type. ArrayDataType dtype = 1; // Shape of the array. ArrayShape array_shape = 2; // DT_FLOAT. repeated float float_val = 3 [packed = true]; // DT_DOUBLE. repeated double double_val = 4 [packed = true]; // DT_INT32, DT_INT16, DT_INT8, DT_UINT8. repeated int32 int_val = 5 [packed = true]; // DT_STRING. repeated bytes string_val = 6; // DT_INT64. repeated int64 int64_val = 7 [packed = true]; // DT_BOOL. repeated bool bool_val = 8 [packed = true]; } // PredictRequest specifies which TensorFlow model to run, as well as // how inputs are mapped to tensors and how outputs are filtered before // returning to user. message PredictRequest { // A named signature to evaluate. If unspecified, the default signature // will be used string signature_name = 1; // Input tensors. // Names of input tensor are alias names. The mapping from aliases to real // input tensor names is expected to be stored as named generic signature // under the key "inputs" in the model export. // Each alias listed in a generic signature named "inputs" should be provided // exactly once in order to run the prediction. map<string, ArrayProto> inputs = 2; // Output filter. // Names specified are alias names. The mapping from aliases to real output // tensor names is expected to be stored as named generic signature under // the key "outputs" in the model export. // Only tensors specified here will be run/fetched and returned, with the // exception that when none is specified, all tensors specified in the // named signature will be run/fetched and returned. repeated string output_filter = 3; // Debug flags // 0: just return prediction results, no debug information // 100: return prediction results, and save request to model_dir // 101: save timeline to model_dir int32 debug_level = 100; } // Response for PredictRequest on successful run. message PredictResponse { // Output tensors. map<string, ArrayProto> outputs = 1; } -
easyrec_predict.proto : définition de requête pour un modèle TensorFlow avec FG.
syntax = "proto3";

option cc_enable_arenas = true;
option go_package = ".;easyrec";
option java_package = "com.aliyun.openservices.eas.predict.proto";
option java_outer_classname = "EasyRecPredictProtos";

import "tf_predict.proto";

// context features
message ContextFeatures {
  repeated PBFeature features = 1;
}

message PBFeature {
  oneof value {
    int32 int_feature = 1;
    int64 long_feature = 2;
    string string_feature = 3;
    float float_feature = 4;
  }
}

// PBRequest specifies the request for aggregator
message PBRequest {
  // Debug flags
  // 0: just return prediction results, no debug information
  // 3: return features generated by FG module, string format, feature values are separated by \u0002,
  //    could be used for checking feature consistency and generating online deep learning samples
  // 100: return prediction results, and save request to model_dir
  // 101: save timeline to model_dir
  // 102: for recall models such as DSSM and MIND, not only return Faiss retrieved results
  //      but also return user embedding vectors.
  int32 debug_level = 1;

  // user features
  map<string, PBFeature> user_features = 2;

  // item ids, static(daily updated) item features
  // are fetched from the feature cache residing in
  // each processor node by item_ids
  repeated string item_ids = 3;

  // context features for each item, realtime item features
  //    could be passed as context features.
  map<string, ContextFeatures> context_features = 4;

  // embedding retrieval neighbor number.
  int32 faiss_neigh_num = 5;
}

// return results
message Results {
  repeated double scores = 1 [packed = true];
}

enum StatusCode {
  OK = 0;
  INPUT_EMPTY = 1;
  EXCEPTION = 2;
}

// PBResponse specifies the response for aggregator
message PBResponse {
  // results
  map<string, Results> results = 1;

  // item features
  map<string, string> item_features = 2;

  // fg generate features
  map<string, string> generate_features = 3;

  // context features
  map<string, ContextFeatures> context_features = 4;

  string error_msg = 5;

  StatusCode status_code = 6;

  // item ids
  repeated string item_ids = 7;

  repeated string outputs = 8;

  // all fg input features
  map<string, string> raw_features = 9;

  // output tensors
  map<string, ArrayProto> tf_outputs = 10;
}