En apprentissage automatique, l'algorithme de pivotement des données est une méthode de visualisation et d'analyse exploratoire des ensembles de données. Il utilise des graphiques, des tableaux et d'autres outils de visualisation pour révéler la structure, la distribution et les relations des données, aidant ainsi les utilisateurs à comprendre les caractéristiques, identifier les modèles et détecter les anomalies. Cet algorithme est crucial lors des étapes de prétraitement des données et d'ingénierie des caractéristiques, car il guide la modélisation et l'analyse ultérieures.
Configuration du composant
Méthode 1 : Utiliser la console
Dans Machine Learning Designer, ajoutez le composant Data Pivoting à un pipeline et configurez ses paramètres dans le volet de droite.
|
Type de paramètre |
Paramètre |
Description |
|
Configuration des champs |
Colonnes de caractéristiques |
Spécifie les colonnes de caractéristiques à utiliser pour la visualisation et l'analyse. Le composant affiche ensuite leurs distributions et relations dans des graphiques ou des tableaux. |
|
Colonne cible |
Spécifie la variable cible (généralement une étiquette ou une variable de réponse) pour la prédiction ou l'analyse. |
|
|
Caractéristiques d'énumération |
Traite les caractéristiques sélectionnées comme des caractéristiques d'énumération. |
|
|
Format de données clairsemées k:v,k:v |
Indique s'il faut utiliser des données clairsemées au format clé-valeur. |
|
|
Paramètres |
Nombre de bacs pour les caractéristiques continues |
Spécifie le nombre d'intervalles discrets (bacs) permettant de diviser les caractéristiques continues afin de les visualiser et de les analyser. |
|
Réglage |
Nombre de cœurs |
Nombre de cœurs pour le calcul. La valeur doit être un entier positif. |
|
Mémoire par cœur |
Quantité de mémoire allouée à chaque cœur, en Mo. La valeur doit être un entier compris entre 1 et 65536. |
Méthode 2 : Utiliser les commandes PAI
Configurez les paramètres du composant Data Pivoting en exécutant une commande PAI dans un composant SQL Script. Pour plus d'informations, consultez la rubrique Scénario 4 : Exécuter des commandes PAI dans le composant SQL Script.
PAI
-name fe_meta_runner
-project algo_public
-DinputTable="pai_dense_10_10"
-DoutputTable="pai_temp_2263_20384_1"
-DmapTable="pai_temp_2263_20384_2"
-DselectedCols="pdays,previous,emp_var_rate,cons_price_idx,cons_conf_idx,euribor3m,nr_employed,age,campaign,poutcome"
-DlabelCol="y"
-DcategoryCols="previous"
-Dlifecycle="28"-DmaxBins="5" ;|
Paramètre |
Obligatoire |
Valeur par défaut |
Description |
|
inputTable |
Oui |
Aucune |
Nom de la table d'entrée. |
|
inputTablePartitions |
Non |
Aucune |
Partitions de la table d'entrée à utiliser pour l'entraînement. Les formats suivants sont pris en charge :
Remarque
Pour spécifier plusieurs valeurs pour une seule clé de partition, séparez les valeurs par une virgule (,), par exemple nom1=valeur1,valeur2. |
|
outputTable |
Oui |
Aucune |
Nom de la table de sortie. |
|
mapTable |
Oui |
Aucune |
Table de mappage de sortie. Pour préparer les données à l'entraînement en apprentissage automatique, Data Pivoting collecte des statistiques pour les caractéristiques STRING et les mappe à des ID entiers (encodage d'étiquettes). |
|
selectedCols |
Oui |
Aucune |
Noms des colonnes à sélectionner dans la table d'entrée. |
|
labelCol |
Non |
Aucune |
Colonne d'étiquette. |
|
categoryCols |
Non |
Aucune |
Spécifie les colonnes numériques (INT ou DOUBLE) à traiter comme des caractéristiques d'énumération. |
|
maxBins |
Non |
100 |
Spécifie le nombre maximal d'intervalles pour la discrétisation équidistante des caractéristiques continues. |
|
isSparse |
Non |
false |
Indique si les données d'entrée sont au format clairsemé. Les valeurs valides sont true et false. |
|
itemSpliter |
Non |
Une virgule (,) |
Spécifie le délimiteur séparant les paires clé-valeur si les données d'entrée sont au format clairsemé. |
|
kvSpliter |
Non |
Un deux-points (:) |
Spécifie le délimiteur séparant les clés et les valeurs si les données d'entrée sont au format clairsemé. |
|
lifecycle |
Non |
28 |
Cycle de vie de la table. |
|
coreNum |
Non |
Déterminé par le système |
Nombre de cœurs CPU à utiliser pour la tâche. Doit être un entier positif. Valeurs valides : [1, 9999]. |
|
memSizePerCore |
Non |
Déterminé par le système |
Quantité de mémoire allouée à chaque cœur, en Mo. La valeur doit être un entier compris entre 1 et 65536. |
Exemple
-
Préparez les données de test comme indiqué dans le tableau suivant.
Age
Workclass
Fwlght
Edu
Edu_num
Married
C
Family
Race
Sex
Gail
Loss
Work_year
Country
Income
39
State-gov
77516
Bachelors
13
Never-married
Adm-clerical
Not-in-family
White
Male
2174.0
0.0
40.0
United-States
<=50K
50
Self-emp-not-inc
83311
Bachelors
13
Married-civ-spouse
Exec-managerial
Husband
White
Male
0.0
0.0
13.0
United-States
<=50K
38
Private
215646
HS-grad
9
Divorced
Handlers-cleaners
Not-in-family
White
Male
0.0
0.0
40.0
United-States
<=50K
53
Private
234721
11th
7
Married-civ-spouse
Handlers-cleaners
Husband
Black
Male
0.0
0.0
40.0
United-States
<=50K
28
Private
338409
Bachelors
13
Married-civ-spouse
Prof-specialty
Wife
Black
Female
0.0
0.0
40.0
Other
<=50K
37
Private
284582
Masters
14
Married-civ-spouse
Exec-managerial
Wife
White
Female
0.0
0.0
40.0
United-States
<=50K
49
Private
160187
9th
5
Married-spouse-absent
Other-service
Not-in-family
Black
Female
0.0
0.0
16.0
Jamaica
<=50K
52
Self-emp-not-inc
209642
HS-grad
9
Married-civ-spouse
Exec-managerial
Husband
White
Male
0.0
0.0
45.0
United-States
>50K
31
Private
45781
Masters
14
Never-married
Prof-specialty
Not-in-family
White
Female
14084.0
0.0
50.0
United-States
>50K
42
Private
159449
Bachelors
13
Married-civ-spouse
Exec-managerial
Husband
White
Male
5178.0
0.0
40.0
United-States
>50K
-
Ajoutez les composants Read Table et Data Pivoting au pipeline, puis connectez-les.
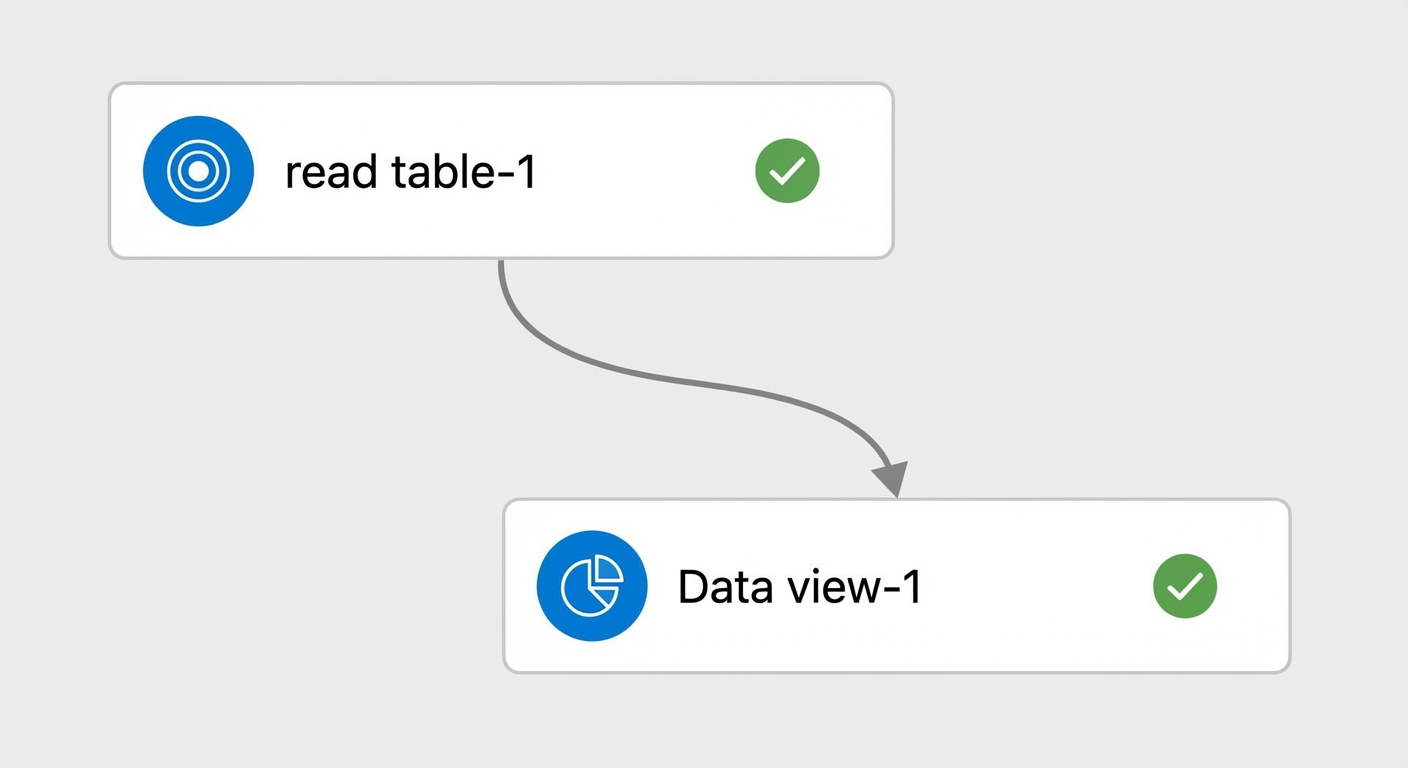
Dans l'onglet Fields Setting du composant Data Pivoting, sélectionnez income comme colonne cible et les 14 autres champs comme colonnes de caractéristiques. Traitez le champ edu_num de type BIGINT comme une caractéristique d'énumération. L'onglet Fields Setting du composant Data Pivoting indiquera que les sections Feature Columns, Target Column et Enumeration Features contiennent respectivement 14, 1 et 1 champ sélectionné.
Cliquez sur
 dans le coin supérieur gauche pour exécuter le pipeline.
-
Une fois le pipeline terminé, cliquez avec le bouton droit sur le composant Data Pivoting et sélectionnez View Data pour afficher les résultats :
Output : Pour préparer les données aux algorithmes d'apprentissage automatique, les colonnes STRING telles que family, race, sex et income sont mappées à des valeurs numériques. La table de données d'entraînement résultante contient 15 colonnes : age, fwlght, edu_num, edu, workclass, married, c, family, race, sex, country, gail, loss, work_year et income. La colonne country est mise en surbrillance pour indiquer qu'il s'agit d'une colonne de caractéristiques STRING.
-
String Column Feature Mapping Table
RemarqueSi aucune colonne de caractéristiques de type STRING n'est sélectionnée, la table String Column Feature Mapping Table est vide.
La table String Column Feature Mapping Table contient trois colonnes : feature_name, feature_value et map_id. Chaque ligne mappe une valeur de caractéristique catégorielle à un ID numérique. Par exemple, pour la caractéristique
edu_num, la valeur 13 est mappée à 1 et 14 est mappée à 2. Pour la caractéristiqueedu, la valeur '11th' est mappée à 1, et 'Bachelors' est mappée à 3, et ainsi de suite. Output Meta Table : La table de métadonnées des caractéristiques de sortie contient 10 colonnes (feature_name, feature_id, feature_type, feature_value, mean, std, min_value, max_value, label_num et distribute_info) et 15 lignes de données de caractéristiques. Le feature_type peut être
label(pour income),enum(pour edu_num, edu, workclass, married, c, family, race, sex et country) ounum(pour age, fwlght, gail, loss et work_year). Pour les caractéristiques numériques (num), les colonnes mean, std, min_value et max_value contiennent des valeurs statistiques spécifiques. Pour les caractéristiques d'énumération (enum) et d'étiquette, ces colonnes contiennent toutes-1.0. La colonne feature_value affiche les valeurs énumérées ou la plage numérique pour chaque caractéristique, et la colonne distribute_info affiche la distribution des valeurs de caractéristiques. distribute_info indique le nombre d'enregistrements pour chaque intervalle après division de la plage de valeurs de la caractéristique en intervalles égaux.