Évalue les performances d'un modèle de clustering en exploitant les données brutes et les résultats du clustering pour générer des métriques d'évaluation.
Limites
Les rapports de visualisation de ce composant sont disponibles uniquement dans la version originale de Machine Learning Studio.
Informations générales
L'indice Calinski-Harabasz, également appelé critère du rapport de variance (VRC), est une métrique d'évaluation calculée selon la formule suivante.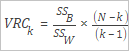
|
Paramètre |
Description |
|
SSB |
La variance inter-clusters, définie comme suit.
|
|
SSW |
La variance intra-clusters, définie comme suit.
|
|
N |
Nombre total d'enregistrements. |
|
k |
Nombre de centres de cluster. |
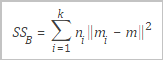 Où :
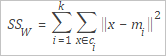 Où :
Configuration du composant
Configurez le composant d'évaluation du modèle de clustering selon l'une des méthodes suivantes.
Méthode 1 : Interface graphique
Configurez les paramètres du composant sur la page du pipeline de Machine Learning Designer.
|
Onglet |
Paramètre |
Description |
|
Field Settings |
Evaluation Columns |
Colonnes à évaluer. |
|
Input is Sparse Format |
Indique si les données d'entrée sont au format clé-valeur (KV) creux (sparse). |
|
|
Key-Value Pair Delimiter |
Par défaut : virgule (,). |
|
|
Key-Value Inner Delimiter |
Par défaut : deux points (:). |
|
|
Execution Tuning |
Number of Cores |
À utiliser avec Memory per Core. Doit être un entier positif. |
|
Memory per Core |
À utiliser avec Number of Cores. Unité : Mo. |
Méthode 2 : Commande PAI
Exécutez une commande PAI dans le composant SQL Script pour configurer les paramètres du composant. Pour plus d'informations, consultez SQL Script.
PAI -name cluster_evaluation
    -project algo_public
    -DinputTableName=pai_cluster_evaluation_test_input
    -DselectedColNames=f0,f3
    -DmodelName=pai_kmeans_test_model
-DoutputTableName=pai_ft_cluster_evaluation_out;|
Paramètre |
Obligatoire |
Description |
Valeur par défaut |
|
inputTableName |
Oui |
Nom de la table d'entrée. |
Aucune |
|
selectedColNames |
Non |
Colonnes de la table d'entrée à évaluer. Pour spécifier plusieurs colonnes, séparez leurs noms par des virgules (,). |
Toutes les colonnes |
|
inputTablePartitions |
Non |
Partitions de la table d'entrée à utiliser pour l'évaluation. Les formats suivants sont pris en charge :
Remarque
Si vous spécifiez plusieurs partitions, séparez-les par des virgules (,). |
Table entière |
|
enableSparse |
Non |
Indique si les données d'entrée sont au format creux (sparse). Valeurs valides : |
false |
|
itemDelimiter |
Non |
Délimiteur entre les paires clé-valeur au format creux (sparse). |
Virgule (,). |
|
kvDelimiter |
Non |
Délimiteur entre une key et une value au format creux (sparse). |
Deux points (:). |
|
modelName |
Oui |
Modèle de clustering d'entrée. |
Aucun |
|
outputTableName |
Oui |
Table de sortie. |
Aucune |
|
lifecycle |
Non |
Cycle de vie de la table de sortie. |
Aucun |
Exemple
-
Générez des données de test à l'aide d'une instruction SQL.
create table if not exists pai_cluster_evaluation_test_input as select * from ( select 1 as id, 1 as f0,2 as f3 union all select 2 as id, 1 as f0,3 as f3 union all select 3 as id, 1 as f0,4 as f3 union all select 4 as id, 0 as f0,3 as f3 union all select 5 as id, 0 as f0,4 as f3 )tmp; -
Créez un modèle de clustering à l'aide d'une commande PAI. Cet exemple utilise le clustering k-means.
PAI -name kmeans -project algo_public -DinputTableName=pai_cluster_evaluation_test_input -DselectedColNames=f0,f3 -DcenterCount=3 -Dloop=10 -Daccuracy=0.00001 -DdistanceType=euclidean -DinitCenterMethod=random -Dseed=1 -DmodelName=pai_kmeans_test_model -DidxTableName=pai_kmeans_test_idx -
Exécutez le composant d'évaluation du modèle de clustering à l'aide d'une commande PAI.
PAI -name cluster_evaluation -project algo_public -DinputTableName=pai_cluster_evaluation_test_input -DselectedColNames=f0,f3 -DmodelName=pai_kmeans_test_model -DoutputTableName=pai_ft_cluster_evaluation_out; -
Consultez la table de sortie pai_ft_cluster_evaluation_out. Après l'exécution du composant, la table de sortie contient une valeur
calinharade3, une valeurcenterCountde3et une valeurcountde5. Le tableau suivant décrit les champs de la table de sortie.Champ
Description
count
Nombre total d'enregistrements.
centerCount
Nombre de centres de cluster.
calinhara
Indice Calinski-Harabasz.