La fréquence d'accès aux données diminue naturellement avec le temps. La gestion du cycle de vie permet de définir des règles qui transfèrent automatiquement les objets vers des classes de stockage moins coûteuses (comme Infrequent Access ou Archive) ou les suppriment après une période donnée. Cette automatisation réduit les coûts de stockage sans nécessiter d'intervention manuelle.
Fonctionnement
La gestion du cycle de vie s'appuie sur des règles définies par l'utilisateur pour automatiser les opérations sur les objets d'un bucket. OSS charge toute nouvelle règle dans les 24 heures suivant sa création. Une fois chargée, OSS exécute quotidiennement les règles correspondantes à une heure fixe, généralement après 00:00 (UTC) le jour suivant (08:00 UTC+8).
Une règle de cycle de vie se compose de trois éléments principaux :
-
Objets à gérer : Filtrez les objets cibles par préfixe d'objet (Prefix), tag d'objet (Tag) ou taille d'objet (ObjectSize).
Les règles de cycle de vie ne prennent en charge ni les caractères génériques, ni la correspondance par suffixe, ni les expressions régulières.
-
Actions à exécuter : Définissez le traitement à appliquer aux objets filtrés :
Transition de classe de stockage (Transition) : Transférez les objets vers des classes de stockage moins coûteuses telles que Infrequent Access, Archive ou Cold Archive.
Expiration et suppression (Expiration) : Supprimez les objets lorsqu'ils atteignent une durée de cycle de vie spécifiée.
Nettoyage des fragments (AbortMultipartUpload) : Supprimez automatiquement les parties issues de téléchargements multipart interrompus après un délai défini.
-
Politiques de déclenchement : Déterminez quand les actions doivent s'exécuter :
Date de dernière modification (Last-Modified-Time) : Transférez ou supprimez les objets en fonction de leur date de dernière modification. Cette approche convient aux données dont le cycle de vie est prévisible, comme les journaux et les sauvegardes.
Date de dernier accès (Last-Access-Time) : Après avoir activé le suivi des accès, transférez les objets selon leur date de dernier accès. Ce mode est adapté aux modèles d'accès imprévisibles (tels qu'une bibliothèque de ressources). Les données froides sont automatiquement rétrogradées puis restaurées lors de l'accès.
Tous les paramètres configurables sont documentés dans Éléments de configuration du cycle de vie.
Scénarios de configuration
Nettoyage automatique des fichiers journaux expirés
Les serveurs téléchargent quotidiennement des journaux dans un répertoire dédié. Utilisez une règle basée sur la date de dernière modification pour supprimer tous les objets d'un bucket après un nombre de jours spécifié, afin de libérer de l'espace de stockage et de réduire les coûts.
Utilisation du stockage par niveaux automatique pour les données chaudes et froides
Pour les données dont la fréquence d'accès est incertaine (images de sites web, vidéos, documents), activez le suivi des accès et utilisez une règle de cycle de vie basée sur la date de dernier accès pour mettre en œuvre un niveau de données intelligent. Le système transfère alors les données froides vers des classes de stockage moins coûteuses en fonction des modèles d'accès réels.
Nettoyage automatique des versions précédentes
Lorsque le versioning est activé, les écrasements et suppressions sont conservés sous forme de versions précédentes. Si un bucket accumule un grand nombre de versions antérieures ou de marqueurs de suppression expirés, utilisez une règle de cycle de vie basée sur la date de dernière modification conjointement au versioning pour réduire les coûts de stockage. Cela permet de diminuer les dépenses et d'améliorer les performances de listage des objets.
Nettoyage automatique des fragments de téléchargements multipart
Les téléchargements multipart interrompus laissent des parties non fusionnées qui continuent d'engendrer des frais. Configurez une règle de cycle de vie pour nettoyer les parties incomplètes après un délai spécifié.
Outre les scénarios précédents, vous pouvez mettre en œuvre des politiques de gestion des données plus granulaires. Pour plus d'informations, consultez Exemples de configuration du cycle de vie. Vous avez la possibilité de combiner différentes règles afin d'obtenir une gestion fine des données de votre bucket selon vos besoins.
Règles de cycle de vie multiples
La coexistence de plusieurs règles de cycle de vie repose sur deux mécanismes : la priorité d'exécution des règles et le mécanisme d'écrasement de la configuration.
Priorité d'exécution des règles
Un bucket peut contenir plusieurs règles de cycle de vie indépendantes. Lorsqu'un objet correspond à plusieurs règles, l'action finale résulte de l'ensemble des correspondances trouvées.
Si plusieurs règles s'appliquent simultanément au même objet, elles s'exécutent selon l'ordre de priorité suivant : Suppression d'objet > Transition vers Deep Cold Archive > Transition vers Cold Archive > Transition vers Archive > Transition vers Infrequent Access > Transition vers Standard.
L'action de suppression possède toujours une priorité supérieure aux transitions de classe de stockage. Définissez un délai plus long pour les règles de suppression que pour les règles de transition. Cela évite que les objets ne soient supprimés avant la fin de la transition.
Exemple d'exécution
Supposons que vous spécifiiez les deux règles de cycle de vie suivantes, et que toutes deux correspondent au même objet.
Règle 1 : Spécifie que les objets dont la dernière modification remonte à plus de 365 jours sont transférés vers la classe de stockage Infrequent Access.
Règle 2 : Spécifie que les objets dont la dernière modification remonte à plus de 365 jours sont supprimés.
Résultat : L'objet correspondant aux règles sera supprimé plus de 365 jours après sa date de dernière modification.
Mécanisme d'écrasement de la configuration
La console gère la fusion automatiquement, ce qui empêche tout écrasement accidentel. En revanche, lors de l'utilisation d'ossutil, des SDK ou de l'API, chaque appel PutBucketLifecycle remplace intégralement toutes les configurations de cycle de vie existantes. Soumettre une nouvelle règle sans inclure les règles actuelles entraîne la suppression de ces dernières.
Exemple
Pour ajouter une nouvelle règle à vos règles existantes, procédez comme suit :
Récupérez toutes les règles de cycle de vie actuellement actives (par exemple, Règle 1).
Ajoutez la nouvelle règle (par exemple, Règle 2).
Soumettez à nouveau la configuration complète incluant l'ensemble des règles (Règle 1 + Règle 2).
Remarque : Si vous soumettez uniquement la configuration contenant la nouvelle règle (Règle 2) sans inclure la règle existante (Règle 1), la Règle 1 sera supprimée et ne sera plus active.
Mise en production
Pour déployer la gestion du cycle de vie en production en toute sécurité :
Testez avant le déploiement : Créez d'abord des règles dans un bucket de test. Vérifiez leur comportement avant de les appliquer en production.
Utilisez les règles de suppression avec prudence : Définissez le préfixe avec précision pour éviter la suppression accidentelle de données importantes.
Activez le versioning comme mesure de protection : Pour les données critiques, activez le versioning afin que les objets supprimés accidentellement par une règle de cycle de vie puissent être récupérés depuis une version précédente.
-
Recourez à des transitions par niveaux pour éviter des frais supplémentaires : Assurez-vous que le délai de déclenchement de chaque étape successive dépasse la somme du délai de déclenchement de l'étape précédente et de sa durée de stockage minimale. Cela permet d'éviter les frais liés à des transitions prématurées.
Exemple incorrect : Standard
30 days-> Infrequent Access40 days-> Archive Storage. L'objet ne reste en IA que pendant 10 jours (< 30 days) avant d'être transféré à nouveau, ce qui engendre des frais.Exemple correct : Standard
30 days-> Infrequent Access90 days-> Archive Storage. L'objet reste en IA pendant 60 jours (respectant ainsi le minimum de 30 jours) avant d'être transféré vers Archive au 90e jour.
Facturation
La configuration des règles de cycle de vie est gratuite. Des frais s'appliquent lorsque les règles s'exécutent et modifient l'état de stockage.
-
Frais de requête : Chaque transition de classe de stockage, suppression d'objet ou suppression de partie génère une requête de type
Put. Ces requêtes sont facturées individuellement. Les détails de facturation figurent dans Description des frais de cycle de vie.Pour les buckets contenant de nombreux petits fichiers, les frais de requête peuvent être significatifs. Évaluez-les avant de configurer vos règles.
-
Frais de stockage : Après la transition, les objets sont facturés au tarif de la nouvelle classe de stockage.
ImportantLes classes de stockage telles que Infrequent Access, Archive et Cold Archive imposent des exigences de durée de stockage minimale (par exemple, 30 jours pour Infrequent Access et 60 jours pour Archive). Si une règle de cycle de vie supprime ou transfère un objet avant que cette durée minimale ne soit atteinte, vous devez payer pour la durée de stockage restante. Afin d'éviter les frais de capacité conditionnelle pour un stockage inférieur à la durée spécifiée dus aux transitions ou suppressions, consultez Comment éviter les frais de capacité pour un stockage inférieur à la durée spécifiée ?. Veillez à respecter la durée de stockage minimale avant toute transition ou suppression.
-
Frais de récupération de données : Les règles de cycle de vie n'engendrent pas directement de frais de récupération de données. Toutefois, l'accès aux objets stockés dans des classes telles que Infrequent Access ou Archive entraîne des frais de récupération.
La lecture directe d'un objet IA engendre des frais de récupération de données.
La lecture d'un objet Archive entraîne des frais de capacité de récupération pour un accès en temps réel.
La restauration d'un objet Archive occasionne des frais de requête de type Put ainsi que des frais de capacité de récupération.
La restauration d'un objet Cold Archive ou Deep Cold Archive engendre des frais de requête de récupération, des frais de capacité de récupération et des frais de capacité restaurée temporaire.
ImportantPour les objets Cold Archive et Deep Cold Archive, le montant varie selon la priorité de récupération choisie. Une priorité plus élevée entraîne un coût plus important.
FAQ
Bucket avec versioning désactivé
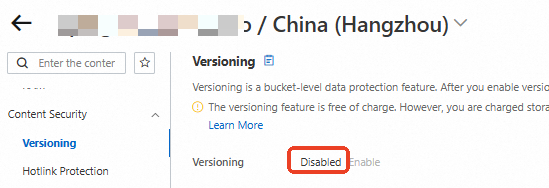
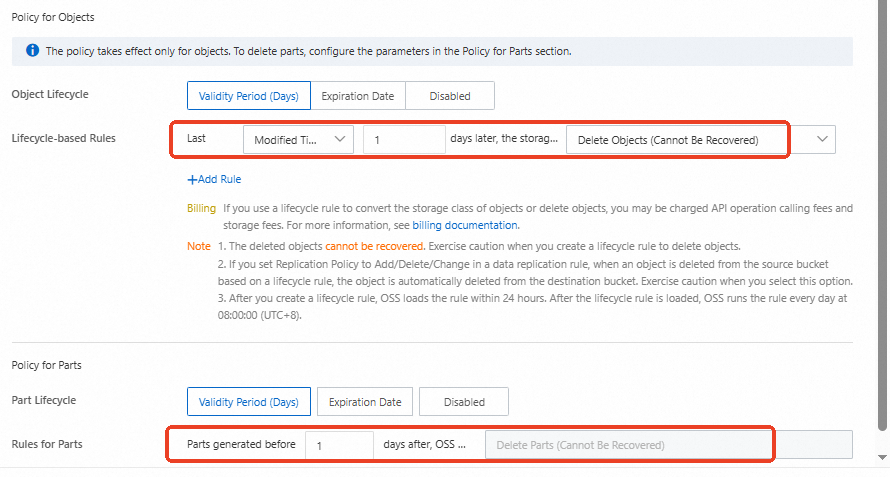
Pour un bucket dont le versioning est désactivé, il suffit de configurer une seule règle de cycle de vie pour nettoyer automatiquement et rapidement tous les fichiers ainsi que les parties issues de téléchargements multipart incomplets.
Connectez-vous à la console OSS, accédez à la page Bucket List et recherchez le bucket cible.
-
Dans le volet de navigation de gauche, choisissez et confirmez que le versioning est désactivé pour le bucket.
-
Dans le volet de navigation de gauche, choisissez . Définissez une règle de cycle de vie pour supprimer automatiquement tous les fichiers du bucket 1 jour après leur dernière modification. Configurez également le nettoyage automatique des parties issues de téléchargements multipart incomplets créés il y a plus de 1 jour.
Bucket avec versioning activé
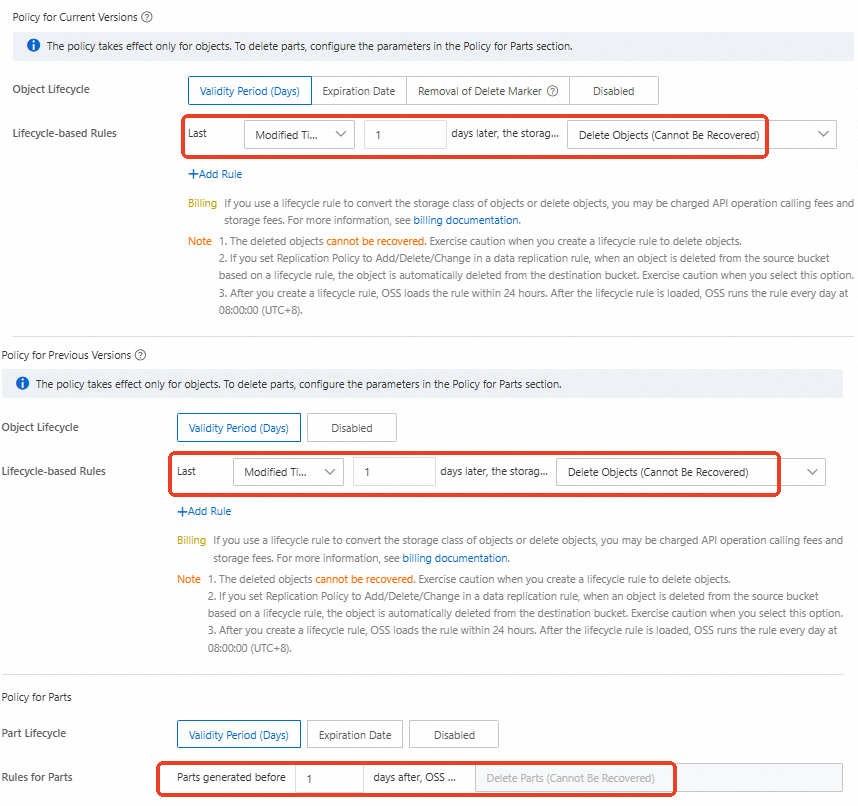
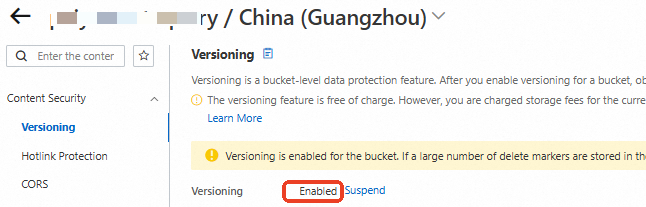
Une fois le versioning activé pour un bucket, celui-ci génère des objets de version actuelle, des objets de versions précédentes, des parties issues de téléchargements multipart incomplets et des marqueurs de suppression. Il suffit de configurer une seule règle de cycle de vie pour nettoyer automatiquement et rapidement l'ensemble de ces éléments.
Connectez-vous à la console OSS, accédez à la page Bucket List et recherchez le bucket cible.
-
Dans le volet de navigation de gauche, choisissez et confirmez que le versioning est activé pour le bucket.
-
Dans le volet de navigation de gauche, choisissez . Définissez une règle de cycle de vie pour supprimer automatiquement tous les objets de version actuelle et précédente du bucket 1 jour après leur dernière modification. Configurez également le nettoyage automatique des parties issues de téléchargements multipart incomplets créés il y a plus de 1 jour. Cette règle nettoie aussi les marqueurs de suppression.