OpenSearch Vector Search Edition est un moteur de recherche distribué à grande échelle développé par Alibaba Group. Il offre une haute disponibilité, une actualisation des données en temps réel et une recherche vectorielle rentable pour les charges de travail de production exigeantes.
Vue d'ensemble
OpenSearch Vector Search Edition est un moteur de recherche distribué à grande échelle développé par Alibaba Group. Il constitue l'épine dorsale de la recherche pour l'ensemble du groupe Alibaba, y compris Taobao, Tmall, Cainiao, Youku et les plateformes de commerce électronique hors de Chine continentale, et sert de moteur de base à Alibaba Cloud OpenSearch. Fort de plus de dix ans de déploiement en production, il répond aux exigences strictes en matière de haute disponibilité, d'actualisation des données en temps réel et de rentabilité, grâce à un système d'exploitation et de maintenance (O&M) intégré pour les déploiements de recherche personnalisés.
Architecture
OpenSearch Vector Search Edition comprend trois composants principaux : un système de gestion, un système de recherche en ligne et des sources de données. Le système de recherche en ligne charge les index et traite les requêtes vectorielles. Les sources de données fournissent à la fois des imports complets de données et des mises à jour incrémentielles en temps réel. Le système de gestion assure l'O&M automatisée, ce qui vous permet de créer et de gérer des clusters sans intervention manuelle.
Architecture du système
Système de recherche en ligne
Le système de recherche en ligne est délimité par table : chaque table vectorielle est interrogée et gérée indépendamment. La configuration par table couvre les champs, les index vectoriels, les sources de données et la concurrence des données en temps réel. L'infrastructure backend repose sur une architecture distribuée composée de deux types de nœuds de travail : les nœuds QRS (Query Result Searcher) et les nœuds Searcher.
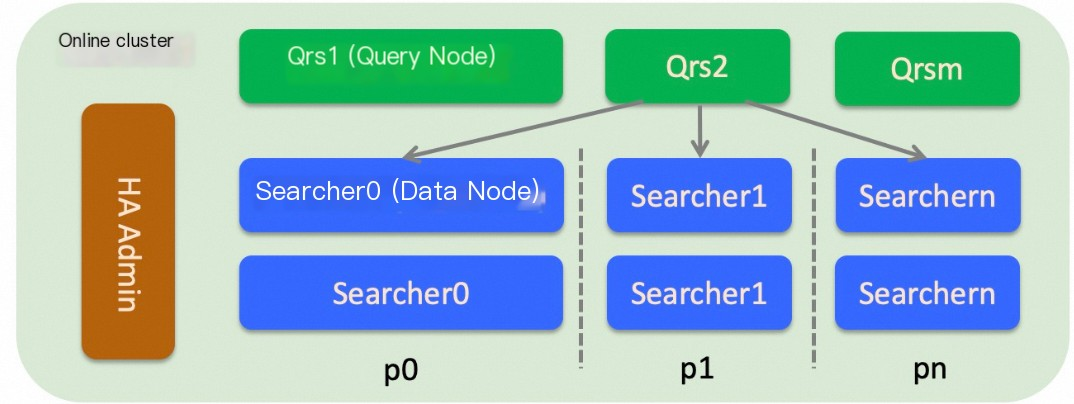
Les nœuds QRS reçoivent, analysent, valident et réécrivent vos requêtes, puis les distribuent aux nœuds Searcher. Après avoir collecté et fusionné les résultats, les nœuds QRS renvoient la réponse finale. Ces nœuds de calcul sont sans état et ne stockent aucune donnée utilisateur, ce qui leur confère une faible empreinte mémoire. L'utilisation de la mémoire n'augmente que lorsque les requêtes retournent un grand ensemble de documents ou génèrent de nombreuses entrées statistiques. Si les nœuds QRS deviennent un goulot d'étranglement, augmentez la capacité en ajoutant davantage de nœuds ou en mettant à niveau leurs spécifications.
Les nœuds Searcher chargent les données d'index, récupèrent les documents et appliquent le filtrage, l'agrégation et le classement. Les index sur les nœuds Searcher peuvent être partitionnés (sharding) : chaque shard hache les champs vers des valeurs comprises dans l'intervalle [0, 65535], et l'ensemble des shards doit couvrir la plage complète. Définissez le nombre de shards lors de la création d'un index. Le partitionnement améliore les performances des requêtes individuelles pour les grands ensembles de données. Pour augmenter le nombre total de requêtes par seconde (QPS), par exemple de 1 000 à 10 000, ajoutez plutôt des réplicas. Lorsque vous ajoutez des réplicas, toutes les données sur chaque nœud Searcher doivent être divisées en un nombre identique de shards, couvrant ensemble l'intervalle [0, 65535].
Les ressources CPU, mémoire et disque des nœuds Searcher sont partagées entre les tables.
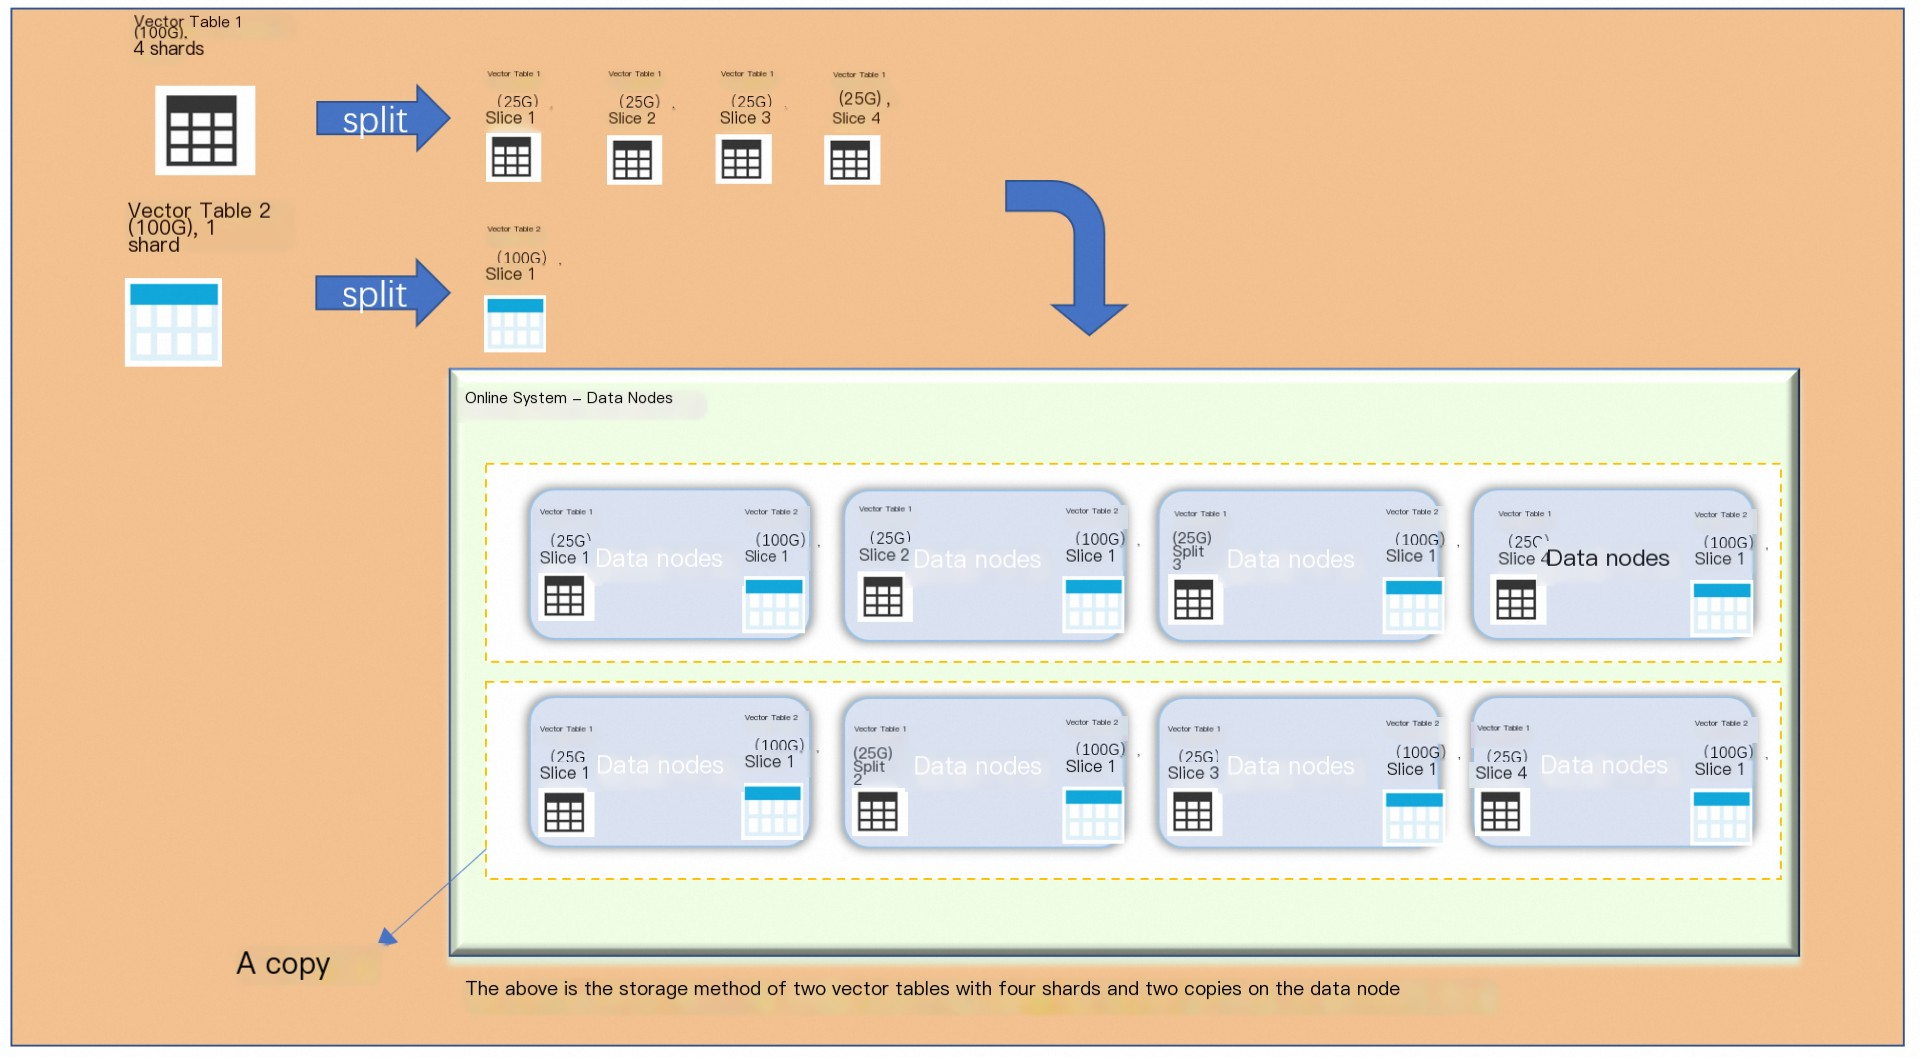
La figure ci-dessus illustre un exemple avec deux tables : la Table vectorielle 1 comporte quatre shards et répartit les données uniformément entre eux sur la base des index générés ; la Table vectorielle 2 possède un seul shard et stocke l'ensemble complet des données sur chaque nœud Searcher sous forme de table broadcast.
Sources de données
Une source de données correspond à une table selon une relation un-à-un et pilote la construction des index via une indexation complète (réindexation). Après la réindexation, les données d'index sont chargées dans la table correspondante du système de recherche en ligne pour la récupération. Les types de sources de données pris en charge sont MaxCompute, Search, Advertisement et Recommendation Offline (SARO), ainsi que API. Les sources de données API commencent vides : vous poussez toutes les données vers le système de recherche en ligne en appelant une opération API.
Système de gestion
Le système de gestion constitue la plateforme O&M pour les instances OpenSearch Vector Search Edition. Il réduit considérablement la charge opérationnelle liée au provisionnement et à la gestion des clusters.
Processus de synchronisation des données
Indexation complète
OpenSearch Vector Search Edition maintient des index sur plusieurs versions, chacune construite à partir d'un snapshot des données brutes. Par défaut, les sources de données API commencent avec des données brutes vides. Chaque exécution de réindexation déclenche un job d'indexation complète. L'indexation complète n'est pas un processus de longue durée : elle se termine une fois les données traitées et l'index construit, moment auquel le nouvel index est appliqué aux clusters en ligne.
Les index multi-versions protègent l'intégrité des données lors des modifications de schéma et de structure. Lorsque le schéma d'index ou la structure des données change, la nouvelle version d'index est isolée des versions précédentes. Si une modification de données provoque une erreur, vous pouvez revenir à n'importe quelle version antérieure.
L'indexation complète implique plusieurs étapes : traitement des données, construction d'index et fusion d'index. Vous pouvez définir la concurrence pour chaque étape afin d'accélérer le processus global.
Indexation incrémentielle en temps réel
Une fois l'indexation complète terminée, chaque version d'index lance un processus d'indexation incrémentielle de longue durée. Les nœuds de mise à jour des données consomment les données incrémentielles et maintiennent l'index continuellement à jour.
Vous pouvez pousser des données incrémentielles depuis MaxCompute, Object Storage Service (OSS) et des sources de données API vers les tables via des opérations API. Les nœuds de mise à jour des données traitent les données entrantes, et les nœuds Searcher construisent les index en temps réel pour une récupération immédiate.
Chaque index complet d'une table dispose d'un processus d'indexation incrémentielle correspondant. Ajustez le nombre de nœuds de mise à jour des données pour répondre à vos exigences de débit de données en temps réel.
Avantages
Conçu pour la recherche critique
Le moteur est écrit en C++ et alimente les systèmes commerciaux centraux d'Alibaba Group depuis plus de dix ans. Il représente un choix éprouvé pour les charges de travail de recherche nécessitant une stabilité élevée et ne tolérant aucune interruption de service.
Mises à jour en temps réel à grande échelle
En tant que moteur de recherche distribué, il gère de grands volumes de données avec une prise en effet des modifications en quelques secondes. Utilisez-le lorsque votre application exige des résultats de recherche sensibles au temps, tels que les mises à jour des stocks de produits, les flux de contenu en direct ou tout scénario où des résultats obsolètes sont inacceptables.
Gestion rentable des index
Plusieurs politiques de compression d'index et stratégies de chargement d'index multivalues vous permettent de satisfaire aux exigences de performance des requêtes à un coût infrastructurel inférieur.