AI Search Open Platform propose un service d'analyse de documents via une API. Vous pouvez intégrer ce service à vos flux de traitement métier afin de convertir des données non structurées en données structurées, prêtes à être exploitées par vos applications.
|
Nom du service |
ID du service |
Description |
Limite QPS de l'API |
|
Document Analysis Service |
ops-document-analyze-001 |
Extrait les structures hiérarchiques logiques (telles que les titres et les paragraphes), le texte, les tableaux et les images de documents non structurés, puis renvoie le résultat dans un format structuré. Types de documents pris en charge : TXT, PDF, HTML, DOC, DOCX, PPT et PPTX. |
10 Remarque
Pour demander une augmentation de la limite QPS de l'API, soumettez un ticket au support technique. |
|
ops-document-analyze-002 |
Analyse plusieurs formats de documents non structurés, tels que les fichiers PDF et les images. Ce service excelle dans l'identification d'éléments complexes comme les tableaux, les formules mathématiques et les graphiques, tout en offrant une vitesse d'inférence élevée. Limites d'utilisation : les fichiers PDF sont limités à 400 pages. Le corps de la requête ne doit pas dépasser 8 Mo. |
Prérequis
-
Obtenir les identifiants d'authentification
La plateforme ouverte AI Search nécessite une clé API pour l'authentification. Pour plus d'informations, consultez la rubrique Obtenir une clé API.
-
Obtenir le endpoint du service
Vous pouvez appeler le service via le réseau public ou un VPC. Pour plus de détails, consultez la rubrique Obtenir le endpoint du service.
Aperçu
Le corps de la requête ne doit pas dépasser 8 Mo.
Présentation
L'analyse du contenu des documents propose des interfaces synchrones et asynchrones. L'interface synchrone n'est pas recommandée pour les environnements de production en raison des risques de délai d'attente HTTP, mais elle peut s'avérer utile lors des phases de débogage. Pour les environnements de production, nous vous recommandons d'utiliser l'interface asynchrone. Cette approche se déroule en deux étapes : créez d'abord une tâche d'extraction asynchrone pour obtenir un task_id, puis interrogez régulièrement le statut de la tâche via l'interface asynchrone jusqu'à sa finalisation.
Tâche d'extraction asynchrone
Méthode de requête
POST
URL
{host}/v3/openapi/workspaces/{workspace_name}/document-analyze/{service_id}/async-
host: le endpoint du service. Vous pouvez appeler le service API via le réseau public ou à travers un VPC. Pour plus d'informations, consultez la rubrique Obtenir un endpoint de service.
workspace_name: le nom de l'espace de travail. Par exemple,default.service_id: l'ID du service intégré. Par exemple,ops-document-analyze-001.
Paramètres de requête
Paramètre d'en-tête
Authentification par clé API
|
Paramètre |
Type |
Obligatoire |
Description |
Valeur d'exemple |
|
Content-Type |
String |
Oui |
Type de média du corps de la requête. |
application/json |
|
Authorization |
String |
Oui |
Clé API utilisée pour l'authentification. |
Bearer OS-d1**2a |
Paramètres du corps
|
Paramètre |
Type |
Obligatoire |
Description |
Exemple |
|
service_id |
String |
Oui |
ID du service intégré. |
ops-document-analyze-001 |
|
document.url |
String |
Non |
URL du document. Le fichier doit être téléchargeable publiquement via HTTP ou HTTPS sans authentification. Vous devez spécifier soit |
http://opensearch-shanghai.oss-cn-shanghai.aliyuncs.com/chatos/***/file-parser/samples/GB10767.pdf |
|
document.content |
String |
Non |
Contenu du document encodé en Base64. Vous devez spécifier soit |
"aGVsbG8gd29ybGQ=" |
|
document.file_name |
String |
Non |
Nom du fichier. Si ce paramètre n'est pas spécifié, le système le déduit à partir de l'URL. Ce paramètre est requis si vous fournissez directement le contenu du document via |
test.pdf |
|
document.file_type |
String |
Non |
Type de fichier. Si ce paramètre n'est pas spécifié, le système le déduit à partir de l'extension du paramètre Types de fichiers pris en charge : TXT, PDF, HTML, DOC, DOCX, PPT et PPTX. Lorsque vous utilisez le service |
|
|
output.image_storage |
String |
Non |
Spécifie la méthode de stockage des images extraites du document.
|
url |
|
strategy.enable_semantic |
Boolean |
Non |
Active l'extraction sémantique des structures hiérarchiques à partir de fichiers TXT et d'autres documents non structurés.
|
false |
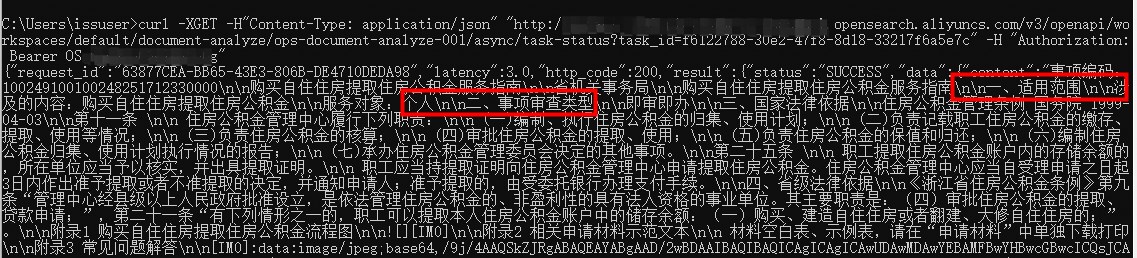
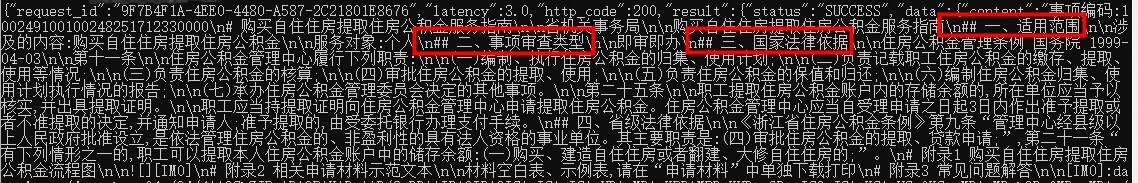
Pour les documents dont la table des matières et le corps du texte ne sont pas clairement distincts, comme illustré ci-dessous, cette fonctionnalité génère une structure hiérarchique plus précise.
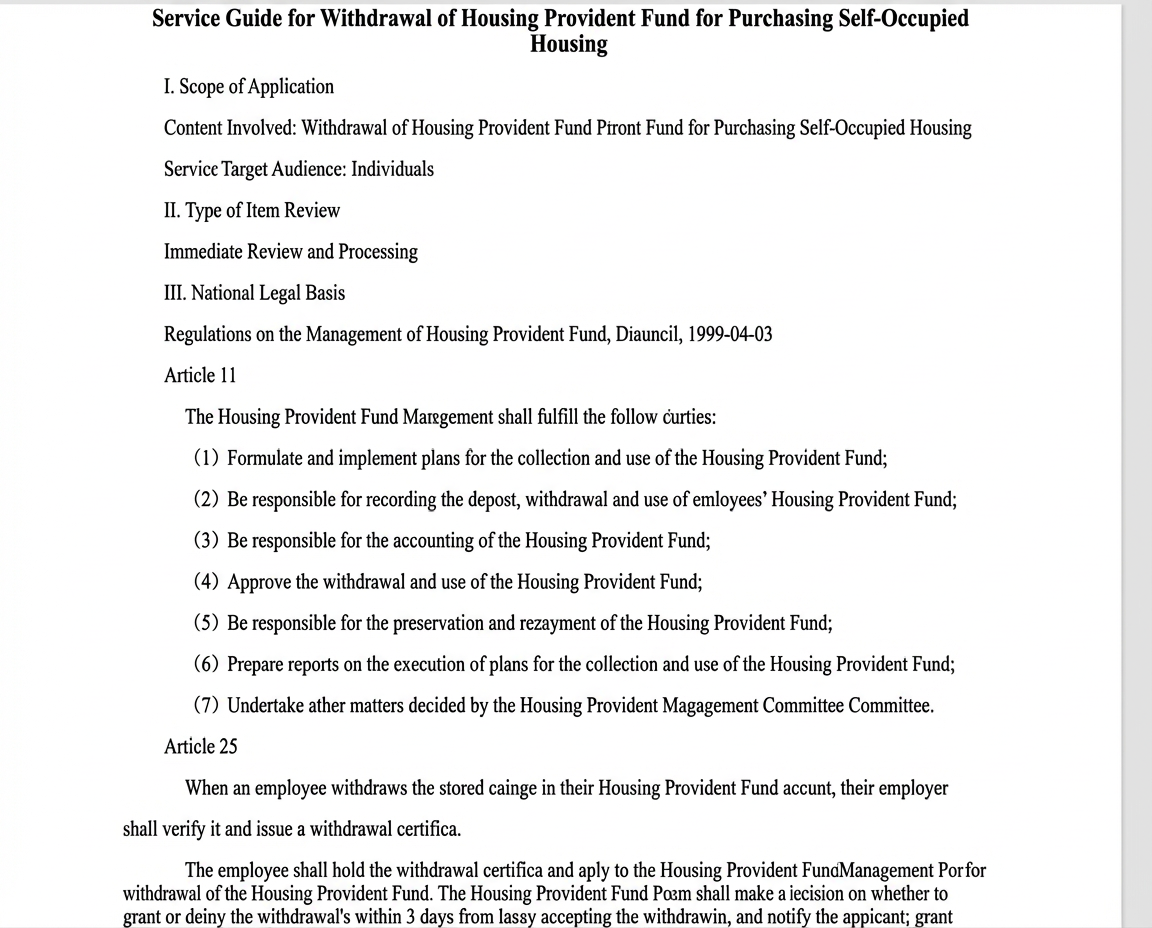
-
Avec l'extraction de la structure sémantique désactivée :
-
Lorsque l'extraction de la structure sémantique est activée, la hiérarchie des résultats est plus précise (le symbole « ## » dans la capture d'écran indique un titre de niveau 2).
 Remarque
Si
usage.semantic_token_countrenvoie une valeur, l'extraction de la structure sémantique a réussi et les frais liés à cet élément de facturation sont appliqués. En l'absence de valeur retournée, l'extraction a échoué et aucun frais n'est facturé.
Le tableau ci-dessous présente la durée estimée et le nombre de jetons sémantiques après activation de l'extraction des résultats sémantiques.
|
Pages PDF |
Jetons |
Sans hiérarchie sémantique |
Avec hiérarchie sémantique |
|
|
Durée (s) |
Durée (s) |
Jetons sémantiques |
||
|
7 |
11504 |
2 |
49 |
36243 |
|
25 |
10375 |
1 |
33 |
59332 |
|
42 |
41435 |
5 |
68 |
130717 |
Paramètres de réponse
|
Paramètre |
Type |
Description |
Exemple |
|
result.task_id |
String |
ID de la tâche asynchrone d'analyse du document. |
d5a4019e-853a-****-b5b6-8053d9f5a9fc |
Exemple cURL
curl --location 'http://****shanghai.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/async/' \
--header 'Authorization: Bearer your API key' \
--header 'Content-Type: application/json' \
--data '{
  "document":{
      "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241018/jahnyn/%E8%A7%A3%E6%9E%90%E6%B5%8B%E8%AF%95.doc"
    },
    "output" :{
      "image_storage":"base64"
    },
    "strategy": {
      "enable_semantic":true
    }
}'
Exemples de réponse
Réponse réussie
{
    "request_id": "D5A4019E-853A-4E20-****-8053D9F5A9FC",
    "latency": 5.0,
    "http_code": 200,
    "result": {
        "task_id": "d5a4019e-853a-****-b5b6-8053d9f5a9fc"
    }
}
Réponse d'erreur
En cas d'échec de la requête, la réponse décrit l'erreur dans les champs code et message.
{
    "request_id": "590A7EB8-AA84-****-AF31-8C35DC965972",
    "latency": 0.0,
    "code": "InvalidParameter",
    "http_code": 400,
    "message": "document.file_name required"
}
Récupération de tâche asynchrone
Méthode de requête
GET
URL
{host}/v3/openapi/workspaces/{workspace_name}/document-analyze/{service_id}/async/task-status?task_id=${task_id}host: endpoint du service. Vous pouvez appeler le service API via le réseau public ou par VPC. Pour plus d'informations, consultez la rubrique Obtenir un endpoint de service.workspace_name: nom du workspace. Par exemple,default.service_id: ID du service intégré. Par exemple,ops-document-analyze-001.task_id: ID de la tâche asynchrone renvoyé par la demande de création de tâche. Par exemple,d5a4019e-853a-****-b5b6-8053d9f5a9fc.
Paramètres de requête
Paramètres d'en-tête
Authentification par clé API
|
Paramètre |
Type |
Obligatoire |
Description |
Exemple |
|
Content-Type |
String |
Oui |
Type de média de la requête. La valeur doit être application/json. |
application/json |
|
Authorization |
String |
Oui |
Clé API pour l'authentification, précédée de Bearer . |
Bearer OS-d1**2a |
Paramètres de réponse
|
Paramètre |
Type |
Description |
Valeur |
|
result.task_id |
String |
ID de la tâche d'analyse asynchrone des documents. |
24c3ad59-****-40cf-974b-b63d63e0571 |
|
result.status |
String |
Statut de la tâche. Les valeurs possibles sont :
|
PENDING |
|
result.error |
String |
Message d'erreur en cas d'échec de la tâche. Ce paramètre est vide dans les autres cas. |
Failed to decrypt the document. |
|
result.data |
Object |
Résultat de l'analyse du document. |
markdown |
|
result.data.content |
String |
Contenu analysé du document.
|
"XXX" |
|
result.data.content_type |
String |
Format du contenu analysé.
|
markdown |
|
result.data.page_num |
Int |
Nombre de pages du document. |
15 |
|
request_id |
String |
Identifiant unique de cet appel API. |
B4AB89C8-B135-****-A6F8-2BAB8018688 |
|
latency |
Float/Int |
Latence de la requête en millisecondes (ms). |
10 |
|
usage |
Object |
Informations de facturation pour cet appel API. |
"usage": { "token_count": 123, "table_count": 5, "image_count": 6, "semantic_token_count":3068 } |
|
usage.token_count |
Int |
Nombre de caractères dans le document. |
1234 |
|
usage.table_count |
Int |
Nombre de tableaux dans le document. |
5 |
|
usage.image_count |
Int |
Nombre d'images dans le document. |
6 |
|
usage.semantic_token_count |
Int |
Nombre de caractères dans l'entrée du modèle d'extraction sémantique. |
3068 |
Requête cURL
curl -XGET -H"Content-Type: application/json" \
"http://****-hangzhou.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/async/task-status?task_id=110d6349-2e51-****-8bfb-25e5de434686" \
-H "Authorization: Bearer Your API key"
Exemples de réponses
Réponse réussie
{
    "request_id": "27F9CEC3-9052-****-83FF-E7957B680492",
    "latency": 13.0,
    "http_code": 200,
    "result": {
        "status": "SUCCESS",
        "data": {
            "content": "Provided proper attribution is provided, Alibaba hereby grants permission to reproduce the tables and figures in this paper solely for use in journalistic or scholarly works....",
            "content_type": "markdown",
            "page_num": 15
        },
        "task_id": "24c3ad59-b196-****-974b-b63d63e05895"
    },
    "usage": {
        "token_count": 31867,
        "table_count": 4,
        "image_count": 8,
        "semantic_token_count":3068
    }
}
Réponse d'erreur
Si une demande d'accès échoue, les champs code et message de la réponse expliquent l'erreur.
Créer une tâche d'analyse synchrone
Évitez d'utiliser l'interface synchrone dans un environnement de production en raison du risque de délais HTTP. Utilisez-la plutôt pour le débogage.
Méthode de requête
POST
URL
{host}/v3/openapi/workspaces/{workspace_name}/document-analyze/{service_id}/syncParamètres
host: endpoint du service. Vous pouvez appeler le service API via le réseau public ou un VPC. Pour plus d'informations, consultez la rubrique Get a service endpoint.workspace_name: nom de l'espace de travail. Par exemple,default.service_id: ID du service intégré. Par exemple,ops-document-analyze-001.
Paramètres de requête
Paramètre d'en-tête
Authentification par clé API
|
Paramètre |
Type |
Obligatoire |
Description |
Valeur |
|
Content-Type |
String |
Oui |
Type de requête. |
application/json |
|
Authorization |
String |
Oui |
Votre clé API. |
Bearer OS-d1**2a |
Paramètre de corps
|
Paramètre |
Type |
Obligatoire |
Description |
Valeur d'exemple |
|
document.url |
String |
Non |
URL publique du document. Elle doit être accessible via HTTP ou HTTPS sans authentification. Vous devez spécifier soit |
http://opensearch-shanghai.oss-cn-shanghai.aliyuncs.com/chatos/***/file-parser/samples/GB10767.pdf |
|
document.content |
String |
Non |
Contenu du document, encodé en Base64. Vous devez spécifier soit |
"aGVsbG8gd29ybGQ=" |
|
document.file_name |
String |
Non |
Nom du fichier. Si ce paramètre est omis, le système déduit le nom à partir de document.url. Ce paramètre est requis lorsque document.content est spécifié. |
test.pdf |
|
document.file_type |
String |
Non |
Type de fichier. Si ce paramètre est omis, le système déduit le type de fichier à partir de l'extension du Types de fichiers pris en charge : TXT, PDF, HTML, DOC, DOCX, PPT et PPTX. |
|
|
output.image_storage |
String |
Non |
Méthode de stockage des images.
|
url |
|
strategy.enable_semantic |
Boolean |
Non |
Indique s'il faut activer l'extraction de la structure sémantique. La valeur par défaut est |
false |
Paramètres de réponse
|
Paramètre |
Type |
Description |
Exemple |
|
result.status |
String |
Statut de la tâche. Les valeurs valides incluent :
|
PENDING |
|
result.error |
String |
Message d'erreur renvoyé lorsque le statut est |
Document decryption failed |
|
result.data |
Object |
Résultat de l'analyse du document. |
markdown |
|
result.data.content |
String |
Contenu analysé du document.
|
"XXX" |
|
result.data.content_type |
String |
Type de contenu du document analysé. Les valeurs valides incluent :
|
markdown |
|
result.data.page_num |
Int |
Nombre de pages du document. |
15 |
|
request_id |
String |
Identifiant unique de la requête. |
B4AB89C8-B135-****-A6F8-2BAB801A2CE4 |
|
latency |
Float/Int |
Latence de la requête en millisecondes (ms). |
10 |
|
usage |
Object |
Détails d'utilisation de la requête. |
"usage": { "token_count": 123, "table_count": 5, "image_count": 6, "semantic_token_count":3068 } |
|
usage.token_count |
Int |
Nombre total de jetons dans le document. |
1234 |
|
usage.table_count |
Int |
Nombre total de tableaux dans le document. |
5 |
|
usage.image_count |
Int |
Nombre total d'images dans le document. |
6 |
|
usage.semantic_token_count |
Int |
Nombre total de jetons sémantiques utilisés comme entrée pour le modèle d'extraction sémantique. |
3068 |
cURL
curl --location 'http://****shanghai.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/sync/' \
--header 'Authorization: Bearer your API key' \
--header 'Content-Type: application/json' \
--data '{
  "document":{
      "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241018/jahnyn/%E8%A7%A3%E6%9E%90%E6%B5%8B%E8%AF%95.doc"
    },
    "output" :{
      "image_storage":"base64"
    },
    "strategy": {
      "enable_semantic":true
    }
}'
Exemples de réponse
Exemple de réponse réussie
{
    "request_id": "27F9CEC3-9052-****-83FF-E7957B689D04",
    "latency": 13.0,
    "http_code": 200,
    "result": {
        "status": "SUCCESS",
        "data": {
            "content": "Provided proper attribution is given, Alibaba hereby grants permission to reproduce the tables and figures in this paper solely for use in journalistic or scholarly works....",
            "content_type": "markdown",
            "page_num": 15
        }
    },
    "usage": {
        "token_count": 31867,
        "table_count": 4,
        "image_count": 8,
        "semantic_token_count":3068
    }
}
Exemple de réponse d'erreur
Si une requête d'accès échoue, la réponse indique l'erreur dans les champs code et message.
{
    "request_id": "6F33AFB6-A35C-****-AFD2-9EA16CCF4383",
    "latency": 2.0,
    "code": "InvalidParameter",
    "http_code": 400,
    "message": "JSON parse error: Cannot deserialize value of type `ImageStorage` from String \\"xxx\\"
}
Codes d'état
|
Code d'état HTTP |
Code d'erreur |
Description |
|
200 |
- |
La requête a réussi. Ce statut est renvoyé même si la tâche a échoué. Vérifiez le champ |
|
404 |
BadRequest.TaskNotExist |
La tâche n'existe pas. |
|
400 |
InvalidParameter |
La requête n'est pas valide. |
|
500 |
InternalServerError |
Une erreur interne s'est produite. |
Pour plus d'informations sur les codes d'état, consultez la rubrique status codes.