Prérequis
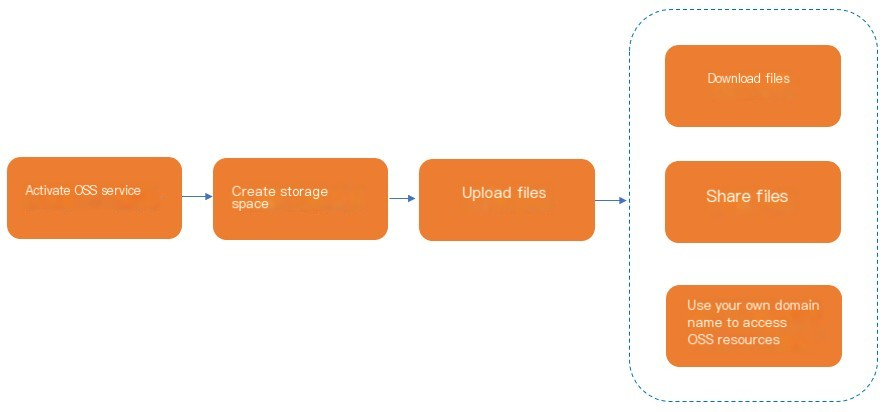
Ajouter une source de données OSS
Connectez-vous à la console OpenSearch, sélectionnez OpenSearch Retrieval Engine Edition dans l'angle supérieur gauche, repérez votre instance sur la page Instances, puis cliquez sur Manage dans la colonne Actions.
-
Configurez la source de données.
Dans le volet de navigation de gauche, accédez à Configuration Center > Data Sources et cliquez sur Add Data Source. Dans le panneau qui s'affiche, sélectionnez OSS, renseignez un Data Source Name, un OSS Path et un Bucket, puis cliquez sur Verify.
Paramètres :
Data Source Name : Nom personnalisé pour la source de données. Le nom doit commencer par une lettre et peut contenir des lettres, des chiffres et des traits de soulignement (_).
OSS Path : Chemin utilisé pour accéder aux objets dans OSS.
Bucket : Nom du bucket OSS.
Le nom du répertoire doit contenir opensearch et ne doit pas inclure de caractères spéciaux tels que les signes égal (=), les esperluettes (&) ou les points d'interrogation (?). Sinon, les données ne peuvent pas être lues.
Pour obtenir le chemin OSS, accédez au bucket que vous avez créé, cliquez sur Create Directory et copiez le chemin du nouveau répertoire. Cette rubrique utilise /opensearch_index_data/ à titre d'exemple.
Pour trouver le nom du bucket, accédez à la console OSS et localisez le bucket que vous avez créé.
-
Créer une table d'index :
Après avoir créé la source de données OSS, choisissez Configuration Center > Index Schema et cliquez sur Create Index Table.
Sur la page de configuration, saisissez un Index Table Name personnalisé et sélectionnez la source de données OSS que vous avez créée.
Dans les paramètres de champ, ajoutez deux champs. Ajoutez d'abord un champ pk de type STRING, définissez-le comme clé primaire et configurez sa méthode d'analyse sur uniq. Ajoutez ensuite un champ embeddings de type FLOAT, activez les valeurs multiples, utilisez ^] comme délimiteur et définissez sa méthode d'analyse sur uniq. Dans les paramètres d'index, ajoutez deux index : un index pk de type PRIMARYKEY64 incluant le champ pk, et un index vector de type CUSTOMIZED incluant les champs pk,embeddings.
Dans cet exemple, les champs pk et embeddings sont configurés. Pour consulter des exemples de données, voir oss_test.txt.
CMD=add
pk=999000
embeddings=0.00.0039257140.0098142860.0039257140.00
pk=999000
embeddings=0.00.0039257140
Pour plus de détails sur le format de données requis par le schéma d'index, consultez la section Format de fichier de données.
Démarrer la réindexation : Dans le volet de navigation de gauche, choisissez O&M Center > O&M Management et cliquez sur Reindexing.
Dans le panneau Reindexing, sélectionnez le Data Source Name de la source de données OSS que vous avez créée. Confirmez le Data Source Type et la Associated Index Table. Définissez un Timestamp et cliquez sur OK. Une fois la réindexation terminée, une nouvelle version d'index complète est générée. Basculez vers la nouvelle version pour l'activer.
Une fois la réindexation terminée, effectuez un test de requête.
Format de fichier HA
Les fichiers de données doivent être encodés en UTF-8 et respecter une structure spécifique. Cette section décrit le format d'entrée standard.
L'exemple suivant montre le contenu d'un fichier de données nommé standard_sample.data :
CMD=add^_
PK=12345321^_
url=http://www.aliyun.com/index.html^_
title=Alibaba Cloud Computing Co., Ltd.^_
body=xxxxxx xxx^_
time=3123423421^_
multi_value_field=1234^]324^]342^_
bidwords=mp3^\price=35.8^Ptime=13867236221^]mp4^\price=32.8^Ptime=13867236221^_
^^
CMD=delete^_
PK=12345321^_CMD=add^_
PK=12345321^_
url=http://www.aliyun.com/index.html^_
title=Alibaba Cloud Computing Co., Ltd.^_
body=xxxxxx xxx^_
time=3123423421^_
multi_value_field=1234^]324^]342^_
bidwords=mp3^\price=35.8^Ptime=13867236221^]mp4^\price=32.8^Ptime=13867236221^_
^^
CMD=delete^_
PK=12345321^_
Un fichier de données se compose de commandes, telles que add et delete. Chaque commande est un ensemble de paires clé-valeur. Utilisez ^^\n pour séparer les commandes, ^_\n pour séparer les paires clé-valeur au sein d'une commande, et ^] pour séparer les valeurs dans un champ à valeurs multiples.
Délimiteurs de fichier
|
Encodage C++ |
ASCII (Hex) |
Description |
Affichage dans Emacs/vi |
Méthode de saisie dans Emacs |
Méthode de saisie dans vi |
|
"\x1F\n" |
1F0A |
Délimiteur de paire clé-valeur |
^_ (suivi d'un saut de ligne) |
C-q C-7 |
C-v C-7 |
|
"\x1E\n" |
1E0A |
Délimiteur de commande |
^^ (suivi d'un saut de ligne) |
C-q C-6 |
C-v C-6 |
|
"\x1D" |
1D |
Délimiteur de valeurs multiples |
^] |
C-q C-5 |
C-v C-5 |
|
"\x1C" |
1C |
Identificateur de poids de section |
^\ |
C-q C-4 |
C-v C-4 |
|
"\x1D" |
1D |
Délimiteur d'élément à valeurs multiples |
^] |
C-q C-5 |
C-v C-5 |
|
"\x03" |
03 |
Délimiteur de champ de sous-document |
^C |
C-q C-c |
C-v C-c |
-
Formats de commande
-
Format de la commande add
La commande add ajoute du nouveau contenu à l'index.
La première ligne d'une commande add doit être CMD=add. Cette ligne est suivie des champs du document. L'ordre des champs dans la commande n'a pas besoin de correspondre à leur ordre dans le schéma d'index. Cependant, tous les champs utilisés doivent être définis dans le schéma d'index.
-
CMD=add^_
PK=12345321^_
url=http://www.aliyun.com/index.html^_
title=Alibaba Cloud Computing Co., Ltd.^_
body=xxxxxx xxx^_
time=3123423421^_
multi_value_field=1234^]324^]342^_
bidwords=mp3^\price=35.8^Ptime=13867236221^]mp4^\price=32.8^Ptime=13867236221^_
^^CMD=add^_
PK=12345321^_
url=http://www.aliyun.com/index.html^_
title=Alibaba Cloud Computing Co., Ltd.^_
body=xxxxxx xxx^_
time=3123423421^_
multi_value_field=1234^]324^]342^_
bidwords=mp3^\price=35.8^Ptime=13867236221^]mp4^\price=32.8^Ptime=13867236221^_
^^-
Format de la commande delete
La commande delete supprime un document spécifié de l'index.
La première ligne doit être CMD=delete, suivie de la ligne qui spécifie le champ défini comme clé primaire dans le schéma d'index.
Si un champ distinct est utilisé pour le hachage de partition, ce champ doit également être inclus. Si le champ de clé primaire est également utilisé pour le hachage de partition, il suffit de le spécifier une seule fois.
CMD=delete^_
PK=12345321^_
^^CMD=delete^_
PK=12345321^_
^^
Supprimer une source de données OSS
Sur la page Data Sources, repérez la source de données que vous souhaitez supprimer et cliquez sur Delete dans la colonne Actions.
Important :
Cette action est irréversible. Procédez avec prudence.
Une boîte de dialogue de confirmation s'affiche. Cliquez sur Confirm pour continuer.
Vous ne pouvez pas supprimer une source de données tant qu'elle est associée à une table d'index. Vous devez supprimer la table d'index avant de pouvoir supprimer la source de données.
Remarques d'utilisation
Le service OSS doit se trouver dans la même région que votre instance OpenSearch Retrieval Engine Edition.
OpenSearch Retrieval Engine Edition ne prend pas en charge les buckets OSS Anywhere.
Lorsque vous ajoutez une source de données OSS, un rôle lié au service nommé AliyunServiceRoleForSearchEngine est automatiquement créé. Si ce rôle existe déjà, il n'est pas créé à nouveau. OpenSearch utilise ce rôle pour accéder à vos ressources dans d'autres services Alibaba Cloud.