OpenSearch Retrieval Engine Edition est un moteur de recherche distribué à grande échelle développé par Alibaba. Il alimente les services de recherche de l'ensemble du groupe Alibaba, notamment Taobao, Tmall, Cainiao, Youku et les activités de commerce électronique à l'étranger, et constitue le socle du service OpenSearch sur Alibaba Cloud. Conçu pour offrir une haute disponibilité, des performances en temps réel et un coût réduit, il intègre un système mature d'exploitation et de maintenance (O&M) automatisé qui vous permet de créer des services de recherche adaptés à vos besoins métier.
Architecture du service
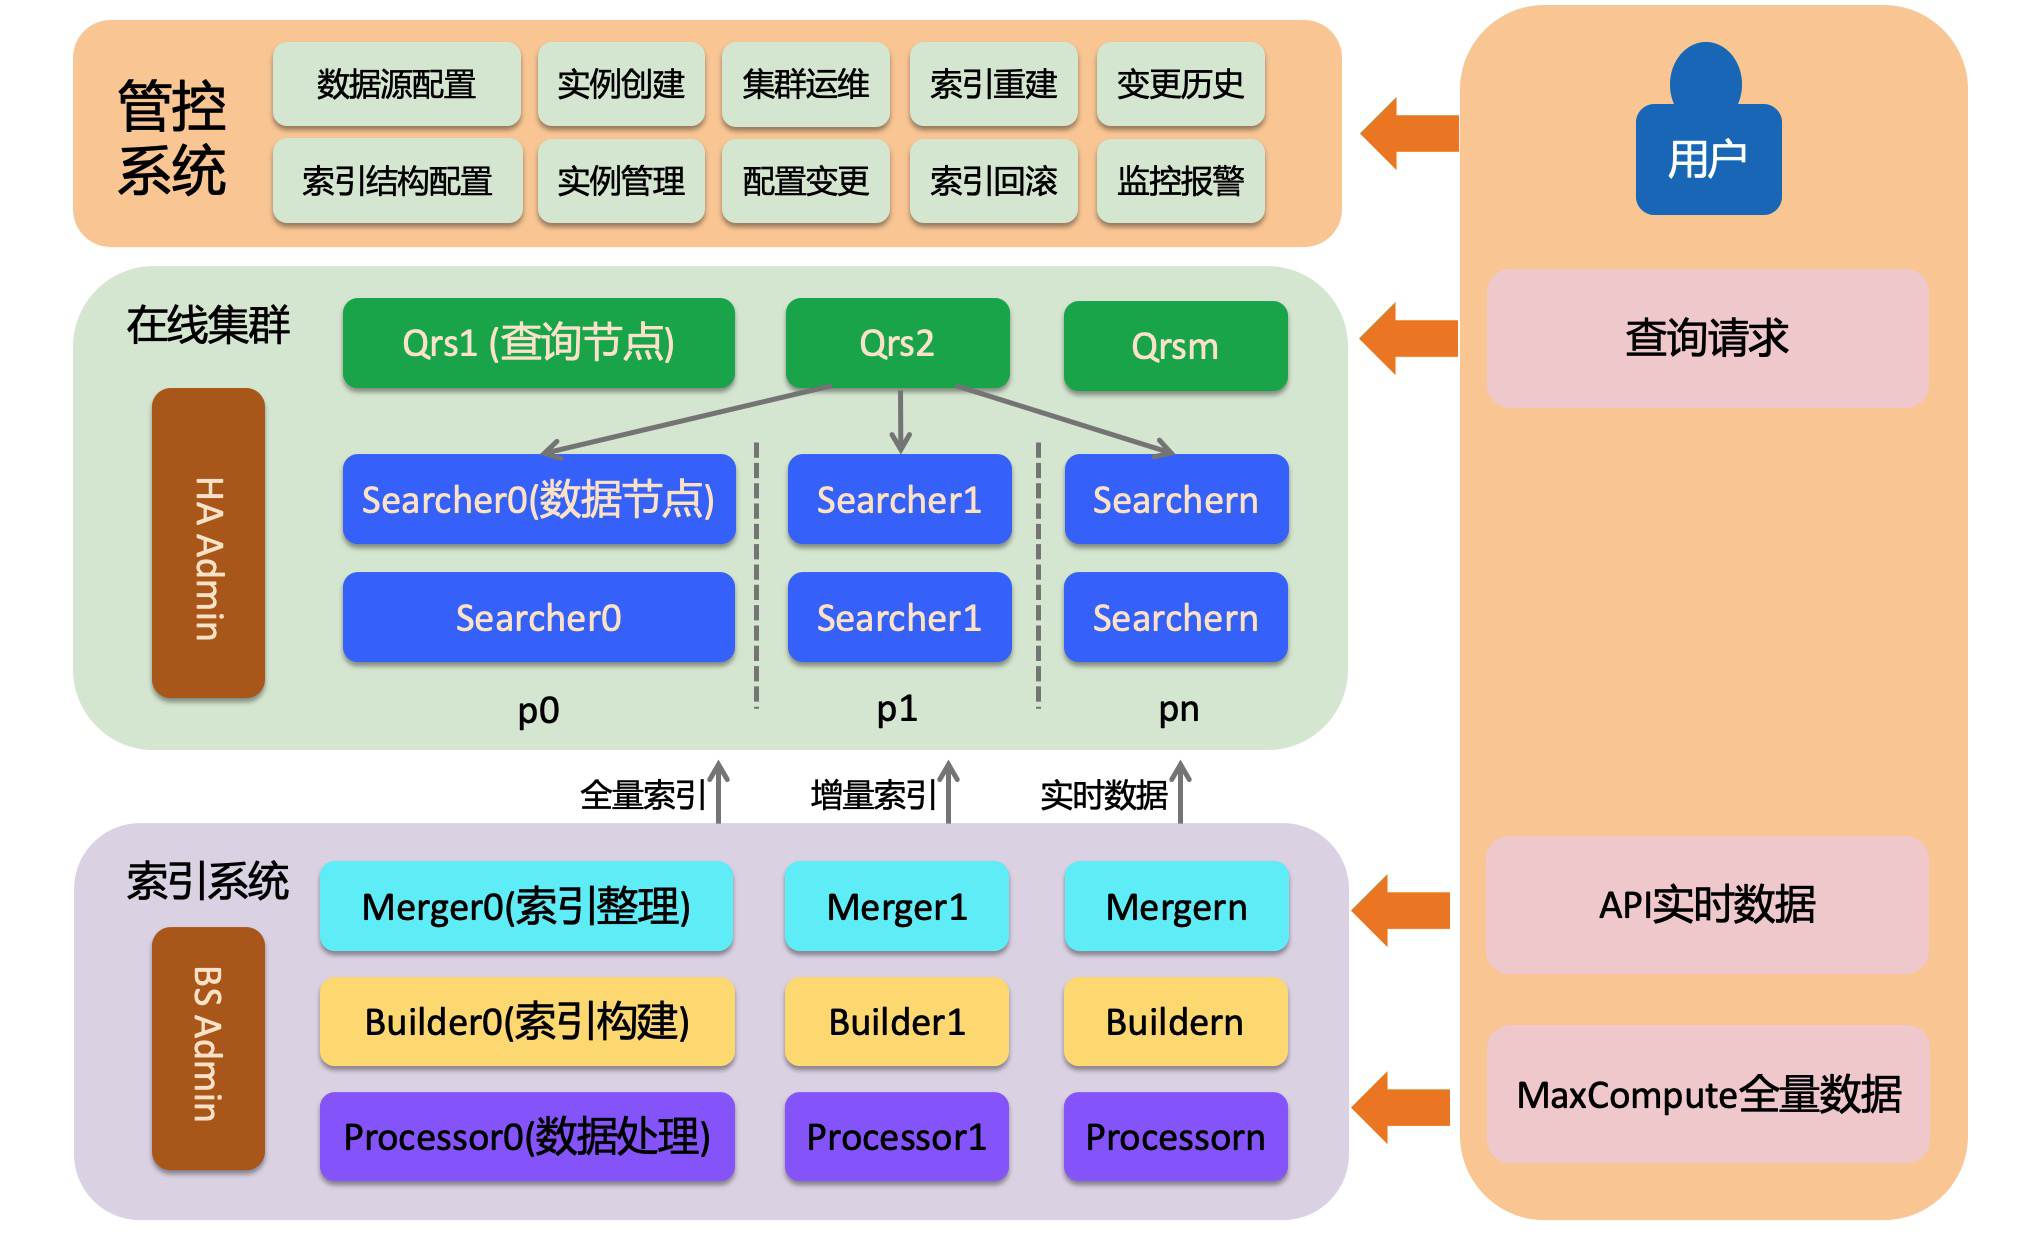
OpenSearch Retrieval Engine Edition se compose de trois parties : un système en ligne, un système de construction d'index hors ligne et un système de contrôle. Le système en ligne charge les index et traite les requêtes de recherche. Le système hors ligne construit des index complets, incrémentiels par lots et en temps réel à partir des données utilisateur. Le système de contrôle assure l'exploitation et la maintenance (O&M) automatisées et vous aide à créer et gérer des clusters.
Système en ligne
Le système en ligne est un système distribué de recherche d'informations comportant trois rôles : admin, qrs et searcher.
HA Admin
Le HA Admin est le cerveau du système en ligne. Chaque cluster physique dispose d'au moins un nœud admin. Il reçoit les commandes du système de contrôle et envoie des instructions d'O&M aux nœuds Qrs et Searcher. Il surveille également ces nœuds en temps réel et remplace automatiquement tout nœud dont le signal heartbeat est anormal.
Qrs (QRS worker)
Un Qrs (QRS worker) est un nœud de traitement des requêtes et des résultats. Il analyse, valide ou réécrit les requêtes entrantes, les transmet au Searcher, puis collecte, fusionne et renvoie les résultats. Les workers QRS sont optimisés pour le calcul et ne chargent pas les données utilisateur ; ils nécessitent donc généralement peu de mémoire. L'utilisation de la mémoire peut toutefois augmenter lorsque de nombreux documents sont renvoyés ou que de nombreuses entrées statistiques sont générées. Si la capacité QRS devient un goulot d'étranglement, ajoutez des nœuds de secours ou mettez à niveau les spécifications des nœuds.
Searcher (nœud de données)
Un Searcher charge les données d'index utilisateur et récupère les documents en fonction des requêtes, en effectuant le filtrage, les statistiques et le tri. Les index sur un Searcher peuvent être partitionnés en hachant le champ de partitionnement vers une valeur dans la plage [0, 65 535] et en divisant cette plage en un nombre spécifié de shards (défini lors de la construction de l'index). Le partitionnement améliore les performances des requêtes uniques pour les clusters contenant de grands volumes de données ou ayant des exigences strictes en matière de latence. Pour augmenter le débit global — par exemple, de 1 000 QPS à 10 000 QPS — effectuez une mise à l'échelle horizontale en ajoutant des nœuds Searcher de secours qui hébergent toutes les données. Les shards doivent couvrir l'intégralité de la plage [0, 65 535].
Système de construction d'index hors ligne
OpenSearch Retrieval Engine Edition utilise la séparation lecture/écriture, de sorte que les écritures de données n'affectent pas le service de recherche en ligne. Cela garantit la stabilité des requêtes tout en prenant en charge des écritures en temps réel à grande échelle. Le système de construction d'index comporte deux flux — complet et incrémentiel — chacun impliquant trois rôles pour le traitement des données et la construction d'index.
Flux complet
Les index prennent en charge plusieurs versions, chacune construite à partir de données brutes (les sources de données API sont vides par défaut). La première construction exécute une tâche ponctuelle de traitement complet des données pour générer un index complet, qui est ensuite basculé vers le cluster en ligne pour la recherche. Les mises à jour incrémentielles suivantes sont appliquées au nouvel index complet. Actuellement, les tâches complètes peuvent uniquement lire les données à partir de sources MaxCompute ou Hadoop Distributed File System (HDFS).
La gestion de plusieurs versions d'index assure la stabilité lors des modifications de données. Lorsque le schéma d'index ou la structure des données change, une construction complète génère un nouvel index complètement isolé de l'ancienne version, ce qui vous permet d'effectuer rapidement un retour arrière en cas de problème.
La génération d'index complet implique plusieurs étapes : traitement des données, construction d'index et fusion d'index. Définissez le niveau de parallélisme à chaque étape pour augmenter la vitesse de génération.
Flux incrémentiel
Après la génération d'un index complet, les mises à jour de données suivantes sont poussées via une API et traitées par deux pipelines. Dans l'un des pipelines, un Processor pousse les données directement vers un nœud de données pour construire un index en temps réel en mémoire. Dans l'autre, un Builder et un Merger créent un index incrémentiel qui est appliqué au nœud de données via un basculement incrémentiel. Lors d'un basculement incrémentiel, l'index en temps réel en mémoire est effacé et les données déjà présentes dans l'index incrémentiel sont supprimées de l'index en temps réel afin de réduire la pression sur la mémoire.
Chaque table d'index correspond à un flux incrémentiel, qui est une tâche de longue durée. Améliorez le traitement des données en temps réel en ajustant le parallélisme de chaque nœud du flux.
Processor
Un Processor traite les documents bruts en tokenisant ou en réécrivant le contenu des champs selon la logique métier. Dans un flux incrémentiel, le Processor s'exécute en tant que service distribué de longue durée dont vous pouvez ajuster le parallélisme pour améliorer le débit. Le Processor prend également en charge plusieurs plugins de traitement des données. Cette fonctionnalité n'est pas encore disponible publiquement. Contactez-nous si vous en avez besoin.
Builder
Un Builder construit un index à partir des documents traités. Il s'exécute en alternance avec le Merger : après chaque construction, une tâche Merger organise l'index, et seul l'index organisé est basculé vers le nœud de données.
Merger
Un Merger consolide et organise les données d'index provenant du Builder sous une forme plus compacte. Au fur et à mesure que les données sont mises à jour, les anciens index accumulent des enregistrements marqués pour suppression. Le Merger nettoie et fusionne ces données selon une politique de fusion spécifiée.
Structure d'index de Retrieval Engine Edition
|-- generation_0
        |-- partition_0_32767
        |-- index_format_version
        |-- index_partition_meta
        |-- schema.json
  |-- version.0
        |-- segment_0
            |-- segment_info
                        |-- attribute
                        |-- deletionmap
             |-- index
      |-- summary
    |-- segment_1
            |-- segment_info
                        |-- attribute
                        |-- deletionmap
             |-- index
      |-- summary
         |-- partition_32768_65535
        |-- index_format_version
        |-- index_partition_meta
        |-- schema.json
  |-- version.0
        |-- segment_0
            |-- segment_info
                        |-- attribute
                        |-- deletionmap
             |-- index
      |-- summary
    |-- segment_1
            |-- segment_info
                        |-- attribute
                        |-- deletionmap
             |-- index
|-- summary|
Nom de la structure |
Description |
|
generation |
|
|
partition |
Une partition est l'unité de base permettant à un searcher de charger un index. Un volume de données trop important dans une seule partition peut dégrader les performances du searcher. Les données en ligne sont généralement divisées en plusieurs partitions pour garantir l'efficacité de la recherche de chaque searcher. |
|
schema.json |
Fichier de configuration d'index qui enregistre les informations sur les champs, les index, les attributs et les résumés. Le moteur utilise ce fichier pour charger l'index. |
|
version.0 |
Fichier de version qui enregistre les segments à charger dans la partition actuelle et l'horodatage du dernier document. Lors d'une construction en temps réel, le moteur filtre les anciens documents bruts en fonction de l'horodatage de la version incrémentielle. |
|
segment |
Un segment est l'unité de base d'un index. Un segment contient les structures d'index inversé et direct d'un document. Le générateur d'index crée un segment à chaque vidage. Plusieurs segments peuvent être fusionnés selon une politique de fusion. Les segments disponibles dans une partition sont spécifiés dans le fichier de version. |
|
segment_info |
Métadonnées du segment qui enregistrent le nombre de documents, l'état de fusion, les informations de localisation et l'horodatage du dernier document. |
|
index |
Répertoire d'index inversé. |
|
attribute |
Répertoire d'index direct. |
|
deletionmap |
Enregistrements des documents supprimés. |
|
summary |
Répertoire d'index de résumé. |
Système de contrôle
Le système de contrôle est une plateforme d'O&M pour les instances Retrieval Engine Edition qui réduit considérablement les coûts d'O&M. Pour plus d'informations, consultez la documentation du produit Retrieval Engine Edition.
Fonctionnalités du produit
Stable
Développé en C++ et perfectionné depuis plus d'une décennie, Retrieval Engine Edition alimente plusieurs activités centrales et a fait la preuve de sa grande stabilité — idéal pour les scénarios de recherche critiques.
Efficace
En tant que moteur de recherche distribué, Retrieval Engine Edition récupère efficacement des ensembles de données massifs et prend en charge des mises à jour de données en temps réel qui prennent effet en quelques secondes — idéal pour les scénarios de recherche sensibles à la latence qui nécessitent des données en temps réel.
Faible coût
Retrieval Engine Edition prend en charge plusieurs politiques de compression d'index et le chargement d'index multi-valeurs, vous aidant ainsi à répondre aux exigences de requête à moindre coût.
Fonctionnalités riches
Retrieval Engine Edition prend en charge divers types d'analyseurs, plusieurs types d'index et une syntaxe de requête puissante. Il fournit également un mécanisme de plugin qui vous permet de personnaliser votre logique de traitement métier.
Requête SQL
Retrieval Engine Edition prend en charge la syntaxe de requête SQL et les jointures multi-tables en ligne, avec un ensemble riche de fonctions définies par l'utilisateur (UDF) intégrées et un mécanisme de personnalisation des UDF. SQL Studio sera bientôt intégré au système d'O&M pour vous aider à développer et tester des requêtes SQL.