Analyseur N-gram
Description : Découpe le texte en séquences de N caractères consécutifs. Il prend en charge l'analyse 2-gram et 3-gram et convient aux recherches non sémantiques.
Cet analyseur est disponible uniquement pour les applications dédiées et nécessite des champs SHORT_TEXT.
Exemple :
-
2-gram
Field value: "Open Search". Tokens: 'op','pe','en','n ',' s','se','ea','ar','rc','ch'. -
3-gram
Field value: "Open Search". Tokens: 'ope','pen','en ','n s',' se','sea','ear','arc','rch'.
Analyseur de mots-clés
Description : Ne tokenize pas la valeur du champ. Utilisez-le pour la correspondance exacte de tags, de mots-clés et d'autres valeurs de chaîne ou numériques qui doivent rester intactes.
Remarque : Prend en charge les champs LITERAL, INT, LITERAL_ARRAY et INT_ARRAY.
Exemple :
For example, a field containing the Chinese term for chrysanthemum tea is retrieved only when the query matches the complete field value.Étapes de configuration :
Dans le schéma d'application de la modification hors ligne, définissez le type de champ cible sur LITERAL.
Dans le schéma d'index, créez un index pour le champ. Sa méthode d'analyse est automatiquement définie sur l'analyse par mot-clé.
Soumettez la modification hors ligne et attendez la fin du basculement du service.
Utilisez
query=field_name:"search_term"pour exécuter une requête de correspondance exacte. Seuls les documents dont la valeur du champ correspond exactement à la valeur entre guillemets doubles sont récupérés. Par exemple,query=id:"OpenSearch".
Pour un champ TEXT, utilisez des guillemets doubles pour exécuter une requête de phrase. Le contenu entre guillemets est traité comme un tout sans tokenisation supplémentaire. Par exemple, query=default:"OpenSearch". Pour plus d'informations, consultez la section Recherche floue.
Analyseur général pour le chinois
Description : Tokenise le texte chinois en unités de recherche basées sur la sémantique. Cet analyseur sectoriel convient aux scénarios à usage général.
Remarque : Cet analyseur prend en charge les champs TEXT et SHORT_TEXT.
Exemple :
For example, a field containing the Chinese term for chrysanthemum tea can be retrieved by searches for the complete term, the word for chrysanthemum, the word for tea, or the phrase for flower tea.Analyseur e-commerce pour le chinois
Description : Un analyseur destiné aux scénarios e-commerce.
Remarque : Cet analyseur prend en charge les champs TEXT et SHORT_TEXT.
Exemple :
For example, a field containing the Chinese product name for Dabao SOD lotion can be retrieved by searches for its brand name, sod, the combinations of SOD and lotion, or the final character meaning lotion.Analyseur mono-caractère pour le chinois
Description : Tokenise le texte en caractères chinois individuels ou en mots. Il convient aux recherches chinoises non sémantiques, telles que les recherches d'auteurs ou de noms de magasins.
Remarque : Cet analyseur prend en charge les champs TEXT et SHORT_TEXT.
Exemple :
For example, a field containing the Chinese term for chrysanthemum tea can be retrieved by searches for the complete term, its two-character phrases, individual characters, or the nonconsecutive combination of the characters for chrysanthemum and tea.Analyseur flou
Description : Prend en charge la recherche pinyin, la recherche par préfixe et suffixe pour les nombres, la recherche par caractère unique et la recherche par lettre unique. La correspondance par préfixe et suffixe est prise en charge pour les lettres, les nombres et le pinyin, mais pas pour les caractères chinois. La longueur du champ est limitée à 100 octets. Pour plus de détails et de précautions, consultez la section Recherche floue.
Remarque : Prend en charge uniquement les champs SHORT_TEXT.
Exemple :
For example, a field containing the Chinese term for chrysanthemum tea can be retrieved by searches for the full term, its character combinations, individual characters, or the pinyin strings ju, juhua, juhuacha, j, jh, and jhc.
If a field contains the phone number 138****5678, use ^138 to match numbers beginning with 138 or 5678$ to match numbers ending with 5678.
If a field contains OpenSearch, a single letter or a combination of letters can retrieve it.
Analyseur avec racinisation pour l'anglais
Description : Convient à la recherche sémantique en anglais. Par défaut, il racinise chaque mot anglais tokenisé et convertit entre les formes singulières et plurielles.
Remarque : Prend en charge les champs TEXT et SHORT_TEXT. Cet analyseur ne prend pas actuellement en charge la configuration de l'analyse de requête.
Exemple :
For example, if a field contains a Chinese phrase meaning “English tokenizer” followed by “english analyzer”, searches for the Chinese phrase, “english”, “analyz”, “analyzer”, “analyzers”, “analyze”, “analyzed”, or “analyzing” can retrieve it.
Note: Consecutive Chinese characters are treated as one token by this English analyzer.
Analyseur de mots sans racinisation pour l'anglais
Description : Convient à la recherche de titres de livres et de noms en anglais. Il tokenise le texte aux espaces et aux signes de ponctuation.
Remarque : Prend en charge les champs TEXT et SHORT_TEXT. Cet analyseur ne prend pas actuellement en charge la configuration de l'analyse de requête.
Exemple :
For example, if a field contains a Chinese phrase meaning “English tokenizer” followed by “english analyzer”, searches for the Chinese phrase, “english”, or “analyzer” can retrieve it.
Note: Consecutive Chinese characters are treated as one token by this English analyzer.
Analyseur granulaire pour l'anglais
Description : Effectue une tokenisation sémantique par unité de recherche anglaise et convient aux textes anglais à usage général.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées.
Exemple :
If a document field contains “dataprocess” and is tokenized as “data process”, searches for “dataprocess”, “data process”, “data”, or “process” can retrieve it.Analyseur pinyin complet
Description : Recherche les caractères chinois dans un texte court par leurs initiales ou leur orthographe pinyin complète. Convient aux noms et aux titres de films. Les recherches en pinyin complet nécessitent des syllabes complètes ; les syllabes partielles ne correspondent pas.
Remarque : Prend en charge uniquement les champs SHORT_TEXT.
Exemple :
For example, if a field contains a Chinese movie title romanized as “Da Nei Mi Tan 007”, searches for “d”, “dn”, “dnm”, “dnmt”, “dnmt007”, “da”, “danei”, “daneimi”, or “daneimitan” can retrieve it. Searches for “an” or “anei” cannot.Analyseur pinyin abrégé
Description : Recherche les caractères chinois dans un texte court par leurs initiales pinyin. Convient aux noms et aux titres de films que les utilisateurs recherchent par abréviation.
Remarque : Prend en charge uniquement les champs SHORT_TEXT.
Exemple :
For example, if a field contains a Chinese movie title romanized as “Da Nei Mi Tan 007”, searches for “d”, “dn”, “dnm”, “dnmt”, “dnmt0”, “dnmt007”, “m”, “mt”, “mt007”, or “007” can retrieve it.Analyseur simple
Description : Offre aux utilisateurs un contrôle total sur la tokenisation lorsque les analyseurs intégrés ne répondent pas à leurs besoins. Utilisez le caractère de tabulation « \t » pour séparer le contenu du champ lors de l'envoi de documents et pour séparer les termes de requête lors de la recherche. Maintenez la cohérence de la tokenisation entre le contenu du champ et les requêtes, sinon les documents risquent de ne pas être récupérés.
Remarque : Prend en charge les champs TEXT et SHORT_TEXT. Cet analyseur ne prend pas actuellement en charge la configuration de l'analyse de requête.
Exemple :
Let C stand for the Chinese character for chrysanthemum and FT for the Chinese phrase for flower tea. For a field containing C\tFT\thao, only the queries C, FT, C\tFT, FT\thao, C\thao, and C\tFT\thao retrieve the document. C and FT are placeholders for Chinese text.Analyseur numérique
Description : Convient aux recherches par intervalle de temps ou par plage numérique.
Remarque : Prend en charge les champs INT et timestamp.
Exemple :
For example: query=default:'OpenSearch' AND index:[number1,number2]
// Here, index is the name of the index configured for numeric analysis.
Analyseur géolocalisation
Description : Convient aux requêtes de plage géographique.
Remarque : Prend en charge uniquement les champs geo_point.
Exemple :
For example: query=spatial_index:'circle(116.5806 39.99624, 1000)'
// Finds points within the circle, such as places within a specified distance.
Analyseur de contenu IT
Description : Un analyseur sectoriel pour le contenu IT. Il tokenise certains termes IT différemment de l'analyseur général.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Exemple :
English glosses of the Chinese example:
Original: C++ array usage notes
General analysis: C ++ array usage notes
IT content analysis: C++ array usage notes
Analyseur e-commerce général
Description : Un analyseur sectoriel pour le e-commerce. Basé sur l'expérience accumulée dans le secteur et sur la technologie de traitement du langage naturel de l'Alibaba DAMO Academy, il fournit une analyse de requête e-commerce adaptée aux besoins du secteur.
Remarque :
Prend en charge uniquement les champs TEXT.
Disponible uniquement pour les applications dédiées avec la spécification E-commerce Enhanced.
Exemple :
English glosses of the Chinese example:
Original: small gold tube concealer
General analysis: small gold tube | concealer | cream
Industry e-commerce analysis: small gold tube | concealer | cream
Analyseur général pour le thaï
Description : Tokenise le texte thaï en unités de recherche pour des scénarios à usage général.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées.
Exemple :
If a document field contains “แหล่งดึงดูดนักท่องเที่ยว” and is tokenized as “แหล่ง ดึง ดูด นักท่องเที่ยว”, searches for “นักท่องเที่ยว” or “แหล่งดึงดูดนักท่องเที่ยว” can retrieve it.Analyseur e-commerce pour le thaï
Description : Un analyseur pour les scénarios e-commerce thaïlandais.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées.
Exemple :
If a document field contains “หน้าจอโทรศัพท์” and is tokenized as “หน้าจอ โทรศัพท์”, searches for “หน้าจอโทรศัพท์”, “หน้าจอ”, or “โทรศัพท์” can retrieve it.Analyseur général pour le vietnamien
Description : Un analyseur pour le texte vietnamien à usage général.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées.
Analyseur général pour l'indonésien
Description : Un analyseur pour le texte indonésien à usage général.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées.
Analyseur général pour l'industrie du jeu
Description : Un analyseur pour les scénarios de jeu.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées avec la spécification Gaming Enhanced.
Exemple :
If a field contains the Chinese phrase for Genshin equipment and is tokenized into the words for Genshin and equipment, searches for the complete phrase or either word can retrieve it.Analyseur e-commerce général pour l'anglais
Description : Un analyseur pour les scénarios e-commerce en anglais.
Remarque : Prend en charge uniquement les champs TEXT.
Disponible uniquement pour les applications dédiées avec la spécification E-commerce Enhanced.
Analyseur de caractères pour le chinois
Description : Tokenise le texte chinois par caractères chinois individuels, nombres, lettres anglaises et signes de ponctuation. Convient aux recherches non sémantiques.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées.
Exemple :
For example, if a field contains four Chinese characters meaning “Open Search” followed by “OpenSearch123.”, searches for any one of those Chinese characters, any listed English letter, or the period can retrieve it.Analyseur général pour le coréen
Description : Un analyseur pour le texte coréen à usage général.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées.
Exemple :
If a document field contains “인제군의교육” and is tokenized as “인제군 의 교육”, searches for “인제군의교육”, “의”, or “교육” can retrieve it.Analyseur e-commerce pour le coréen
Description : Un analyseur pour les scénarios e-commerce coréens.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées.
Exemple :
If a document field contains “스포츠캐주얼신발” and is tokenized as “스포츠 캐주얼 신발”, searches for “스포츠”, “캐주얼”, or “신발” can retrieve it.Analyseur général pour le japonais
Description : Un analyseur pour le texte japonais à usage général.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées.
Exemple :
If a document field contains “メキシコアグーチ” and is tokenized as “メキシコ アグーチ”, searches for “メキシコ” or “アグーチ” can retrieve it.Analyseur e-commerce pour le japonais
Description : Un analyseur pour les scénarios e-commerce japonais.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Disponible uniquement pour les applications dédiées.
Exemple :
If a document field contains “ラウンドネックスーツ” and is tokenized as “ラウンド ネック スーツ”, searches for “ラウンド”, “ネック”, or “スーツ” can retrieve it.Analyseur de texte personnalisé
Description : Combine un analyseur sectoriel (général, e-commerce ou analyse de noms de personnes) avec des termes d'intervention personnalisés. Pour plus de détails, consultez la section Analyseurs de texte personnalisés.
Remarque : Prend en charge uniquement les champs TEXT et SHORT_TEXT.
Tester les analyseurs
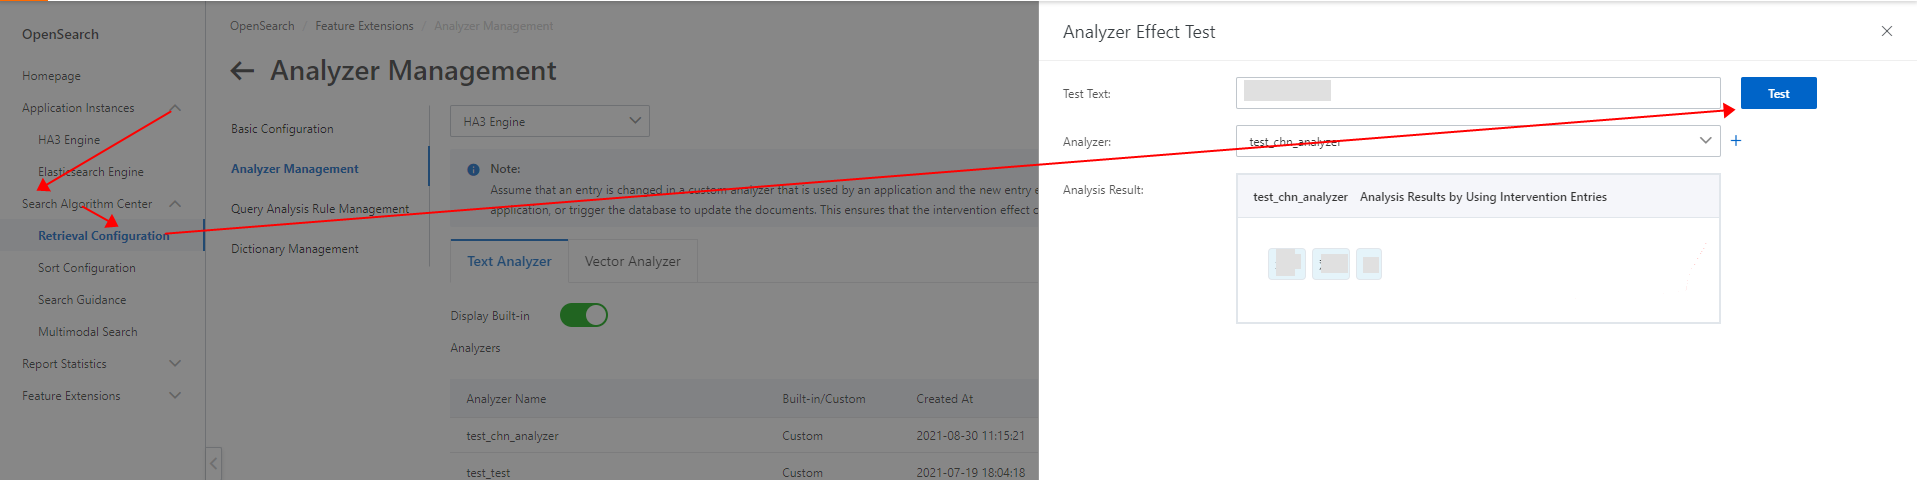
Utilisez la fonctionnalité de test d'analyse pour vérifier les résultats des analyseurs sectoriels et personnalisés. Dans la console de l'application, accédez à la liste des applications et choisissez Search Algorithm Center > Retrieval Configuration > Analyzer Management > Tokenization Test, comme illustré dans la figure suivante.
Unités de recherche étendues
Au niveau de la granularité de la recherche, un analyseur génère deux types de termes de recherche : les unités de recherche de base et les unités de recherche étendues. Les unités de recherche de base sont les résultats normaux de la tokenisation. Les unités de recherche étendues sont des termes supplémentaires dérivés des unités de recherche de base : d'autres façons valides de segmenter le même texte. Par exemple, pour une phrase chinoise signifiant « chaussures de basket », les unités de recherche de base sont le mot chinois pour « basket » et le mot chinois pour « chaussure », tandis que le mot chinois pour « chaussures de sport » est une unité de recherche étendue. La production d'unités de recherche étendues par un analyseur dépend de la configuration de son dictionnaire interne.
Dans la boîte de dialogue Analyzer Effect Test, activez l'option Extended Retrieval Units et cliquez sur Test pour afficher à la fois les unités de recherche de base et étendues. Lorsque l'option est désactivée, seules les unités de recherche de base apparaissent. Utilisez cette comparaison pour vérifier si la tokenisation a produit des unités de recherche étendues et pour investiguer les résultats de tokenisation inattendus. Cette option n'affecte que l'affichage des résultats de test et n'a aucun impact sur la recherche réelle.
Option désactivée : Dans les gloses anglaises, le résultat d'analyse d'une phrase chinoise signifiant « chaussures de basket » est
basketball, shoe.Option activée : Dans les gloses anglaises, le résultat d'analyse d'une phrase chinoise signifiant « chaussures de basket » est
basketball, athletic shoes, shoe, où le mot chinois pour « chaussures de sport » est une unité de recherche étendue.
Les unités de recherche de base et étendues sont affichées ensemble dans le même style dans les résultats d'analyse. La console ne les distingue pas visuellement. L'option n'affecte que les résultats de test et revient à l'état désactivé lorsque vous fermez la boîte de dialogue.
Les unités de recherche étendues peuvent produire des résultats de tokenisation inattendus. Par exemple, un nom de marque complet peut être divisé en caractères individuels. Dans ce cas, utilisez les Analyseurs de texte personnalisés pour ajouter un terme d'intervention et conserver la phrase pertinente intacte.
Scénarios applicables
Pour les recherches en chinois dans des contextes sémantiques, utilisez un analyseur sémantique chinois.
Pour les textes courts ou les recherches en chinois sans contexte sémantique où le classement est moins important, utilisez l'analyseur chinois mono-caractère pour élargir le rappel.
Pour les recherches en pinyin, utilisez l'analyseur flou.
Pour les recherches en anglais, utilisez l'analyseur avec racinisation pour l'anglais.
Dans certains scénarios, la combinaison de l'analyseur sémantique chinois et de l'analyseur mono-caractère améliore les résultats de recherche. Par exemple, utilisez
query=title_index:'{terme chinois}' OR sws_title_index:'{terme chinois}'avec l'expression de classement fintext_relevance(title)*5+field_proximity(sws_title). Remplacez{terme chinois}par la même phrase chinoise dans les deux clauses. Cela permet de récupérer des documents contenant les caractères du terme avec d'autres caractères entre eux, tout en classant plus haut les documents contenant la phrase exacte.
Notes d'utilisation
-
Types de champs pouvant être utilisés comme champs d'index
INT, INT_ARRAY, TEXT, SHORT_TEXT, LITERAL, LITERAL_ARRAY, TIMESTAMP, GEO_POINT
Types de champs ne pouvant pas être utilisés comme champs d'index
FLOAT, FLOAT_ARRAY, DOUBLE, DOUBLE_ARRAY
Si un résumé de résultat de recherche est configuré pour un champ TEXT, certaines phrases des unités de recherche étendues (voir Unités de recherche étendues), telles que la phrase chinoise signifiant « thé aux fleurs » dans l'exemple précédent, ne sont pas mises en surbrillance dans les résultats de recherche.
L'analyseur chinois mono-caractère traite les nombres et les mots anglais comme un seul token. Par exemple, une recherche pour « hello » peut récupérer « hello word », mais une recherche pour « he » ne le peut pas. Utilisez l'analyseur flou pour les correspondances au sein d'un mot.
La clé primaire de la table principale dans le schéma d'application est définie par défaut comme un champ d'index nommé « id ». Ce paramètre ne peut pas être modifié.