Cette rubrique présente la fonctionnalité de prédiction de catégorie, ses principes de base et son utilisation pour vous aider à la comprendre et à l'utiliser rapidement.
Résultats
Concept clé
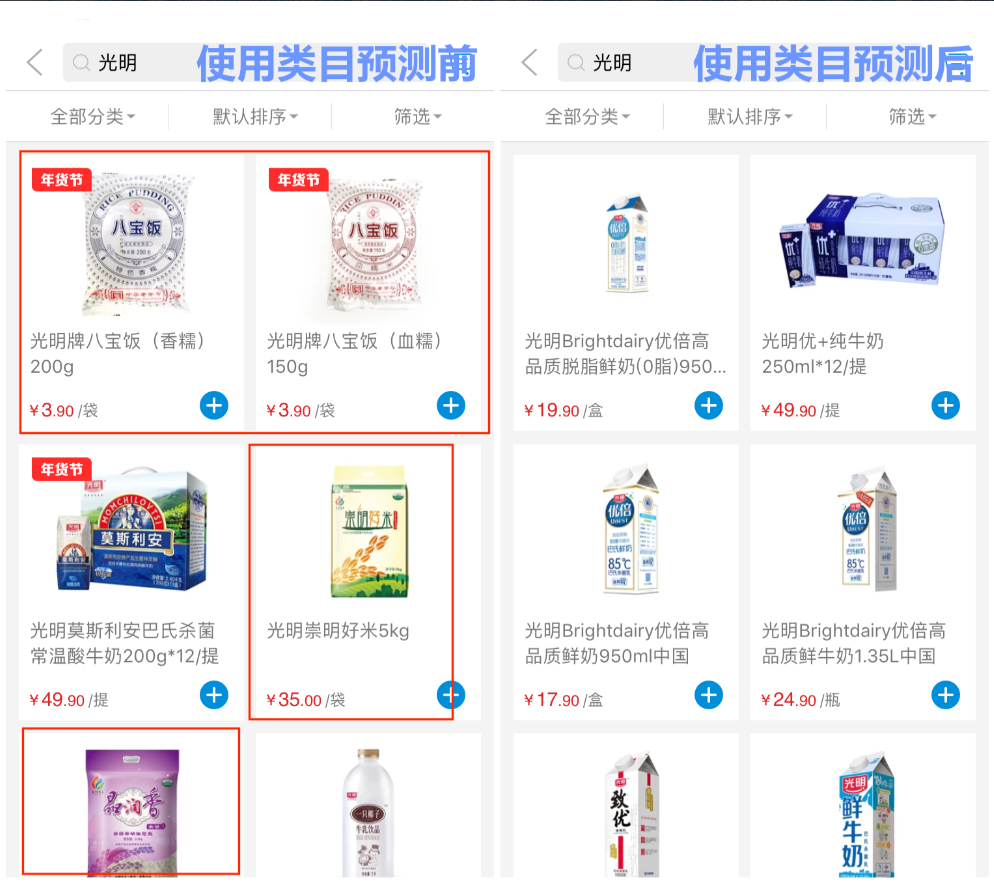
La prédiction de catégorie classe les résultats en calculant la pertinence entre la requête de recherche d'un utilisateur et les catégories de produits. Les produits appartenant à des catégories plus pertinentes obtiennent un score de classement plus élevé et apparaissent en tête des résultats de recherche.
Exemple :
Prenons l'exemple d'un utilisateur qui recherche « Bright » et obtient une liste de produits. Certains appartiennent à la catégorie « Milk » et d'autres à la catégorie « Rice ». Selon les données historiques de comportement de recherche, les utilisateurs qui recherchent « Bright » cliquent beaucoup plus souvent sur des produits de la catégorie « Milk » que sur ceux de la catégorie « Rice ». Le modèle de prédiction de catégorie en déduit que la catégorie « Milk » est plus pertinente pour « Bright » que la catégorie « Rice ». Par conséquent, lors du calcul du score de classement, les produits de la catégorie « Milk » obtiennent un score supérieur à ceux de la catégorie « Rice ». Ils sont ainsi mieux classés, ce qui augmente la valeur commerciale de la recherche.
Principes de base de la prédiction de catégorie
La prédiction de catégorie vise à évaluer la pertinence entre une requête de recherche et une catégorie. Elle s'appuie sur des données historiques de requêtes, des données comportementales de clics et des informations produit pour chaque catégorie. Le système collecte les requêtes précédemment effectuées, les croise avec les données de clics post-recherche et les associe aux informations produit de chaque catégorie afin de caractériser les modèles de données liant les requêtes aux catégories.
L'entraînement d'un modèle nécessite une source de données. Avant de créer un modèle de prédiction de catégorie, vous devez l'associer à une application. Une fois l'application associée, définissez les trois types de données suivants requis pour l'entraînement :
Toutes les requêtes recherchées dans l'application. Ajoutez le paramètre
raw_queryaux requêtes de recherche.Données de catégorie et données produit. Spécifiez ces champs depuis l'application lors de la préparation de l'entraînement. Vous devez au minimum indiquer le champ ID de catégorie et le champ titre du produit.
Données comportementales de clics de l'application. Plus les données comportementales transmises sont complètes et de qualité, plus les caractéristiques du modèle sont riches et meilleurs sont les résultats.
La fonctionnalité de prédiction de catégorie OpenSearch prend en charge l'entraînement de modèles avec ou sans données comportementales.
L'entraînement avec données comportementales s'applique lorsque ces dernières ont été chargées. Avant le début de l'entraînement, une vérification automatique garantit que la quantité, la qualité et l'intégrité des données répondent aux exigences. L'entraînement du modèle comprend les étapes suivantes :
Échantillonnez les requêtes historiques et les informations de catégorie pour générer des données d'échantillonnage, puis étiquetez-les à l'aide des données comportementales.
Calculez les statistiques de métriques et les caractéristiques sur les données comportementales pour générer des caractéristiques de comportement de clic.
Associez les requêtes aux titres de produits de chaque catégorie, tokenisez les requêtes et les titres, puis calculez les caractéristiques sémantiques entre le texte de la requête et celui du titre du produit.
Si des données comportementales de transaction sont chargées, calculez les statistiques de métriques et les caractéristiques correspondantes pour générer des caractéristiques de transaction. Les produits ayant de meilleures performances de transaction seront ainsi mieux classés.
Combinez les données d'échantillonnage générées ci-dessus avec les caractéristiques comportementales, sémantiques, de transaction et les étiquettes pour former les données d'entraînement, puis alimentez l'algorithme pour un entraînement itératif.
Une fois l'entraînement terminé, vous obtenez un modèle décrivant la pertinence entre les requêtes et les catégories dans les échantillons. Utilisez ce modèle pour prédire la pertinence entre une requête et une catégorie.
Lors de l'entraînement d'un modèle de prédiction de catégorie avec l'option « données comportementales » sélectionnée, une requête doit avoir enregistré plus d'un clic sur une catégorie associée au cours des 14 derniers jours.
L'entraînement sans données comportementales s'applique aux scénarios où aucune donnée comportementale n'a été chargée ou lorsque celles-ci sont de faible qualité. Il suffit de spécifier le champ ID de catégorie et le champ titre du produit dans l'application pour lancer l'entraînement. En l'absence de données comportementales, il est impossible d'étiqueter les échantillons ; un autre type d'algorithme est donc utilisé. Il calcule la pertinence sémantique entre le texte de la requête et celui du titre du produit uniquement sur la base des données textuelles des requêtes et des titres de produits après tokenisation, puis en déduit la pertinence entre les requêtes et les catégories.
Un modèle utilisant des données comportementales offre de meilleures performances qu'un modèle n'en utilisant pas. Plus les caractéristiques d'entraînement sont riches, plus le modèle caractérise exhaustivement les modèles de données entre les requêtes et les catégories, et plus ses prédictions sont précises.
Que le modèle utilise ou non des données comportementales, le processus d'entraînement a fait l'objet de nombreuses expérimentations sur des données provenant de différents scénarios et d'un réglage minutieux des paramètres afin de garantir des résultats conformes aux attentes.
Utilisation de la prédiction de catégorie
Prérequis
L'entraînement du modèle nécessite une source de données. Vous devez associer une application avant d'entraîner un modèle. Les données de l'application, les données de requête et les données comportementales de l'application sont toutes requises par le modèle de prédiction de catégorie.
Si vous n'avez pas chargé de données comportementales de clics, si vous ne souhaitez pas les utiliser pour l'entraînement ou si elles ne remplissent pas encore les conditions requises, vous pouvez entraîner le modèle sans ces données. Dans ce cas, le modèle de prédiction de catégorie doit sélectionner les données pour trois champs dans l'application : Category ID, Commodity Title et Category Name. Les champs Category ID et Commodity Title sont obligatoires, tandis que Category Name est facultatif. Une fois l'entraînement terminé, le modèle génère des résultats de prédiction partiels pour évaluation. Le champ Category Name sert sur la page d'évaluation des résultats à vérifier si la pertinence entre les requêtes et les catégories répond aux attentes ; nous vous recommandons donc de le fournir lors de l'entraînement.
Si des données comportementales de clics ont été chargées, vous pouvez également choisir d'associer ces données lors de l'entraînement du modèle, en plus des champs mentionnés ci-dessus. Si les données comportementales remplissent les conditions d'entraînement, elles sont utilisées pour entraîner le modèle.
Procédure
Créez un modèle de prédiction de catégorie sous une application.
Appliquez le modèle de prédiction de catégorie : appliquez d'abord le modèle dans l'analyse des requêtes, puis activez-le dans le tri de base et le tri métier.
Créez une analyse de requête, configurez la prédiction de catégorie et sélectionnez le modèle créé à l'étape 1.
Activez le modèle de prédiction de catégorie dans les requêtes : appelez l'API de requête via le SDK et transmettez le paramètre
raw_query.
Pour la procédure détaillée, consultez Utilisation de la fonctionnalité de prédiction de catégorie.