L'utilisation des IOPS est une métrique critique pour les instances MongoDB. Lorsqu'elle atteint ou approche les 100 %, les réponses de l'application ralentissent et les services peuvent devenir indisponibles. Cette rubrique explique comment vérifier l'utilisation des IOPS, identifie les causes courantes d'une utilisation élevée et propose des stratégies d'optimisation.
Informations générales
Les fournisseurs de bases de données cloud utilisent généralement des technologies telles que cgroups (Control Groups) pour appliquer l'isolation des E/S et limiter les IOPS (Input/Output Operations Per Second) par instance, évitant ainsi la contention des E/S sur les hôtes partagés. Chaque type d'instance possède donc une capacité maximale d'IOPS spécifique.
Remarques importantes
Les métriques Utilisation des IOPS et Taux d'utilisation des IOPS ne sont pas disponibles pour les instances autonomes, ni pour les instances de jeu de réplicas ou de cluster fragmenté exécutant MongoDB 4.2 avec des disques cloud.
Pour ces instances, la page Monitoring Information de la console ApsaraDB for MongoDB affiche toujours la valeur 0 pour les métriques IOPS Usage et IOPS Usage. Cette valeur ne reflète pas les données réelles des IOPS.
Vérification de l'utilisation des IOPS
Vérifiez l'utilisation des IOPS à l'aide des graphiques de surveillance ou en exécutant des commandes.
Connectez-vous à la console ApsaraDB for MongoDB. Dans la page Basic Information , section Specification Information , consultez les IOPS maximales de l'instance. Pour connaître les limites d'IOPS des différents types d'instances, reportez-vous à la rubrique Types d'instances .
Connectez-vous à la console ApsaraDB for MongoDB. Sur la page Monitoring Information , vérifiez les métriques IOPS Usage et IOPS Usage afin de déterminer si l'instance approche sa limite d'IOPS. Pour plus d'informations sur les métriques liées aux IOPS, consultez la rubrique Métriques .
Causes courantes des problèmes d'E/S
Une utilisation élevée des E/S disque sur une instance MongoDB résulte généralement des facteurs suivants :
Mémoire insuffisante : les performances d'E/S dépendent fortement de la taille du cache WiredTiger. Un cache plus volumineux conserve davantage de données fréquemment utilisées, ce qui réduit les E/S disque et diminue le risque de goulots d'étranglement. À l'inverse, un cache plus petit oblige le système à vider plus fréquemment les pages modifiées vers le disque, augmentant ainsi la pression sur les E/S.
Configuration inappropriée : parmi les problèmes de configuration susceptibles de provoquer une utilisation élevée des E/S figurent la vidange fréquente du journal ou des journaux d'exécution, un niveau de Write Concern inefficace, ou des erreurs moveChunk dans un cluster fragmenté.
Stratégies d'optimisation pour les problèmes d'E/S
Pour résoudre les problèmes d'E/S sur une instance ApsaraDB for MongoDB, choisissez un type d'instance adapté, optimisez les index et affinez les modèles d'écriture de vos applications.
-
Sélectionnez un type d'instance approprié
Il est souvent difficile de prédire le ratio idéal entre les données fréquemment utilisées et la taille du cache avant le déploiement. En règle générale, choisissez un type d'instance qui répond à vos besoins métier tout en maintenant l'utilisation quotidienne du processeur et des IOPS en dessous de 50 % lors des pics.
-
Optimisez les index
Les analyses complètes de table et les requêtes utilisant des index inefficaces consomment considérablement les ressources d'E/S. Par exemple, l'exportation d'une collection entière peut provoquer un pic d'E/S. Une indexation excessive augmente également la taille des données sur le disque, réduisant ainsi la quantité de données fréquemment utilisées que le cache WiredTiger peut contenir. Chaque opération d'écriture nécessite des E/S supplémentaires pour mettre à jour les index, ce qui dégrade encore les performances. Créez des index adaptés à vos modèles de requête pour atténuer ces problèmes.
-
Optimisez l'architecture et les opérations de votre application
Pour éviter que les E/S disque ne deviennent un goulot d'étranglement au niveau de l'application, envisagez les optimisations suivantes :
-
Contrôlez les threads d'écriture et de lecture simultanés
MongoDB est une application multithread. Un nombre élevé d'écritures simultanées ou de requêtes complexes peut provoquer des goulots d'étranglement au niveau des E/S et un décalage de réplication persistant sur les nœuds secondaires. Si un volume d'écriture élevé cause des goulots d'étranglement au niveau des E/S, envisagez de passer à un cluster fragmenté pour augmenter linéairement les performances d'écriture en distribuant les données horizontalement.
-
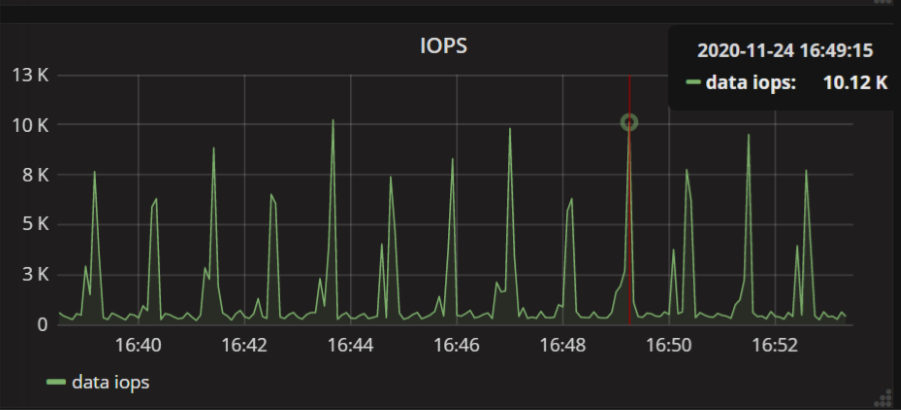
Évitez autant que possible les pics d'écriture
Certaines applications effectuent des écritures périodiques ou une persistance de données en masse, provoquant des pics d'IOPS. Si l'instance actuelle ne peut pas gérer ces charges de pointe, répartissez les opérations d'écriture de manière plus uniforme. Par exemple, ajoutez un petit délai aléatoire à chaque opération d'écriture par lot.
-
Évitez d'effectuer des opérations de maintenance pendant les heures de pointe
Certaines opérations de maintenance peuvent avoir un impact significatif sur les performances et provoquer des pics d'IOPS. Planifiez ces opérations pendant les heures creuses dans la mesure du possible. Les opérations générant un volume élevé d'E/S incluent les modifications de données par lots (écritures, mises à jour et suppressions), la création d'index, les compactations de collections et les exports de données en masse.
-