MaxCompute Spark accède à Alibaba Cloud Object Storage Service (OSS) via le kit de développement logiciel (SDK) Jindo. Le Jindo SDK est un client OSS haute performance conçu pour l'écosystème Hadoop et Spark. Il fournit une implémentation Hadoop FileSystem hautement optimisée pour Alibaba Cloud OSS.
Étape 1 : Configurer la classe d'implémentation OSS et l'endpoint
Utilisez l'endpoint public correspondant à la région en mode local. En mode cluster, utilisez l'endpoint interne. Pour plus d'informations, consultez la rubrique Régions et endpoints.
-
Spark 3.5+ (intègre JindoSDK 6.5 par défaut). Ajoutez les configurations suivantes :
spark.hadoop.fs.AbstractFileSystem.oss.impl=com.aliyun.jindodata.oss.JindoOSS spark.hadoop.fs.oss.impl=com.aliyun.jindodata.oss.JindoOssFileSystem spark.hadoop.fs.oss.endpoint=oss-${RegionId}-internal.aliyuncs.com -
Autres versions (si vous utilisez JindoSDK 3.7). Ajoutez les configurations suivantes :
spark.hadoop.fs.AbstractFileSystem.oss.impl=com.aliyun.emr.fs.oss.OSS
spark.hadoop.fs.oss.impl=com.aliyun.emr.fs.oss.JindoOssFileSystem
spark.hadoop.fs.oss.endpoint=oss-${RegionId}-internal.aliyuncs.com
Étape 2 : Configurer les informations d'authentification
Choisissez l'une des deux méthodes d'authentification suivantes.
Méthode 1 : Utiliser un AccessKey ID et un AccessKey secret
Ajoutez les éléments de configuration suivants au fichier spark-defaults.conf ou à votre configuration DataWorks :
spark.hadoop.fs.oss.accessKeyId=${AccessId}
spark.hadoop.fs.oss.accessKeySecret=${AccessKey}
Méthode 2 : Utiliser un jeton Security Token Service
Pour plus d'informations, consultez la rubrique Autoriser l'accès en mode STS. Ensuite, ajoutez les éléments de configuration suivants.
Configuration pour Spark 3.5+
## Add the following configuration items to the spark-defaults.conf file or your DataWorks configuration:
spark.hadoop.fs.oss.credentials.provider=com.aliyun.jindodata.oss.auth.CustomCredentialsProvider
spark.hadoop.aliyun.oss.provider.url=http://localhost:10011/sts-token-info?user_id=${AliyunUid}&role=${RoleName}
Configuration pour les autres versions
## Add the following configuration items to the spark-defaults.conf file or your DataWorks configuration:
spark.hadoop.odps.cupid.http.server.enable=true
spark.hadoop.fs.jfs.cache.oss.credentials.provider=com.aliyun.emr.fs.auth.CustomCredentialsProvider
spark.hadoop.aliyun.oss.provider.url=http://localhost:10011/sts-token-info?user_id=${AliyunUid}&role=${RoleName}
Étape 3 : Référencer la dépendance JindoSDK (ignorez cette étape pour Spark 3.5+)
-
Mode local
En mode local, téléchargez le JindoSDK et ajoutez-le au classpath.
-
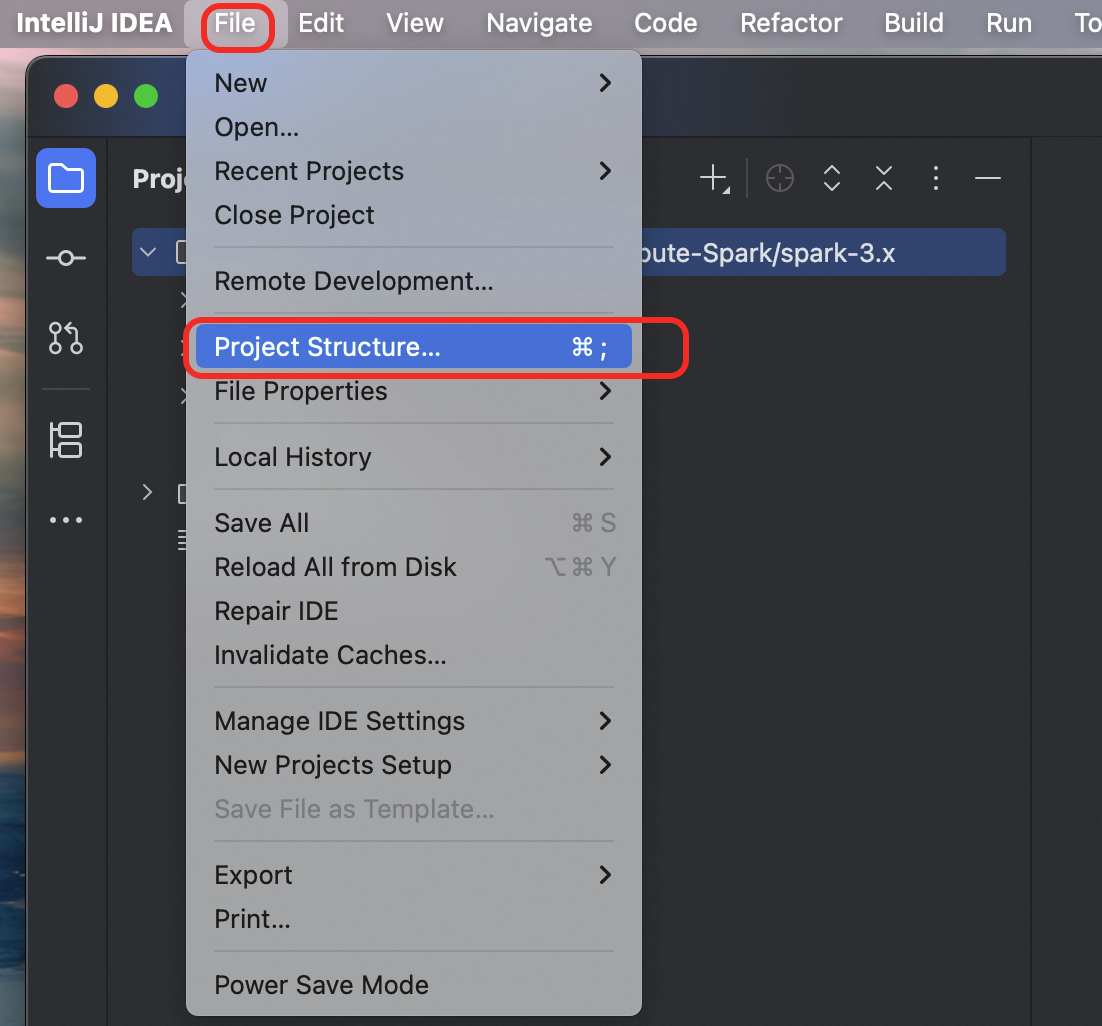
Accédez à File > Project Structure.
-
Dans le volet de navigation de gauche, sélectionnez
Modules, cliquez sur l'icône+, puis sélectionnezJARs or Directories.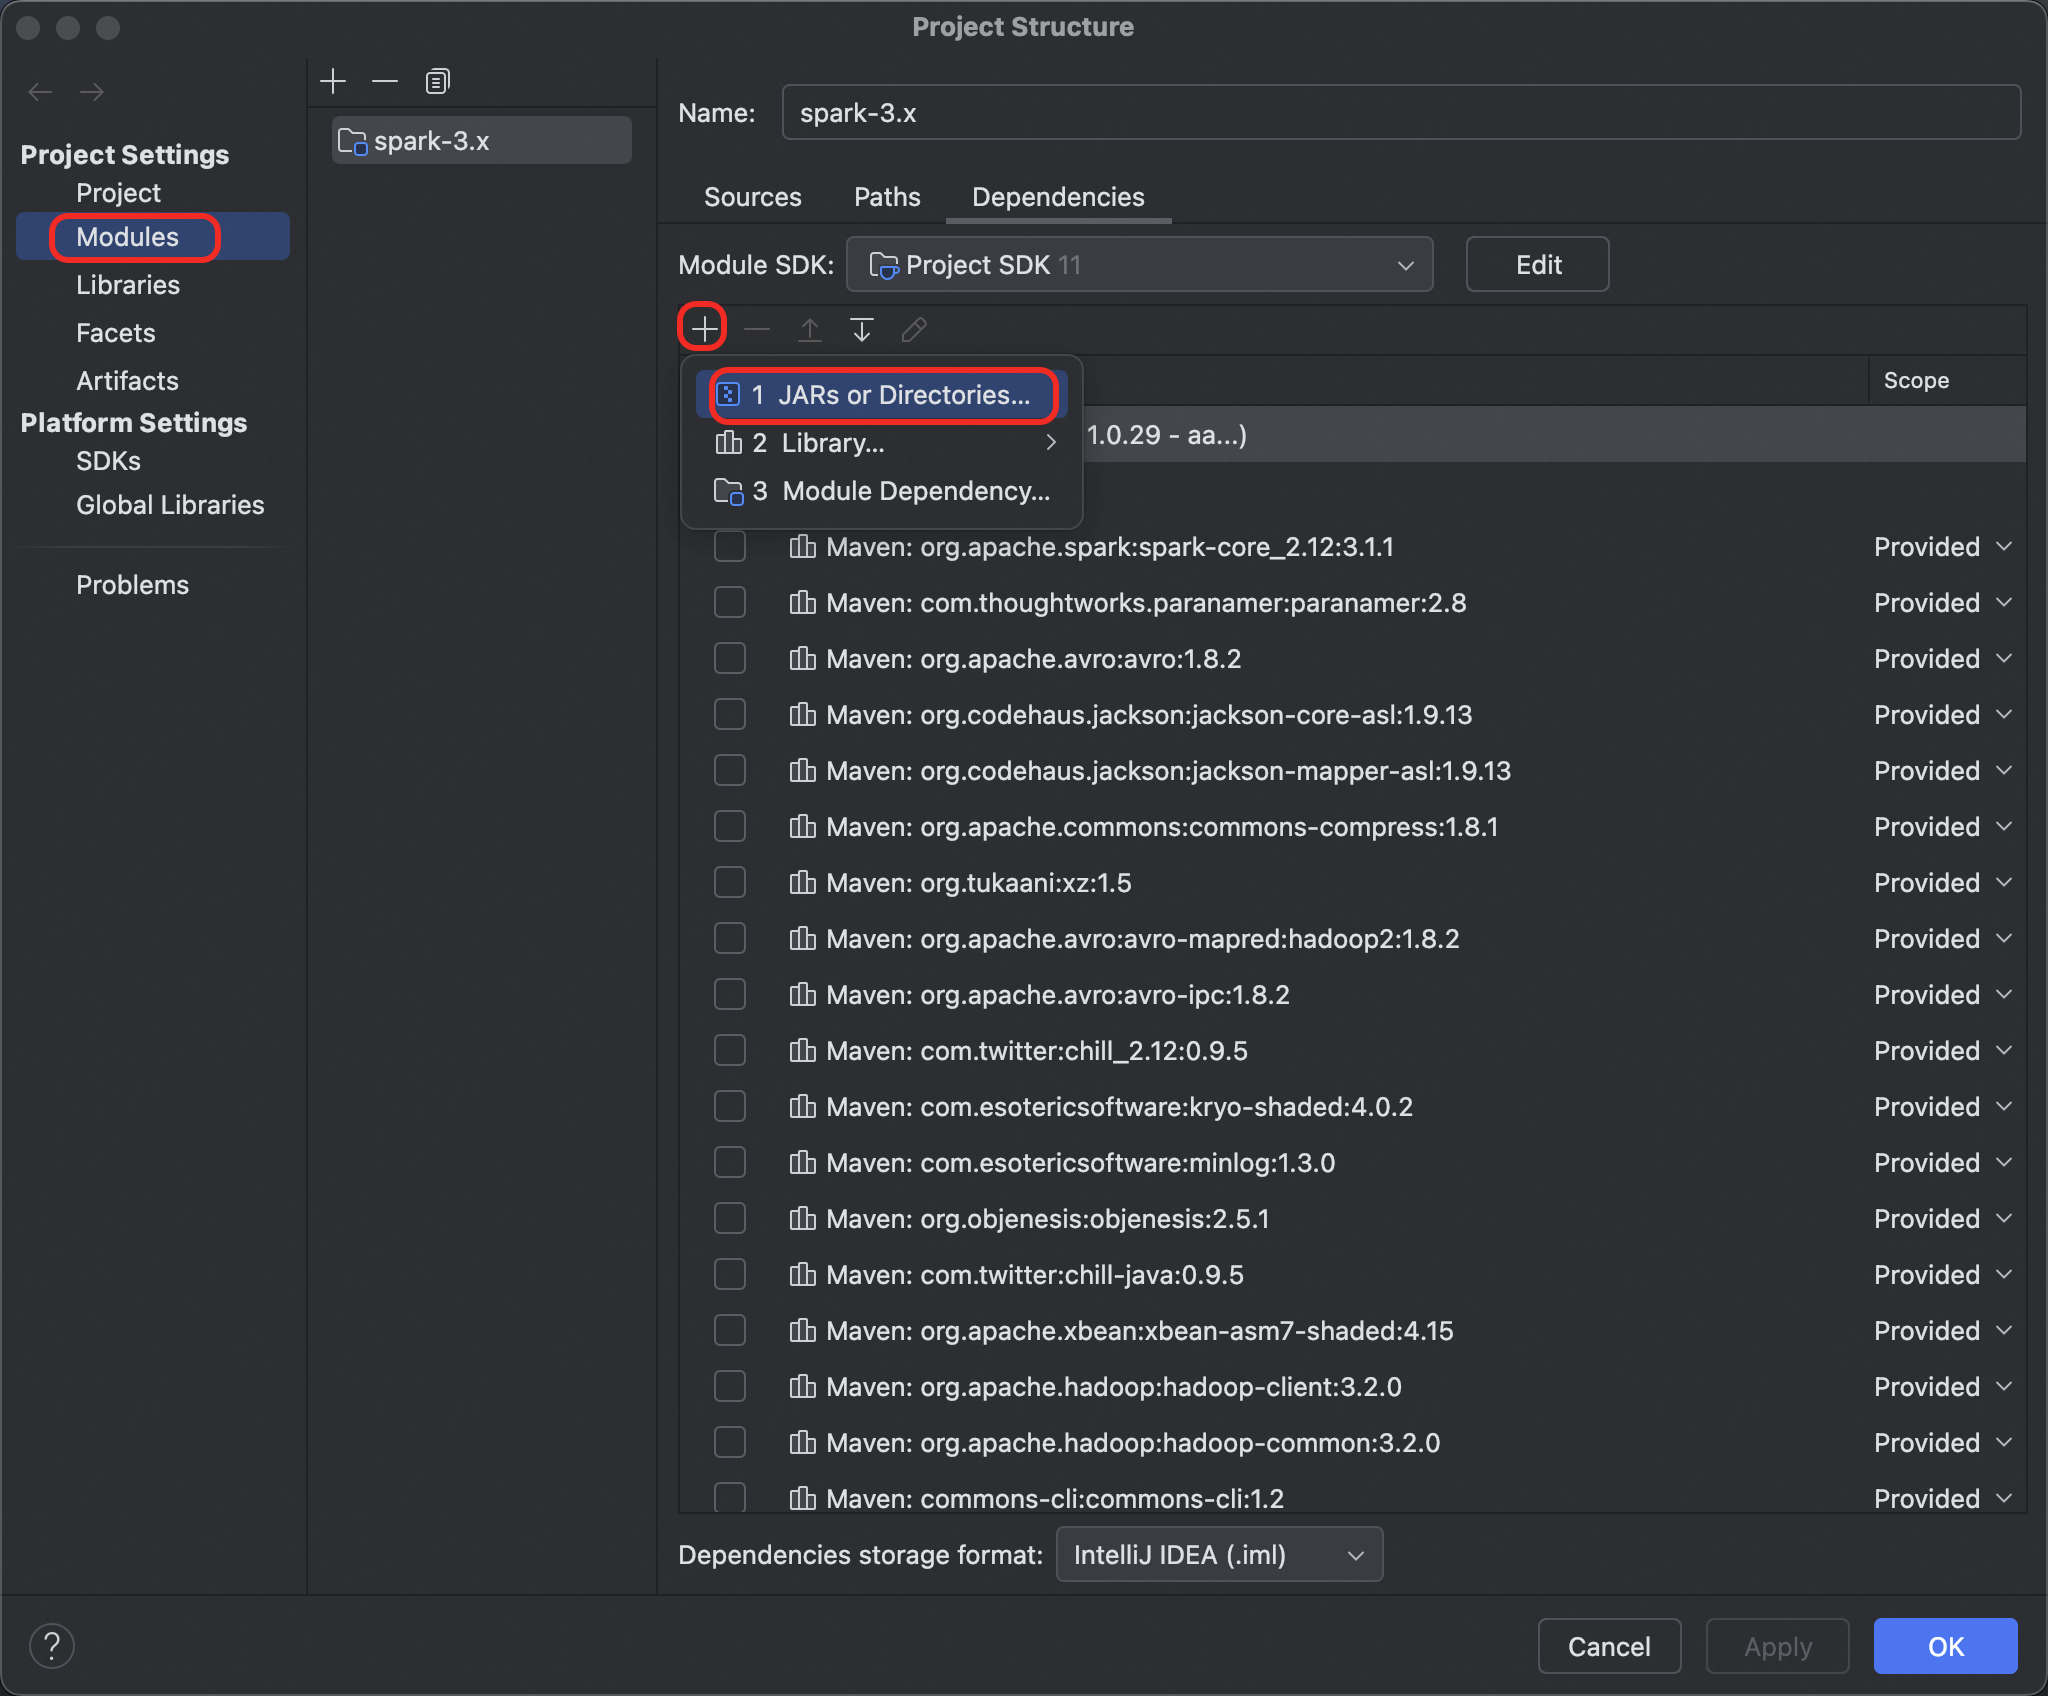
Ajoutez tous les fichiers JAR du dossier
libde JindoSDK.Dans IDEA, cliquez sur OK.
-
-
Mode cluster
Pour Spark 3.5, le Jindo SDK est inclus côté serveur. Aucune action n'est requise.
-
Pour les autres versions, modifiez le fichier
spark-defaults.conf. Ajoutez l'élément de configuration suivant pour utiliser les ressources publiques :spark.hadoop.odps.cupid.resources = public.jindofs-sdk-3.7.2.jar ## Note: To use a different version of the JindoSDK, download the corresponding SDK version, upload it to your project, and then reference it using spark.hadoop.odps.cupid.resources.
Étape 4 : Configurer la liste d'autorisation réseau
Par défaut, l'accès est direct sans configuration supplémentaire.
-
En mode cluster, si vous ne parvenez pas à accéder à OSS, ajoutez le nom de domaine du bucket cible à la liste d'autorisation du job en ajoutant l'élément de configuration suivant au fichier
spark-defaults.confou à votre configuration DataWorks :spark.hadoop.odps.cupid.trusted.services.access.list=${BucketName}.oss-${RegionId}-internal.aliyuncs.com
Étape 5 : Soumettre le job
./bin/spark-submit --class xxx spark-app.jar