Cette rubrique présente les concepts de base, l'utilisation et les limites du service Information Schema pour MaxCompute.
Le service Information Schema de MaxCompute fournit des métadonnées de projet et un historique d'utilisation. Il étend le schéma d'information ANSI SQL-92 avec des champs et des vues spécifiques au service MaxCompute. Vous pouvez interroger les vues en lecture seule du projet public Information Schema pour récupérer les métadonnées et l'historique d'utilisation de vos projets.
Limites
Information Schema propose une vue des métadonnées limitée au projet actuel et ne prend pas en charge l'accès aux métadonnées interprojets. Pour interroger et analyser les métadonnées de plusieurs projets, récupérez les métadonnées de chaque projet, puis consolidez-les.
Les tables système de métadonnées offrent une vue en quasi temps réel. Pour les applications nécessitant des métadonnées extrêmement à jour, utilisez le SDK ou la CLI pour récupérer directement les métadonnées d'objets spécifiques.
Les métadonnées et l'historique des tâches sont stockés dans Information Schema. Pour créer des sauvegardes instantanées ou conserver l'historique des tâches au-delà de 14 jours, sauvegardez périodiquement les données d'Information Schema dans un projet.
Activer Information Schema
À partir du 1er mars 2024, MaxCompute n'installe plus automatiquement le schéma d'information au niveau du projet pour les nouveaux projets. Si vous devez interroger des métadonnées, vous pouvez interroger le schéma d'information au niveau du locataire pour obtenir des informations plus complètes. Pour plus d'informations sur l'utilisation du schéma d'information au niveau du locataire, reportez-vous à la section Schéma d'information au niveau du locataire.
Pour les projets MaxCompute existants, le propriétaire du projet ou un utilisateur RAM disposant du rôle Super_Administrator doit installer le package d'autorisations Information Schema afin d'accéder aux métadonnées du projet. Pour plus d'informations sur l'attribution d'un rôle de gestion à un utilisateur, consultez la section Attribuer un rôle à un utilisateur. Vous pouvez installer le package de l'une des manières suivantes :
-
Connectez-vous au client MaxCompute et exécutez la commande suivante :
install package Information_Schema.systables; -
Connectez-vous à la console DataWorks et accédez à la page Ad Hoc Query. Pour plus d'informations, consultez la section Utiliser une requête ad hoc pour exécuter des instructions SQL (facultatif). Exécutez la commande suivante :
install package Information_Schema.systables;
L'installation du package accorde au projet actuel l'autorisation d'interroger ses métadonnées via Information Schema. Ces données sont stockées dans le projet Information Schema et leur stockage est gratuit.
Exécutez la commande suivante pour répertorier les vues fournies par Information Schema.
odps@myproject1> describe package Information_Schema.systables;La figure suivante illustre le résultat de la requête.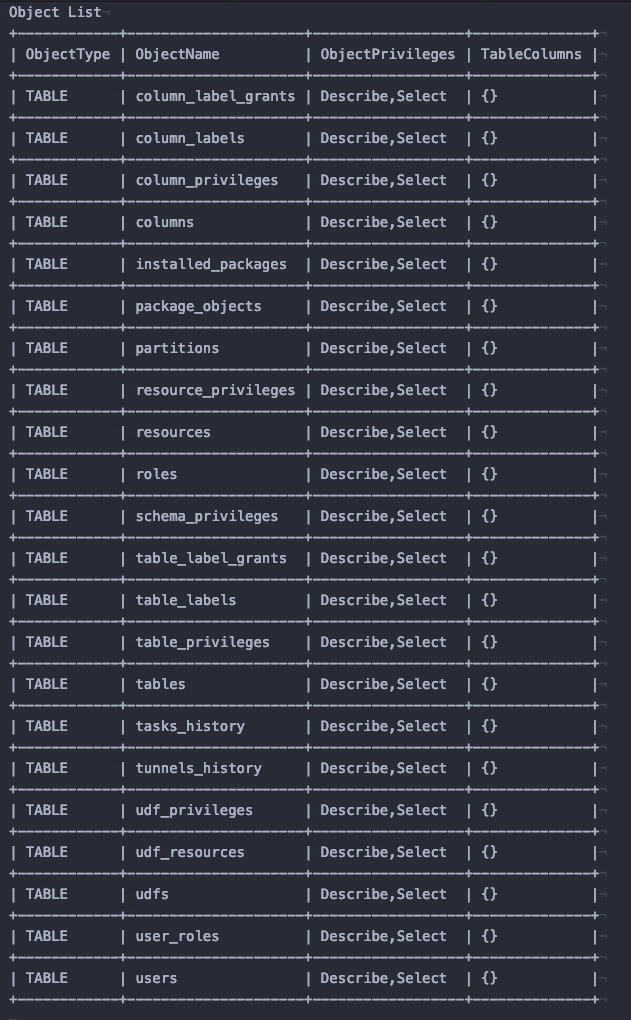
Interroger les vues de métadonnées
Pour interroger une vue de métadonnées, préfixez le nom de la vue avec le schéma d'information du projet, par exemple Information_Schema.view_name.
Par exemple, pour interroger les métadonnées de toutes les tables du projet myproject1, exécutez la commande suivante.
odps@myproject1>select * from Information_Schema.tables;Information Schema inclut également des vues d'historique des tâches permettant d'interroger l'historique des tâches dans le projet actuel. Vous pouvez ajouter une partition de date pour filtrer les résultats.
odps@myproject1>select * from Information_Schema.tasks_history where ds='yyyymmdd' limit 100;Autorisation
Les vues d'Information Schema contiennent toutes les données utilisateur au niveau du projet. Par défaut, le propriétaire du projet peut consulter ces données. Si d'autres utilisateurs ou rôles doivent y accéder, ils doivent être autorisés. Pour plus d'informations, consultez la section Accéder aux ressources entre projets à l'aide d'un package.
La syntaxe d'octroi d'autorisation est la suivante :
grant <actions> on package Information_Schema.systables to user <user_name>;
grant <actions> on package Information_Schema.systables to role <role_name>;
actions : l'autorisation à accorder. La valeur doit être read.
-
user_name : un compte Alibaba Cloud ou un utilisateur RAM dans le projet.
Vous pouvez exécuter la commande
list users;dans le client MaxCompute pour répertorier les comptes utilisateur. -
role_name : un rôle dans le projet.
Vous pouvez exécuter la commande
list roles;dans le client MaxCompute pour répertorier les noms de rôle.
Exemple :
grant read on package Information_Schema.systables to user RAM$Bob@aliyun.com:user01;Vues de métadonnées
Utilisez les vues de métadonnées Information_Schema pour interroger les métadonnées.
Exploitez les vues d'information d'Information_Schema pour analyser des métriques telles que la consommation de ressources, la durée d'exécution et le volume de données traitées, afin d'optimiser les tâches ou de planifier la capacité des ressources.
Chaque vue possède une période de rétention spécifique, au-delà de laquelle ses données deviennent inaccessibles. Pour conserver les données historiques plus longtemps, exportez-les périodiquement depuis Information_Schema vers une table locale.
Les règles de facturation suivantes s'appliquent :
Pour les projets utilisant des ressources de calcul en paiement à l'utilisation, les interrogations des vues Information Schema entraînent des frais basés sur le volume de données analysées. Pour améliorer les performances des requêtes, ces vues sont optimisées avec des
range clustered tablesafin de réduire le volume de données analysées. Pour minimiser les données analysées et réduire les coûts lors de l'interrogation des vues TASKS_HISTORY et TUNNELS_HISTORY, interrogez les données de la veille après 06:00:00 et évitez d'interroger les données du jour en cours.Pour les projets utilisant des ressources de calcul par abonnement, les interrogations des vues Information Schema consomment les CU que vous avez achetés.
Les vues Information Schema n'engendrent aucun frais de stockage.
Lors de l'exportation des données, sélectionnez explicitement les noms de colonnes de la vue. Évitez d'utiliser insert into select * from information_schema.*** pour prévenir les échecs de sauvegarde lors de l'ajout de nouvelles colonnes.
Ce tableau répertorie les vues de métadonnées.
Catégorie | Vue | Actualité et rétention | Latence |
Informations de métadonnées | Vue en quasi temps réel | Les données de ces vues présentent un décalage d'environ 3 heures par rapport aux données en ligne. | |
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Vue en quasi temps réel | |||
Informations d'utilisation | Un snapshot en temps réel des tâches en cours d'exécution. | Cette vue présente une latence de l'ordre de la seconde. En tant que fonctionnalité Preview, elle n'est pas couverte par un SLA et son déploiement est progressif. | |
Une table partitionnée en quasi temps réel qui conserve les détails des 14 derniers jours. | Les données de ces vues présentent une latence d'environ 3 heures. | ||
Une table partitionnée en quasi temps réel qui conserve les détails des 14 derniers jours. |
Tables
Fournit des détails sur les tables d'un projet.
Colonne | Type de données | Description |
table_catalog | STRING | La valeur est fixée à |
table_schema | STRING | Le nom du projet. |
table_name | STRING | Le nom de la table. |
table_type | STRING | Le type de table. Les valeurs valides sont :
|
is_partitioned | BOOLEAN | Indique si la table est partitionnée. |
owner_id | STRING | L'ID du propriétaire de la table. |
owner_name | STRING | Facultatif. Le nom du compte Alibaba Cloud du propriétaire de la table. |
create_time | DATETIME | L'heure de création de la table. |
last_modified_time | DATETIME | L'heure de la dernière modification des données de la table. |
data_length | BIGINT | Pour une table non partitionnée, il s'agit de la taille des données de la table. Pour une table partitionnée, cette valeur est NULL car MaxCompute ne calcule pas la taille totale de la table. Vous pouvez trouver la taille des données pour chaque partition dans la vue PARTITIONS. Unité : octet. |
table_comment | STRING | Le commentaire de la table. |
life_cycle | BIGINT | Facultatif. Le cycle de vie de la table. |
is_archived | BOOLEAN | Réservé pour une utilisation future. |
table_exstore_type | STRING | Réservé pour une utilisation future. |
cluster_type | STRING | Le type de clustering de la table MaxCompute. Les valeurs valides sont HASH ou RANGE. |
number_buckets | BIGINT | Facultatif. Le nombre de buckets dans une table clusterisée. Une valeur de 0 signifie que MaxCompute détermine le nombre de buckets au moment de l'exécution. |
view_original_text | STRING | Pour les tables de type VIRTUAL_VIEW, cette colonne contient l'instruction SQL qui définit la vue. |
La console MaxCompute ne permet pas de trier les tables par taille. Pour interroger et trier les tables par taille ou gérer l'espace de stockage, exécutez des requêtes SQL sur le schéma d'information. Avant d'exécuter les requêtes, activez la prise en charge du schéma avec la commande suivante :
SET odps.namespace.schema=true;-
Interrogez la taille des tables non partitionnées et triez-les par ordre décroissant :
SELECT * FROM SYSTEM_CATALOG.INFORMATION_SCHEMA.Tables ORDER by data_length DESC; -
Interrogez la taille des partitions dans les tables partitionnées et triez-les par ordre décroissant :
SELECT * FROM SYSTEM_CATALOG.INFORMATION_SCHEMA.PARTITIONS ORDER by data_length DESC;
Utilisez les résultats de la requête pour identifier les tables ou partitions volumineuses et supprimez les données inutiles afin de libérer de l'espace de stockage.
Une erreur d'autorisation lors de l'exécution de ces instructions SQL indique que le schéma d'information n'est pas installé dans votre projet ou que vous ne disposez pas des autorisations nécessaires au niveau du projet. Pour résoudre ce problème, reportez-vous à la section Activer le service Information Schema pour obtenir des instructions sur l'installation et l'octroi d'autorisations. Pour des métadonnées plus complètes ou pour éviter ce type de problèmes d'autorisation, vous pouvez également configurer le schéma d'information au niveau du locataire.
Partitions
Décrit les partitions de table d'un projet.
|
Parameter |
Type |
Value |
|
table_catalog |
STRING |
La valeur est toujours |
|
table_schema |
STRING |
Le nom du projet. |
|
table_name |
STRING |
Le nom de la table. |
|
partition_name |
STRING |
Le nom de la partition. Par exemple, |
|
create_time |
DATETIME |
L'heure de création de la partition. |
|
last_modified_time |
DATETIME |
L'heure de dernière modification de la partition. |
|
data_length |
BIGINT |
La taille des données de la partition, en octets. |
|
is_archived |
BOOLEAN |
Réservé pour une utilisation future. |
|
is_exstore |
BOOLEAN |
Réservé pour une utilisation future. |
|
cluster_type |
STRING |
Facultatif. Le type de regroupement (bucketing) d'une table MaxCompute. Valeurs valides : HASH et RANGE. |
|
number_buckets |
BIGINT |
Facultatif. Le nombre de buckets dans une table clusterisée. Si cette valeur est 0, le nombre de buckets est déterminé dynamiquement lors de l'exécution d'une tâche. |
Columns
Décrit les colonnes des tables d'un espace projet.
|
Parameter |
Type |
Value |
|
table_catalog |
STRING |
Une valeur fixe de |
|
table_schema |
STRING |
Le nom du projet. |
|
table_name |
STRING |
Le nom de la table. |
|
column_name |
STRING |
Le nom de la colonne. |
|
ordinal_position |
BIGINT |
La position ordinale de la colonne. |
|
column_default |
STRING |
La valeur par défaut de la colonne. |
|
is_nullable |
BOOLEAN |
Indique si la colonne peut contenir des valeurs NULL ; la valeur est toujours YES. |
|
data_type |
STRING |
Le type de données de la colonne. |
|
column_comment |
STRING |
Le commentaire de la colonne. |
|
is_partition_key |
BOOLEAN |
Indique si la colonne est une clé de partition. |
UDFs
Informations sur les UDF du projet.
|
Parameter |
Type |
Value |
|
udf_catalog |
STRING |
La valeur fixe est |
|
udf_schema |
STRING |
Nom du projet. |
|
udf_name |
STRING |
Nom de l'UDF. |
|
owner_id |
STRING |
L'ID du propriétaire de l'UDF. |
|
owner_name |
STRING |
Facultatif. Nom du compte cloud du propriétaire de l'UDF. |
|
create_time |
DATETIME |
L'heure de création de l'UDF. |
|
last_modified_time |
DATETIME |
L'heure de dernière modification de l'UDF. |
Resources
Décrit les attributs des ressources du projet.
|
Field |
Type |
Value |
|
resource_catalog |
STRING |
Toujours |
|
resource_schema |
STRING |
Le nom du projet. |
|
resource_name |
STRING |
Le nom de la ressource. |
|
resource_type |
STRING |
Valeurs possibles : Py ou Jar. |
|
owner_id |
STRING |
L'ID du propriétaire de la ressource. |
|
owner_name |
STRING |
Facultatif. Le nom du compte cloud du propriétaire de la ressource. |
|
create_time |
DATETIME |
L'heure de création de la ressource. |
|
last_modified_time |
DATETIME |
L'heure de dernière modification de la ressource. |
|
size |
BIGINT |
L'espace de stockage utilisé par la ressource. |
|
comment |
STRING |
Un commentaire concernant la ressource. |
|
is_temp_resource |
BOOLEAN |
Indique si la ressource est temporaire. |
UDF_RESOURCES
Répertorie les dépendances de ressources pour les UDF d'un projet.
|
Parameter |
Type |
Value |
|
udf_catalog |
STRING |
Toujours |
|
udf_schema |
STRING |
Le nom du projet. |
|
udf_name |
STRING |
Le nom de l'UDF. |
|
resource_schema |
STRING |
Le nom du projet contenant la ressource. |
|
resource_name |
STRING |
Le nom de la ressource. |
Users
Liste des utilisateurs de l'espace projet.
|
Parameter |
Type |
Value |
|
user_catalog |
STRING |
La valeur peut être Alibaba Cloud ou RAM. |
|
user_schema |
STRING |
Le nom du projet. |
|
user_name |
STRING |
Facultatif. Le nom d'utilisateur. |
|
user_id |
STRING |
L'ID utilisateur. |
|
user_label |
STRING |
Le libellé utilisateur. |
Roles
Les champs suivants définissent un rôle dans le projet.
|
Parameter |
Type |
Value |
|
role_catalog |
STRING |
Toujours |
|
role_schema |
STRING |
Le nom du projet. |
|
role_name |
STRING |
Le nom du rôle. |
|
role_label |
STRING |
Le libellé du rôle. |
|
comment |
STRING |
Un commentaire pour le rôle. |
USER_ROLES
Décrit les rôles attribués aux utilisateurs du projet.
|
Parameter |
Type |
Value |
|
user_role_catalog |
STRING |
La valeur fixe est |
|
user_role_schema |
STRING |
Le nom du projet. |
|
role_name |
STRING |
Le nom du rôle. |
|
user_name |
STRING |
Le nom de l'utilisateur. |
|
user_id |
STRING |
L'ID utilisateur. |
PACKAGE_OBJECTS
Décrit les objets d'un Package au sein d'un projet.
|
Parameter |
Type |
Value |
|
package_catalog |
STRING |
La valeur est fixée à |
|
package_schema |
STRING |
Le nom du projet. |
|
package_name |
STRING |
Le nom du Package. |
|
object_type |
STRING |
Le type de l'objet au sein du Package. |
|
object_name |
STRING |
Le nom de l'objet au sein du Package. |
|
column_name |
STRING |
Le nom de la colonne. Ce champ s'applique uniquement si l'objet est une table. |
|
allowed_privileges |
VECTOR<STRING> |
Les privilèges autorisés pour l'objet. |
|
allowed_label |
STRING |
Le libellé de sécurité autorisé. |
INSTALLED_PACKAGES
Répertorie les packages installés dans le projet.
|
Field |
Type |
Value |
|
installed_package_catalog |
STRING |
La valeur est toujours |
|
installed_package_schema |
STRING |
Le nom du projet où le package est installé. |
|
package_project |
STRING |
Le nom du projet où le package a été créé. |
|
package_name |
STRING |
Le nom du package. |
|
installed_time |
DATETIME |
Heure d'installation (champ réservé). |
|
allowed_label |
STRING |
Le libellé pour le partage. |
SCHEMA_PRIVILEGES
Répertorie les privilèges sur les schémas d'un projet.
|
Parameter |
Type |
Value |
|
user_catalog |
STRING |
Une valeur fixe de |
|
user_schema |
STRING |
Le nom du projet. |
|
grantee |
STRING |
Le nom de l'utilisateur. |
|
user_id |
STRING |
L'ID du compte. |
|
grantor |
STRING |
Le compte du concédant. Cette valeur est actuellement NULL. |
|
privilege_type |
STRING |
Le type de privilège. |
TABLE_PRIVILEGES
Décrit les privilèges sur les tables d'un projet.
|
Parameter |
Type |
Value |
|
table_catalog |
STRING |
Une valeur fixe de |
|
table_schema |
STRING |
Le nom du projet contenant la table. |
|
table_name |
STRING |
Le nom de la table. |
|
grantee |
STRING |
Le nom d'utilisateur. |
|
user_id |
STRING |
L'ID du compte. |
|
grantor |
STRING |
Le concédant. La valeur actuelle est NULL. |
|
privilege_type |
STRING |
Le type de privilège. |
|
user_schema |
STRING |
Le nom du projet de l'utilisateur. |
COLUMN_PRIVILEGES
Répertorie les privilèges au niveau des colonnes pour les tables d'un projet.
|
Parameter |
Type |
Value |
|
table_catalog |
STRING |
Toujours |
|
table_schema |
STRING |
Le nom du projet qui contient la table. |
|
table_name |
STRING |
Le nom de la table. |
|
column_name |
STRING |
Le nom de la colonne. |
|
grantee |
STRING |
Le nom d'utilisateur. |
|
user_id |
STRING |
L'ID du compte. |
|
grantor |
STRING |
L'utilisateur qui a accordé le privilège. Ce champ est facultatif et sa valeur est actuellement NULL. |
|
privilege_type |
STRING |
Le type de privilège. |
|
user_schema |
STRING |
Le projet auquel l'utilisateur appartient. |
UDF_PRIVILEGES
Fournit des informations sur les privilèges relatifs aux UDF dans un projet.
|
Parameter |
Type |
Value |
|
udf_catalog |
STRING |
La valeur fixe |
|
udf_schema |
STRING |
Le nom du projet. |
|
udf_name |
STRING |
Le nom de l'UDF. |
|
user_schema |
STRING |
Le nom du projet de l'utilisateur. |
|
grantee |
STRING |
Le nom d'utilisateur. |
|
user_id |
STRING |
L'ID du compte. |
|
grantor |
STRING |
Le concédant. La valeur est actuellement NULL. |
|
privilege_type |
STRING |
Le type de privilège. |
Resource privileges
Répertorie les privilèges pour les ressources du projet.
|
Parameter |
Type |
Value |
|
resource_catalog |
STRING |
La valeur est toujours |
|
resource_schema |
STRING |
Le nom du projet. |
|
resource_name |
STRING |
Le nom de la ressource. |
|
user_schema |
STRING |
Le projet qui contient l'utilisateur. |
|
grantee |
STRING |
Le nom d'utilisateur. |
|
user_id |
STRING |
L'ID du compte. |
|
grantor |
STRING |
Le compte du concédant. Sa valeur est actuellement NULL. |
|
privilege_type |
STRING |
Le type de privilège. |
Table labels
Répertorie les libellés des tables du projet.
|
Parameter |
Type |
Value |
|
table_catalog |
STRING |
Toujours |
|
table_schema |
STRING |
Le nom du projet. |
|
table_name |
STRING |
Le nom de la table. |
|
label_type |
STRING |
Toujours NULL. |
|
label_level |
STRING |
Le niveau du libellé. |
COLUMN_LABELS
Fournit des informations sur les libellés de colonne pour les tables d'un projet.
|
Column |
Type |
Value |
|
table_catalog |
STRING |
La valeur est toujours |
|
table_schema |
STRING |
Le nom du projet. |
|
table_name |
STRING |
Le nom de la table. |
|
column_name |
STRING |
Le nom de la colonne. |
|
label_type |
STRING |
Le type de libellé. Cette valeur est toujours NULL. |
|
label_level |
STRING |
Le niveau du libellé. |
TABLE_LABEL_GRANTS
La vue TABLE_LABEL_GRANTS décrit les autorisations de libellés sur les tables du projet.
|
Parameter |
Type |
Value |
|
table_label_grant_catalog |
STRING |
Toujours |
|
table_label_grant_schema |
STRING |
Le nom du projet auquel l'utilisateur appartient. |
|
user |
STRING |
Le nom d'utilisateur. |
|
user_id |
STRING |
L'ID utilisateur. |
|
table_schema |
STRING |
Le nom du projet qui contient la table. |
|
table_name |
STRING |
Le nom de la table. |
|
grantor |
STRING |
Le compte du concédant, qui est actuellement NULL. |
|
label_level |
STRING |
Le niveau de libellé accordé. |
|
expired |
DATETIME |
L'heure d'expiration. |
COLUMN_LABEL_GRANTS
Répertorie les octrois de libellés pour les colonnes de table dans un projet.
|
Parameter |
Type |
Value |
|
column_label_grant_catalog |
STRING |
La valeur est toujours |
|
column_label_grant_schema |
STRING |
Le nom du projet de l'utilisateur. |
|
user |
STRING |
Le nom d'utilisateur. |
|
user_id |
STRING |
L'ID utilisateur. |
|
table_schema |
STRING |
Le nom du projet de la table. |
|
table_name |
STRING |
Le nom de la table. |
|
column_name |
STRING |
Le nom de la colonne. |
|
grantor |
STRING |
Le compte du concédant. Cette valeur est actuellement toujours NULL. |
|
label_level |
STRING |
Le niveau de libellé accordé. |
|
expired |
DATETIME |
L'heure d'expiration. |
Tasks
Cette vue fournit des instantanés en temps réel des tâches pour une surveillance en direct.
La vue TASKS est actuellement en aperçu privé. Les champs et leur contenu sont susceptibles d'être modifiés. Cette vue n'est pas couverte par un accord de niveau de service (SLA). Utilisez-la avec prudence. Pour les mises à jour concernant son statut de publication, reportez-vous à la rubrique Annonces.
Field | Type | Description |
project_name | STRING | Le nom du projet. |
task_name | STRING | Le nom de la tâche. |
task_type | STRING | Le type de la tâche. Valeurs valides :
|
inst_id | STRING | L'ID de l'instance. |
status | STRING | L'état de la tâche lors de la prise de l'instantané. Les valeurs valides sont |
owner_id | STRING | L'ID du compte cloud qui a soumis la tâche. |
owner_name | STRING | Le nom du compte cloud qui a soumis la tâche. |
start_time | DATETIME | L'heure de début de la tâche. |
priority | BIGINT | La priorité de la tâche. Cela s'applique uniquement aux tâches qui utilisent des ressources par abonnement. |
signature | STRING | La signature de la tâche. |
queue_name | STRING | Le nom de la file d'attente de calcul. |
cpu_usage | BIGINT | L'utilisation actuelle du CPU. La valeur est |
mem_usage | BIGINT | L'utilisation actuelle de la mémoire, en Mo. |
gpu_usage | BIGINT | L'utilisation actuelle du GPU. La valeur est |
total_cpu_usage | BIGINT | L'utilisation cumulée du CPU. La valeur est |
total_mem_usage | BIGINT | L'utilisation cumulée de la mémoire. La valeur est |
total_gpu_usage | BIGINT | L'utilisation cumulée du GPU. La valeur est |
cpu_min_ratio | BIGINT | Le ratio entre l'utilisation actuelle du CPU de la tâche et le niveau de ressources garanti de la file d'attente de calcul. Cela s'applique uniquement aux tâches qui utilisent des ressources par abonnement. |
mem_min_ratio | BIGINT | Le ratio entre l'utilisation actuelle de la mémoire de la tâche et le niveau de ressources garanti de la file d'attente de calcul. Cela s'applique uniquement aux tâches qui utilisent des ressources par abonnement. |
gpu_min_ratio | BIGINT | Le ratio entre l'utilisation actuelle du GPU de la tâche et le niveau de ressources garanti de la file d'attente de calcul. Cela s'applique uniquement aux tâches qui utilisent des ressources par abonnement. |
cpu_max_ratio | BIGINT | Le ratio entre l'utilisation actuelle du CPU de la tâche et le niveau maximal de ressources élastiques de la file d'attente de calcul. Cela s'applique uniquement aux tâches qui utilisent des ressources par abonnement. |
mem_max_ratio | BIGINT | Le ratio entre l'utilisation actuelle de la mémoire de la tâche et le niveau maximal de ressources élastiques de la file d'attente de calcul. Cela s'applique uniquement aux tâches qui utilisent des ressources par abonnement. |
gpu_max_ratio | BIGINT | Le ratio entre l'utilisation actuelle du GPU de la tâche et le niveau maximal de ressources élastiques de la file d'attente de calcul. Cela s'applique uniquement aux tâches qui utilisent des ressources par abonnement. |
settings | STRING | Paramètres de planification personnalisés provenant de services de niveau supérieur tels que DataWorks. |
additional_info | STRING | Informations supplémentaires. Il s'agit d'un champ réservé. |
TASKS_HISTORY
Cette vue contient l'historique des tâches terminées au cours des 14 derniers jours dans un projet MaxCompute.
Field | Type | Value |
task_catalog | STRING | Valeur fixe : |
task_schema | STRING | Nom du projet. |
task_name | STRING | Nom de la tâche. |
task_type | STRING | Type de tâche. Valeurs valides :
|
inst_id | STRING | ID de l'instance. |
status | STRING | État de la tâche au moment de la collecte des données (non en temps réel). Valeurs possibles :
|
owner_id | STRING | ID du compte. |
owner_name | STRING | Nom du compte cloud. |
result | STRING | Contient le message d'erreur uniquement en cas d'échec d'une tâche SQL. |
start_time | DATETIME | Heure de début de la tâche. |
end_time | DATETIME | Heure de fin de la tâche. Cette valeur est NULL si la tâche était encore en cours d'exécution lors de la collecte des données. |
input_records | BIGINT | Nombre d'enregistrements lus par la tâche. |
output_records | BIGINT | Nombre d'enregistrements écrits par la tâche. |
input_bytes | BIGINT | Volume de données analysées. Cette valeur correspond à celle affichée dans Logview. |
output_bytes | BIGINT | Volume de données écrites. |
input_tables | STRING | Tables d'entrée de la tâche, au format [project.table1, project.table2]. Ces informations peuvent être indisponibles pour certains types de tâches, tels que SQLCost. |
output_tables | STRING | Tables de sortie de la tâche, au format [project.table1, project.table2]. |
operation_text | STRING | Source XML de l'instruction de requête. Ce champ est NULL si sa taille dépasse 256 Ko. |
signature | STRING | Facultatif. Signature de la tâche. |
complexity | DOUBLE | Facultatif. Complexité de la tâche. Ce champ est disponible uniquement pour les tâches SQL. |
cost_cpu | DOUBLE | Coût CPU de la tâche, où 100 représente 1 seconde-cœur. Par exemple, si une tâche utilise 10 cœurs pendant 5 secondes, le coût CPU est de 10 × 100 × 5 = 5000. |
cost_mem | DOUBLE | Coût mémoire de la tâche, en Mo-secondes. |
settings | STRING | Paramètres fournis par l'utilisateur ou transmis par le planificateur, au format JSON. Peut inclure des champs tels que : USERAGENT, BIZID, SKYNET_ID et SKYNET_NODENAME. |
ds | STRING | Date de collecte des données. Par exemple, 20190101. |
TUNNELS_HISTORY
Cette vue contient l'historique des opérations de chargement et de téléchargement en masse effectuées via Tunnel. Les données sont conservées pendant 14 jours.
Parameter | Type | Value |
tunnel_catalog | STRING | Fixé à |
tunnel_schema | STRING | Nom du projet. |
session_id | STRING | ID de session. Le format est |
operate_type | STRING | Type d'opération. Valeurs valides :
|
tunnel_type | STRING | Type de tunnel. Les valeurs valides sont |
request_id | STRING | ID de la requête. |
object_type | STRING | Type d'objet. Les valeurs valides sont |
object_name | STRING | Nom de la table ou ID de l'instance. |
partition_spec | STRING | Spécification de partition. Par exemple, |
data_size | BIGINT | Taille des données en octets. |
block_id | BIGINT | ID de bloc pour un chargement Tunnel. Ce champ est valide uniquement lorsque le type d'opération est |
offset | BIGINT | Décalage basé sur zéro indiquant l'enregistrement de départ pour un téléchargement. |
length | BIGINT | Nombre d'enregistrements chargés ou téléchargés (équivalent au nombre d'enregistrements). Pour les téléchargements, l'utilisateur spécifie cette valeur. |
owner_id | STRING | ID du compte Alibaba Cloud. |
owner_name | STRING | Nom du compte Alibaba Cloud. |
start_time | DATETIME | Heure de début de la requête. |
end_time | DATETIME | Heure de fin de la requête. |
client_ip | STRING | Adresse IP du client qui a initié la requête Tunnel. |
user_agent | STRING | Chaîne User-Agent du client qui a initié la requête Tunnel. Par exemple, cette chaîne peut inclure la version Java et le système d'exploitation. |
columns | STRING | Colonnes spécifiées pour un téléchargement Tunnel. |
ds | STRING | Date de collecte des données. Par exemple, |
FAQ
Nombre d'accès dans TABLE_ACCESS_INFO
Non. Le nombre d'accès dans TABLE_ACCESS_INFO représente le total des opérations d'accès d'une tâche, telles que les lectures et les écritures. Ce nombre ne distingue pas les types d'opérations spécifiques ; vous ne pouvez donc pas consulter séparément le nombre de requêtes.