Cette rubrique décrit les scénarios courants de répartition inégale des données dans MaxCompute et leurs solutions.
MapReduce
Pour comprendre la répartition inégale des données, vous devez d'abord comprendre le fonctionnement de MapReduce. MapReduce est un framework de calcul distribué qui utilise une stratégie de division pour mieux régner. Il divise les problèmes vastes ou complexes en sous-problèmes plus petits et gérables, traite ces sous-problèmes, puis fusionne leurs résultats pour produire une sortie finale. Par rapport aux frameworks de programmation parallèle traditionnels, MapReduce offre une tolérance aux pannes élevée, une grande facilité d'utilisation et une excellente évolutivité. Lorsque vous utilisez MapReduce pour implémenter des programmes parallèles, vous n'avez pas besoin de prendre en compte les questions non liées à la programmation dans les clusters distribués, telles que le stockage des données ou les mécanismes d'échange et de transmission d'informations entre les nœuds. Cela simplifie considérablement la programmation distribuée.
Le schéma suivant illustre le flux de travail de MapReduce.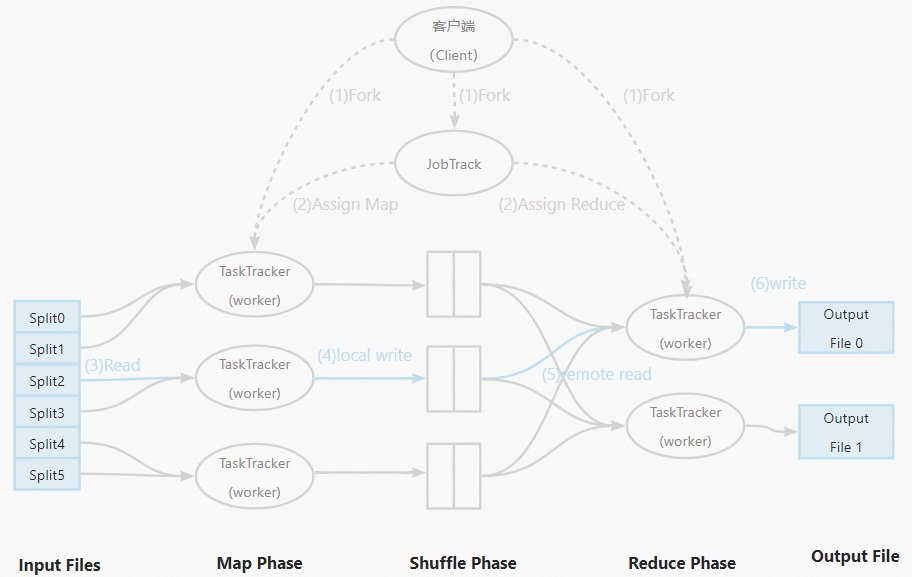
Répartition inégale des données
La répartition inégale des données se produit souvent lors de l'étape du reducer. Bien que les mappers divisent généralement les fichiers d'entrée de manière uniforme, une répartition inégale survient lorsque les données sont distribuées de façon disparate entre les workers. Cette distribution inégale entraîne la terminaison rapide de certains workers, tandis que d'autres mettent beaucoup plus de temps. Dans les environnements de production, la plupart des données présentent ce type de déséquilibre. Ce phénomène suit le principe de Pareto, également connu sous le nom de règle des 80/20. Par exemple, 20 % des utilisateurs actifs d'un forum peuvent générer 80 % des publications, ou 20 % des utilisateurs peuvent être à l'origine de 80 % du trafic d'un site web. À l'ère du big data, la répartition inégale des données peut avoir un impact sévère sur les performances des programmes distribués. Un symptôme courant est un job qui semble bloqué à 99 % de progression.
Comment identifier la répartition inégale des données
Procédure
Pour identifier la répartition inégale des données dans MaxCompute, utilisez Logview comme suit :
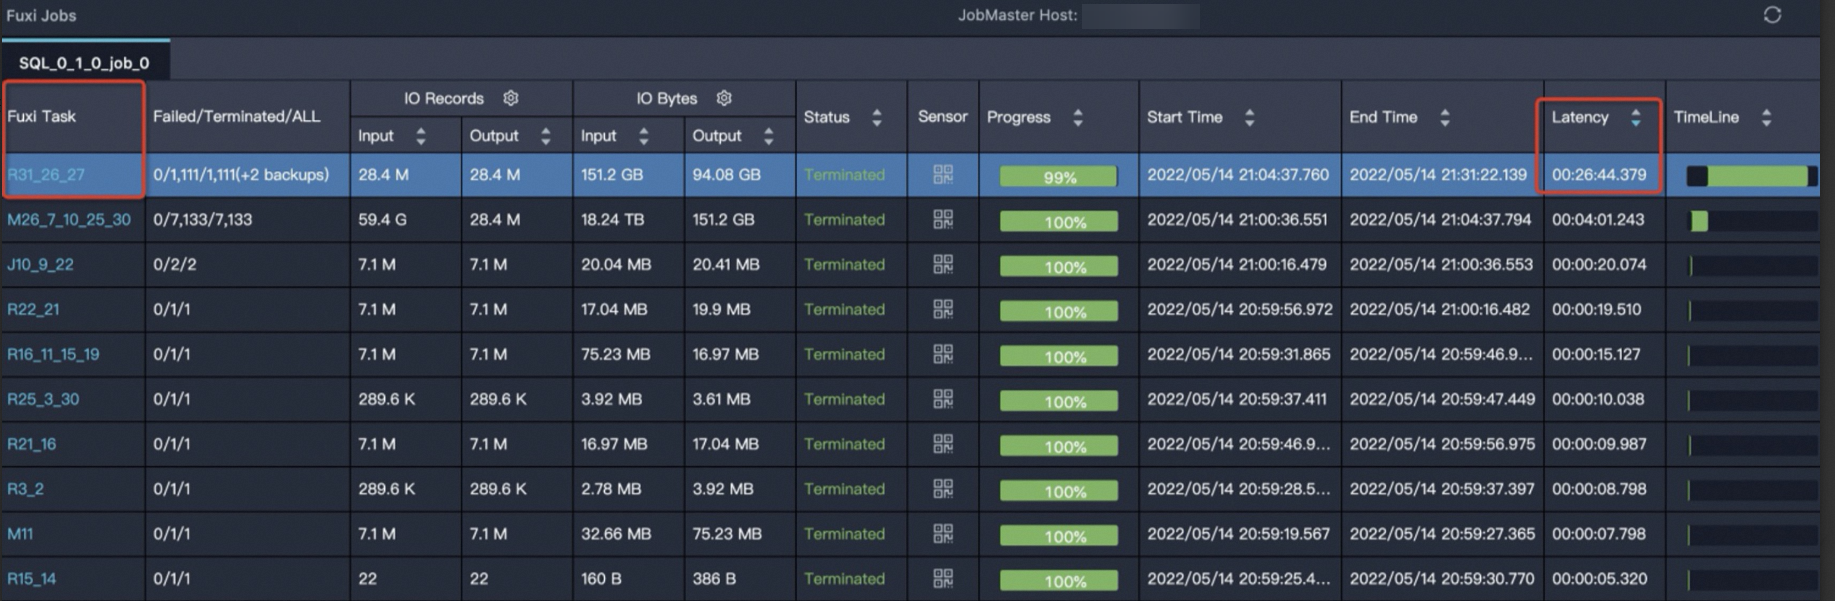
Dans l'onglet Fuxi Jobs, triez les jobs par Latency dans l'ordre décroissant et sélectionnez l'étape du job dont le temps d'exécution est le plus long.
Dans la liste Fuxi instance de cette étape, triez les instances par Latency dans l'ordre décroissant. Sélectionnez l'instance dont le temps d'exécution est nettement supérieur à la moyenne (généralement la première de la liste). Consultez son journal de sortie dans la colonne StdOut.
Utilisez les informations contenues dans le journal StdOut pour afficher le graphique d'exécution du job correspondant.
Exploitez les informations clés du graphique d'exécution du job pour localiser l'extrait SQL à l'origine de la répartition inégale des données.
Exemple
Repérez l'URL Logview dans le journal d'exécution de la tâche. Pour plus d'informations, consultez Points d'entrée Logview.
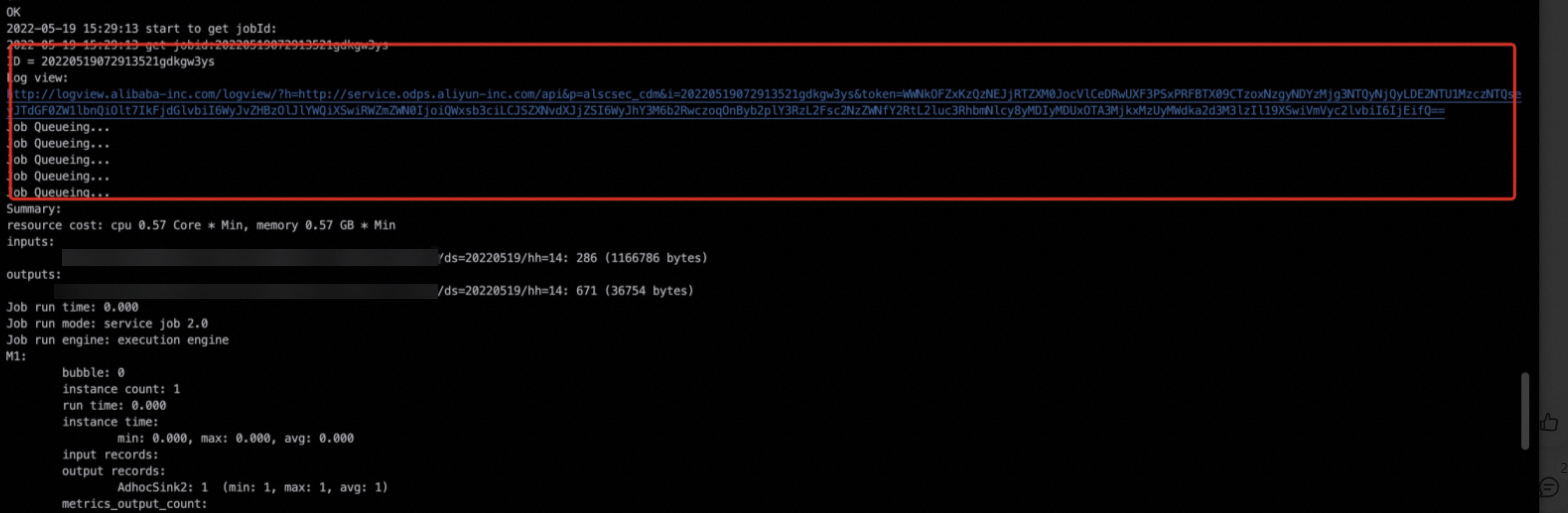
Pour cibler rapidement le problème, triez les tâches Fuxi sur la page Logview par Latency dans l'ordre décroissant et sélectionnez celle dont le temps d'exécution est le plus long.
-
La tâche
R31_26_27présente le temps d'exécution le plus long. Cliquez sur la tâcheR31_26_27pour accéder à la page des détails de l'instance, comme illustré ci-dessous.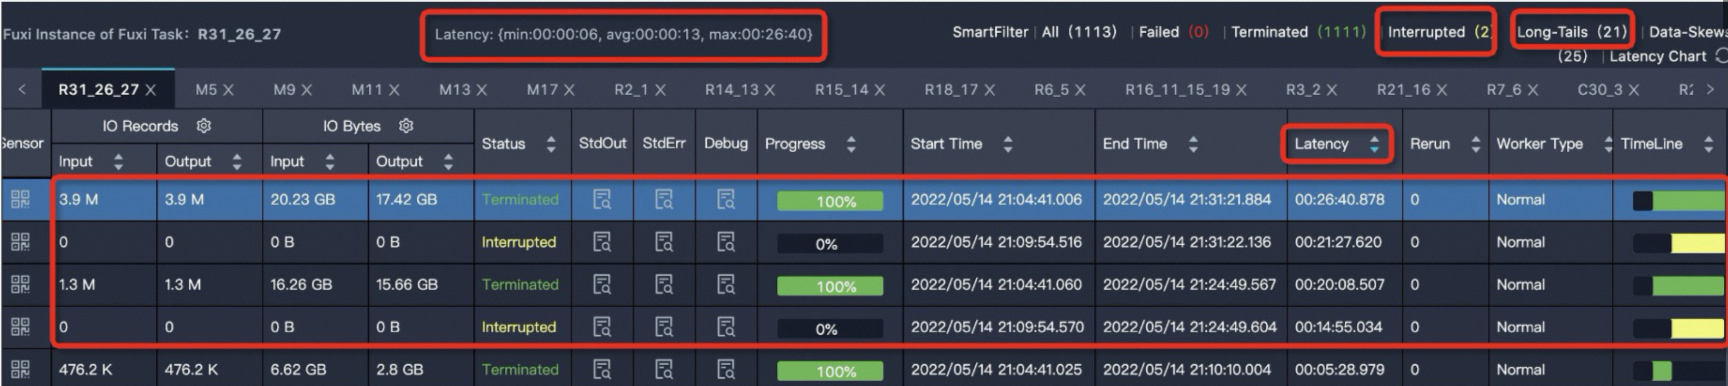 La ligne
Latency: {min:00:00:06, avg:00:00:13, max:00:26:40}indique que le temps d'exécution minimal d'une instance est de6s, le temps moyen est de13set le temps maximal est de26 minutes et 40 secondes.Triez les instances par
Latencydans l'ordre décroissant. Vous constatez que quatre instances ont un temps d'exécution élevé.MaxCompute considère qu'une instance Fuxi constitue une longue traîne si son temps d'exécution dépasse le double de la moyenne. Cela signifie qu'une instance de tâche avec un temps d'exécution supérieur à
26sest identifiée comme une longue traîne. Dans ce cas, 21 instances affichent des temps d'exécution supérieurs à26s. Toutefois, la présence d'instances à longue traîne n'indique pas nécessairement une répartition inégale des données. Vous devez également comparer les valeursavgetmaxdu temps d'exécution de l'instance. Une tâche est considérée comme présentant une répartition inégale des données sévère nécessitant une optimisation si sa valeurmaxest bien supérieure à sa valeuravg. Cliquez sur l'icône
 dans la colonne StdOut pour consulter le journal de sortie, comme illustré dans l'exemple suivant.
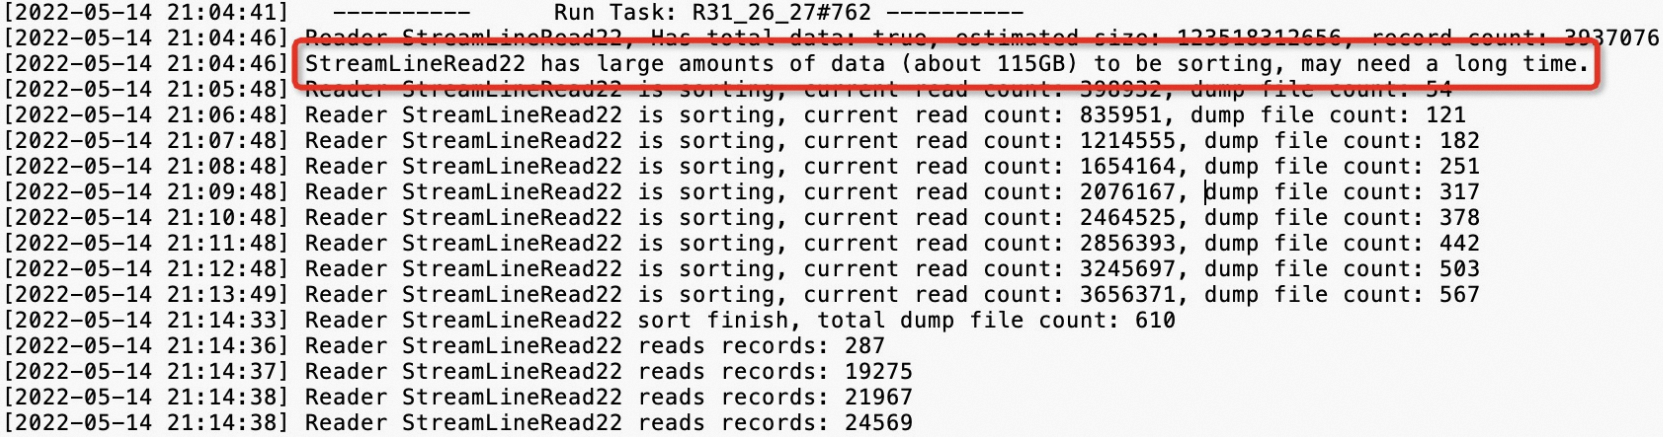
Une fois le problème identifié, accédez à l'onglet Job Details, cliquez avec le bouton droit sur
R31_26_27, puis sélectionnez Expand All pour développer la tâche. Pour plus d'informations, consultez Utilisation de Logview 2.0 pour afficher les informations sur les jobs.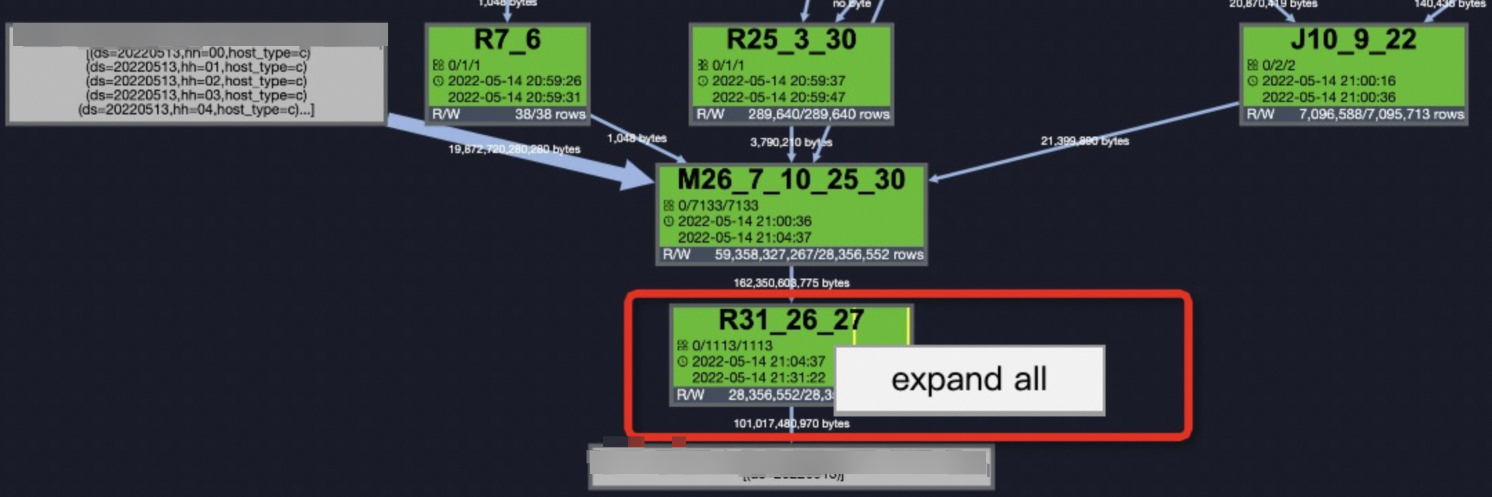 Vérifiez l'étape précédant
StreamLineRead22, à savoirStreamLineWriter21. Cela vous permet d'identifier les clés déséquilibrées (new_uri_path_structure,cookie_x5check_useridetcookie_userid) et de localiser l'extrait SQL à l'origine de la répartition inégale des données.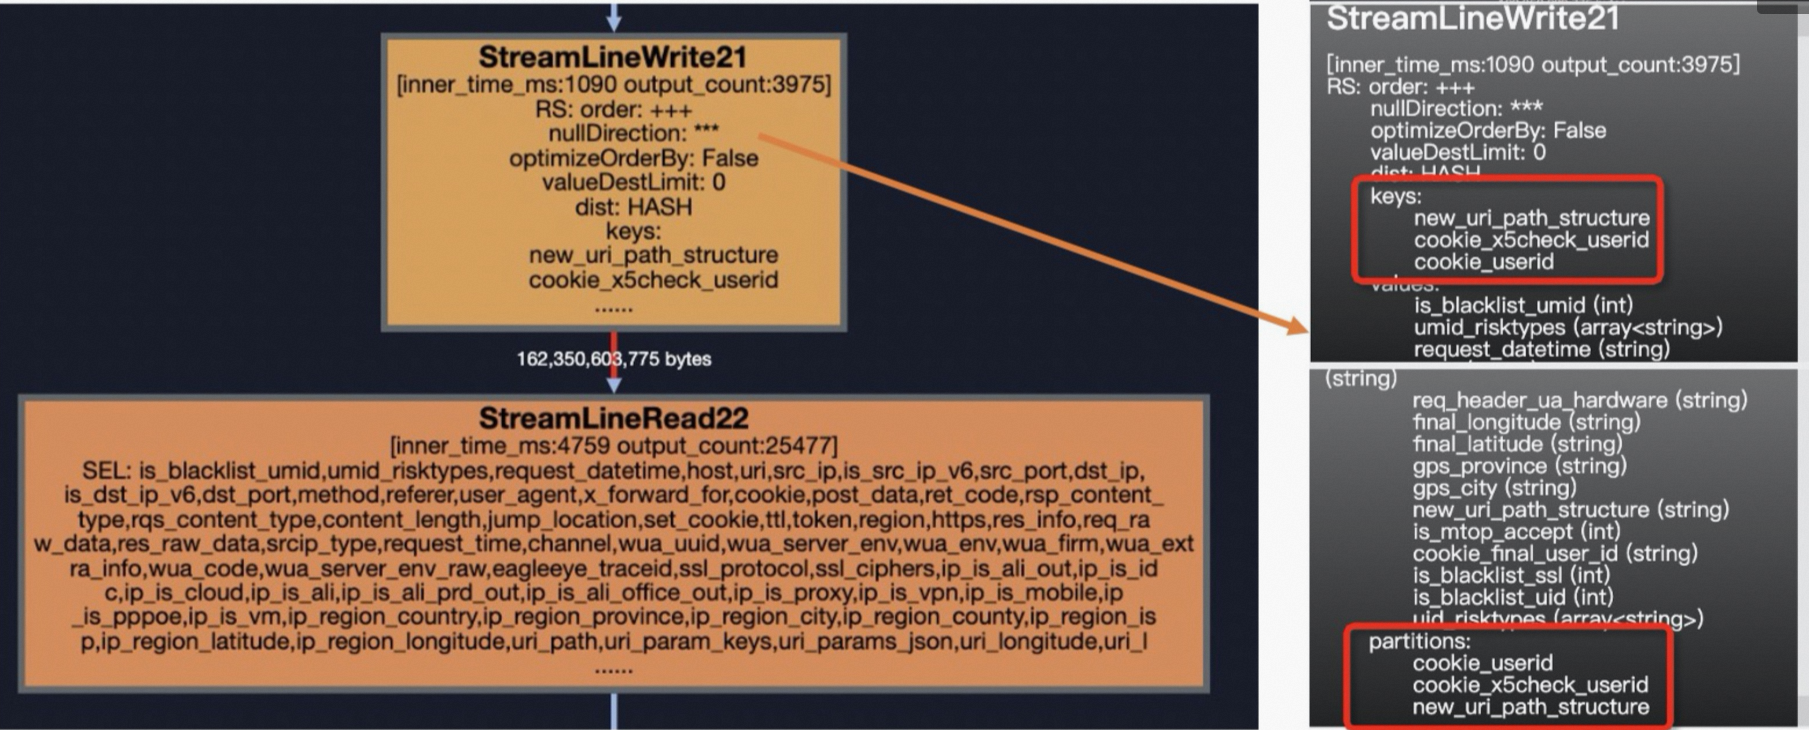
Dépannage et résolution de la répartition inégale des données
Les causes les plus fréquentes de répartition inégale des données sont listées ci-dessous, par ordre de fréquence décroissante :
JOIN
GROUP BY
COUNT(DISTINCT)
ROW_NUMBER (TopN)
partition dynamique
JOIN
La répartition inégale des données lors d'une opération JOIN peut résulter de différents scénarios, tels que la jointure d'une grande table avec une petite table, d'une grande table avec une table de taille moyenne, ou la présence de clés chaudes générant des longues traînes.
Grandes et petites tables
-
Exemple de répartition inégale des données
Dans l'exemple suivant,
t1est une grande table, tandis quet2ett3sont de petites tables.SELECT t1.ip ,t1.is_anon ,t1.user_id ,t1.user_agent ,t1.referer ,t2.ssl_ciphers ,t3.shop_province_name ,t3.shop_city_name FROM <viewtable> t1 LEFT OUTER JOIN <other_viewtable> t2 ON t1.header_eagleeye_traceid = t2.eagleeye_traceid LEFT OUTER JOIN ( SELECT shop_id ,city_name AS shop_city_name ,province_name AS shop_province_name FROM <tenanttable> WHERE ds = MAX_PT('<tenanttable>') AND is_valid = 1 ) t3 ON t1.shopid = t3.shop_id -
Solution
Utilisez la syntaxe Indice MAPJOIN, comme indiqué dans le code suivant.
SELECT /*+ mapjoin(t2,t3)*/ t1.ip ,t1.is_anon ,t1.user_id ,t1.user_agent ,t1.referer ,t2.ssl_ciphers ,t3.shop_province_name ,t3.shop_city_name FROM <viewtable> t1 LEFT OUTER JOIN (<other_viewtable>) t2 ON t1.header_eagleeye_traceid = t2.eagleeye_traceid LEFT OUTER JOIN ( SELECT shop_id ,city_name AS shop_city_name ,province_name AS shop_province_name FROM <tenanttable> WHERE ds = MAX_PT('<tenanttable>') AND is_valid = 1 ) t3 ON t1.shopid = t3.shop_id -
Remarques d'utilisation
Lorsque vous référencez une petite table ou une sous-requête, vous devez utiliser son alias.
Un MAPJOIN prend en charge une sous-requête en tant que petite table.
Dans un MAPJOIN, vous pouvez utiliser des jointures non équivalentes ou combiner plusieurs conditions avec
OR. Vous pouvez calculer un produit cartésien en omettant la clauseONet en utilisantmapjoin on 1 = 1. Par exemple :select /*+ mapjoin(a) */ a.id from shop a join table_name b on 1=1;. Cependant, cette opération peut provoquer une augmentation du volume des données.Dans un MAPJOIN, séparez plusieurs petites tables par des virgules (
,), par exemple/*+ mapjoin(a,b,c)*/.-
Un MAPJOIN charge toutes les données des tables spécifiées en mémoire lors de l'étape map. Par conséquent, les tables spécifiées doivent être de petite taille. La taille en mémoire de chaque table ne peut pas dépasser 512 Mo. Cette limite s'applique à la taille des données après leur chargement en mémoire, qui peut être nettement supérieure à leur taille de stockage compressé. Vous pouvez augmenter cette limite de mémoire jusqu'à 8 192 Mo en définissant le paramètre suivant :
SET odps.sql.mapjoin.memory.max=2048; -
Limites des opérations JOIN dans un MAPJOIN :
Pour une
LEFT OUTER JOIN, la table de gauche doit être la grande table.Pour une
RIGHT OUTER JOIN, la table de droite doit être la grande table.FULL OUTER JOINn'est pas pris en charge.Pour une
INNER JOIN, la table de gauche ou de droite peut être la grande table.Un MAPJOIN prend en charge un maximum de 128 petites tables. Si vous dépassez cette limite, une erreur de syntaxe est signalée.
Grandes et tables moyennes
-
Exemple de répartition inégale des données
Dans l'exemple suivant,
t0est une grande table ett1est une table de taille moyenne.SELECT request_datetime ,host ,URI ,eagleeye_traceid FROM <viewtable> t0 LEFT JOIN ( SELECT traceid, eleme_uid, isLogin_is FROM <servicetable> WHERE ds = '${today}' AND hh = '${hour}' ) t1 ON t0.eagleeye_traceid = t1.traceid WHERE ds = '${today}' AND hh = '${hour}' -
Solution
Utilisez l'indice DISTRIBUTED MAPJOIN hint pour résoudre la répartition inégale des données, comme indiqué dans le code suivant.
SELECT  /*+distmapjoin(t1)*/
        request_datetime
        ,host
        ,URI
        ,eagleeye_traceid
FROM <viewtable>
    t0
LEFT JOIN (
    SELECT
    traceid,
    eleme_uid,
    isLogin_is
    FROM <servicetable>
    WHERE ds = '${today}'
    AND     hh = '${hour}'
) t1 ON t0.eagleeye_traceid = t1.traceid
WHERE   ds = '${today}'
AND     hh = '${hour}'
Jointure de clés chaudes
-
Exemple de répartition inégale des données
Dans le tableau suivant, la colonne
eleme_uidcontient de nombreuses clés chaudes, ce qui peut facilement provoquer une répartition inégale des données.SELECT eleme_uid, ... FROM ( SELECT eleme_uid, ... FROM <viewtable> )t1 LEFT JOIN( SELECT eleme_uid, ... FROM <customertable> ) t2 ON t1.eleme_uid = t2.eleme_uid; -
Solutions
Vous pouvez résoudre ce problème en utilisant l'une des trois méthodes suivantes.
Méthode
Nom
Description
Méthode 1
Séparation manuelle des clés chaudes
Identifiez les clés chaudes, filtrez-les de la table principale et traitez-les avec un MAPJOIN. Traitez les enregistrements restants ne contenant pas de clés chaudes avec un MergeJoin. Enfin, fusionnez les résultats des deux jointures.
Méthode 2
Indice SkewJoin
Utilisez l'indice
/*+ skewJoin(<table_name>[(<column1_name>[,<column2_name>,...])][((<value11>,<value12>)[,(<value21>,<value22>)...])]*/. L'utilisation de l'indice SkewJoin ajoute une étape supplémentaire pour trouver les clés déséquilibrées, ce qui augmente le temps d'exécution de la requête. Si vous connaissez déjà les clés déséquilibrées, vous pouvez définir les paramètres SkewJoin pour gagner du temps.Méthode 3
Jointure modulo-équivalente
Utilisez une table multiplicatrice pour distribuer les clés chaudes.
-
Séparation manuelle des clés chaudes.
Après identification des valeurs chaudes, les enregistrements les contenant sont filtrés de la table principale pour effectuer un MapJoin. Les enregistrements restants sans valeurs chaudes sont traités avec un MergeJoin. Enfin, les résultats des deux jointures sont combinés. Pour plus de détails, consultez l'exemple de code suivant :
SELECT /*+ MAPJOIN (t2) */ eleme_uid, ... FROM ( SELECT eleme_uid, ... FROM <viewtable> WHERE eleme_uid = <skewed_value> )t1 LEFT JOIN( SELECT eleme_uid, ... FROM <customertable> WHERE eleme_uid = <skewed_value> ) t2 ON t1.eleme_uid = t2.eleme_uid UNION ALL SELECT eleme_uid, ... FROM ( SELECT eleme_uid, ... FROM <viewtable> WHERE eleme_uid != <skewed_value> )t3 LEFT JOIN( SELECT eleme_uid, ... FROM <customertable> WHERE eleme_uid != <skewed_value> ) t4 ON t3.eleme_uid = t4.eleme_uid -
Indice SkewJoin.
Dans une instruction
SELECT, utilisez l'indice/*+ skewJoin(<table_name>[(<column1_name>[,<column2_name>,...])][((<value11>,<value12>)[,(<value21>,<value22>)...])]*/pour gérer le déséquilibre. Dans cet indice,table_namecorrespond au nom de la table déséquilibrée,column_nameau nom de la colonne déséquilibrée etvalueà la valeur de la clé déséquilibrée. Le code suivant fournit un exemple.-- Method 1: Hint the table name. Note that you hint the table's alias. SELECT /*+ skewjoin(a) */ * FROM T0 a JOIN T1 b ON a.c0 = b.c0 AND a.c1 = b.c1; -- Method 2: Hint the table name and the columns that you suspect are skewed. For example, columns c0 and c1 in table 'a' have data skew. SELECT /*+ skewjoin(a(c0, c1)) */ * FROM T0 a JOIN T1 b ON a.c0 = b.c0 AND a.c1 = b.c1 AND a.c2 = b.c2; -- Method 3: Hint the table name and columns, and provide the skewed key values. If a key value is of the STRING type, enclose it in quotation marks. For example, the values for (a.c0=1 and a.c1="2") and (a.c0=3 and a.c1="4") are both skewed. SELECT /*+ skewjoin(a(c0, c1)((1, "2"), (3, "4"))) */ * FROM T0 a JOIN T1 b ON a.c0 = b.c0 AND a.c1 = b.c1 AND a.c2 = b.c2;RemarqueLa méthode d'indice SkewJoin spécifiant directement les valeurs est plus efficace que la séparation manuelle des clés chaudes ou l'utilisation de l'indice sans spécification des valeurs.
Types de JOIN pris en charge par l'indice SkewJoin :
Pour une
INNER JOIN, vous pouvez indiquer l'une ou l'autre table de la jointure.Pour une
LEFT JOIN,SEMI JOINouANTI JOIN, vous ne pouvez indiquer que la table de gauche.Pour une
RIGHT JOIN, vous ne pouvez indiquer que la table de droite.FULL JOINne prend pas en charge l'indice SkewJoin.
Nous vous recommandons d'ajouter un indice uniquement à un JOIN présentant une répartition inégale des données certaine, car l'indice exécute une agrégation, ce qui engendre un coût.
Les types de données des clés de jointure du côté gauche du JOIN indiqué doivent être identiques aux types de données des clés de jointure du côté droit. Sinon, l'indice SkewJoin ne prend pas effet. Par exemple, le type de données de
a.c0doit être identique à celui deb.c0, et le type de données dea.c1doit être identique à celui deb.c1. Vous pouvez utiliser la fonction CAST dans une sous-requête pour garantir la cohérence des types de données. Voici un exemple :CREATE TABLE T0(c0 int, c1 int, c2 int, c3 int); CREATE TABLE T1(c0 string, c1 int, c2 int); -- Method 1: SELECT /*+ skewjoin(a) */ * FROM T0 a JOIN T1 b ON cast(a.c0 AS string) = b.c0 AND a.c1 = b.c1; -- Method 2: SELECT /*+ skewjoin(b) */ * FROM (SELECT cast(a.c0 AS string) AS c00 FROM T0 a) b JOIN T1 c ON b.c00 = c.c0;Après ajout de l'indice SkewJoin, l'optimiseur exécute une agrégation pour obtenir les 20 clés chaudes principales.
20est la valeur par défaut, que vous pouvez modifier en utilisantset odps.optimizer.skew.join.topk.num = xx;.L'indice SkewJoin prend en charge l'indication d'un seul côté d'un JOIN.
Le JOIN indiqué doit comporter une condition
left_key = right_key. Les jointures par produit cartésien ne sont pas prises en charge.Vous ne pouvez pas ajouter un indice SkewJoin à un JOIN disposant déjà d'un indice MAPJOIN.
-
Jointure modulo-équivalente avec une table multiplicatrice.
Cette approche diffère logiquement des trois solutions précédentes. Elle n'utilise pas une stratégie de division pour mieux régner. Elle exploite plutôt une table multiplicatrice contenant une seule colonne d'entiers avec des valeurs allant de 1 à N, où N est déterminé par le degré de déséquilibre. Cette table sert à étendre la table de comportement utilisateur par un facteur N. L'opération JOIN suivante utilise alors deux clés de jointure : l'ID utilisateur et
number. En ajoutant la condition de jointurenumber, la répartition inégale des données causée par la distribution basée uniquement sur les IDs utilisateur est réduite à1/Nde son niveau initial. Cependant, un inconvénient de cette approche est qu'elle gonfle également les données par un facteur N.SELECT eleme_uid, ... FROM ( SELECT eleme_uid, ... FROM <viewtable> )t1 LEFT JOIN( SELECT /*+mapjoin(<multipletable>)*/ eleme_uid, number ... FROM <customertable> JOIN <multipletable> ) t2 ON t1.eleme_uid = t2.eleme_uid AND mod(t1.<value_col>,10)+1 = t2.number;Pour remédier à la dilation des données, vous pouvez limiter l'expansion aux seuls enregistrements de clés chaudes dans les deux tables, en laissant les autres enregistrements non chauds inchangés. Commencez par repérer les enregistrements de clés chaudes. Ensuite, traitez séparément la table de trafic et la table de comportement utilisateur en ajoutant une nouvelle colonne
eleme_uid_join. Si un ID utilisateur est une clé chaude, concaténez-y un entier positif attribué aléatoirement (par exemple, de 0 à 1 000) à l'aide deCONCAT. Sinon, conservez l'ID utilisateur d'origine. Lors de la jointure des deux tables, utilisez la colonneeleme_uid_join. Cela permet à la fois de distribuer les clés chaudes pour réduire le déséquilibre et d'éviter l'expansion inutile des enregistrements non chauds. Toutefois, cette logique réécrit fortement le SQL métier d'origine et n'est donc pas recommandée.
-
GROUP BY
Le code suivant fournit un exemple de pseudo-code avec une clause GROUP BY.
SELECT  shop_id
        ,sum(is_open) AS open_days
FROM    table_xxx_di
WHERE   dt BETWEEN '${bizdate_365}' AND '${bizdate}'
GROUP BY shop_id;
Lorsqu'une répartition inégale des données se produit, vous pouvez utiliser l'une des trois solutions suivantes :
|
Méthode |
Nom |
Description |
|
Méthode 1 |
Définition du paramètre anti-déséquilibre pour GROUP BY |
Définissez |
|
Méthode 2 |
Ajout d'un nombre aléatoire |
Séparation des clés provoquant des longues traînes. |
|
Méthode 3 |
Création d'une table tournante |
Réduction des coûts et amélioration de l'efficacité. |
-
Méthode 1 : Définition du paramètre anti-déséquilibre pour GROUP BY.
SET odps.sql.groupby.skewindata=true; -
Méthode 2 : Ajout d'un nombre aléatoire.
Cette solution réécrit le SQL pour ajouter un nombre aléatoire, séparant ainsi les clés responsables des longues traînes. Il s'agit d'une méthode efficace pour résoudre les longues traînes dans les opérations GROUP BY.
Pour la requête SQL
Select Key,Count(*) As Cnt From TableName Group By Key;, sans combiner, le nœud mapper redistribue les données vers le nœud reducer, qui effectue ensuite l'opération COUNT. Le plan d'exécution correspondant estM->R.En supposant que la clé à longue traîne ait été identifiée, vous pouvez redistribuer le travail pour cette clé comme suit :
-- Assume the long-tail key is KEY001.
SELECT  a.Key
        ,SUM(a.Cnt) AS Cnt
FROM(SELECT  Key
            ,COUNT(*) AS Cnt
            FROM    <TableName>
            GROUP BY Key
            ,CASE WHEN KEY = 'KEY001' THEN Hash(Random()) % 50
             ELSE 0
            END
        ) a
GROUP BY a.Key;
Le plan d'exécution modifié devient
M->R->R. Bien que le nombre d'étapes d'exécution augmente, le temps d'exécution global peut être réduit car la clé à longue traîne est traitée en deux étapes. La consommation de ressources et l'efficacité temporelle sont similaires à celles de la Méthode 1. Cependant, dans des scénarios réels, il existe souvent plus d'une clé à longue traîne. Compte tenu de l'effort nécessaire pour trouver les clés à longue traîne et réécrire le SQL, la Méthode 1 est souvent plus rentable. -
Méthode 3 : Création d'une table tournante.
Pour réduire les coûts et améliorer l'efficacité, vous devrez peut-être récupérer des données sur l'année écoulée. Pour les tâches en ligne, lire toutes les partitions de
T-1àT-365à chaque fois représente un gaspillage important de ressources. La création d'une table tournante peut réduire le nombre de partitions lues sans affecter la récupération des données sur l'année écoulée. Le code suivant fournit un exemple.Tout d'abord, initialisez 365 jours de données commerciales marchandes avec une agrégation GROUP BY, marquez la date de mise à jour des données et stockez-les dans la table
a. Les tâches en ligne ultérieures peuvent alors joindre la table du jourT-2aavec la tabletable_xxx_diet effectuer un autre GROUP BY. Cela réduit le nombre de partitions lues quotidiennement de 365 à 2. La duplication de la clé primaireshop_idest grandement réduite, ce qui diminue également la consommation de ressources.-- Create a rolling table. CREATE TABLE IF NOT EXISTS m_xxx_365_df ( shop_id STRING, last_update_ds STRING, `365d_open_days` BIGINT ) PARTITIONED BY ( ds STRING COMMENT 'Date partition' )LIFECYCLE 7; -- Assume the 365-day period is 2021-05-01 to 2022-05-01. Perform a one-time initialization. INSERT OVERWRITE TABLE m_xxx_365_df PARTITION(ds = '20220501') SELECT shop_id, max(ds) as last_update_ds, sum(is_open) AS `365d_open_days` FROM table_xxx_di WHERE dt BETWEEN '20210501' AND '20220501' GROUP BY shop_id; -- Then, the daily online task to be executed is: INSERT OVERWRITE TABLE m_xxx_365_df PARTITION(ds = '${bizdate}') SELECT aa.shop_id, aa.last_update_ds, `365d_open_days` - COALESCE(is_open, 0) AS `365d_open_days` -- Prevent infinite rolling of open days. FROM ( SELECT shop_id, max(last_update_ds) AS last_update_ds, sum(`365d_open_days`) AS `365d_open_days` FROM ( SELECT shop_id, ds AS last_update_ds, sum(is_open) AS `365d_open_days` FROM table_xxx_di WHERE ds = '${bizdate}' GROUP BY shop_id UNION ALL SELECT shop_id, last_update_ds, `365d_open_days` FROM m_xxx_365_df WHERE dt = '${bizdate_2}' AND last_update_ds >= '${bizdate_365}' -- No GROUP BY needed here if the source is already grouped. ) GROUP BY shop_id ) AS aa LEFT JOIN ( SELECT shop_id, is_open FROM table_xxx_di WHERE ds = '${bizdate_366}' ) AS bb ON aa.shop_id = bb.shop_id;
COUNT(DISTINCT)
Supposons qu'une table présente la distribution de données suivante.
|
ds (partition) |
cnt (nombre d'enregistrements) |
|
20220416 |
73 025 514 |
|
20220415 |
2 292 806 |
|
20220417 |
2 319 160 |
L'utilisation de l'instruction suivante peut facilement provoquer une répartition inégale des données :
SELECT  ds
        ,COUNT(DISTINCT shop_id) AS cnt
FROM    demo_data0
GROUP BY ds;
Les solutions sont les suivantes :
|
Méthode |
Nom |
Description |
|
Méthode 1 |
Réglage des paramètres |
Définissez |
|
Méthode 2 |
Agrégation générique en deux étapes |
Ajoutez un nombre aléatoire à la valeur du champ de partition. |
|
Méthode 3 |
Agrégation de type deux étapes |
Effectuez d'abord un groupement par les champs |
-
Méthode 1 : Réglage des paramètres.
Définissez le paramètre suivant :
SET odps.sql.groupby.skewindata=true; -
Méthode 2 : Agrégation générique en deux étapes.
Si les données du champ
shop_idsont réparties de manière inégale, la Méthode 1 n'est pas efficace. Une méthode plus générique consiste à ajouter un nombre aléatoire à la valeur du champ de partition.-- Method A: Concatenate a random number. CONCAT(ROUND(RAND(),1)*10,'_', ds) AS rand_ds SELECT SPLIT_PART(rand_ds, '_', 2) AS ds ,COUNT(DISTINCT shop_id) AS id_cnt FROM ( SELECT CONCAT(CAST(FLOOR(RAND() * 10) AS STRING), '_', ds) AS rand_ds ,shop_id FROM demo_data0 ) GROUP BY rand_ds; -- Method B: Add a random number field. ROUND(RAND(),1)*10 AS randint10 SELECT ds ,COUNT(DISTINCT shop_id) AS id_cnt FROM (SELECT ds ,shop_id FROM demo_data0 ) GROUP BY ds, FLOOR(RAND() * 10); -
Méthode 3 : Agrégation de type deux étapes.
Si les données des champs GROUP BY et DISTINCT sont réparties uniformément, vous pouvez optimiser la requête en appliquant d'abord GROUP BY aux deux champs de regroupement (ds et shop_id), puis en utilisant la commande
count(distinct).SELECT ds ,COUNT(shop_id) AS cnt FROM(SELECT ds ,shop_id FROM demo_data0 GROUP BY ds ,shop_id ) GROUP BY ds;
ROW_NUMBER (TopN)
Le code suivant fournit un exemple Top-10.
SELECT  main_id
        ,type
FROM    (SELECT  main_id
                 ,type
                 ,ROW_NUMBER() OVER(PARTITION BY main_id ORDER BY type DESC ) rn
            FROM <data_demo2>
        ) A
WHERE   A.rn <= 10;
Lorsqu'une répartition inégale des données se produit, vous pouvez la résoudre en utilisant l'une des méthodes suivantes :
|
Méthode |
Nom |
Description |
|
Méthode 1 |
Agrégation en deux étapes basée sur SQL |
Ajoutez une colonne aléatoire ou un nombre aléatoire et utilisez-le comme paramètre dans la clause PARTITION BY. |
|
Méthode 2 |
Agrégation en deux étapes basée sur UDAF |
Utilisez une UDAF pour optimiser la requête avec une file de priorité min-heap. |
-
Méthode 1 : Agrégation en deux étapes basée sur SQL.
Pour distribuer les données de chaque groupe de partition aussi uniformément que possible lors de l'étape map, ajoutez une colonne aléatoire et utilisez-la comme paramètre dans la clause PARTITION BY.
-- Method 1: Use modulo on a random number. SELECT main_id ,type FROM (SELECT main_id ,type ,ROW_NUMBER() OVER(PARTITION BY main_id ORDER BY type DESC ) rn FROM (SELECT main_id ,type FROM (SELECT main_id ,type ,ROW_NUMBER() OVER(PARTITION BY main_id,src_pt ORDER BY type DESC ) rn FROM (SELECT main_id ,type ,ceil(110 * rand()) % 11 AS src_pt FROM data_demo2 ) ) B WHERE B.rn <= 10 ) ) A WHERE A.rn <= 10; -- Method 2: Use a custom random number. SELECT main_id ,type FROM (SELECT main_id ,type ,ROW_NUMBER() OVER(PARTITION BY main_id ORDER BY type DESC ) rn FROM (SELECT main_id ,type FROM(SELECT main_id ,type ,ROW_NUMBER() OVER(PARTITION BY main_id,src_pt ORDER BY type DESC ) rn FROM (SELECT main_id ,type ,ceil(10 * rand()) AS src_pt FROM data_demo2 ) ) B WHERE B.rn <= 10 ) ) A WHERE A.rn <= 10; -
Méthode 2 : Agrégation en deux étapes basée sur UDAF.
La méthode SQL peut entraîner un code verbeux difficile à maintenir. Vous pouvez alternativement utiliser une UDAF avec une file de priorité min-heap pour l'optimisation. Durant la phase
iterate, seuls les éléments Top-N sont conservés, et durant la phasemerge, seuls N éléments sont fusionnés. Le processus est le suivant :iterate: Poussez les K premiers éléments. Pour les éléments suivants, comparez-les continuellement à l'élément supérieur du min-heap et échangez les éléments si nécessaire.merge: Après la fusion de deux tas, renvoyez les K premiers éléments sur place.terminate: Renvoyez le tas sous forme de tableau.Dans la requête SQL, divisez le tableau en lignes distinctes.
@annotate('* -> array<string>')
class GetTopN(BaseUDAF):
    def new_buffer(self):
        return [[], None]
    def iterate(self, buffer, order_column_val, k):
        # heapq.heappush(buffer, order_column_val)
        # buffer = [heapq.nlargest(k, buffer), k]
        if not buffer[1]:
            buffer[1] = k
        if len(buffer[0]) < k:
            heapq.heappush(buffer[0], order_column_val)
        else:
            heapq.heappushpop(buffer[0], order_column_val)
    def merge(self, buffer, pbuffer):
        first_buffer, first_k = buffer
        second_buffer, second_k = pbuffer
        k = first_k or second_k
        merged_heap = first_buffer + second_buffer
        merged_heap.sort(reverse=True)
        merged_heap = merged_heap[0: k] if len(merged_heap) > k else merged_heap
        buffer[0] = merged_heap
        buffer[1] = k
    def terminate(self, buffer):
        return buffer[0]

SET odps.sql.python.version=cp37;
SELECT main_id,type_val FROM (
  SELECT  main_id ,get_topn(type, 10) AS type_array
  FROM data_demo2
  GROUP BY main_id
)
LATERAL VIEW EXPLODE(type_array)type_ar AS type_val;
Partition dynamique
Une partition dynamique vous permet d'insérer des données dans une table partitionnée en spécifiant un nom de colonne de partition dans la clause PARTITION sans fournir de valeur spécifique. La valeur de partition est fournie par la colonne correspondante dans la clause SELECT. Par conséquent, les partitions exactes à créer sont inconnues jusqu'à la fin de l'exécution de la requête SQL et la détermination des valeurs de la colonne de partition. Pour plus d'informations, consultez Insertion ou remplacement des données dans des partitions dynamiques (DYNAMIC PARTITION). Le code suivant fournit un exemple SQL.
CREATE TABLE total_revenues (revenue bigint) partitioned BY (region string);

INSERT overwrite TABLE total_revenues PARTITION(region)
SELECT total_price AS revenue,region
FROM sale_detail;
Les partitions dynamiques sont utilisées dans de nombreux scénarios et peuvent facilement entraîner une répartition inégale des données. Lorsqu'une répartition inégale des données se produit, vous pouvez la résoudre en utilisant l'une des solutions suivantes.
|
Méthode |
Nom |
Description |
|
Méthode 1 |
Configuration des paramètres |
Optimisez la requête en configurant les paramètres. |
|
Méthode 2 |
Optimisation par élagage |
Trouvez les partitions contenant un grand nombre d'enregistrements, élaguez-les, puis insérez-les séparément. |
-
Méthode 1 : Configuration des paramètres.
Le partitionnement dynamique permet de placer les données répondant à différentes conditions dans des partitions distinctes, évitant ainsi la nécessité de multiples instructions INSERT OVERWRITE. Cela peut grandement simplifier le code, surtout lorsqu'il y a de nombreuses partitions. Cependant, le partitionnement dynamique peut également entraîner un nombre excessif de petits fichiers.
-
Exemple de répartition inégale des données
Prenons l'exemple du SQL simple suivant :
INSERT INTO TABLE part_test PARTITION(ds) SELECT * FROM part_test;Supposons qu'il existe K instances Map et N partitions cibles.
                            ds=1
cfile1                      ds=2
...             X           ds=3
cfilek                      ...
                            ds=n
Dans le cas le plus extrême,
K*Npetits fichiers peuvent être générés. Un nombre excessif de petits fichiers peut exercer une énorme pression de gestion sur le système de fichiers. Par conséquent, MaxCompute gère les partitions dynamiques en introduisant un niveau supplémentaire de tâches reducer. Il dirige les données destinées aux mêmes partitions cibles pour qu'elles soient écrites par la même instance reducer (ou quelques-unes), évitant ainsi la création de trop nombreux petits fichiers. Ce reducer est toujours la dernière tâche du job. Dans MaxCompute, cette fonctionnalité est activée par défaut, ce qui signifie que le paramètre suivant est défini sur true :SET odps.sql.reshuffle.dynamicpt=true;L'activation de cette fonctionnalité par défaut résout le problème du nombre excessif de petits fichiers et empêche les échecs de tâches dus à un nombre trop important de fichiers générés par une seule instance. Cependant, elle introduit également un nouveau problème : la répartition inégale des données. De plus, l'introduction d'une étape reducer supplémentaire consomme des ressources de calcul. Vous devez donc peser soigneusement les compromis.
-
Solution
L'objectif initial de l'introduction d'une étape reducer supplémentaire en activant le paramètre
set odps.sql.reshuffle.dynamicpt=true;était de résoudre le problème du nombre excessif de petits fichiers. Cependant, si le nombre de partitions cibles est faible et qu'il n'y a aucun risque d'avoir trop de petits fichiers, activer cette fonctionnalité par défaut non seulement gaspille des ressources de calcul, mais réduit également les performances. Dans ce cas, désactiver cette fonctionnalité en définissantset odps.sql.reshuffle.dynamicpt=false;peut améliorer considérablement les performances. Le code suivant fournit un exemple.INSERT overwrite TABLE ads_tb_cornucopia_pool_d PARTITION (ds, lv, tp) SELECT /*+ mapjoin(t2) */ '20150503' AS ds, t1.lv AS lv, t1.type AS tp FROM (SELECT ... FROM tbbi.ads_tb_cornucopia_user_d WHERE ds = '20150503' AND lv IN ('flat', '3rd') AND tp = 'T' AND pref_cat2_id > 0 ) t1 JOIN (SELECT ... FROM tbbi.ads_tb_cornucopia_auct_d WHERE ds = '20150503' AND tp = 'T' AND is_all = 'N' AND cat2_id > 0 ) t2 ON t1.pref_cat2_id = t2.cat2_id;Si les paramètres par défaut sont utilisés pour le code précédent, le temps d'exécution total du job est d'environ 1 heure et 30 minutes. La dernière étape reducer prend environ 1 heure et 20 minutes, soit environ
90%du temps d'exécution total. L'introduction d'une étape reducer supplémentaire rend la distribution des données de chaque instance reducer très inégale, ce qui entraîne une longue traîne.
Pour l'exemple précédent, en analysant le nombre historique de partitions dynamiques générées, nous constatons qu'environ deux partitions dynamiques sont générées chaque jour. Vous pouvez donc définir en toute sécurité
set odps.sql.reshuffle.dynamicpt=false;. Le job peut alors être terminé en seulement 9 minutes. Dans ce cas, définir ce paramètre surfalsepeut améliorer considérablement les performances et économiser du temps de calcul et des ressources. Ce changement de paramètre unique apporte une amélioration significative pour un effort minimal.Cette optimisation ne concerne pas uniquement les jobs volumineux et longs qui consomment beaucoup de ressources, mais aussi les jobs ordinaires et courts qui en consomment moins. Tant que le partitionnement dynamique est utilisé et que le nombre de partitions dynamiques est faible, vous pouvez définir le paramètre
odps.sql.reshuffle.dynamicptsurfalsepour économiser des ressources et améliorer les performances.Les nœuds remplissant les trois conditions suivantes peuvent être optimisés, quelle que soit la durée du job :
Le job utilise des partitions dynamiques.
Le nombre de partitions dynamiques est inférieur ou égal à 50.
Le job ne contient pas
set odps.sql.reshuffle.dynamicpt=false;.
Le temps d'exécution de la dernière instance Fuxi peut être utilisé pour déterminer l'urgence de définir ce paramètre pour le nœud. Ceci est identifié par le champ
diag_level. Les règles sont les suivantes :Last_Fuxi_Inst_Timeest supérieur à 30 minutes :Diag_Level=4 ('Critical').Last_Fuxi_Inst_Timeest compris entre 20 et 30 minutes :Diag_Level=3 ('High').Last_Fuxi_Inst_Timeest compris entre 10 et 20 minutes :Diag_Level=2 ('Medium').Last_Fuxi_Inst_Timeest inférieur à 10 minutes :Diag_Level=1 ('Low').
-
-
Méthode 2 : Optimisation par élagage.
Pour résoudre la répartition inégale des données déjà présente dans l'étape map lors de l'insertion de données dans des partitions dynamiques, vous pouvez identifier et élaguer les partitions contenant de nombreux enregistrements, puis les insérer séparément. Selon le cas d'utilisation réel, vous pouvez modifier la configuration des paramètres de l'étape map comme suit :
SET odps.sql.mapper.split.size=128;
INSERT OVERWRITE TABLE data_demo3 partition(ds,hh)
SELECT  *
FROM    dwd_alsc_ent_shop_info_hi;
Le résultat montre qu'une analyse complète de la table a été effectuée. Pour optimiser davantage, vous pouvez désactiver le job Reduce introduit par le système, comme suit :
SET odps.sql.reshuffle.dynamicpt=false ;
INSERT OVERWRITE TABLE data_demo3 partition(ds,hh)
SELECT *
FROM dwd_alsc_ent_shop_info_hi;
Pour résoudre la répartition inégale des données dans l'étape map lors de l'insertion de données dans des partitions dynamiques, identifiez les partitions contenant de nombreux enregistrements, élaguez-les et insérez-les séparément. Les étapes spécifiques sont les suivantes :
-
Utilisez la commande suivante pour interroger les partitions spécifiques contenant un grand nombre d'enregistrements.
SELECT  ds
        ,hh
        ,COUNT(*) AS cnt
FROM    dwd_alsc_ent_shop_info_hi
GROUP BY ds
         ,hh
ORDER BY cnt DESC;
Certaines des partitions sont les suivantes :
ds
hh
cnt
20200928
17
1052800
20191017
17
1041234
20210928
17
1034332
20190328
17
1000321
20210504
1
19
20191003
20
18
20200522
1
18
20220504
1
18
-
Filtrez les partitions contenant un grand nombre d'enregistrements, insérez les données restantes, puis insérez séparément les données des partitions à grand nombre d'enregistrements.
SET odps.sql.reshuffle.dynamicpt=false ;
-- Insert data for partitions that do not have a large number of records.
INSERT OVERWRITE TABLE data_demo3 partition(ds,hh)
SELECT  *
FROM    dwd_alsc_ent_shop_info_hi
WHERE   CONCAT(ds,hh) NOT IN ('2020092817','2019101717','2021092817','2019032817');

-- Insert data for partitions that have a large number of records.
set odps.sql.reshuffle.dynamicpt=false ;
INSERT OVERWRITE TABLE data_demo3 partition(ds,hh)
SELECT  *
FROM    dwd_alsc_ent_shop_info_hi
WHERE   CONCAT(ds,hh) IN ('2020092817','2019101717','2021092817','2019032817');

-- Verify the result.
SELECT  ds
  ,hh,COUNT(*) AS cnt
 FROM dwd_alsc_ent_shop_info_hi
 GROUP BY ds,hh ORDER BY cnt desc;
-