User-defined join (UDJ) étend le framework de fonctions définies par l'utilisateur (UDF) de MaxCompute en permettant d'appliquer une logique de jointure personnalisée sur deux tables. S'appuyant sur le moteur de calcul MaxCompute V2.0, UDJ permet d'exprimer des opérations inter-tables que les types de JOIN standards et les frameworks UDF/UDTF/UDAF ne peuvent pas gérer, sans recourir à une implémentation MapReduce personnalisée.
Quand utiliser UDJ
MaxCompute propose six types de join intégrés : INNER JOIN, LEFT JOIN, RIGHT JOIN, FULL JOIN, SEMI JOIN et ANTI-SEMI JOIN. Les frameworks existants UDF, fonction définie par l'utilisateur renvoyant une table (UDTF) et fonction d'agrégation définie par l'utilisateur (UDAF) opèrent chacun sur une seule table à la fois.
Pour joindre plusieurs tables avec une logique personnalisée, deux options s'offrent à vous, mais elles présentent toutes deux des inconvénients majeurs :
JOIN intégré avec SQL complexe : Combiner plusieurs types de JOIN avec des UDF dans une seule instruction SQL crée une boîte noire logique qui complique la génération d'un plan d'exécution optimal.
MapReduce personnalisé : L'optimisation des plans d'exécution est difficile. La plupart du code MapReduce étant écrit en Java, son exécution est moins efficace que le code natif MaxCompute généré par le générateur de code Low Level Virtual Machine (LLVM).
UDJ résout ces deux limitations. La logique de jointure s'exécute au sein du runtime natif de MaxCompute et l'échange de données entre le moteur d'exécution UDJ et votre code Java est optimisé, rendant la logique de jointure UDJ plus efficace qu'un réducteur MapReduce équivalent.
Avec UDJ, vous pouvez :
Appliquer une logique de fusion personnalisée aux enregistrements co-groupés provenant de deux tables
Gérer explicitement les cas asymétriques (groupe gauche vide, groupe droit vide)
Utiliser le pré-tri
SORT BYpour traiter efficacement les grands groupes sans charger tous les enregistrements en mémoireRemplacer la logique complexe du réducteur MapReduce par du code Java appelable depuis SQL
Limitations
Vous ne pouvez pas utiliser de UDF, UDAF ou UDTF pour lire les données des types de tables suivants :
Table sur laquelle l'évolution du schéma est appliquée
Table contenant des types de données complexes
Table contenant des types de données JSON
Table transactionnelle
Performances
Pour valider les performances d'UDJ, nous avons réécrit un travail MapReduce réel exécutant un algorithme complexe en utilisant UDJ. Les deux approches ont été testées sur le même jeu de données avec la même concurrence. La figure ci-dessous présente les résultats.
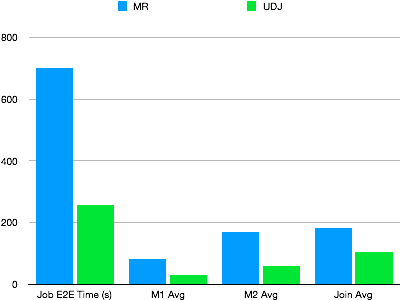
UDJ surpasse significativement la version MapReduce. L'intégralité de la logique du mappeur s'exécute dans le runtime natif de MaxCompute. La logique d'échange de données entre le moteur d'exécution UDJ de MaxCompute et les interfaces Java est optimisée dans le code Java. La logique de jointure est plus efficace que celle d'un réducteur équivalent.
Implémenter UDJ : exemple de jointure inter-tables
Cette section détaille un exemple complet : pour chaque enregistrement d'un journal d'activité client, trouvez l'enregistrement de paiement dont l'horodatage est le plus proche et fusionnez les deux.
Tables d'exemple
payment — stocke les enregistrements de paiement des utilisateurs
| user_id | time | pay_info |
|---|---|---|
| 2656199 | 2018-02-13 22:30:00 | gZhvdySOQb |
| 8881237 | 2018-02-13 08:30:00 | pYvotuLDIT |
| 8881237 | 2018-02-13 10:32:00 | KBuMzRpsko |
user_client_log — stocke les journaux d'activité client
| user_id | time | content |
|---|---|---|
| 8881237 | 2018-02-13 00:30:00 | click MpkvilgWSmhUuPn |
| 8881237 | 2018-02-13 06:14:00 | click OkTYNUHMqZzlDyL |
| 8881237 | 2018-02-13 10:30:00 | click OkTYNUHMqZzlDyL |
Objectif : Pour chaque enregistrement user_client_log, trouvez l'enregistrement payment dont la valeur time est la plus proche pour le même user_id, puis fusionnez les deux enregistrements.
Un JOIN standard ne peut pas accomplir cette tâche, car la condition ABS(p.time - u.time) = MIN(ABS(p.time - u.time)) nécessite une fonction d'agrégation dans le prédicat de JOIN, ce que SQL n'autorise pas.
Étape 1 : Configurer le SDK
Ajoutez le SDK UDF à votre projet Maven :
<dependency>
  <groupId>com.aliyun.odps</groupId>
  <artifactId>odps-sdk-udf</artifactId>
  <version>0.29.10-public</version>
  <scope>provided</scope>
</dependency>
Étape 2 : Écrire la classe UDJ
La classe UDJ implémente trois méthodes de cycle de vie :
setup()— appelée une fois avant le début du traitement ; initialisez ici le schéma de sortie et l'état partagéjoin()— appelée une fois par clé de jointure ; reçoit des itérateurs sur les groupes d'enregistrements gauche et droitclose()— appelée après le traitement de tous les groupes ; libérez les ressources ici
L'exemple ci-dessous implémente la correspondance basée sur l'heure la plus proche. Tous les enregistrements de paiement pour un user_id donné sont chargés dans une ArrayList afin que l'itérateur du côté droit puisse comparer chaque enregistrement de journal à l'ensemble complet.
package com.aliyun.odps.udf.example.udj;

import com.aliyun.odps.Column;
import com.aliyun.odps.OdpsType;
import com.aliyun.odps.Yieldable;
import com.aliyun.odps.data.ArrayRecord;
import com.aliyun.odps.data.Record;
import com.aliyun.odps.udf.DataAttributes;
import com.aliyun.odps.udf.ExecutionContext;
import com.aliyun.odps.udf.UDJ;
import com.aliyun.odps.udf.annotation.Resolve;
import java.util.ArrayList;
import java.util.Iterator;

// Output schema: (user_id STRING, time BIGINT, content STRING)
@Resolve("->string,bigint,string")
public class PayUserLogMergeJoin extends UDJ {

  private Record outputRecord;

  // Initialize the output record schema before processing starts.
  @Override
  public void setup(ExecutionContext executionContext, DataAttributes dataAttributes) {
    outputRecord = new ArrayRecord(new Column[]{
      new Column("user_id", OdpsType.STRING),
      new Column("time", OdpsType.BIGINT),
      new Column("content", OdpsType.STRING)
    });
  }

  // Called once per join key (user_id).
  // left  = payment records for this user_id
  // right = log records for this user_id
  @Override
  public void join(Record key, Iterator<Record> left, Iterator<Record> right, Yieldable<Record> output) {
    outputRecord.setString(0, key.getString(0));

    if (!right.hasNext()) {
      // No log records for this user — nothing to output.
      return;
    } else if (!left.hasNext()) {
      // No payment records — output log records unmerged.
      while (right.hasNext()) {
        Record logRecord = right.next();
        outputRecord.setBigint(1, logRecord.getDatetime(0).getTime());
        outputRecord.setString(2, logRecord.getString(1));
        output.yield(outputRecord);
      }
      return;
    }

    // Load all payment records into memory so each log record
    // can be compared against the full set.
    ArrayList<Record> pays = new ArrayList<>();
    left.forEachRemaining(pay -> pays.add(pay.clone()));

    while (right.hasNext()) {
      Record log = right.next();
      long logTime = log.getDatetime(0).getTime();
      long minDelta = Long.MAX_VALUE;
      Record nearestPay = null;

      // Find the payment record with the smallest time difference.
      for (Record pay : pays) {
        long delta = Math.abs(logTime - pay.getDatetime(0).getTime());
        if (delta < minDelta) {
          minDelta = delta;
          nearestPay = pay;
        }
      }

      // Merge the log record with its nearest payment record.
      outputRecord.setBigint(1, log.getDatetime(0).getTime());
      outputRecord.setString(2, mergeLog(nearestPay.getString(1), log.getString(1)));
      output.yield(outputRecord);
    }
  }

  String mergeLog(String payInfo, String logContent) {
    return logContent + ", pay " + payInfo;
  }

  @Override
  public void close() {}
}
Empaquetez cette classe sous le nom odps-udj-example.jar.
Étape 3 : Enregistrer la fonction UDJ
Téléchargez le fichier JAR et enregistrez la fonction :
ADD jar odps-udj-example.jar;

CREATE FUNCTION pay_user_log_merge_join
  AS 'com.aliyun.odps.udf.example.udj.PayUserLogMergeJoin'
  USING 'odps-udj-example.jar';
Étape 4 : Préparer les données d'exemple
CREATE TABLE payment(user_id STRING, time DATETIME, pay_info STRING);
CREATE TABLE user_client_log(user_id STRING, time DATETIME, content STRING);

-- Insert payment records
INSERT OVERWRITE TABLE payment VALUES
('1335656', datetime '2018-02-13 19:54:00', 'PEqMSHyktn'),
('2656199', datetime '2018-02-13 12:21:00', 'pYvotuLDIT'),
('2656199', datetime '2018-02-13 20:50:00', 'PEqMSHyktn'),
('2656199', datetime '2018-02-13 22:30:00', 'gZhvdySOQb'),
('8881237', datetime '2018-02-13 08:30:00', 'pYvotuLDIT'),
('8881237', datetime '2018-02-13 10:32:00', 'KBuMzRpsko'),
('9890100', datetime '2018-02-13 16:01:00', 'gZhvdySOQb'),
('9890100', datetime '2018-02-13 16:26:00', 'MxONdLckwa');

-- Insert log records
INSERT OVERWRITE TABLE user_client_log VALUES
('1000235', datetime '2018-02-13 00:25:36', 'click FNOXAibRjkIaQPB'),
('1000235', datetime '2018-02-13 22:30:00', 'click GczrYaxvkiPultZ'),
('1335656', datetime '2018-02-13 18:30:00', 'click MxONdLckpAFUHRS'),
('1335656', datetime '2018-02-13 19:54:00', 'click mKRPGOciFDyzTgM'),
('2656199', datetime '2018-02-13 08:30:00', 'click CZwafHsbJOPNitL'),
('2656199', datetime '2018-02-13 09:14:00', 'click nYHJqIpjevkKToy'),
('2656199', datetime '2018-02-13 21:05:00', 'click gbAfPCwrGXvEjpI'),
('2656199', datetime '2018-02-13 21:08:00', 'click dhpZyWMuGjBOTJP'),
('2656199', datetime '2018-02-13 22:29:00', 'click bAsxnUdDhvfqaBr'),
('2656199', datetime '2018-02-13 22:30:00', 'click XIhZdLaOocQRmrY'),
('4356142', datetime '2018-02-13 18:30:00', 'click DYqShmGbIoWKier'),
('4356142', datetime '2018-02-13 19:54:00', 'click DYqShmGbIoWKier'),
('8881237', datetime '2018-02-13 00:30:00', 'click MpkvilgWSmhUuPn'),
('8881237', datetime '2018-02-13 06:14:00', 'click OkTYNUHMqZzlDyL'),
('8881237', datetime '2018-02-13 10:30:00', 'click OkTYNUHMqZzlDyL'),
('9890100', datetime '2018-02-13 16:01:00', 'click vOTQfBFjcgXisYU'),
('9890100', datetime '2018-02-13 16:20:00', 'click WxaLgOCcVEvhiFJ');
Étape 5 : Exécuter UDJ dans SQL
La clause USING identifie la fonction UDJ et mappe les colonnes de chaque table :
SELECT r.user_id, FROM_UNIXTIME(time/1000) AS time, content
FROM (
  SELECT user_id, time AS time, pay_info FROM payment
) p
JOIN (
  SELECT user_id, time AS time, content FROM user_client_log
) u
ON p.user_id = u.user_id
USING pay_user_log_merge_join(p.time, p.pay_info, u.time, u.content)
r
AS (user_id, time, content);
**Paramètres de la clause USING :**
| Parameter | Description |
|---|---|
pay_user_log_merge_join |
Nom de la fonction UDJ enregistrée |
(p.time, p.pay_info, u.time, u.content) |
Colonnes des tables gauche et droite transmises à UDJ |
r |
Alias pour l'ensemble de résultats UDJ, référencable dans la requête externe |
(user_id, time, content) |
Noms des colonnes pour la sortie UDJ |
Sortie attendue :
+---------+---------------------+-----------------------------------------------+
| user_id | time                | content                                       |
+---------+---------------------+-----------------------------------------------+
| 1000235 | 2018-02-13 00:25:36 | click FNOXAibRjkIaQPB                         |
| 1000235 | 2018-02-13 22:30:00 | click GczrYaxvkiPultZ                         |
| 1335656 | 2018-02-13 18:30:00 | click MxONdLckpAFUHRS, pay PEqMSHyktn         |
| 1335656 | 2018-02-13 19:54:00 | click mKRPGOciFDyzTgM, pay PEqMSHyktn         |
| 2656199 | 2018-02-13 08:30:00 | click CZwafHsbJOPNitL, pay pYvotuLDIT         |
| 2656199 | 2018-02-13 09:14:00 | click nYHJqIpjevkKToy, pay pYvotuLDIT         |
| 2656199 | 2018-02-13 21:05:00 | click gbAfPCwrGXvEjpI, pay PEqMSHyktn         |
| 2656199 | 2018-02-13 21:08:00 | click dhpZyWMuGjBOTJP, pay PEqMSHyktn         |
| 2656199 | 2018-02-13 22:29:00 | click bAsxnUdDhvfqaBr, pay gZhvdySOQb         |
| 2656199 | 2018-02-13 22:30:00 | click XIhZdLaOocQRmrY, pay gZhvdySOQb         |
| 4356142 | 2018-02-13 18:30:00 | click DYqShmGbIoWKier                         |
| 4356142 | 2018-02-13 19:54:00 | click DYqShmGbIoWKier                         |
| 8881237 | 2018-02-13 00:30:00 | click MpkvilgWSmhUuPn, pay pYvotuLDIT         |
| 8881237 | 2018-02-13 06:14:00 | click OkTYNUHMqZzlDyL, pay pYvotuLDIT         |
| 8881237 | 2018-02-13 10:30:00 | click OkTYNUHMqZzlDyL, pay KBuMzRpsko         |
| 9890100 | 2018-02-13 16:01:00 | click vOTQfBFjcgXisYU, pay gZhvdySOQb         |
| 9890100 | 2018-02-13 16:20:00 | click WxaLgOCcVEvhiFJ, pay MxONdLckwa         |
+---------+---------------------+-----------------------------------------------+
Optimiser l'utilisation de la mémoire avec le pré-tri SORT BY
L'implémentation ci-dessus charge tous les enregistrements de paiement pour chaque user_id dans une ArrayList. Cette approche fonctionne lorsqu'un utilisateur possède un petit nombre d'enregistrements de paiement, mais elle échoue lorsque le groupe est trop volumineux pour tenir en mémoire.
Si les données sont triées par heure, vous n'avez besoin de suivre que quelques enregistrements à la fois au lieu du groupe complet.
Modification SQL
Ajoutez une clause SORT BY pour trier les deux tables au sein de chaque groupe de jointure :
SELECT r.user_id, from_unixtime(time/1000) AS time, content
FROM (
  SELECT user_id, time AS time, pay_info FROM payment
) p
JOIN (
  SELECT user_id, time AS time, content FROM user_client_log
) u
ON p.user_id = u.user_id
USING pay_user_log_merge_join(p.time, p.pay_info, u.time, u.content)
r
AS (user_id, time, content)
SORT BY p.time, u.time;
Méthode join() mise à jour
Les deux côtés étant triés par heure, vous pouvez trouver l'enregistrement de paiement le plus proche à l'aide d'un seul balayage linéaire, en comparant une fenêtre glissante d'au plus trois enregistrements plutôt que d'itérer sur tout le groupe gauche pour chaque enregistrement droit. Mettez à jour la méthode join() pour implémenter cette logique :
@Override
public void join(Record key, Iterator<Record> left, Iterator<Record> right, Yieldable<Record> output) {
  outputRecord.setString(0, key.getString(0));

  if (!right.hasNext()) {
    return;
  } else if (!left.hasNext()) {
    while (right.hasNext()) {
      Record logRecord = right.next();
      outputRecord.setBigint(1, logRecord.getDatetime(0).getTime());
      outputRecord.setString(2, logRecord.getString(1));
      output.yield(outputRecord);
    }
    return;
  }

  long prevDelta = Long.MAX_VALUE;
  Record logRecord = right.next();
  Record payRecord = left.next();
  Record lastPayRecord = payRecord.clone();

  while (true) {
    long delta = logRecord.getDatetime(0).getTime() - payRecord.getDatetime(0).getTime();

    if (left.hasNext() && delta > 0) {
      // The time gap is still shrinking — advance the left iterator.
      lastPayRecord = payRecord.clone();
      prevDelta = delta;
      payRecord = left.next();
    } else {
      // Minimum delta reached. Output the merged record and advance the right iterator.
      Record nearestPay = Math.abs(delta) < prevDelta ? payRecord : lastPayRecord;
      outputRecord.setBigint(1, logRecord.getDatetime(0).getTime());
      outputRecord.setString(2, mergeLog(nearestPay.getString(1), logRecord.getString(1)));
      output.yield(outputRecord);

      if (right.hasNext()) {
        logRecord = right.next();
        prevDelta = Math.abs(
          logRecord.getDatetime(0).getTime() - lastPayRecord.getDatetime(0).getTime()
        );
      } else {
        break;
      }
    }
  }
}
Cette version met en cache au maximum trois enregistrements à la fois et produit la même sortie que l'approche utilisant ArrayList.
Après avoir modifié la classe Java UDJ, reconstruisez le fichier JAR et rajoutez-le à MaxCompute pour que les modifications prennent effet.