Lorsque vous utilisez PyODPS DataFrame, le code s'exécute dans deux environnements distincts : votre machine locale (l'environnement sur site) et un exécuteur MaxCompute dans le cloud. Les fonctions transmises à map, apply, map_reduce ou les opérations d'agrégation personnalisées s'exécutent au sein de l'exécuteur MaxCompute, et non localement. Comprendre cette frontière permet d'éviter les erreurs d'importation, les conflits de packages et les échecs d'accès aux données.
Modèle d'exécution
PyODPS est un package Python, et non une implémentation du langage Python. Il s'exécute dans des environnements Python standard et se comporte comme n'importe quel interpréteur Python courant.
Prenons l'exemple suivant :
from odps import ODPS, options
import numpy as np

o = ODPS(...)
df = o.get_table('pyodps_iris').to_df()

coeffs = [0.1, 0.2, 0.4]

def handle(v):
    import numpy as np
    return float(np.cosh(v)) * sum(coeffs)

options.df.supersede_libraries = True
val = df.sepal_length.map(handle).sum().execute(libraries=['numpy.zip', 'other.zip'])
print(np.sinh(val))
Le schéma ci-dessous illustre les systèmes impliqués lors de l'exécution de ce code. Tout ce qui se trouve en dehors de MaxCompute correspond à l'environnement sur site.
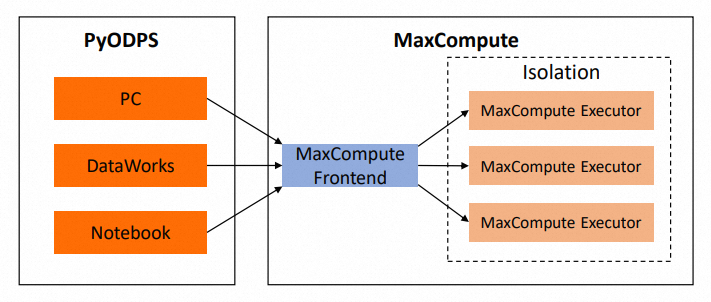
Tout le code, à l'exception du corps de la fonction handle, s'exécute dans l'environnement sur site. La fonction handle est transmise à map mais n'y est pas appelée ; elle est soumise à MaxCompute et exécutée à distance.
Lorsque handle est transmis à map avec le backend MaxCompute, PyODPS le traite en trois phases :
Le module cloudpickle extrait la fermeture et le bytecode de la fonction.
PyODPS DataFrame utilise la fermeture et le bytecode pour générer une fonction définie par l'utilisateur (UDF) Python, puis la soumet à MaxCompute.
Si vous exécutez des tâches dans MaxCompute à l'aide d'instructions SQL, la UDF Python générée est appelée, le bytecode et la fermeture sont désérialisés (unpickled), et la UDF est exécutée dans un exécuteur MaxCompute.
Frontière d'exécution
|
Emplacement du code |
S'exécute sur |
|
Imports et instructions de niveau supérieur |
Environnement sur site |
|
Corps de fonction transmis à |
Exécuteur MaxCompute |
|
Tout le code lors de l'utilisation du backend pandas |
Environnement sur site |
Contraintes dans un exécuteur MaxCompute
Les contraintes suivantes s'appliquent à tout corps de fonction que vous transmettez à map, apply, map_reduce ou aux fonctions d'agrégation personnalisées lorsque le backend MaxCompute est actif.
Les packages locaux ne sont pas disponibles. Seuls les packages présents dans les exécuteurs MaxCompute peuvent être référencés à l'intérieur du corps de la fonction. Dans l'exemple ci-dessus, other.zip listé dans libraries=['numpy.zip', 'other.zip'] doit exister en tant que ressource MaxCompute. Le simple fait de le télécharger vers MaxCompute ne suffit pas s'il est absent de l'environnement sur site.
Importez les packages à l'intérieur du corps de la fonction. Si vous importez un package en dehors de la fonction et y faites référence à l'intérieur, une erreur peut se produire. Cloudpickle envoie la référence au package sur site, mais la structure du package peut ne pas être compatible avec l'exécuteur MaxCompute. Importez plutôt le package à l'intérieur du corps de la fonction, comme illustré dans la fonction handle de l'exemple.
Les variables externes sont capturées par valeur. Si vous référencez une variable définie en dehors de la fonction (telle que coeffs dans l'exemple) et la modifiez à l'intérieur du corps de la fonction, la valeur sur site est conservée. La modification ne se propage pas à l'environnement sur site.
Le code provenant d'autres fichiers doit exister dans l'exécuteur. Si le corps de la fonction référence du code provenant d'un autre fichier, le package contenant ce fichier doit être disponible dans l'exécuteur MaxCompute. Si vous préférez ne pas l'emballer en tant que ressource tierce, stockez tout le code personnel référencé dans le même fichier.
Les packages tiers doivent être intégrés avec Python 2.7 (UCS-2). Le package tiers téléchargé doit être intégré avec Python 2.7, qui utilise UCS-2, dans un exécuteur MaxCompute.
Aucun accès direct aux autres tables MaxCompute. Les exécuteurs MaxCompute ne prennent pas en charge les connexions aux endpoints ou aux Tunnel endpoints, et aucun package PyODPS n'est disponible à l'intérieur de l'exécuteur. Vous ne pouvez pas utiliser d'objets d'entrée ODPS ni PyODPS DataFrame pour accéder à d'autres tables MaxCompute depuis un corps de fonction, et vous ne pouvez pas transmettre ces objets depuis l'extérieur.
Pour les petites tables : transmettez la table en tant que DataFrame resource.
Pour les grandes tables : utilisez plutôt une jointure de table.
Utiliser des packages tiers
La manière dont vous utilisez les packages tiers dépend de l'emplacement d'exécution de votre code.
Ordinateur personnel ou serveur sur site. Installez le package pour la version Python requise à l'aide de pip ou de votre gestionnaire de packages.
Notebook. Contactez votre fournisseur de plateforme pour obtenir des instructions sur l'installation des packages.
DataWorks. L'installation directe de packages sur le système sur site n'est pas prise en charge dans DataWorks. Au lieu de cela, référencez les packages tiers en lisant le fichier et en exécutant la commande exec. Pour plus de détails, consultez la rubrique Utiliser un nœud PyODPS pour référencer un package tiers.
La structure de répertoire affichée dans DataStudio ne correspond pas à la structure de répertoire réelle sur le système de fichiers. L'importation ou l'ouverture d'un chemin affiché dans DataStudio échouera.
Après avoir téléchargé des ressources dans DataWorks, cliquez sur Submit pour vous assurer que les ressources sont téléchargées vers MaxCompute.
Pour utiliser une version NumPy personnalisée, définissez
odps.df.supersede_libraries = Truedans votre code et spécifiez le nom du package NumPy comme première entrée du paramètrelibrarieslors du téléchargement du package wheel requis.
Accéder aux données dans d'autres tables MaxCompute
La méthode d'accès aux autres tables MaxCompute dépend de l'emplacement d'exécution de votre code.
Environnement sur site (ordinateur personnel, serveur sur site, Notebook ou DataWorks). Utilisez le code sur site pour accéder à la table. Si vous pouvez atteindre l'endpoint, utilisez PyODPS ou PyODPS DataFrame. Si vous ne pouvez pas atteindre l'endpoint, contactez votre fournisseur de plateforme.
À l'intérieur des fonctions map, apply, map_reduce ou d'agrégation personnalisée. Les exécuteurs MaxCompute ne prennent pas en charge les connexions aux endpoints ou aux Tunnel endpoints, et aucun package PyODPS n'est disponible. Vous ne pouvez pas utiliser d'objets d'entrée ODPS ni PyODPS DataFrame pour accéder à d'autres tables, et vous ne pouvez pas transmettre ces objets depuis l'extérieur.
Pour les petites tables : transmettez la table en tant que DataFrame resource.
Pour les grandes tables : utilisez plutôt une jointure de table.
Comportement du backend pandas
Lorsque vous utilisez le backend pandas, tout le code s'exécute dans l'environnement sur site. Installez tous les packages requis localement.
Lorsque vous passez du backend pandas à MaxCompute pour la production, respectez les règles du backend MaxCompute pour l'installation des packages.